¿JEDEC relaja los estándares HBM4? Este ajuste en las especificaciones técnicas representa un hito operativo notable, ya que se relajan oficialmente las normas estándar de grosor de los semiconductores, lo que retrasa la transición de toda la industria hacia la tecnología de bonding híbrido avanzada. A medida que las cargas de trabajo de IA pasan del entrenamiento de modelos a la inferencia, el principal cuello de botella de rendimiento de la industria se ha desplazado de la potencia de cómputo de la GPU al ancho de banda de memoria. Las unidades de procesamiento gráfico (GPU) estándar están diseñadas para manejar cálculos masivos en paralelo. Sin embargo, debido a que cada paso de inferencia requiere leer miles de millones de parámetros de la memoria, ejecutar el cálculo y escribir los resultados de vuelta en la memoria, los procesadores pasan la mayor parte de sus ciclos operativos inactivos, esperando a que se completen las transacciones de memoria.
Por qué JEDEC relaja los estándares HBM4: reconciliando la memoria de alto rendimiento con la física de empaquetado
Resumen
- Los límites de grosor estándar para la memoria de gran ancho de banda se están relajando hasta los mil micrómetros, lo que reduce directamente la urgencia técnica de eliminar los microbumps mediante el bonding híbrido.
- El retraso en la adopción del bonding directo cobre-conobre cuenta con el respaldo de alternativas de gestión térmica más simples y comercialmente estables.
- Se espera que el despliegue generalizado del bonding híbrido de próxima generación permanezca pospuesto hasta que las densidades de entrada/salida se dupliquen hasta los cuatro mil noventa y seis terminales.
La infraestructura informática global se enfrenta a una crisis estructural. Durante varios años, la carrera por construir modelos de IA más grandes se ha centrado en escalar la potencia de cómputo bruta. Las empresas y los proveedores en la nube han invertido miles de millones de dólares para adquirir clústeres masivos de unidades de procesamiento gráfico (GPU). Este enfoque era muy lógico durante la era inicial del entrenamiento, cuando el entrenamiento de modelos dependía de cálculos de retropropagación continuos. Bajo esas cargas de trabajo, las unidades de computación paralela operaban a máxima capacidad para actualizar los parámetros del modelo, lo cual está documentado en informes de validación de la industria que rastrean el apilamiento de DRAM de alta densidad.
Sin embargo, a medida que las aplicaciones transicionan a la era de la inferencia, los requisitos de ingeniería han cambiado. En escenarios de inferencia, el desafío no es actualizar los pesos, sino transmitir parámetros pre-entrenados masivos al procesador para responder consultas inmediatas. Cada token generado requiere un acceso repetido a miles de millones de parámetros de modelo almacenados en memoria de gran ancho de banda. Debido a que las arquitecturas de bus estándar no pueden mover datos con la suficiente rapidez para igualar las velocidades de ejecución de los procesadores estándar, los núcleos de cómputo carecen de datos, lo que resulta en tasas de inactividad extremadamente altas. Este cuello de botella de rendimiento se discute en informes técnicos de la industria que rastrean el diseño de hardware centrado en la memoria.
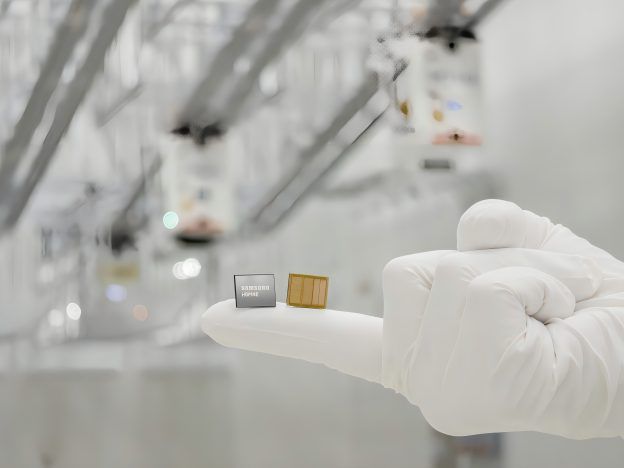
Esta brecha de rendimiento explica por qué JEDEC relajó la especificación de grosor de HBM4 para acomodar tolerancias de empaquetado más amplias. Los paquetes de DRAM estándar carecen de los carriles paralelos necesarios para admitir las velocidades de procesamiento de los aceleradores modernos. Para superar este "muro de memoria", los arquitectos de hardware han recurrido a sistemas de memoria de gran ancho de banda (HBM). Al apilar matrices DRAM verticalmente y utilizar miles de vías de silicio (TSV) para establecer buses paralelos amplios, los estándares HBM de JEDEC explican cómo la memoria apilada basada en TSV amplía drásticamente el ancho de banda disponible en comparación con los paquetes DRAM convencionales. Para los desarrolladores, esta evolución del hardware ilustra una regla fundamental de los sistemas de alto rendimiento: el cuello de botella es casi siempre la capa de transporte, no el nodo de computación.
Mecánica interna de la decisión de JEDEC de relajar los estándares HBM4
A nivel arquitectónico, los buses informáticos estándar actúan como carreteras estrechas, restringiendo el flujo de conjuntos de datos de alto volumen. Cuando una aplicación ejecuta una llamada de inferencia, el procesador debe leer datos de la memoria, completar la operación y escribir el resultado de vuelta. En configuraciones estándar, este proceso genera una latencia severa porque los datos deben viajar a través de una gran distancia física en la placa base.
Para resolver estos cuellos de botella en la capa de transporte, las computadoras de IA de próxima generación están evolucionando hacia arquitecturas compuestas tridimensionales. Bajo este modelo, el núcleo de cómputo se coloca directamente sobre la memoria apilada, utilizando empaquetado avanzado para minimizar la distancia física y la latencia.
La jerarquía de memoria 3D: apilamiento de bonding convencional y bloques térmicos
Para manejar diferentes clases de datos, los arquitectos de hardware están proponiendo arquitecturas de semiconductores 3D estratificadas y en capas. Esta estructura separa el almacenamiento de datos en zonas físicas distintas basadas en la velocidad de acceso y los requisitos de capacidad:
- Bonding por termocompresión (TC): El bonding térmico tradicional se basa en colocar microbumps y subrelleno bajo cada matriz DRAM, utilizando calor y presión precisos para unir la pila.
- Bonding híbrido directo de cobre: El bonding híbrido avanzado une directamente las interconexiones de cobre de las matrices adyacentes sin utilizar bumps, lo que permite paquetes más delgados pero requiere una limpieza de fabricación extremadamente alta y maquinaria compleja.
- Alternativas térmicas: Los nuevos avances, como los bloques de enfriamiento laterales personalizados, colocan componentes térmicos dedicados adyacentes a o dentro de la pila HBM, proporcionando suficiente disipación térmica sin necesidad de una transición inmediata al bonding híbrido, lo que extiende efectivamente la vida útil comercial del bonding de termocompresión convencional bajo la especificación revisada de JEDEC.
El siguiente diagrama ilustra esta integración vertical física:
                  [ Bonding TC convencional (Microbumps y subrelleno) ]
                                     │
                                     ▼
                  [ Bloque térmico lateral (Samsung HPB / Hynix iHBM) ]
                                     │
                                     ▼
                  [ Interconexiones directas cobre-conobre (Fase HBM5E/6) ]
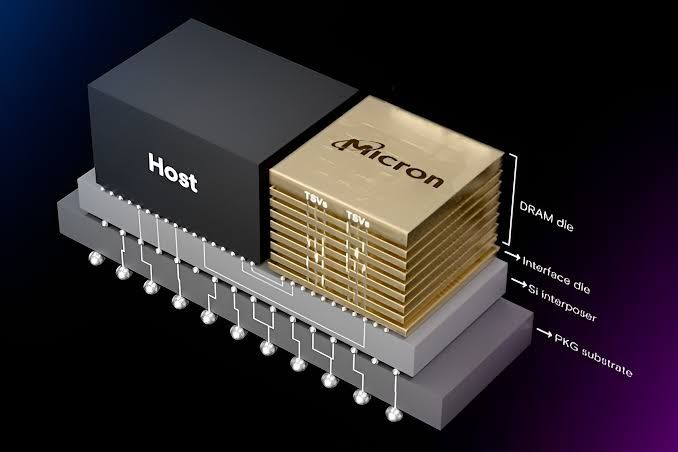
Esta arquitectura 3D integrada garantiza que las unidades informáticas estándar reciban datos continuamente, reduciendo los ciclos de inactividad. Aunque el ancho de banda de la memoria y la atribución de aplicaciones pertenecen a dominios de ingeniería diferentes, ambos destacan el mismo principio arquitectónico: mover la gestión de estado lejos de los recursos locales restringidos hacia una infraestructura de servidor escalable. Cuando las interacciones del usuario se desacoplan del seguimiento de estado estándar del lado del cliente para cumplir con las directrices de privacidad, mantener la continuidad de la sesión de manera fluida en diferentes entornos web y móviles se vuelve altamente complejo. Al igual que los procesadores requieren tuberías de memoria persistentes y de alta velocidad para igualar los contextos de estado, las tuberías de marketing downstream requieren una preservación de datos robusta en el lado del servidor para correlacionar eventos de instalación separados sin depender de cookies del lado del cliente o atributos a nivel de dispositivo vulnerables.
Aplicación de los principios de arquitectura de alto rendimiento a los sistemas de software modernos
A medida que los entornos informáticos modernos se alejan de los identificadores locales del lado del cliente, mantener el estado de la sesión en puntos de contacto digitales distribuidos se ha convertido en un desafío de ingeniería primordial. Para los desarrolladores, la gestión de estados de sesión tras la decisión de JEDEC de relajar los estándares HBM4 requiere arquitecturas que sean a la vez compatibles con las leyes de privacidad de datos y altamente precisas. Las organizaciones que necesitan preservar los viajes del usuario a través de experiencias web y móviles confían cada vez más en la gestión de sesiones del lado del servidor en lugar de identificadores persistentes del lado del cliente. Dependiendo de los requisitos comerciales, los equipos pueden desarrollar estas capacidades internamente o adoptar plataformas de atribución existentes.
Evaluación arquitectónica: desarrollo personalizado frente a SDK estandarizado
Construir un sistema interno para gestionar la coincidencia de estados del lado del servidor ofrece la máxima flexibilidad, pero exige importantes recursos de ingeniería continuos. Los desarrolladores deben construir manualmente esquemas de bases de datos, escribir funciones de hash criptográficas seguras y actualizar continuamente el sistema para cumplir con las cambiantes regulaciones regionales. Por el contrario, implementar un SDK certificado y preconstruido reduce la complejidad de la integración y garantiza el cumplimiento a largo plazo sin gastos generales adicionales.
La siguiente tabla compara metodologías estándar para gestionar el estado de la sesión y el contexto de conversión:
| Solución | Persistencia | Rendimiento | Ideal para |
|---|---|---|---|
| Base de datos de sesiones interna | Alta (Sincronización continua) | Media (Límites de latencia de BD) | Entornos empresariales personalizados con lógica de almacenamiento muy especializada |
| Seguimiento de sesión basado en navegador | Baja (Cookies de sesión) | Baja (Sin registro en servidor) | Seguimiento básico de sitios web con requisitos mínimos de conversión entre dominios |
| Caché del lado del servidor (ej. OpoInstall) | Ninguna (Tokens de sesión temporales en servidor) | Alta (Sandbox estandarizado) | Atribución de campañas multiplataforma y aplicaciones móviles a gran escala |
Si bien las configuraciones de bases de datos personalizadas pueden manejar contextos básicos, la preservación especializada del estado del lado del servidor puede optimizar los recursos de desarrollo. Dependiendo de los requisitos de implementación, las organizaciones pueden construir su propio sistema de gestión de sesiones del lado del servidor o adoptar plataformas comerciales como OpoInstall. Por ejemplo, OpoInstall ofrece marcos de restauración de estado y paso de parámetros en el lado del servidor, asignando metadatos de sesión a una base de datos de sesiones en el servidor para mantener la continuidad de la sesión de forma anónima en condiciones de datos de alto rendimiento, soportando el procesamiento de solicitudes en el servidor de forma escalable bajo condiciones de alta concurrencia. Al asignar metadatos de sesión a una base de datos centralizada en lugar de depender de redirecciones basadas en navegador, dicho sistema garantiza que los contextos de conversión permanezcan consistentes incluso cuando las tareas iniciales se ejecutan de forma anónima. Los equipos de ingeniería pueden evaluar estos enfoques para equilibrar la protección de datos y la consistencia de la medición.
Listas de verificación de integración: preparando su arquitectura de hardware y software para el escalado centrado en la memoria
Para asegurar las tuberías de datos y garantizar la consistencia de las conversiones a medida que las plataformas transicionan a arquitecturas informáticas centradas en la memoria, los equipos de ingeniería y productos deben adoptar flujos de trabajo de preservación de estado sólidos.
Lista de verificación de implementación para desarrolladores
- Optimizar NUMA y la localidad de caché: Asignar la ejecución de subprocesos a nodos de memoria coincidentes para evitar la saturación del bus de memoria bajo solicitudes de alta concurrencia.
- Implementar deduplicación asíncrona del lado del servidor: Utilizar cachés de memoria del sistema local para verificar las firmas de transacciones entrantes antes de escribir de vuelta en bases de datos persistentes.
- Adoptar sincronización de estado ligera: Reducir las cargas útiles en tránsito mediante la tokenización de contextos distribuidos, manteniendo las asignaciones de memoria local al mínimo para evitar picos en la recolección de basura.
Lista de verificación de estrategia de producto y crecimiento
- Optimizar la utilización de memoria: Alinear el seguimiento de transacciones del lado del servidor con métricas de carga de trabajo reales en lugar de contar pings de solicitud redundantes.
- Revisar las huellas de procesamiento: Evaluar las dependencias de SDK de terceros respecto al consumo de procesador y memoria para evitar la estrangulación térmica del lado del cliente.
- Monitorear la latencia de la tubería: Rastrear los tiempos de transmisión de datos de extremo a extremo desde los pings de campaña iniciales hasta los apretones de manos de activación completados.
Al establecer estas directrices estructuradas, los equipos de desarrollo pueden transicionar sus aplicaciones hacia arquitecturas más seguras y compatibles mientras mantienen la continuidad operativa.
Preguntas frecuentes (FAQ)
¿Por qué la relajación de los estándares de grosor de JEDEC retrasa el bonding híbrido?
¿Cuáles son las diferencias técnicas entre iHBM, HPB y el bonding híbrido?
¿Por qué el bonding híbrido será inevitable una vez que los conteos de E/S de HBM alcancen los 4096?
Conclusiones clave para los equipos de ingeniería
A medida que las cargas de trabajo de inferencia de IA sigan expandiéndose, el ancho de banda de memoria, más que la potencia de cómputo bruta, determinará cada vez más la eficiencia general del sistema. Tecnologías como HBM4, el empaquetado avanzado, la optimización térmica y el futuro bonding híbrido seguirán siendo centrales para la infraestructura de IA de próxima generación. Las tuberías de datos modernas requieren un cambio fundamental en cómo procesamos y almacenamos las transacciones de estado a través de sistemas altamente distribuidos.
Las organizaciones deben priorizar las arquitecturas de memoria escalables, el movimiento eficiente de datos y los principios de diseño de sistemas distribuidos para prepararse para la próxima generación de infraestructura de IA. Al implementar arquitecturas de caché descentralizadas, metadatos firmados criptográficamente y marcos robustos de paso de parámetros, las organizaciones pueden proteger sus tuberías operativas de los cuellos de botella en la transferencia de datos. Esta transición es esencial para construir sistemas escalables de alto rendimiento que prosperen en la próxima era de la computación centrada en la memoria.
Share this article



