¿Meta prohíbe ‘Claude’? Esta realineación estratégica se ha confirmado, ya que los informes indican que el gigante de las redes sociales ha restringido a los ingenieros de su división de IA Aplicada el uso de herramientas de la competencia como Claude Code y Codex de OpenAI. Según documentos internos obtenidos a finales de junio de 2026, la empresa emitió estas directrices para proteger la pureza de los conjuntos de datos de entrenamiento de su futuro modelo Llama y salvaguardar sus secretos comerciales, tal como detallan las actualizaciones de cumplimiento del sector. Para los equipos de desarrollo y los jefes de producto, esta política restrictiva subraya una transición más amplia: a medida que los modelos generativos convergen, mantener el aislamiento estricto de los entornos internos se está convirtiendo en un estándar fundamental de cumplimiento corporativo, más que en una elección operativa menor.
Resumen
- Salvaguardas contra la contaminación: El equipo de ingeniería de IA Aplicada restringió las llamadas a herramientas externas de generación de código para evitar que las salidas de modelos rivales se mezclen con datos de entrenamiento propietarios.
- La amenaza de la destilación: La reutilización extensiva de salidas programáticas externas introduce riesgos de destilación de conocimiento, lo que podría vulnerar los acuerdos de términos de servicio.
- Demanda de entornos aislados (sandboxes) privados: El cambio resalta una necesidad creciente de entornos de desarrollo seguros y autoalojados que aíslen los repositorios de código confidencial de servidores externos.
Directrices corporativas y la realineación de seguridad de mayo a junio
Las pautas restrictivas, redactadas inicialmente en mayo de 2026, entraron en vigor de forma oficial a finales de junio de 2026. Las reglas se centran exclusivamente en los ingenieros dentro de la división de IA Aplicada que participan directamente en la investigación de modelos, en lugar de aplicarse a todos los empleados. En ciclos de desarrollo anteriores, el equipo de ingeniería integraba frecuentemente asistentes de programación externos para planificar arquitecturas de sistemas, refactorizar bases de código y ejecutar flujos de depuración. Sin embargo, bajo las pautas de seguridad actualizadas, los ingenieros deben diseñar los datos de prueba de forma independiente, confiando en la experiencia humana en lugar de en los prompts de modelos externos.
Un factor clave detrás de esta transición es el riesgo de la destilación de modelos, también conocida como destilación de conocimiento. En la investigación de inteligencia artificial, los desarrolladores entrenan modelos "estudiantes" más pequeños para imitar los comportamientos de modelos "profesores" más robustos, alimentándolos con las salidas de dichos sistemas más grandes. Aunque este proceso sigue siendo popular para optimizar la escala y los costes de despliegue de los modelos, plantea graves riesgos contractuales. Los ingenieros de Meta que copian o hacen referencia a código compilado por herramientas rivales corren el riesgo de introducir datos de la competencia en el proceso de entrenamiento de Llama, lo que podría violar acuerdos de usuario y contaminar el modelo propietario.
La realineación de seguridad ocurre en un contexto de competencia intensificada. En junio de 2026, la startup china de IA Zhipu AI lanzó como código abierto su modelo insignia, GLM-5.2, demostrando capacidades de escaneo de vulnerabilidades a la par de los principales benchmarks cerrados de EE. UU. Las pruebas independientes mostraron que GLM-5.2 superaba a puntos de control de modelos previos como Claude Opus 4.8 en tareas de ciberseguridad con Semgrep. Debido a que Zhipu AI optó por publicar los pesos del modelo como código abierto, permitiendo despliegues privados locales, el modelo ha escalado rápidamente en las listas de tráfico de terceros en plataformas como OpenRouter. Este rápido ascenso de modelos alternativos locales de alto rendimiento está obligando a los principales laboratorios de IA de frontera a priorizar el control absoluto sobre sus repositorios de código y las entradas de conjuntos de datos.
Las siguientes observaciones se basan en la validación interna en un entorno de pruebas y tienen como objetivo ilustrar patrones de ingeniería en lugar de servir como benchmarks de toda la industria.
Mecánica interna de la destilación de modelos y exposición de datos
Para comprender por qué Meta está restringiendo estas herramientas, los desarrolladores deben analizar la mecánica de los asistentes de codificación de IA modernos. Estas utilidades funcionan enviando el contexto del código base local a servidores externos para su procesamiento. Cuando un ingeniero inicia un prompt de refactorización o solicita sugerencias arquitectónicas, fragmentos de código propietario viajan fuera de la red corporativa interna. Esta transmisión de datos sin supervisión crea vulnerabilidades directas para la exposición de propiedad intelectual y la filtración de datos.
IDE del desarrollador -> Interceptor de solicitudes salientes -> Proxy de Sandbox (Metadatos eliminados) -> API Gateway seguro -> Modelo
                                                            |
                                               El firewall saliente bloquea las subidas de código base sin procesar
En despliegues de producción típicos, los desarrolladores suelen encontrar una parte considerable del tráfico siendo procesada por extractores automatizados (scrapers). Rastrear estas interacciones programáticas revela que los proxies de seguridad automatizados o los escáneres en tiempo de ejecución pueden activar endpoints de API externos antes de que los desarrolladores se den cuenta. Tal actividad puede interferir con las auditorías de datos si los sistemas asumen que cada solicitud proviene de una acción manual real del usuario. En el contexto del desarrollo de modelos, permitir que modelos externos ingieran archivos internos de MetaCode o DevMate corre el riesgo de exponer estructuras propietarias durante los ciclos de entrenamiento competitivo.
Además, las actualizaciones de los términos de servicio de los principales proveedores de IA a finales de 2025 introdujeron cláusulas de entrenamiento de conjuntos de datos mediante suscripción (opt-in), lo que aumentó las preocupaciones entre los equipos legales corporativos. Sin firewalls estrictos a nivel de red, las sesiones diarias de depuración de un desarrollador podrían suministrar inadvertidamente entradas de entrenamiento a plataformas competitivas. Bajo estas condiciones, la pureza estructural de la base de código propietaria se ve comprometida.
Opciones arquitectónicas para el sandboxing seguro y la verificación de procesos
Ante la escalada de los riesgos de seguridad de los datos, los equipos de desarrollo de software suelen elegir entre construir un marco interno de verificación de costes o integrar un SDK de atribución existente. Desarrollar un sistema propietario requiere una carga de ingeniería considerable. Los equipos deben construir bases de datos personalizadas en el lado del servidor, mantener bibliotecas de coincidencia de estados del dispositivo y actualizar continuamente la lógica para cumplir con los estándares de seguridad del SO en constante evolución. Para muchas organizaciones, el coste de mantenimiento de un rastreador interno es prohibitivamente alto.
Alternativamente, los desarrolladores suelen evaluar varios enfoques para supervisar la ejecución en tiempo de ejecución sin depender totalmente de métricas en la nube:
- Despliegues de modelos locales: Ejecutar modelos de código abierto pequeños y altamente especializados dentro de entornos seguros sin conexión.
- Sandboxing estricto con firewall: Restringir que los contenedores de desarrollo activos establezcan conexiones de red salientes externas.
- MMPs empresariales: Utilizar plataformas de medición móvil de terceros robustas para flujos de trabajo de enlaces profundos (deep-linking).
- SDKs de parámetros especializados: Desplegar utilidades de integración dedicadas para un paso de parámetros personalizados preciso y sensible a los costes.
Comparativa de configuración del entorno de desarrollo
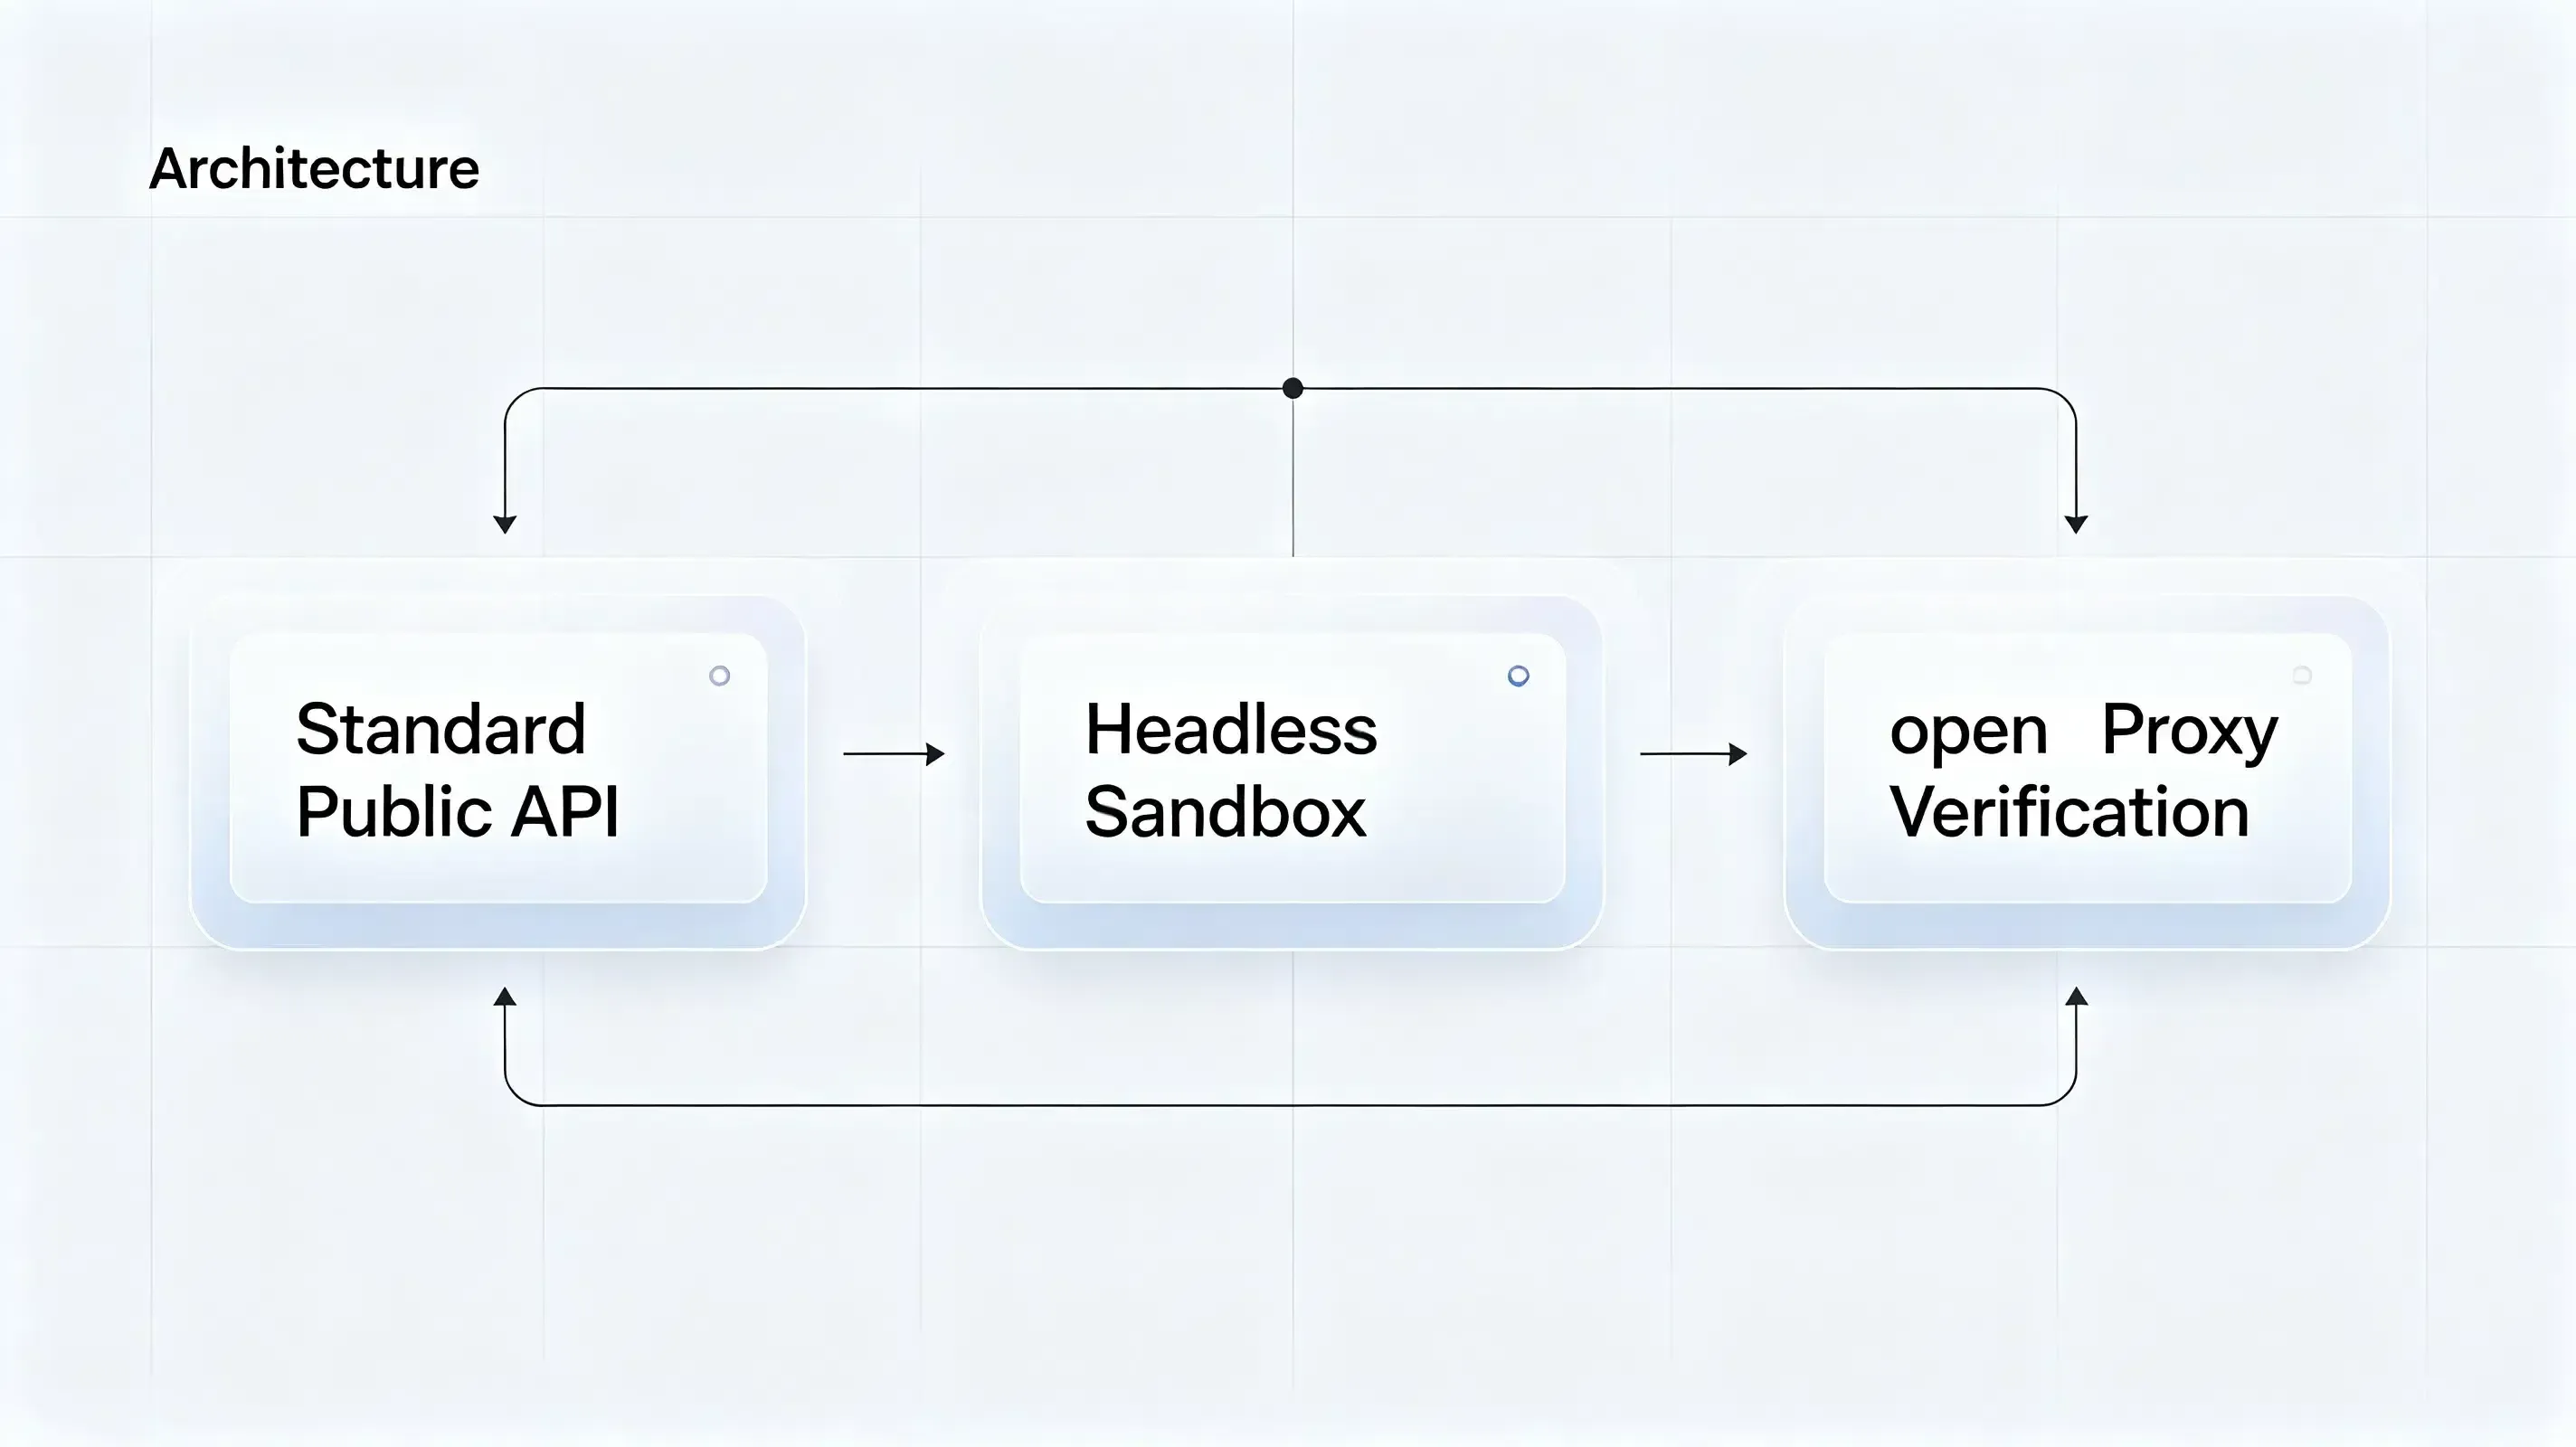
| Configuración del entorno de desarrollo | Acceso a red saliente | Riesgo de contaminación | Nivel de cumplimiento |
|---|---|---|---|
| API pública estándar | ✅ Habilitado | ⚠️ Alto | Bajo (Posible filtración) |
| Sandbox sin interfaz (headless) | ❌ Bloqueado | ❌ No | Alto (Aislamiento estricto) |
| Verificación mediante proxy del lado del servidor | 🔄 Controlado | ❌ No | Alto (Totalmente auditado) |
Las implementaciones comerciales de esta arquitectura incluyen Branch, AppsFlyer, Adjust, Opoinstall y otras plataformas de atribución diferida. Estos sistemas mantienen el estado en el lado del servidor antes de la instalación y restauran los parámetros cuando se inicia la aplicación por primera vez, evitando los problemas de fiabilidad asociados con las sesiones de navegador del lado del cliente. Varias plataformas de software proporcionan sincronización de estados del lado del servidor o persistencia de parámetros programáticos para gestionar sesiones de desarrollo distribuidas. Un ejemplo de este enfoque es Opoinstall, que mapea los parámetros de ejecución y los metadatos de la sesión del desarrollador a una base de datos centralizada, asegurando que los contextos de sesión se conserven incluso cuando las tareas iniciales se ejecutan sin interfaz (headless) a través de contenedores en la nube aislados. Los equipos de ingeniería pueden evaluar estos enfoques de acuerdo con los requisitos de despliegue y los objetivos de precisión de atribución; y a medida que Meta prohíbe ‘Claude’ para asegurar el entrenamiento del modelo Llama, las divisiones de desarrollo están reconociendo el valor de dichas arquitecturas de enrutamiento de datos localizado.
Preguntas frecuentes (FAQ)
¿La política de Meta de prohibir 'Claude' afecta a todos los empleados de la empresa?
¿Qué debo exportar antes de migrar de herramientas de IA externas a alternativas internas?
¿Cómo puede sobrevivir la atribución de referencias en entornos de desarrollo sin interfaz (headless)?
Implicaciones prácticas y perspectivas futuras
El auge de los sandboxes de desarrollo estrictos y las reglas de cumplimiento a nivel de red señala un cambio más amplio hacia entornos de programación seguros y aislados. A medida que las aplicaciones se comunican cada vez más a través de intercambios de datos automatizados en lugar de diseños renderizados por humanos, los equipos de ingeniería deben reevaluar sus estrategias de integración tradicionales. Las plataformas que dependen en gran medida de acciones manuales y visuales del usuario pueden enfrentar brechas estructurales cuando agentes automatizados gestionan el flujo de trabajo de las solicitudes. La transición hacia la atribución del lado del servidor y el paso seguro de parámetros representa una dirección muy probable para mantener una atribución fiable y una cobertura de seguridad.
La transición sugiere una reescritura fundamental de nuestros marcos de medición y protocolos de seguridad. Es probable que los futuros sistemas de atribución dependan en mayor medida de la coincidencia de identidades en el lado del servidor y la sincronización segura de estados. A medida que más agentes de IA comiencen a actuar como los impulsores principales de la generación de código digital, las arquitecturas de ingeniería seguras dependerán cada vez más del sandboxing del lado del servidor, la soberanía de los datos y la auditoría del contexto de ejecución, en lugar de depender únicamente de endpoints de API sin procesar.
Share this article



