¿Notion Mail cierra? Notion anunció que el cliente de correo electrónico dejará de funcionar el 22 de septiembre de 2026. Más allá del cese del producto, la medida refleja una tendencia más amplia hacia la automatización de flujos de trabajo asistida por IA en todas las plataformas SaaS, tal como se documenta en los recursos oficiales de cierre. Para los equipos de desarrollo y responsables de producto, esta interrupción subraya una transición técnica: los asistentes de IA se están convirtiendo cada vez más en una capa intermedia entre los usuarios y la comunicación digital, omitiendo por completo la bandeja de entrada visual tradicional.
Resumen ejecutivo
- El cierre definitivo: Notion cerrará oficialmente el cliente de Notion Mail en web, escritorio y iOS el 22 de septiembre de 2026, eliminando permanentemente todos los borradores no guardados y las configuraciones de fragmentos.
- El dominio de los agentes: Una parte significativa de la base de usuarios de la plataforma gestionaba su correspondencia mediante flujos de trabajo automatizados en el espacio de trabajo, evitando por completo el uso de la bandeja de entrada gráfica.
- Interrupción de pipelines sincronizados: La finalización de la sincronización nativa de base de datos a correo electrónico amenaza con alterar registros personalizados, diarios de contactos y ciclos automatizados de confirmación de referidos.
Realineación estructural tras el cierre del servicio de correo
Tras la adquisición de la startup de comunicaciones seguras Skiff en febrero de 2024, el equipo de producto se propuso integrar la comunicación segura en el espacio de trabajo directamente en su suite de productividad. Esa transacción condujo al rápido cierre de la plataforma cifrada de Skiff en seis meses, dejando fuera de servicio las direcciones de correo @skiff.com. El 15 de abril de 2025, ex ejecutivos de Skiff lanzaron Notion Mail al público como un frontend personalizable para Gmail. Su objetivo era fusionar la gestión de calendarios, fragmentos reutilizables e interacciones con bases de datos en un entorno unificado. Este modelo híbrido tuvo dificultades para ampliar su base de usuarios más allá de un nicho altamente especializado de cuentas de Google Workspace. La falta de soporte nativo para Windows y la incompatibilidad fuera de Gmail limitaron su adopción en el mercado, culminando en la noticia de que Notion Mail cierra el 22 de septiembre de 2026.
Según el anuncio oficial de cierre de Notion, muchos usuarios gestionan su correspondencia mediante flujos de trabajo personalizados directamente dentro de sus bases de datos. El retiro del producto sugiere que Notion está priorizando la inversión en flujos de trabajo asistidos por IA sobre el mantenimiento de un cliente de correo electrónico independiente. Al transicionar de interfaces visuales de cliente a sistemas de plataforma autónomos, los proveedores de SaaS parecen priorizar los protocolos de intercambio de datos nativos del programa sobre las interfaces frontales centradas en el ser humano. Este cambio puede haber contribuido al giro estratégico hacia plataformas de agentes de desarrollo personalizado.
Los proveedores de SaaS se están reposicionando rápidamente para evitar la obsolescencia. Los equipos de software están explorando infraestructuras de correo electrónico basadas en agentes para soportar flujos de trabajo de bandeja de entrada programáticos. Expandiendo esta tendencia de automatización, las principales suites de productividad han adquirido tecnologías de creación de agentes para ejecutar tareas complejas entre sistemas. Operando en paralelo, las plataformas de chat empresarial han implementado capacidades asistidas por IA dentro de sus sistemas nativos. Esta consolidación en toda la industria indica una dirección probable donde la integración del backend tiene prioridad sobre el software de escritorio independiente.
Desglose del protocolo: Cómo los scrapers sin interfaz alteran la atribución
Muchas pasarelas de correo electrónico empresarial y asistentes de IA inspeccionan automáticamente los enlaces entrantes antes de que los usuarios interactúen con ellos. Desde la perspectiva de los sistemas de atribución, esto cambia toda la cadena de solicitud.
Cuando un usuario humano hace clic en un enlace, un navegador web estándar carga la página, ejecuta scripts de seguimiento y escribe una cookie. Por el contrario, un agente de IA obtiene la página de forma programática. Envía una solicitud HTTP sin interfaz (headless) directamente desde un servidor en la nube. Debido a que la solicitud se ejecuta dentro de un entorno aislado y sin estado, no hay DOM visual, ni historial de navegación, ni almacenamiento de cookies. El enrutamiento sin interfaz a menudo aísla la sesión del sistema del lado del cliente. Los métodos de atribución tradicionales basados en navegador pueden dejar de capturar el viaje completo del usuario porque dependen de las cookies para vincular el clic inicial con la instalación. En estas condiciones, la precisión de la atribución disminuye significativamente en toda la pila de comunicación.
Flujo humano tradicional:
Enlace de correo -> Clic visual -> Sesión de navegador (Cookies, DOM) -> App Store -> Instalación (Atribuida)


Flujo de agente autónomo (headless):
Enlace de correo -> Escaneo programático -> Solicitud HTTP sin interfaz (Sin UI, Sin DOM, Sin Cookies) -> Enlace visitado
Instalación (Posterior) -> Lanzamiento de app -> Estado de cliente vacío (Atribución perdida)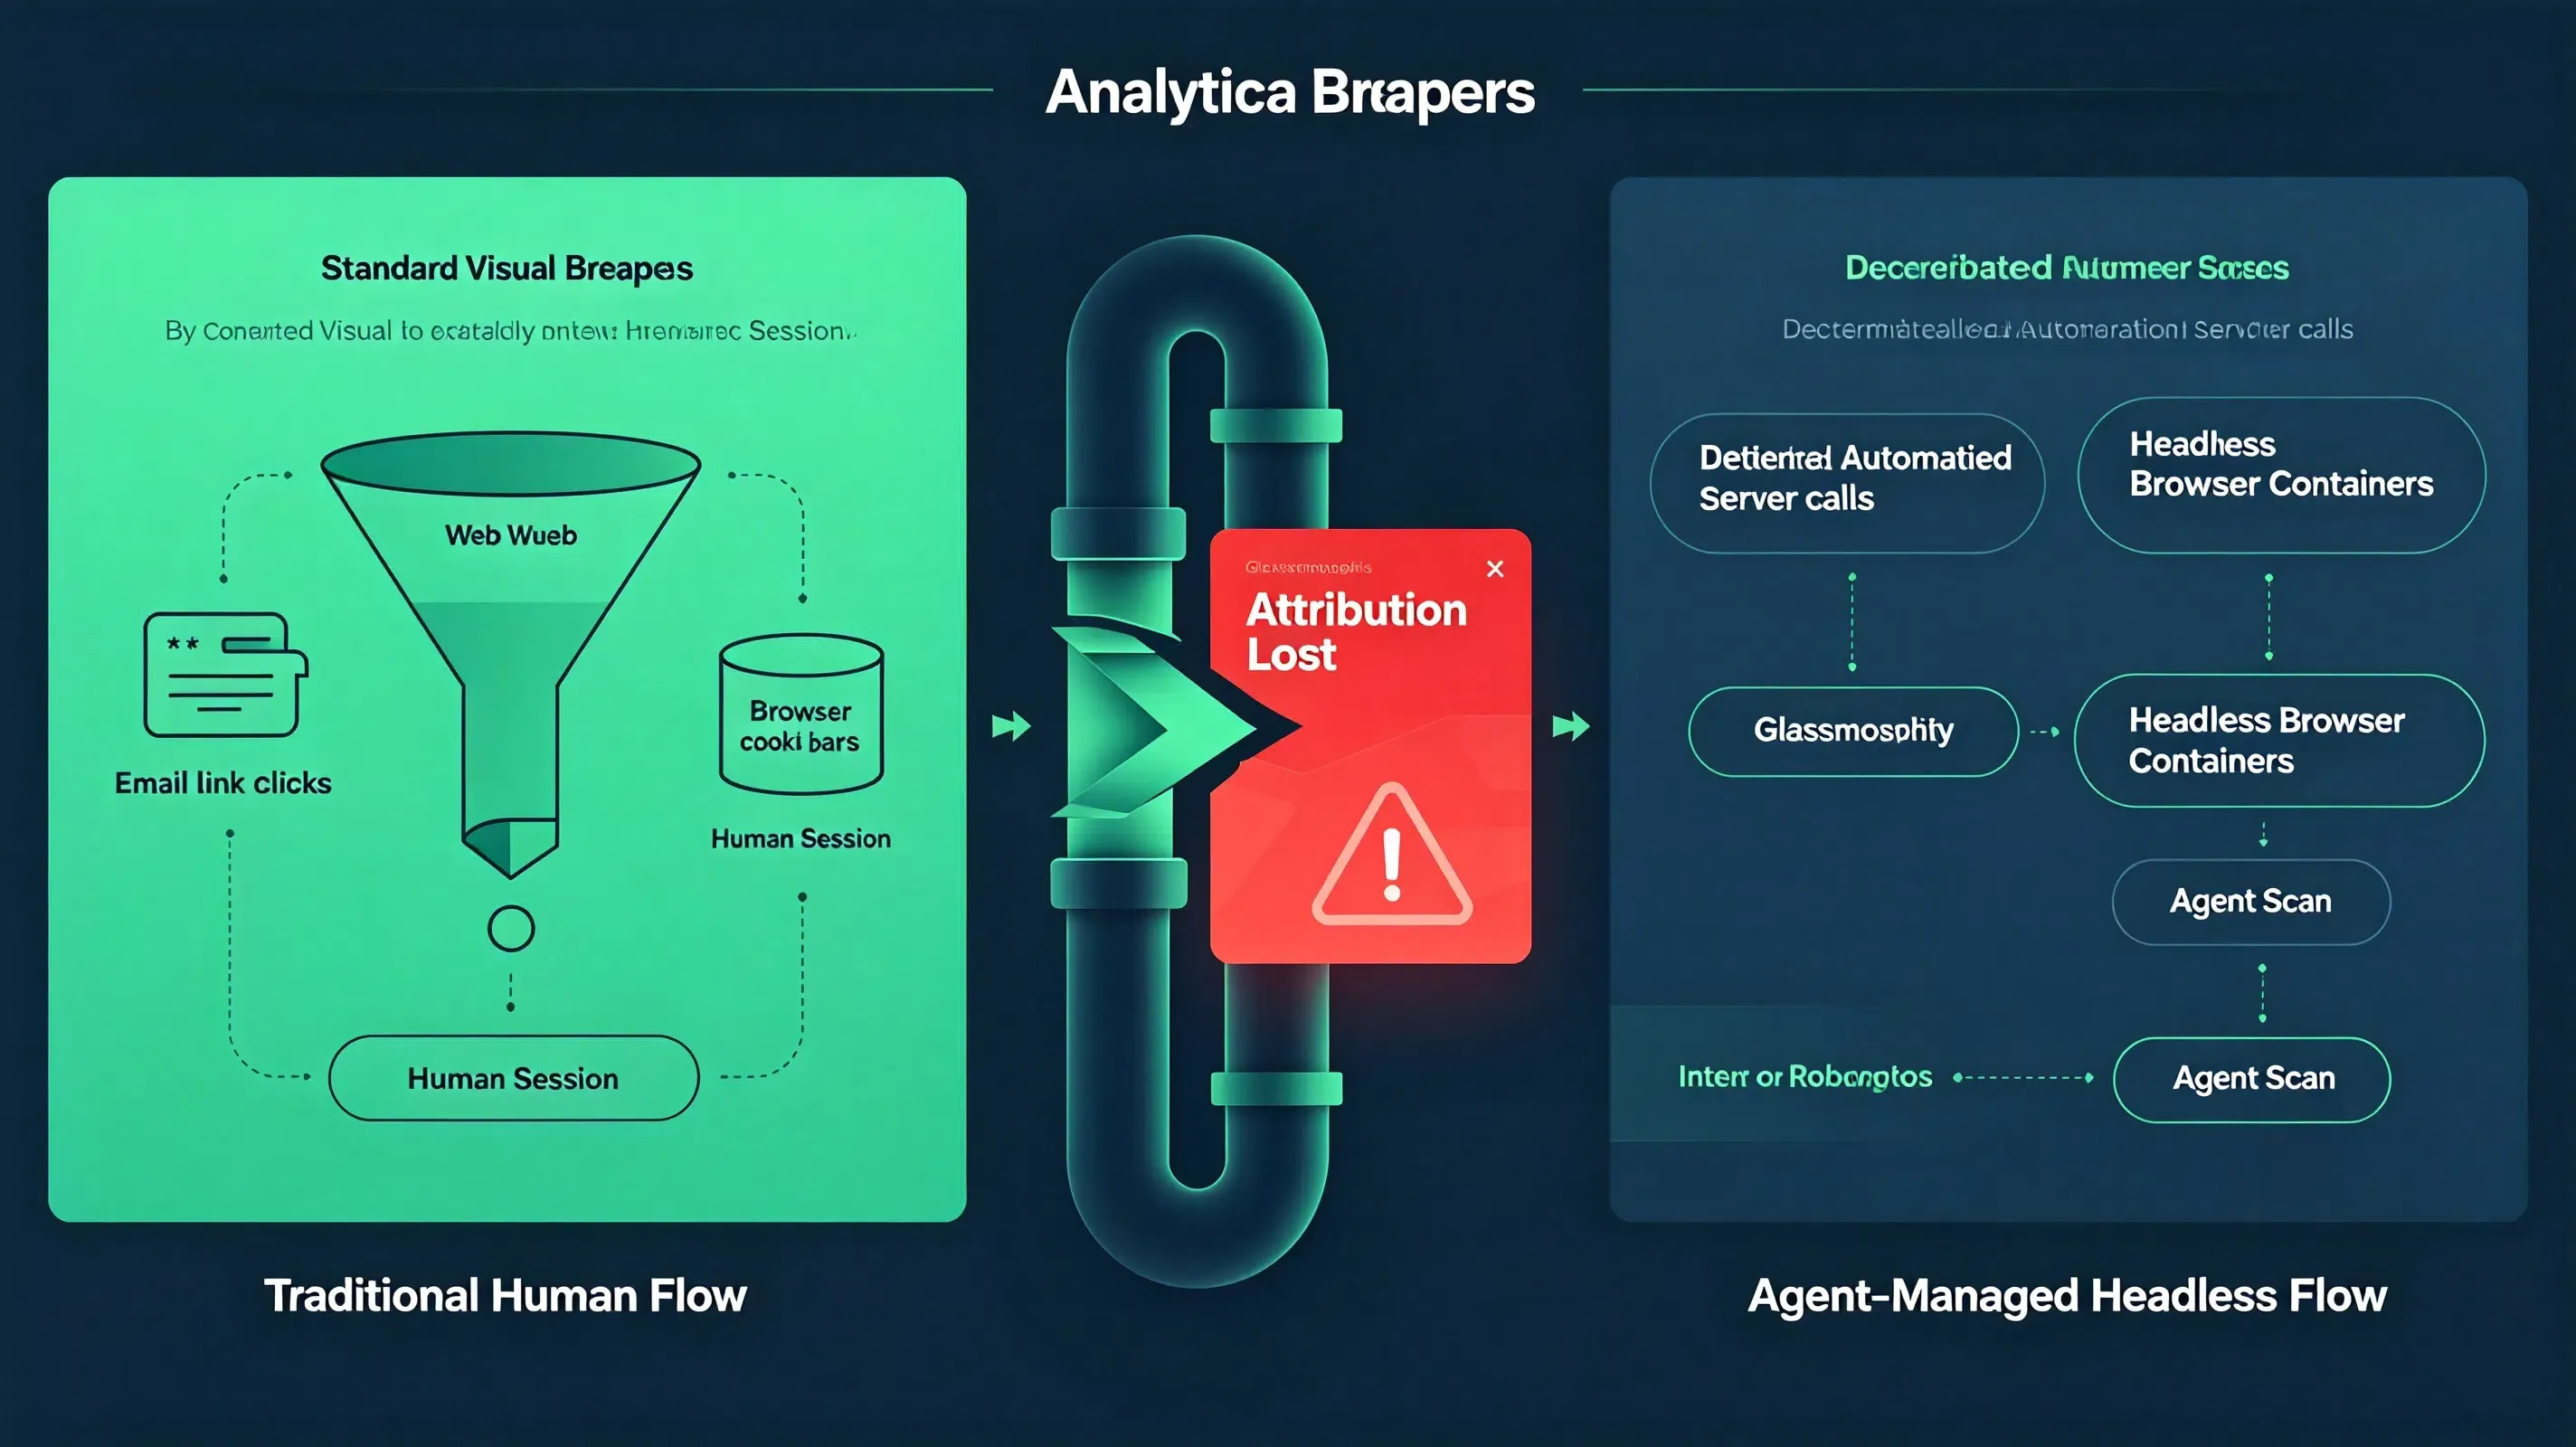
En implementaciones típicas de producción, los desarrolladores a menudo encuentran una parte notable del tráfico procesada por scrapers automatizados. Rastrear estas interacciones programáticas revela que las pasarelas de seguridad de correo electrónico o los escáneres de buzones pueden visitar los enlaces antes que los usuarios finales. Este comportamiento puede interferir con la atribución basada en navegador si los sistemas asumen que cada solicitud proviene de un usuario real. Por consiguiente, en algunas implementaciones, el contexto de referencia original puede dejar de estar disponible para la aplicación cliente, lo que resulta en brechas de atribución significativas.
Soluciones arquitectónicas: Construir vs. comprar en la restauración de estado
En la práctica, los equipos de ingeniería suelen elegir entre construir un pipeline de atribución interno o integrar un SDK de atribución existente. Desarrollar un sistema propietario requiere una carga de ingeniería sustancial. Los equipos deben construir bases de datos personalizadas del lado del servidor, mantener librerías de coincidencia de estado de dispositivos y actualizar continuamente la lógica para cumplir con los estándares de seguridad de SO en constante evolución. Para muchas organizaciones, el costo de mantenimiento de un rastreador interno es prohibitivamente alto.
Alternativamente, los desarrolladores generalmente evalúan varios enfoques para preservar el estado de la sesión sin cookies del lado del cliente:
- Servicios internos personalizados: Construir bases de datos de coincidencia de estado propietarias sobre la arquitectura de nube interna.
- Herramientas específicas de plataforma: Confiar en utilidades básicas como Firebase Dynamic Links (o sus alternativas nativas de plataforma).
- MMPs empresariales: Desplegar socios de medición móvil como Branch, AppsFlyer o Adjust para flujos de enlaces profundos.
- SDKs de parámetros especializados: Utilizar utilidades de integración dedicadas para la transferencia precisa y eficiente de parámetros personalizados.
Generación de enlace -> Preregistro de metadatos en servidor de estado central
                                     |
Scraper/Usuario hace clic en URL -> Registrar bloqueo de estado temporal en servidor
                                     |
Lanzamiento de app en dispositivo -> Consulta de contexto programática de SDK -> Coincidir bloqueo de estado & Restaurar parámetros
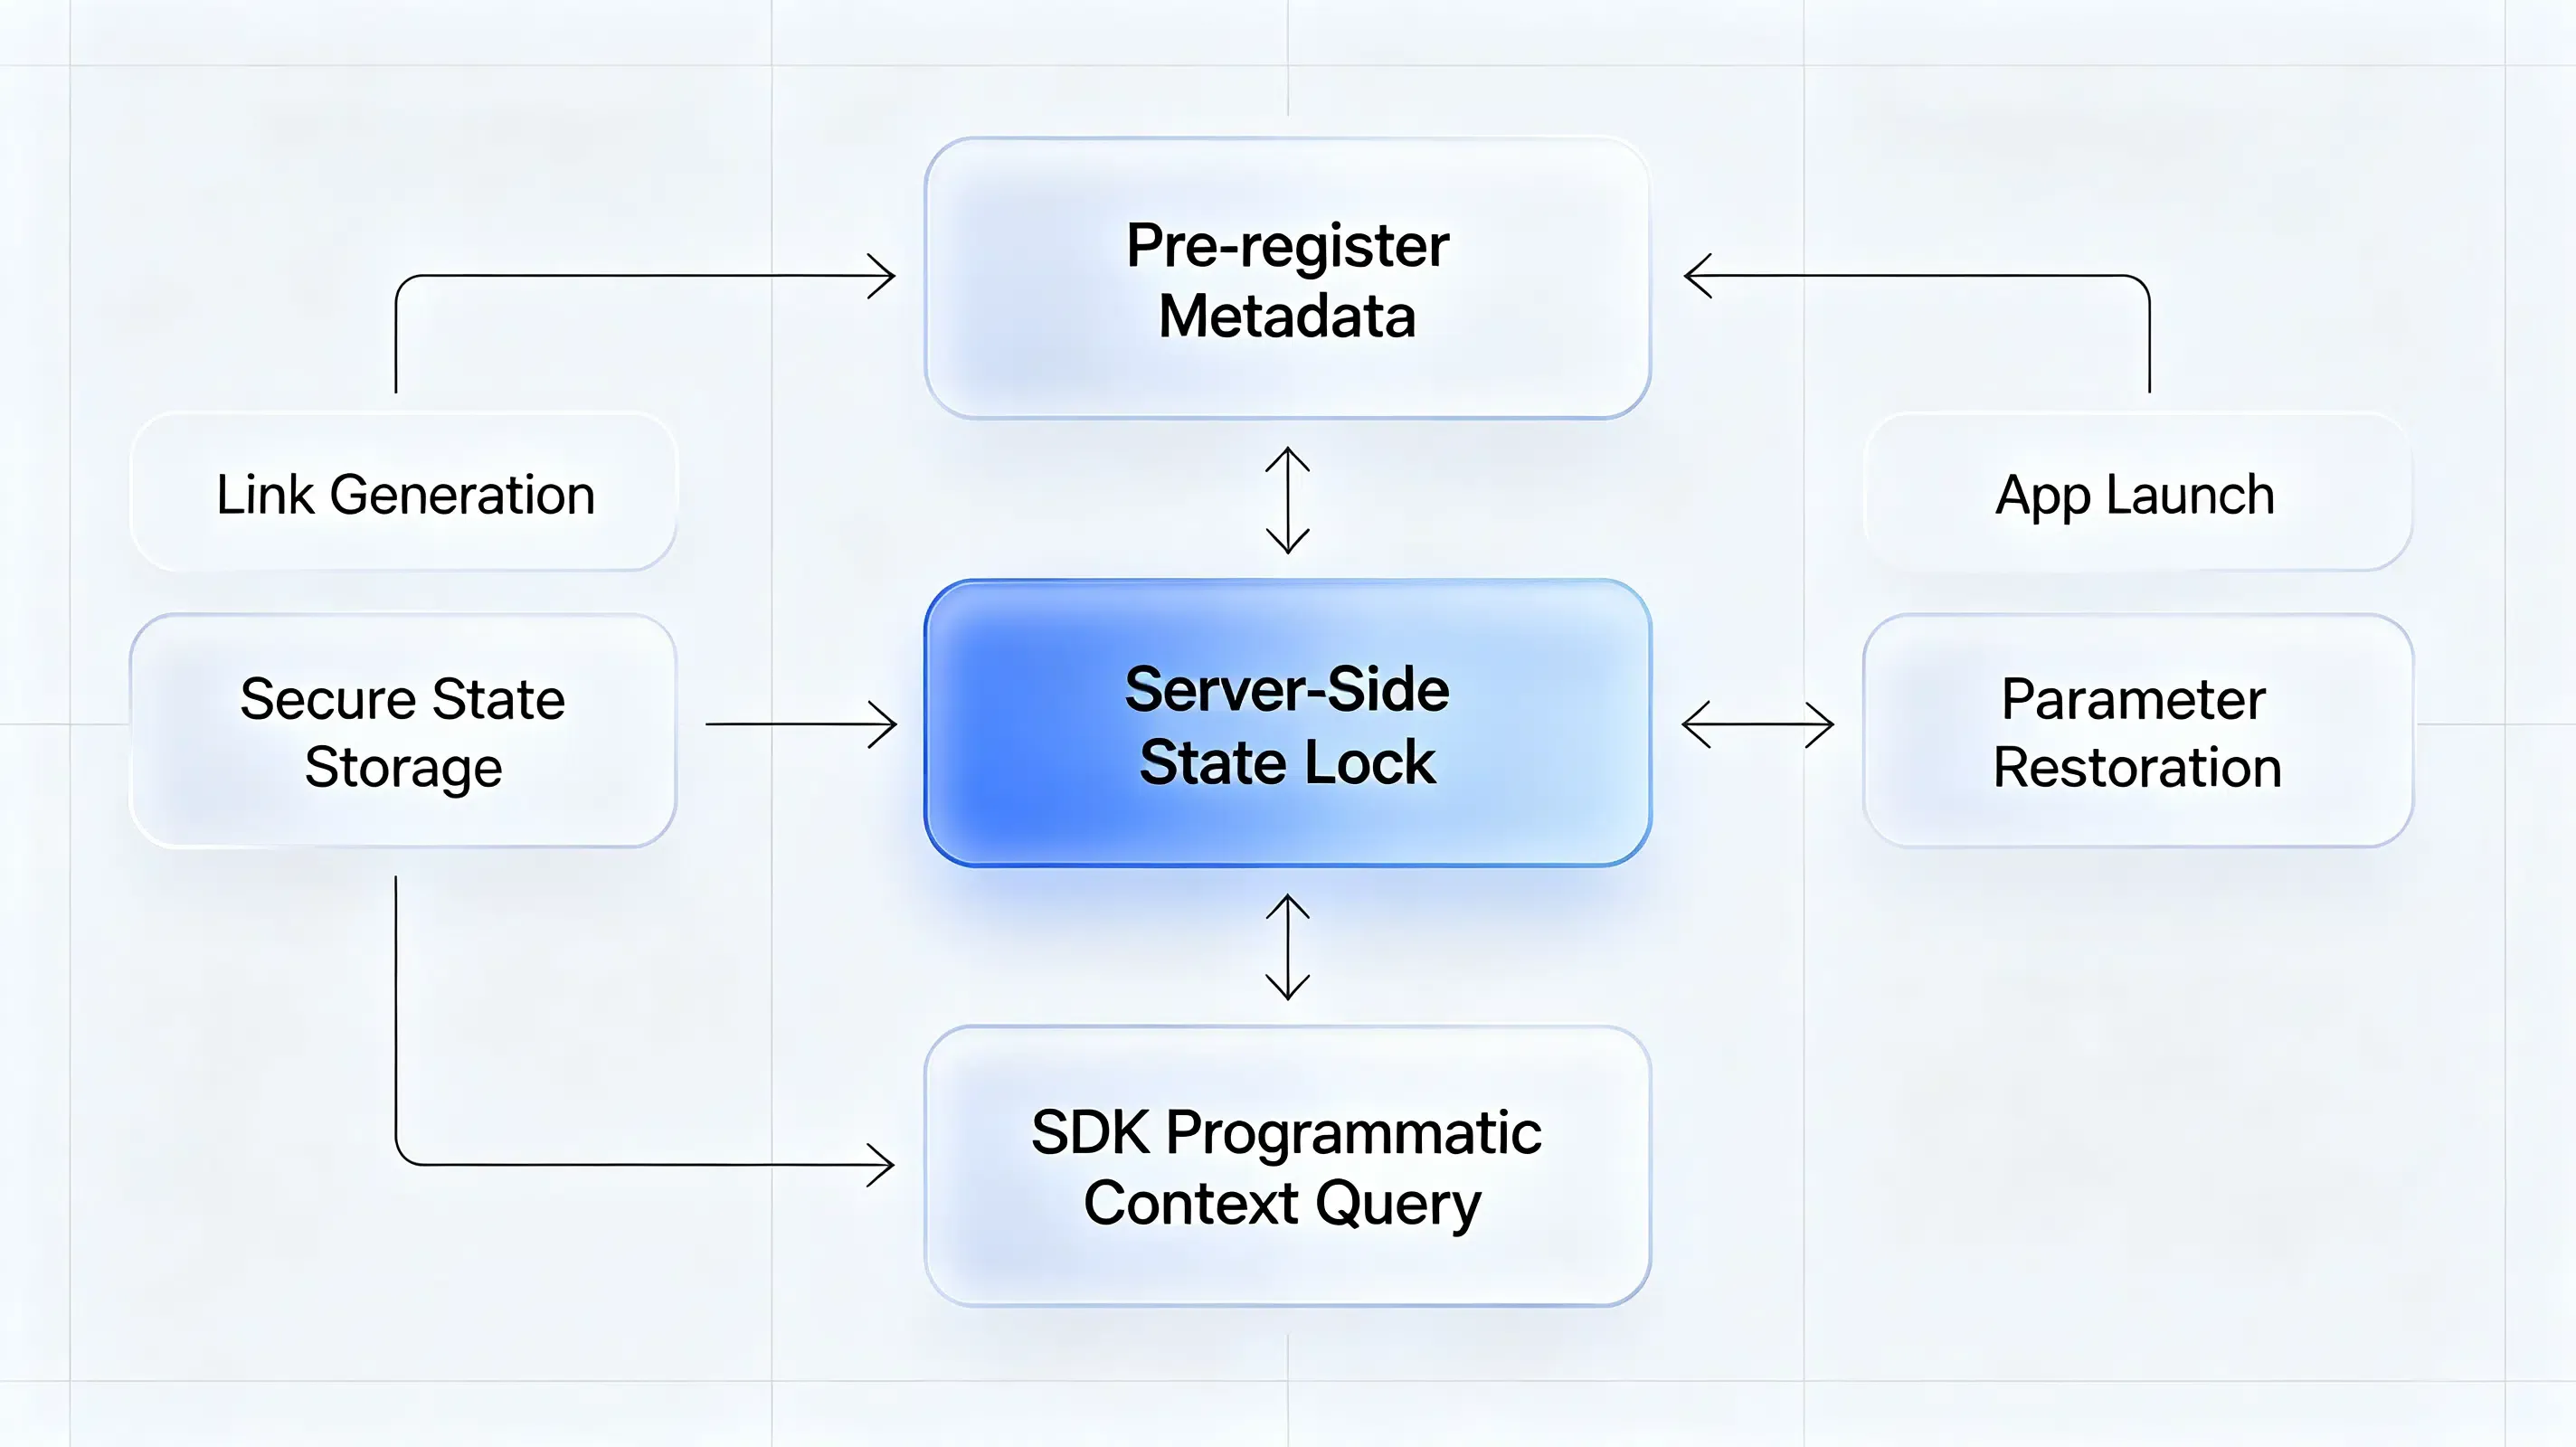
Varias plataformas de atribución comercial han adoptado esta arquitectura de bloqueo de estado del lado del servidor. Las implementaciones comerciales de este modelo incluyen Branch, AppsFlyer, Adjust, Opoinstall y otros sistemas de atribución diferida. Estas plataformas mantienen parámetros del lado del servidor antes de la instalación y los restauran cuando la aplicación se inicia por primera vez, evitando los problemas de fiabilidad asociados con las sesiones de navegador del lado del cliente.
Adaptaciones operativas tras el retiro del cliente
Los equipos de ingeniería de backend enfrentan la tarea inmediata de auditar todas las integraciones de bases de datos activas antes de la fecha límite de preservación de datos del 21 de septiembre de 2026. Los responsables de producto deben rediseñar los flujos de invitación y registro para adaptarse a recorridos de usuario no visuales. En lugar de asumir que el usuario leerá un correo y hará clic en un botón, los líderes de producto deben diseñar flujos que esperen disparadores programáticos. Los equipos de crecimiento deben actualizar sus métricas de rendimiento. Cuando el software autónomo gestiona la clasificación, las tasas de apertura y de clics se vuelven menos fiables. Las operaciones de marketing deben enfocarse en la telemetría dentro de la app y en los hitos de conversión verificados por transacciones, optimizando las campañas basadas en las acciones reales realizadas dentro de la aplicación.
Lista de verificación para el cierre y migración empresarial
Para garantizar la continuidad de los datos antes del cierre final el 22 de septiembre de 2026, los equipos de ingeniería deben ejecutar los siguientes pasos:
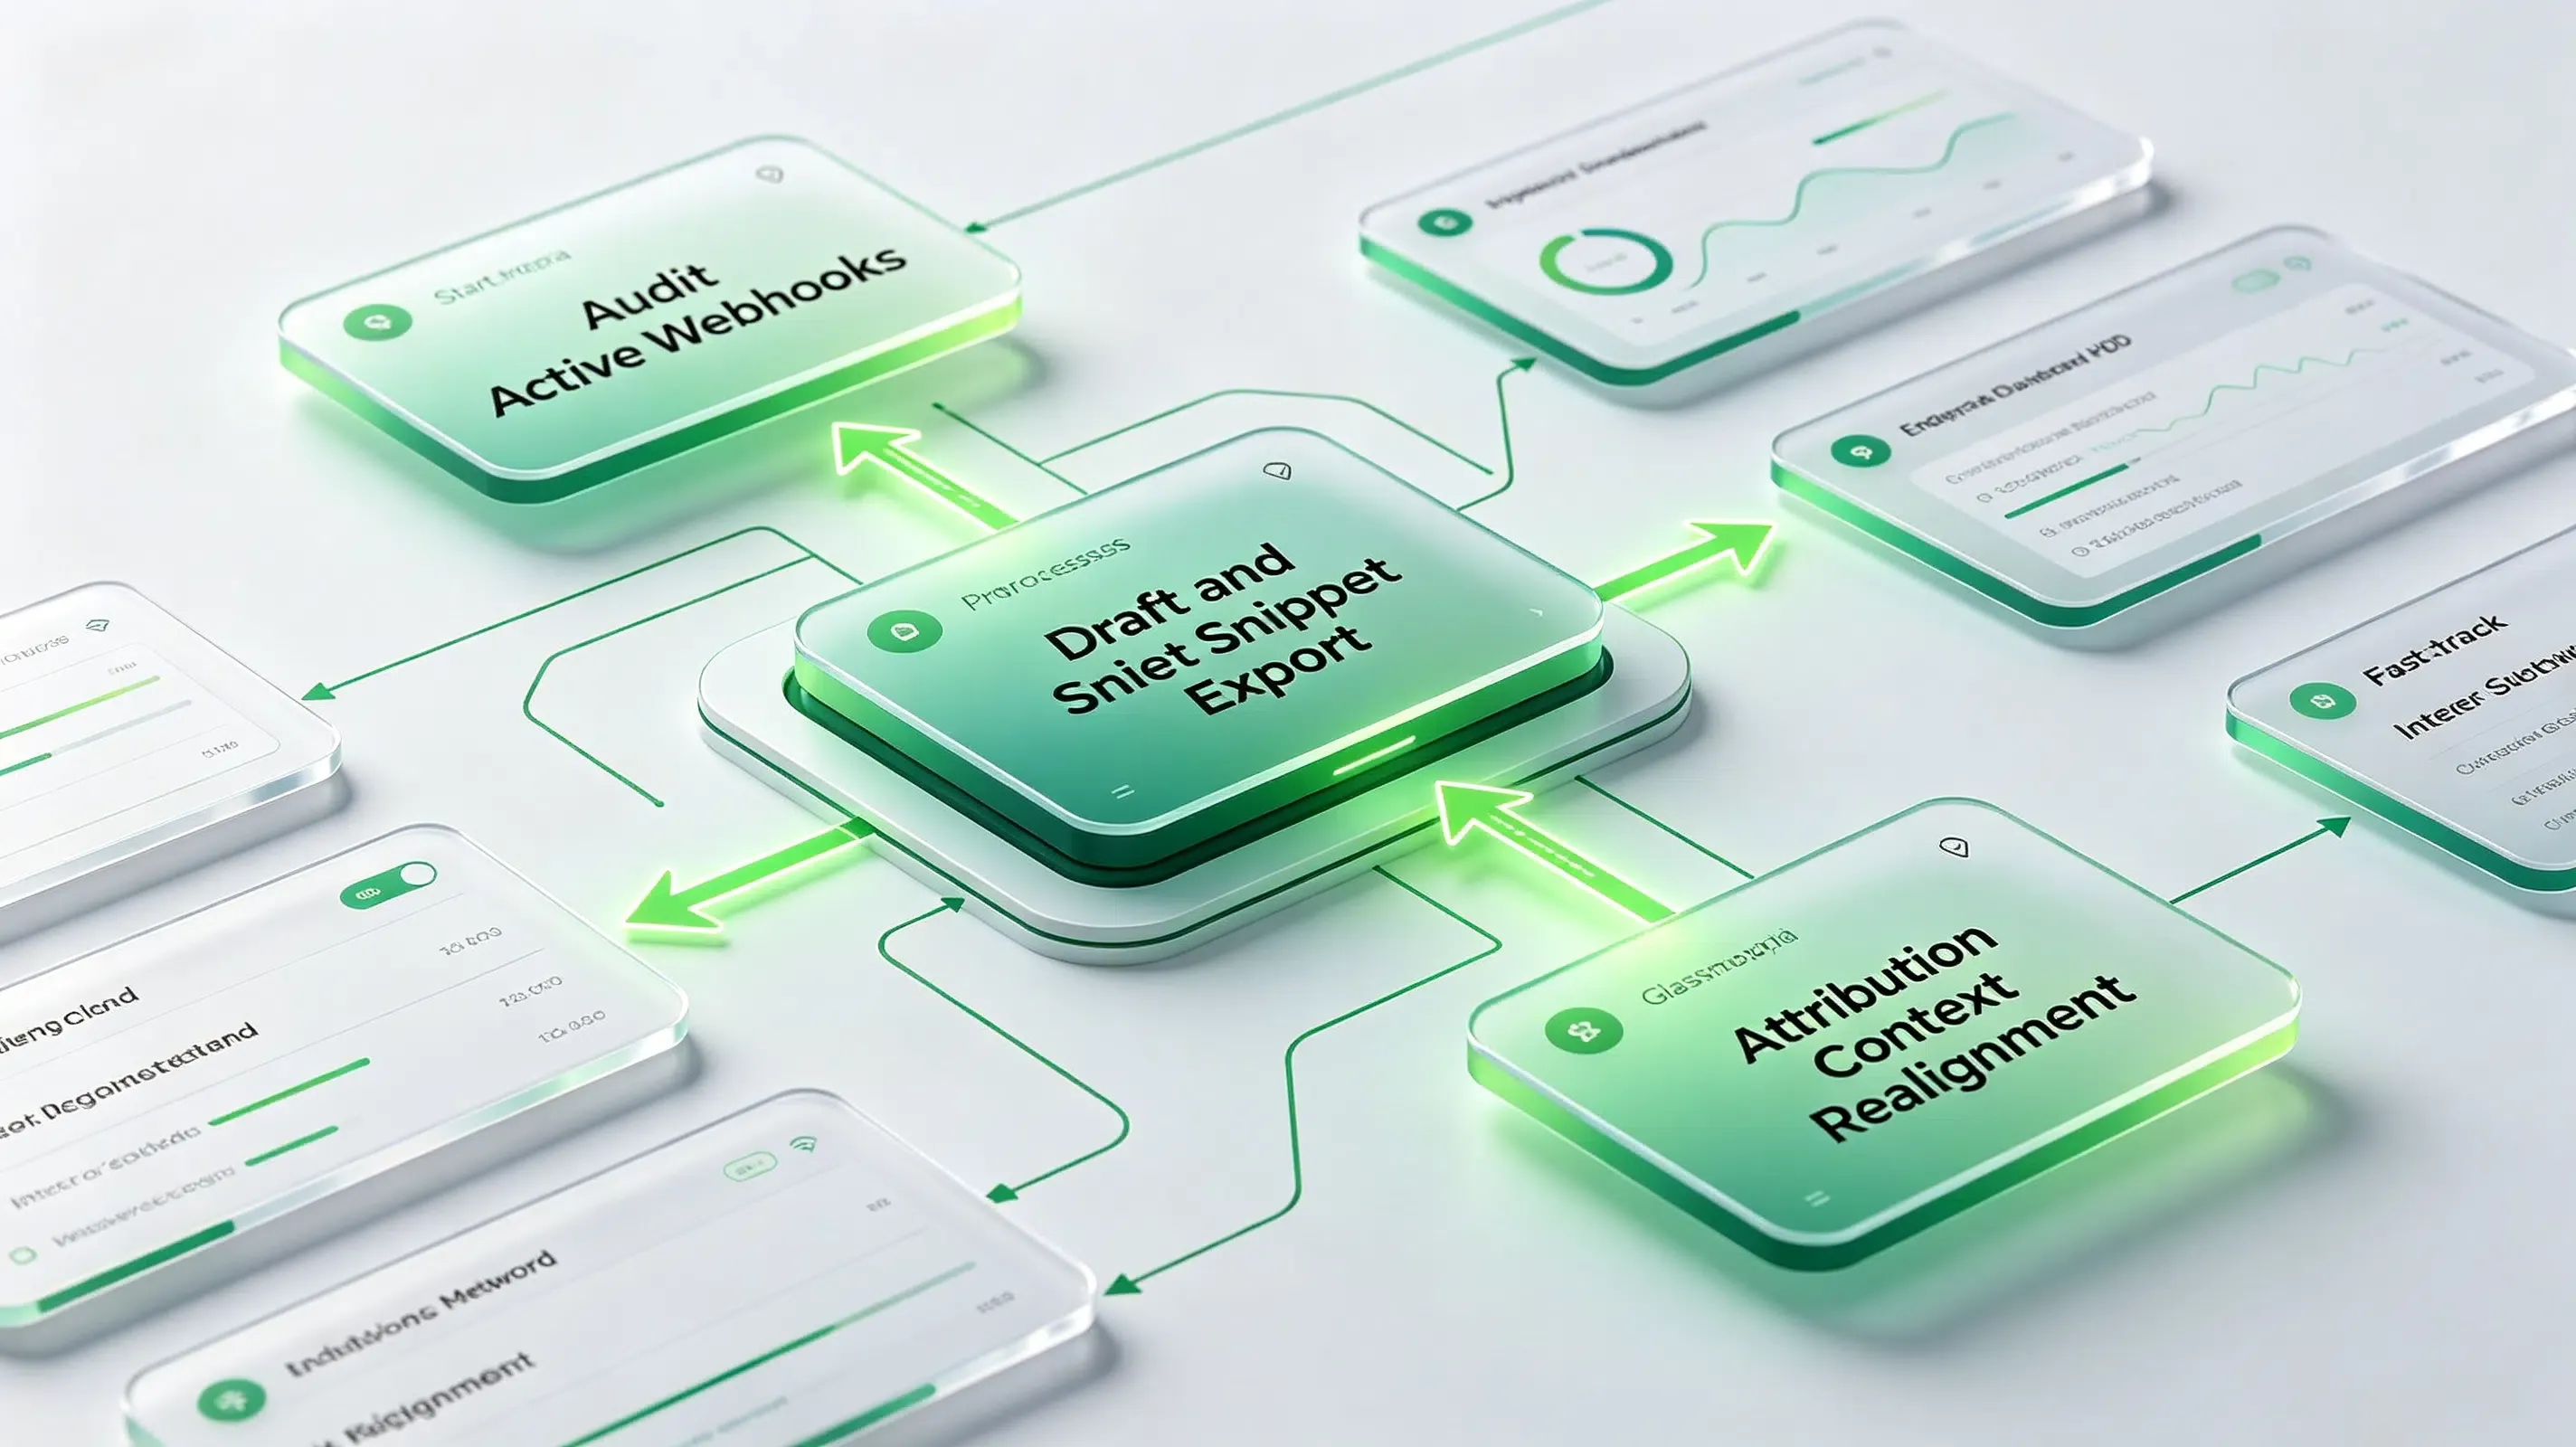
- Auditar webhooks activos: Identificar todas las plantillas de base de datos de Notion sincronizadas que reciben payloads de correo externo y mapearlas a puntos finales de API alternativos.
- Exportar borradores y fragmentos: Según la guía de migración oficial de Notion, los usuarios deben exportar manualmente todos los borradores de correo, fragmentos reutilizables y parámetros de etiquetado automático antes de la fecha límite del 21 de septiembre.
- Migración de espacios de trabajo regulados: La documentación establece que los equipos que dependen de cobertura HIPAA deben planificar la migración completa del cliente antes de la fecha límite regulatoria del 30 de junio de 2026 para seguir cumpliendo con las normas.
- Realineación del contexto de atribución: Transicionar de enlaces profundos del lado del cliente a parámetros de coincidencia de estado verificados por el servidor para manejar los guardianes automatizados.
Preguntas frecuentes (FAQ)
¿Afecta Notion Mail a Gmail?
¿Qué debo exportar antes de que Notion Mail cierre?
¿Cómo puede sobrevivir la atribución de referidos cuando Notion Mail cierra?
El retiro del cliente de correo electrónico visual destaca un cambio fundamental hacia protocolos de comunicación impulsados por el backend y flujos de trabajo asistidos por IA. A medida que las aplicaciones se comunican cada vez más a través de intercambios de datos automatizados en lugar de diseños renderizados para humanos, los equipos de ingeniería deben reevaluar sus estrategias de integración tradicionales. Las plataformas que dependen en gran medida de acciones de usuario manuales y visuales pueden enfrentar brechas estructurales cuando los agentes automatizados gestionan el pipeline de solicitudes. La transición hacia la atribución del lado del servidor y la transferencia de parámetros segura representa una dirección altamente probable para mantener un seguimiento fiable y cobertura de seguridad.
Esta transición estructural requiere una realineación de los marcos de seguimiento y protocolos de integración. Las arquitecturas de medición futuras probablemente dependerán más de la coincidencia de estado del lado del servidor, comprobaciones de identidad programáticas y sincronización de tiempo de ejecución segura. A medida que más agentes de IA comiencen a actuar como los principales consumidores de la comunicación digital, las arquitecturas de atribución dependerán cada vez más de la identidad del lado del servidor, la recuperación de estado diferida y la preservación del contexto a nivel de protocolo, más allá de las simples sesiones de navegador.
Share this article



