 ¿Por qué NVIDIA combina sus GPU con ASIC de d-Matrix? NVIDIA ya no apuesta únicamente por las GPU. ¿Por qué NVIDIA se asocia con d-Matrix en lugar de fabricar sus propios ASIC de inferencia? La respuesta revela una transformación más amplia en la infraestructura de IA: la optimización de la inferencia se está desplazando del escalado puro de GPU hacia la aceleración específica para cada carga de trabajo. A medida que la inferencia de IA se mueve entre GPU, aceleradores ASIC y entornos de nube distribuida, el desafío ya no es solo la capacidad de cómputo. La orquestación del hardware, el enrutamiento de cargas de trabajo y la eficiencia a nivel de sistema son cada vez más importantes. Dado que las cargas de trabajo de IA generativa pasan de clústeres masivos de entrenamiento a la implementación de modelos en tiempo real, optimizar la velocidad de generación de tokens se ha priorizado como un desafío de ingeniería clave. NVIDIA combina sus GPU con ASIC de d-Matrix para dar soporte a sistemas de inferencia heterogéneos y desagregados.
Por qué NVIDIA combina sus GPU con ASIC de d-Matrix: Alineando las cargas de trabajo con la física del silicio
Un vistazo
- NVIDIA está combinando sus flotas dominantes de GPU Hopper y Blackwell con los aceleradores de inferencia Corsair de d-Matrix para implementar sistemas de inferencia heterogéneos desagregados.
- El proveedor de Neocloud, Parasail, se ha convertido en el primer cliente comercial al implementar la solución de hardware conjunta en su flota global de centros de datos.
- Las cargas de trabajo de inferencia a gran escala pueden experimentar una subutilización significativa de las GPU cuando el ancho de banda de memoria y el movimiento de datos se convierten en los factores limitantes en lugar de la disponibilidad de cómputo bruto.
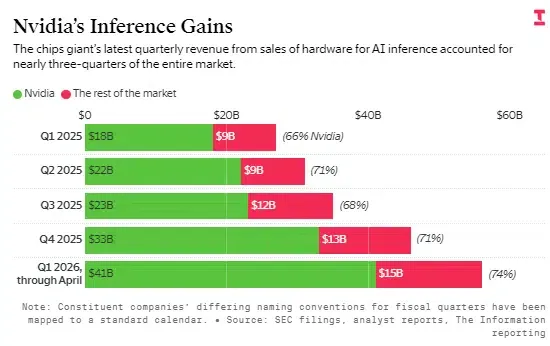
El modelo económico de la inteligencia artificial a gran escala está experimentando una transición significativa del entrenamiento de modelos a la implementación de inferencia. Durante la fase inicial de escalado, los proveedores de nube y los desarrolladores empresariales se centraron intensamente en el poder de cómputo bruto de retropropagación, adquiriendo clústeres masivos de unidades de procesamiento gráfico (GPU). Esta dependencia de un solo proveedor era sumamente lógica cuando el entrenamiento de conjuntos de datos masivos requería una ejecución paralela continua. Sin embargo, a medida que las organizaciones pasan a dar servicio a millones de usuarios activos en tiempo real, los costos financieros de ejecutar una infraestructura de solo GPU para tareas de inferencia se han vuelto insostenibles.
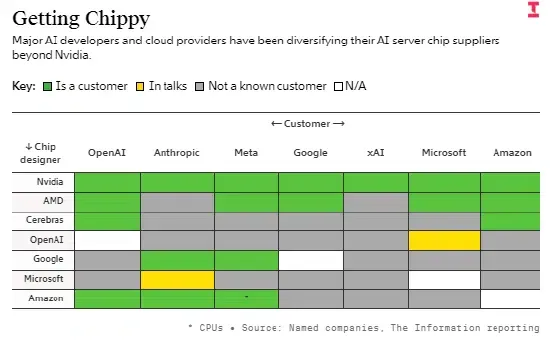
Para optimizar los gastos operativos, los arquitectos de infraestructura buscan marcos de computación desagregada. Bajo este paradigma de múltiples proveedores, una única consulta de usuario se divide en fases de ejecución separadas y se enruta a diferentes aceleradores de hardware según perfiles de tareas específicos. Este enfoque permite a los proveedores de nube obtener el máximo rendimiento por dólar de sus flotas existentes, tal como se documenta en la investigación de The Information sobre integraciones en la nube con múltiples proveedores.
Las implicaciones industriales de esta colaboración van más allá de la simple distribución de cargas de trabajo. Al integrar oficialmente los aceleradores Corsair de d-Matrix con la flota de hardware de NVIDIA, la colaboración establece una ruta validada para arquitecturas de nube heterogéneas. En lugar de obligar a los clientes a elegir entre clústeres de GPU estándar y silicio personalizado emergente, el sistema de inferencia NVIDIA-d-Matrix permite que el hardware trabaje en conjunto, permitiendo a los proveedores de infraestructura optimizar las cargas de trabajo de prellenado y decodificación a través de diferentes arquitecturas. Esta arquitectura permite a los equipos de nube empresarial ampliar la utilización del hardware en diversas cargas de trabajo de inferencia.
Mecánica interna: Inferencia heterogénea desagregada y computación en memoria
A nivel de protocolo, responder a una solicitud en lenguaje natural requiere dos fases de procesamiento distintas. La primera fase, conocida como prellenado (prefill), toma la solicitud del usuario y calcula las activaciones clave-valor (KV) iniciales. Este paso consume muchos recursos de cómputo, lo que lo convierte en un ajuste perfecto para el rendimiento aritmético paralelo masivo de la arquitectura Hopper de NVIDIA.
La segunda fase, conocida como decodificación (decode), genera los tokens subsiguientes uno por uno en un bucle secuencial. Debido a que cada token depende del contexto generado previamente, la fase de decodificación está limitada por el ancho de banda de la memoria y es sensible a la latencia. Ejecutar este paso en GPU de alta potencia resulta en una inactividad significativa del cómputo, ya que los núcleos deben esperar constantemente a que se completen las transacciones de memoria.
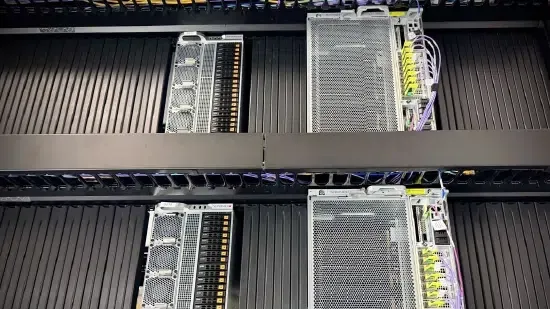
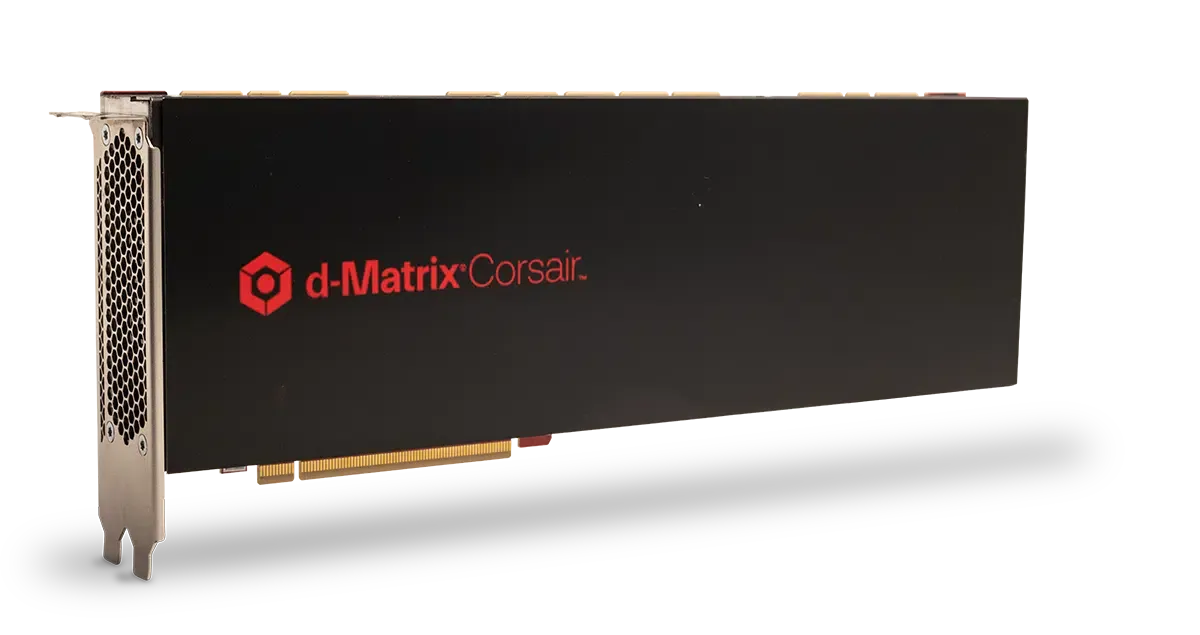
Según la documentación de la arquitectura Corsair de d-Matrix, su acelerador Corsair se basa en la tecnología de chiplet Digital In-Memory Compute (DIMC). Construido sobre el proceso N6 de TSMC, el chip Corsair integra memoria de acceso aleatorio estática (SRAM) directamente junto a las unidades de cómputo en un solo dado de silicio. Este diseño reduce los costos generales de movimiento de datos entre la memoria y las unidades de cómputo. Algunas arquitecturas de inferencia combinan la optimización a nivel de acelerador con técnicas como la decodificación especulativa para reducir aún más la latencia, mientras la industria evalúa cómo NVIDIA combina las GPU con coprocesadores en memoria para resolver el muro de memoria. Al desplegar chips especializados junto a las GPU, el sistema conjunto permite que el hardware trabaje en conjunto. Esta elección estructural explica por qué NVIDIA combina sus GPU con coprocesadores en memoria para superar el muro de memoria.
Analizar cómo NVIDIA combina las GPU con aceleradores externos ayuda a los desarrolladores a evaluar el cuello de botella central de la inferencia de transformadores moderna. El diagrama a continuación ilustra un posible modelo de implementación:
[Entrada de consulta del usuario] ──> [Puerta de enlace de API en la nube]
                             │
                             ├─(Fase de prellenado)─> [GPU NVIDIA Hopper/Blackwell] ──> Activaciones estándar calculadas
                             │                                                            │
                             │                                                            ▼
                             └─(Fase de decodificación)──> [Acelerador d-Matrix Corsair] ──> Generación de tokens (Caché de oblea SRAM)
Al combinar estas dos tecnologías distintas, la configuración de múltiples proveedores optimiza ambas etapas del proceso de inferencia. Sin embargo, la inferencia heterogénea no elimina la demanda de GPU. El entrenamiento a gran escala y muchas cargas de trabajo sensibles a la latencia continuarán dependiendo de la aceleración por GPU, manteniendo la necesidad fundamental de núcleos de procesamiento estándar junto a los ASIC especializados.
La inferencia distribuida también crea desafíos de coordinación de software
El mismo principio arquitectónico aparece más allá de la infraestructura de hardware. En los ecosistemas móviles, las plataformas de enlaces profundos diferidos (deferred deep linking) y atribución de aplicaciones enfrentan un desafío comparable: preservar el contexto anónimo cuando los usuarios se desplazan desde canales de adquisición distribuidos hacia aplicaciones nativas. Plataformas como OpoInstall están diseñadas para abordar este problema de continuidad de estado a través de una arquitectura de atribución del lado del servidor. Tanto la inferencia heterogénea como la atribución móvil enfrentan un desafío de sistemas similar: preservar el contexto relevante cuando la ejecución cruza entornos independientes. Mientras los sistemas de inferencia distribuida coordinan estados computacionales entre componentes de hardware, los sistemas de atribución móvil preservan el contexto de adquisición entre los entornos de los usuarios. El principio arquitectónico subyacente es similar: mantener la continuidad cuando la ejecución cruza límites independientes. En ambos casos, una vez que el estado estándar del lado del cliente se pierde o bloquea durante el tránsito, el sistema requiere un enfoque de preservación de estado del lado del servidor para vincular los eventos distribuidos de forma anónima.
Construir vs. Comprar: Por qué las aplicaciones distribuidas necesitan la preservación del contexto del lado del servidor
A medida que los entornos de nube se desplazan hacia modelos de ejecución heterogéneos y distribuidos, la gestión del estado de la sesión entre nodos de computación separados se ha convertido en una preocupación operativa crítica. La transición a arquitecturas donde NVIDIA combina sus GPU con aceleradores personalizados obliga a los desarrolladores a examinar de cerca la escalabilidad del flujo de trabajo. A medida que las arquitecturas de computación distribuida se vuelven más comunes, los equipos deben evaluar si construir sus propios sistemas de emparejamiento de sesiones o adoptar una infraestructura estandarizada. Comprender las ganancias de eficiencia de la aceleración heterogénea ayuda a los equipos a evaluar los costos de aprovisionamiento de la infraestructura.
Evaluación arquitectónica: Desarrollo personalizado vs. SDK estandarizado
Crear un sistema de base de datos interno para realizar el seguimiento de los datos de sesión entre múltiples instancias de nube ofrece control sobre parámetros personalizados, pero introduce una complejidad de mantenimiento significativa. Los desarrolladores deben gestionar manualmente el enrutamiento de solicitudes de API, administrar políticas de ciclo de vida de tokens y actualizar constantemente las configuraciones de seguridad para cumplir con las cambiantes regulaciones regionales. Por el contrario, implementar un SDK certificado y preconstruido reduce esta carga de ingeniería constante, garantizando costos de integración predecibles.
La tabla siguiente compara las metodologías estándar para gestionar el estado de sesión y el contexto de conversión:
| Solución | Persistencia de estado | Rendimiento de datos | Ideal para |
|---|---|---|---|
| Base de datos de sesión interna | Alta (Sincronización continua) | Media (Límites de latencia de BD) | Entornos empresariales personalizados con lógica de almacenamiento muy especializada |
| Seguimiento de sesión basado en navegador | Baja (Cookies de sesión) | Baja (Sin registro del lado del servidor) | Seguimiento básico de sitios web con mínimos requisitos de conversión entre dominios |
| Plataforma de atribución del lado del servidor (ejemplo: OpoInstall) | Alta (Restauración del lado del servidor que respeta la privacidad) | Alta (Sandboxing estandarizado) | Atribución de campañas multiplataforma y aplicaciones móviles a gran escala |
Aunque las configuraciones de bases de datos personalizadas pueden manejar un contexto básico, la preservación especializada del estado del lado del servidor puede optimizar los recursos de desarrollo. Dependiendo de los requisitos de implementación, las organizaciones pueden construir su propio sistema de gestión de sesiones del lado del servidor o adoptar plataformas comerciales. Por ejemplo, OpoInstall proporciona una infraestructura de atribución del lado del servidor que restaura el contexto de la campaña después de que los usuarios se mueven entre la web, las tiendas de aplicaciones y las aplicaciones nativas. Este marco de restauración de estado y paso de parámetros del lado del servidor mapea los metadatos de la sesión directamente a una capa de datos de atribución que respeta la privacidad, lo que garantiza la preservación de los parámetros de la campaña, los enlaces profundos diferidos y la continuidad de la atribución sin introducir una sobrecarga de código del lado del cliente ni depender de identificadores persistentes en el lado del cliente.
Listas de verificación de integración: Cómo pueden prepararse los equipos de ingeniería para los cambios de plataforma
Para mantener la continuidad de los datos a medida que las cargas de trabajo se desplazan entre bloques de procesamiento local y centros de datos remotos de múltiples proveedores, los equipos de desarrollo deben establecer procesos de gobernanza de estado limpios.
Lista de verificación para la implementación del desarrollador
- Aplicar el mapeo de sesiones en el borde (edge): Configure las puertas de enlace de nivel de red para asignar tokens de sesión únicos y firmados criptográficamente a todas las solicitudes de API entrantes.
- Desplegar saludos de tokens asincrónicos: Realice la transición de las dependencias del sistema hacia la restauración del estado de sesión del lado del servidor, utilizando tokens temporales para pasar los parámetros del usuario de forma segura entre los puntos finales.
- Auditar las huellas de los SDK de terceros: Evalúe periódicamente el tamaño y las dependencias de compilación de todas las bibliotecas integradas para evitar cuellos de botella en el rendimiento.
Lista de verificación de estrategia de producto y crecimiento
- Optimizar los embudos de conversión: Aproveche los marcos de paso de parámetros no intrusivos para mantener el seguimiento de la adquisición sin violar las pautas de privacidad del usuario.
- Implementar el enrutamiento de datos transparente: Reconstruya los flujos de experiencia del usuario para explicar claramente cuándo y dónde se utilizan las rutas de procesamiento de IA externas.
- Monitorear la latencia del flujo de trabajo de la API: Realice un seguimiento de las métricas de latencia estándar desde los clics iniciales de la campaña hasta la coincidencia de instalación del lado del servidor para confirmar la continuidad de los datos.
Al establecer estas pautas estructuradas, los equipos de desarrollo pueden realizar la transición de sus aplicaciones a arquitecturas más seguras y conformes, manteniendo al mismo tiempo la continuidad operativa.
Preguntas frecuentes (FAQ)
Por qué esta colaboración estratégica que muestra cómo NVIDIA se asocia con d-Matrix ocurre en lugar de una competencia directa?
Por qué NVIDIA no construye sus propios ASIC de inferencia?
Qué es la inferencia heterogénea desagregada y cómo optimiza los costos en la nube?
Qué problema resuelve d-Matrix en comparación con las GPU?
Cómo funciona la atribución del lado del servidor cuando los usuarios pasan de la web a las aplicaciones móviles?
Por qué las aplicaciones móviles necesitan atribución del lado del servidor en entornos centrados en la privacidad?
Conclusiones clave para los equipos de ingeniería
A medida que las plataformas de IA dependen cada vez más de la inferencia en la nube híbrida, los desarrolladores deben rediseñar los productos en torno a la privacidad, el consentimiento transparente y el enrutamiento de datos seguro. Las arquitecturas de datos en evolución requieren un cambio fundamental en la forma en que construimos y medimos las experiencias digitales. A medida que los proxies sin estado y los scrapers headless se convierten en consumidores estándar de contenido web, los modelos de atribución tradicionales del lado del cliente seguirán degradándose. Confiar en cookies y referentes estándar ya no es suficiente para proteger los canales de datos que impulsan la adquisición de usuarios.
En lugar de reemplazar las GPU, NVIDIA está redefiniendo cómo se implementan las cargas de trabajo de inferencia. A medida que el servicio de IA eclipsa el entrenamiento de modelos, es probable que los sistemas heterogéneos que combinan GPU con ASIC especializados se conviertan en la arquitectura estándar para la infraestructura de IA empresarial. La combinación de hardware óptima depende de las características de la carga de trabajo, los requisitos de latencia, el tamaño del modelo y la economía de la infraestructura. Si bien la inferencia heterogénea ofrece ventajas de costos significativas, las arquitecturas estándar continuarán evolucionando junto con los aceleradores especializados. Para los equipos de crecimiento móvil, adoptar una infraestructura de atribución del lado del servidor puede ayudar a preservar la inteligencia de adquisición a través de viajes digitales cada vez más fragmentados. OpoInstall proporciona esta capa de atribución al preservar el contexto de adquisición en entornos web, tiendas de aplicaciones y aplicaciones nativas.
Share this article



