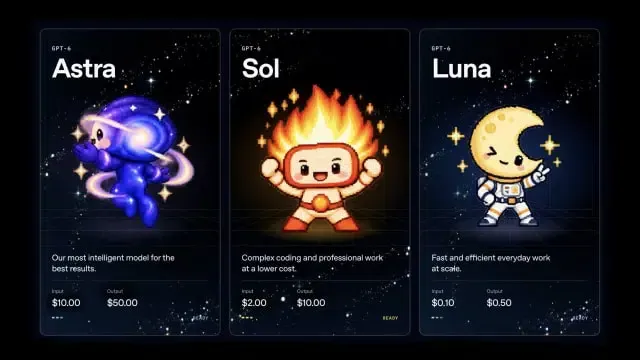
¿OpenAI reduce a la mitad los costes de la API de Sol? OpenAI anunció oficialmente la disponibilidad comercial de GPT-6 Sol y GPT-6 Luna el 22 de septiembre de 2026, reduciendo las tarifas de los tokens de la API en un 50% o más en comparación con los precios promocionales anteriores de GPT-5.6 en los endpoints estándar. Para el procesamiento estándar de prompts con hasta 272K tokens de entrada, GPT-6 Sol tiene un precio de $2.00 por millón de tokens de entrada y $10.00 por millón de tokens de salida, mientras que el modelo más pequeño GPT-6 Luna se sitúa en $0.10 de entrada y $0.50 de salida por millón de tokens. Cuando OpenAI reduce a la mitad los costes de la API de Sol en los niveles de desarrollo estándar, la deflación computacional estructural altera las restricciones operativas del software generativo. Unos precios unitarios más bajos hacen que los bucles de agentes recursivos, la extracción por lotes en segundo plano y los trabajadores autónomos de múltiples pasos sean económicamente viables a escala. Sin embargo, para los arquitectos de sistemas, ingenieros de fiabilidad y desarrolladores de backend, la menor fricción financiera expone desafíos de escalabilidad posteriores, desplazando el foco de la ingeniería desde los presupuestos de tokens hacia los límites de velocidad, restricciones de concurrencia, canales de telemetría y cuellos de botella de contrapresión.
El problema operativo y los cuellos de botella financieros
Durante las primeras fases de adopción empresarial de LLM en producción, las tarifas nominales de los tokens sirvieron como un gobernador arquitectónico informal. Los elevados costes de inferencia obligaron a los equipos de desarrollo a tratar las llamadas a los modelos como transacciones discretas iniciadas por el usuario. Las aplicaciones dependían en gran medida de aprobaciones humanas en el bucle, historiales conversacionales limitados y trabajadores programados estrictamente limitados para garantizar que las facturas mensuales de los proveedores siguieran siendo predecibles. La introducción de reducciones permanentes en los modelos de gama media desafía estas compensaciones históricas, trasladando las preocupaciones de la ingeniería de sistemas desde los precios de los modelos hasta la resiliencia de la infraestructura de backend.
De un vistazo
- Reducción de precio base: El 22 de septiembre de 2026, OpenAI introdujo GPT-6 Sol a $2.00 de entrada / $10.00 de salida y GPT-6 Luna a $0.10 de entrada / $0.50 de salida por millón de tokens para el procesamiento estándar en prompts de hasta 272K tokens, lo que representa una reducción nominal del 50% o superior en comparación con los precios de la API promocionales de GPT-5.6.
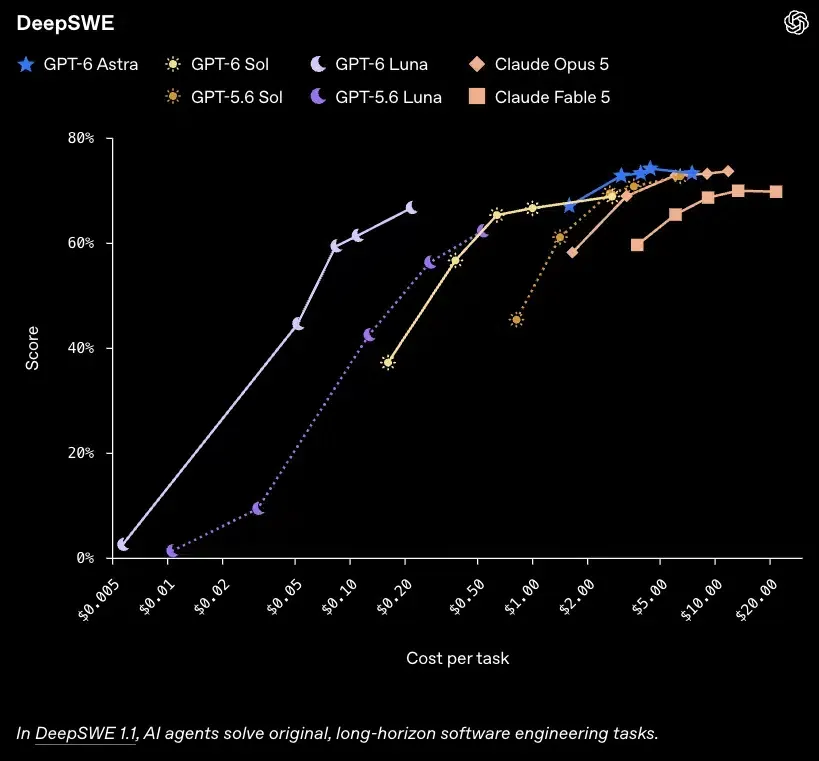
- Economía de benchmarks a nivel de tarea: En AutomationBench 1.0.6, OpenAI informa que GPT-6 Sol configurado con un esfuerzo de razonamiento xhigh logró una puntuación de flujo de trabajo del 33.2% con un coste medio reportado de $0.27 por tarea intentada, desplazando la evaluación del desarrollador desde el precio bruto de los tokens hacia el coste por unidad de trabajo intentada.
- Dinámica de almacenamiento en caché de prompts: La plataforma ofrece un descuento automatizado del 90% en lecturas de tokens de entrada almacenados en caché (facturados a 0.1× de la tarifa base de tokens de entrada), mientras que las escrituras iniciales en caché se facturan a 1.25× de la tarifa de tokens de entrada no almacenados en caché, lo que requiere una normalización cuidadosa de los prefijos para mantener altas tasas de aciertos en caché en ejecuciones dinámicas de múltiples pasos.
Como se detalla en la Referencia de precios de la API para desarrolladores de OpenAI oficial y en el Anuncio de la comunidad de OpenAI, estas estructuras de precios se originan a partir de mejoras continuas en los canales de inferencia de bajo nivel y los sistemas de almacenamiento en caché KV. Sin embargo, cuando el coste de ejecutar secuencias de tareas automatizadas disminuye significativamente, los equipos de ingeniería amplían el alcance de sus tareas en segundo plano. El umbral económico que antes desalentaba a los trabajadores en segundo plano de ejecutar sondeos continuos, pases automatizados de revisión de código o canales de extracción de documentos de múltiples etapas se ha reducido.
En todo el mercado, múltiples proveedores de modelos fundacionales han reducido o reestructurado los precios de sus API en los niveles de desarrollo. Anthropic lanzó Claude Opus 5.5 junto con especificaciones actualizadas en la Especificación de la plataforma Anthropic Claude Opus 5.5, cotizando a $4 por millón de tokens de entrada, $0.20 por millón de lecturas de entradas almacenadas en caché y $20 por millón de tokens de salida, destacando un menor consumo de tokens en los benchmarks de refactorización de código. Simultáneamente, Google mantiene sus precios introductorios promocionales para Gemini 3.8 Flash documentados en Google AI para desarrolladores, y los lanzamientos de pesos abiertos como MiMo-V2.6-Pro de Xiaomi proporcionan a los equipos de autohospedaje opciones agresivas de costes de tokens bajo licencias de software permisivas.
Cuando los costes de los modelos caen, los comportamientos de desarrollo cambian. Los equipos de ingeniería despliegan bucles recursivos más profundos, inyectan documentación empresarial completa en los prompts del sistema y configuran una lógica de reintento automatizada en gráficos de tareas complejos. Lo que comienza como un alivio de costes en la capa de API puede trasladar picos de latencia y tráfico a los servicios internos. Si un trabajador de orquestación emite docenas de llamadas a modelos secuenciales o paralelas para una sola transacción de usuario, los grupos de bases de datos internas, los clústeres de almacenamiento auxiliar, los canales de telemetría y los limitadores de velocidad deben absorber la carga resultante.
Causas raíz sistémicas y cadenas de peticiones no visuales
Cuando las aplicaciones de cliente pasan de interfaces de chat interactivas a la automatización en segundo plano no visual, los perfiles de peticiones ascendentes cambian drásticamente. Un único evento empresarial puede desencadenar un canal autónomo que inspecciona esquemas, evalúa variables de entorno, llama a herramientas externas y verifica los resultados a través de múltiples pases continuos.
+-----------------------------------------------------------------------------------------+
|                  RECURSIVE AGENT EXECUTION & BACKPRESSURE BOTTLENECK                    |
+-----------------------------------------------------------------------------------------+
|                                                                                         |
|  [ User Web / App Trigger ]                                                             |
|         |                                                                               |
|         v                                                                               |
|  [ Ingestion API Gateway ]                                                              |
|         |                                                                               |
|         +---> Spawns Autonomous Worker Instance                                         |
|         |                                                                               |
|         v                                                                               |
|  [ Autonomous Orchestration Loop (GPT-6 Sol / Luna) ]                                   |
|         |                                                                               |
|         +--- Step 1: Query Context (Cache Read) -----------------+                      |
|         |                                                        |                      |
|         +--- Step 2: Tool Execution (Uncached Call)              |                      |
|         |                                                        |                      |
|         +--- Step 3: Self-Correction Validation                  |                      |
|         |                                                        v                      |
|         +--- Step 4: Recursive Execution Fork ----> [ Bursting Internal RPCs ]          |
|                                                                  |                      |
|  [ Downstream System Bottlenecks ]                               |                      |
|         |                                                        |                      |
|         +--- Internal Microservices <-- (Connection Starvation) -+                      |
|         +--- PostgreSQL / Cache Stores <-- (Connection Pool Saturation)                 |
|         +--- Distributed Telemetry Stream <-- (Lossy Drop Buffer Applied)               |
|         +--- Audit Compliance Store <-- (Durable / Replayable Queue Lag)                |
|         +--- Upstream Provider Thresholds <-- (HTTP 429 Rate Limit Exhaustion)          |
|                                                                                         |
+-----------------------------------------------------------------------------------------+
Ejecución de agentes recursivos y multiplicación de la concurrencia
En los sistemas web interactivos tradicionales, el volumen de peticiones refleja los ritmos de interacción humana. Cada hilo HTTP se mapea típicamente a una interacción de usuario explícita, con una distribución general más baja y un ritmo limitado por el tiempo de pensamiento humano. El tiempo de ejecución del cliente envía un payload, espera una respuesta y hace una pausa antes de iniciar interacciones posteriores.
Comparativa conceptual de perfiles de peticiones: interactivo frente a agéntico
| Métrica arquitectónica | Flujo de usuario interactivo | Bucle de agente autónomo |
|---|---|---|
| Modelo de concurrencia | La distribución de peticiones al ritmo humano suele ser menor | 1 evento de ingesta = N llamadas secundarias encadenadas |
| Tiempo de ejecución | Ritmo marcado por la respuesta del usuario y su tiempo de pensamiento | Procede automáticamente hasta que intervienen los límites de las políticas |
| Invalidación de contexto | Payloads nuevos por sesión | Depende en gran medida del contexto almacenado en caché |
| Gestión de errores | Reintento por parte del usuario en caso de error | Reintentos programáticos automatizados |
| Cuellos de botella del sistema | Ancho de banda de la pasarela frontend | Límites del grupo de bases de datos internas |
| Cascadas de fallos | Aisladas a una sola sesión | Pueden desencadenar la saturación de la cola |
Cuando los sistemas integran agentes autónomos, este ritmo se desacopla. Un único evento desencadenado puede generar una secuencia ininterrumpida de llamadas automatizadas. Si un agente encuentra un error transitorio o una salida de herramienta malformada, la lógica de reintento ingenuo puede generar ráfagas rápidas de peticiones contra los servicios de backend. Debido a que los costes de tokens reducidos hacen que las ejecuciones más largas sean asequibles, los flujos de trabajo automatizados pueden escalar significativamente el volumen de peticiones en segundo plano, incluso con una base de usuarios activos plana.
Mecánica de caché de prompts: reutilización de KV, costes generales de escritura y estabilidad de prefijos
OpenAI combinó los lanzamientos de Sol y Luna con optimizaciones en su subsistema de almacenamiento en caché de prompts. Como se documenta en la Especificación de almacenamiento en caché de prompts de OpenAI, los tokens de entrada que coinciden con un prefijo almacenado en caché reciben un descuento del 90% en el precio de lectura. El almacenamiento en caché de prompts reduce principalmente la recomputación del lado del modelo en lugar de funcionar como un mecanismo de compresión de carga de red de propósito general. En las interacciones sin estado estándar, la aplicación cliente transmite el contexto de la petición, y el proveedor omite la recomputación de los tensores KV para el prefijo coincidente, reduciendo significativamente la latencia de tiempo hasta el primer token y la facturación de entradas.
Crucialmente, la escritura de un prefijo inicial en la caché del lado del servidor se factura a 1.25× de la tarifa de tokens de entrada no almacenados en caché. Maximizar la eficiencia de costes requiere mantener la estabilidad de los prefijos a lo largo de múltiples consultas.
Precios de lista públicos de API seleccionados — No directamente comparables entre proveedores
| Identificador del modelo | Entrada ($/1M Tok) | Salida ($/1M Tok) | Política de lectura de caché |
|---|---|---|---|
| OpenAI GPT-6 Luna (Std) | $0.10 | $0.50 | Descuento del 90% (0.10×) |
| OpenAI GPT-6 Sol (Std) | $2.00 | $10.00 | Descuento del 90% (0.10×) |
| OpenAI GPT-6 Astra (Std) | $10.00 | $50.00 | Precios dinámicos por niveles |
| Anthropic Opus 5.5 | $4.00 | $20.00 | $0.20/1M lectura (0.05×) |
| Anthropic Sonnet 5 | $2.00 | $10.00 | Hasta 90% en caché |
| Google Gemini 3.8 Flash | $0.75 (Intro) | $3.75 (Intro) | $0.075/1M lectura en caché |
| Xiaomi MiMo-V2.6-Pro | $0.435 | $0.87 | $0.0036/1M lectura en caché |
Nota: Las tarifas estándar se aplican a los niveles de contexto corto (prompts de hasta 272K tokens de entrada para OpenAI). Los proveedores aplican diversos costes generales de escritura en caché, límites de contexto y términos promocionales con límite de tiempo.
La preservación de los prefijos requiere un manejo cuidadoso de las opciones de configuración de la API. En la arquitectura de la API de OpenAI, cambiar los parámetros de esfuerzo de razonamiento directamente o alterar las matrices de definición de herramientas cambiará el prefijo del prompt renderizado e invalidará los estados almacenados en caché anteriores.
Para preservar el contexto almacenado en caché durante las sesiones de múltiples turnos, los desarrolladores deben mantener los esquemas de herramientas y las instrucciones base en un orden consistente. Si se necesitan ajustes en tiempo de ejecución, los desarrolladores deben actualizar los parámetros a través de controles de sesión estructurados (como configuration_update) o alternar la ejecución de herramientas usando tool_choice o allowed_tools en lugar de modificar directamente la matriz de definiciones de herramientas.
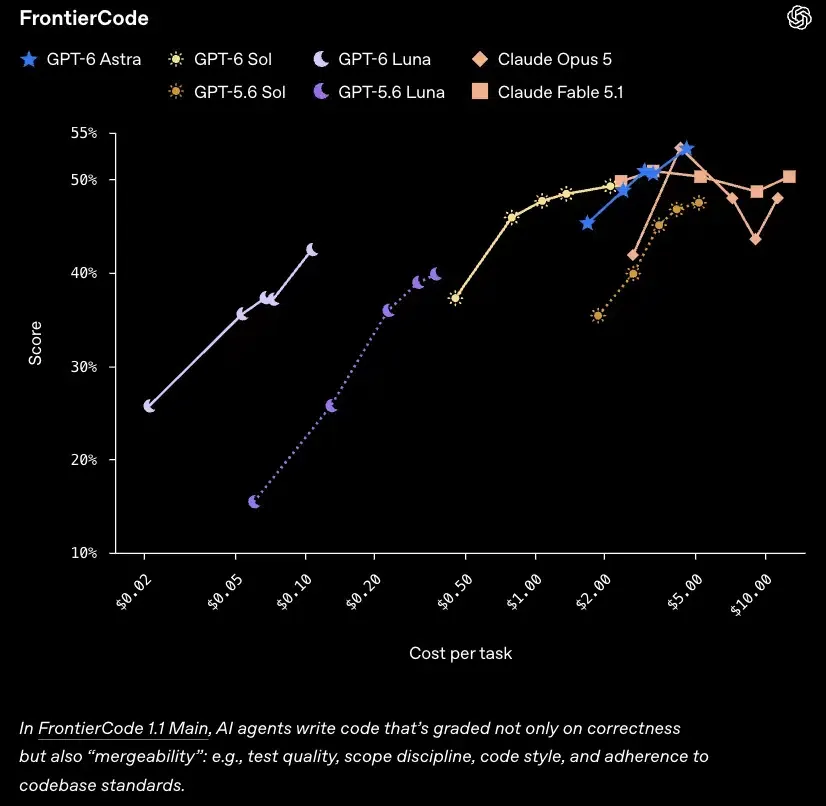
Cuando se producen fallos de caché, el proveedor ascendente vuelve a procesar la secuencia de entrada sin el descuento de lectura del 90%. A escala, esto puede aumentar la latencia de inferencia y la presión de tiempo de espera (timeout). Para la ejecución de tareas de múltiples pasos, la evaluación de costes pasa de simples multiplicadores de tokens a gastos de tareas completadas, como se ve en el reportaje de VentureBeat sobre los benchmarks de GPT-6 Sol y Luna, donde GPT-6 Sol logró una puntuación del 33.2% en AutomationBench 1.0.6 con un promedio de $0.27 por tarea intentada.
Arquitectura de telemetría: desacoplamiento de las métricas operativas de las auditorías de conformidad
Un aumento en las peticiones de LLM automatizadas ejerce una presión significativa sobre la observabilidad del backend y los canales de conformidad. Los flujos de trabajo de agentes de alta concurrencia requieren una separación arquitectónica clara entre la telemetría operativa y los registros de auditoría legal.
Las políticas de conformidad empresarial a menudo exigen registrar los metadatos de las sesiones, las pruebas de ejecución de herramientas y los registros de transacciones. Tratar la telemetría operativa y los datos de conformidad de manera idéntica crea compensaciones de ingeniería graves:
- Canales de auditoría de seguridad y conformidad: Deben proporcionar una entrega duradera y reproducible con reintentos explícitos, persistencia y gestión de fallos en almacenes de auditoría de escritura única y control de acceso. Los payloads deben capturar metadatos estructurados, la identidad de la persona que llama y el estado criptográfico mientras desinfectan sistemáticamente la información de identificación personal (PII) y las claves secretas. Bajo carga alta, estos canales deben aplicar contrapresión o poner en cola las tareas de forma duradera en lugar de descartar los registros.
- Canales de telemetría operativa: Rastean métricas de rendimiento como recuentos de tokens, ratios de aciertos de caché de prompts y latencias de respuesta ascendentes. Debido a que estos seguimientos se utilizan para la monitorización y depuración en tiempo real, se pueden procesar a través de búferes de pérdida acotados. Si los colectores descendentes se ralentizan, la aplicación puede eliminar de forma segura el exceso de telemetría operativa para preservar la disponibilidad principal del servicio.
Cuando los proveedores externos devuelven errores de límite de velocidad HTTP 429, las políticas de reintento mal configuradas pueden causar problemas operativos graves. Los reintentos inmediatos o las rutinas de retroceso exponencial sincronizado sin fluctuación aleatoria (jitter) crean oleadas de reintentos que pueden propagarse en cascada a través de los microservicios intermedios, consumiendo grupos de hilos y conexiones de bases de datos.
Comparativa de soluciones: compensaciones entre desarrollo interno y adquisición
Gestionar la carga operativa resultante de unos costes de inferencia más bajos requiere que las organizaciones evalúen sus arquitecturas de pasarelas y proxies de IA. Los equipos deben decidir si desarrollan pasarelas personalizadas de enrutamiento, limitación de velocidad y telemetría de forma interna o si despliegan infraestructura especializada de terceros.
+-----------------------------------------------------------------------------------------+
|                 SYSTEM RESILIENCY PIPELINE WITH DECOUPLED TELEMETRY                     |
+-----------------------------------------------------------------------------------------+
|                                                                                         |
|  [ Inbound Application Requests ]                                                       |
|         |                                                                               |
|         v                                                                               |
|  [ Sliding-Window Rate Limiter ] <--- Local In-Memory or Distributed Cache              |
|         |                                                                               |
|         +---> Rejects / Delays Excess Concurrency (HTTP 429 Protection)                 |
|         |                                                                               |
|         v                                                                               |
|  [ Prompt Normalization & Cache Alignment Engine ]                                      |
|         |                                                                               |
|         +---> Pins Static System Prompts & Tool Definitions to Base Prefix              |
|         +---> Uses Structured Controls to Modify Session Parameters                     |
|         |                                                                               |
|         v                                                                               |
|  [ Upstream Provider Dispatch (OpenAI / Anthropic / Local API) ]                         |
|         |                                                                               |
|         +---------------------------------------+---------------------------------------+
|         |                                       |                                       |
|         v (Synchronous Fast Path)               |                                       |
|  [ Client Response Assembly ]                   |                                       |
|         |                                       v (Asynchronous Dual Path)              |
|         v                               +-----------------------------------------------+
|  [ Return Payload to App ]              |                                               |
|                                         v (Lossy Ring Buffer)   v (Durable Outbox)      |
|                                    [ Operational Metrics ]  [ Compliance Audit Store ]  |
|                                    (Drops on Congestion)    (Durable / Replayable)      |
|                                                                                         |
+-----------------------------------------------------------------------------------------+
Canales de resiliencia internos personalizados
Desarrollar infraestructura personalizada otorga a los equipos de ingeniería un control completo sobre las políticas de red, la desinfección de datos y las estrategias de enrutamiento. Las organizaciones pueden construir proxies perimetrales adaptados a sus topologías exactas de microservicios internos.
// Reference implementation: Synchronized Token Bucket with fractional remainder and bounded saturation
package com.example.ai.resilience;

import java.math.BigInteger;
import java.time.Duration;

public final class TokenBucketLimiter {
    private final long maxTokenCapacity;
    private final long refillPeriodNanos;
    private long availableTokens;
    private long lastRefillNanos;
    // Scaled remainder numerator in the range [0, refillPeriodNanos)
    private long scaledRemainder;

    public TokenBucketLimiter(long maxTokens, Duration refillPeriod) {
        if (maxTokens <= 0 || refillPeriod.isZero() || refillPeriod.isNegative()) {
            throw new IllegalArgumentException("Invalid boundary configuration for TokenBucketLimiter.");
        }
        this.maxTokenCapacity = maxTokens;
        this.refillPeriodNanos = refillPeriod.toNanos();
        this.availableTokens = maxTokens;
        this.lastRefillNanos = System.nanoTime();
        this.scaledRemainder = 0L;
    }

    public synchronized boolean tryAcquire(long requestedUnits) {
        if (requestedUnits <= 0) {
            return false;
        }
        refillTokens();
        if (requestedUnits > availableTokens) {
            return false;
        }
        availableTokens -= requestedUnits;
        return true;
    }

    private void refillTokens() {
        long nowNanos = System.nanoTime();
        long elapsedNanos = nowNanos - lastRefillNanos;

        if (elapsedNanos <= 0) {
            return;
        }

        // Advance baseline timestamp monotonically
        this.lastRefillNanos = nowNanos;

        // If bucket is already full, discard unconsumed fractional credits to prevent timing drift
        if (this.availableTokens >= this.maxTokenCapacity) {
            this.scaledRemainder = 0L;
            return;
        }

        long wholePeriods = elapsedNanos / refillPeriodNanos;
        long remElapsedNanos = elapsedNanos % refillPeriodNanos;

        // Fast-path: if at least one complete period has elapsed, the bucket fully replenishes to capacity.
        // This eliminates the multiplication overflow surface (wholePeriods * maxTokenCapacity).
        if (wholePeriods > 0) {
            this.availableTokens = maxTokenCapacity;
            this.scaledRemainder = 0L;
            return;
        }

        // Under sub-period micro-intervals, calculate exact fractional tokens using BigInteger arithmetic
        BigInteger bigRemNanos = BigInteger.valueOf(remElapsedNanos);
        BigInteger bigCapacity = BigInteger.valueOf(maxTokenCapacity);
        BigInteger bigRemainder = BigInteger.valueOf(scaledRemainder);
        BigInteger bigPeriod = BigInteger.valueOf(refillPeriodNanos);

        // totalWork = (remElapsedNanos * maxTokenCapacity) + scaledRemainder
        BigInteger totalWork = bigRemNanos.multiply(bigCapacity).add(bigRemainder);
        BigInteger[] divAndRem = totalWork.divideAndRemainder(bigPeriod);

        long tokensGenerated = divAndRem[0].longValue();
        this.scaledRemainder = divAndRem[1].longValue();

        if (tokensGenerated > 0) {
            long spaceLeft = maxTokenCapacity - availableTokens;
            if (tokensGenerated >= spaceLeft) {
                this.availableTokens = maxTokenCapacity;
                this.scaledRemainder = 0L;
            } else {
                this.availableTokens += tokensGenerated;
            }
        }
    }
}
Sin embargo, el desarrollo interno requiere un mantenimiento de ingeniería continuo. Los equipos deben adaptarse manualmente a las actualizaciones de las API de los proveedores, gestionar los límites de velocidad en evolución de múltiples proveedores y administrar colas de telemetría distribuidas. Este gasto general de mantenimiento puede desviar los recursos de los desarrolladores internos de las características principales del producto.
Pasarelas comerciales y herramientas de infraestructura
Para evitar construir estas capacidades desde cero, muchas empresas despliegan proxies de API gestionados, pasarelas de LLM y planos de control perimetrales. Algunas pasarelas gestionadas proporcionan coordinación de límites de velocidad consciente del proveedor, observabilidad, controles de políticas y enrutamiento consciente de la caché; las capacidades exactas varían según el proveedor, y la optimización de prefijos a menudo todavía requiere disciplina de peticiones a nivel de aplicación.
Las plataformas comerciales permiten a los equipos de ingeniería aplicar cuotas de costes por entorno, configurar enrutamiento de reserva automatizado entre familias de modelos y eliminar información confidencial de los clientes antes de registrar los metadatos de las peticiones. Las pasarelas diseñadas específicamente gestionan los picos de concurrencia, auditan las tendencias de consumo de API y protegen los microservicios descendentes en entornos de aplicaciones complejos.
Matriz de decisiones: canal interno frente a plataformas gestionadas
| Criterios de evaluación | Herramientas de resiliencia internas | Infraestructura de enrutamiento gestionada |
|---|---|---|
| Esfuerzo de desarrollo inicial | Alto (3-6 semanas de ingeniería) | Bajo (Se integra mediante API estándar) |
| Mantenimiento de protocolos | Responsabilidad continua del equipo | Gestionado por las actualizaciones del proveedor |
| Control operativo | Visibilidad completa de la pila | Limitado por la interfaz del proveedor |
| Ajuste de caché de prompts | Requiere proxies personalizados | Dependiente del proveedor; normalmente requiere cooperación de la aplicación |
| Aislamiento de telemetría | Gestión de colas personalizada | Dependiente del proveedor |
| Perfil de costes financieros | Gastos generales de nómina de ingeniería | Tarifas recurrentes de SaaS / uso |
Listas de comprobación de integración y cronogramas de gobernanza
Las organizaciones que escalan su uso de modelos tras las reducciones de precios de GPT-6 Sol y Luna pueden utilizar este marco operativo para evitar sobrecargas sistémicas:
+-----------------------------------------------------------------------------------------+
|                  ENTERPRISE LLM INFRASTRUCTURE READINESS CHECKLIST                      |
+-----------------------------------------------------------------------------------------+
| [ ] Audit client applications to identify unbounded recursive model calling loops       |
| [ ] Set hard timeout limits and non-linear retry backoffs with randomized jitter        |
| [ ] Implement local and edge token-bucket rate limiters ahead of upstream calls          |
| [ ] Organize prompt structures to maximize prompt caching prefix reuse                   |
| [ ] Separate lossy operational telemetry from durable, replayable audit trails           |
| [ ] Add runtime sampling to strip raw prompt bodies from high-frequency traces          |
| [ ] Monitor HTTP 429 status trends and set automated backpressure triggers              |
| [ ] Configure cost alerts and circuit breakers to catch runaway automated jobs          |
+-----------------------------------------------------------------------------------------+
Configuración del canal de telemetría
Los sistemas de observabilidad deben desacoplar el registro de prompts de las rutas de peticiones en tiempo real. Al procesar cargas de trabajo de agentes de alta frecuencia, las aplicaciones deben escribir metadatos de telemetría en colas asíncronas acotadas en memoria, evitando bloqueos de E/S si los colectores de telemetría descendentes se ralentizan.
// Reference implementation: Memory-bounded telemetry logger with lossy load shedding
package com.example.ai.resilience;

import java.util.concurrent.ArrayBlockingQueue;
import java.util.concurrent.BlockingQueue;
import java.util.concurrent.atomic.AtomicLong;

public final class BoundedTelemetryQueue {
    public static final class LogPayload {
        public final String traceId;
        public final String modelId;
        public final long promptTokens;
        public final long completionTokens;
        public final boolean cacheHit;

        public LogPayload(String traceId, String modelId, long pTokens, long cTokens, boolean hit) {
            this.traceId = traceId;
            this.modelId = modelId;
            this.promptTokens = pTokens;
            this.completionTokens = cTokens;
            this.cacheHit = hit;
        }
    }

    private final BlockingQueue<LogPayload> internalQueue;
    private final AtomicLong droppedEvents = new AtomicLong(0);

    public BoundedTelemetryQueue(int maxQueueCapacity) {
        if (maxQueueCapacity <= 0) {
            throw new IllegalArgumentException("Queue capacity must be positive.");
        }
        this.internalQueue = new ArrayBlockingQueue<>(maxQueueCapacity);
    }

    public boolean recordEvent(LogPayload payload) {
        if (payload == null) {
            return false;
        }
        // Non-blocking submission: drops telemetry under load to preserve app stability
        boolean accepted = internalQueue.offer(payload);
        if (!accepted) {
            droppedEvents.incrementAndGet();
        }
        return accepted;
    }

    public LogPayload pollEvent() {
        return internalQueue.poll();
    }

    public long getDroppedEventCount() {
        return droppedEvents.get();
    }
}
Preguntas frecuentes (FAQ)
¿Cuáles son las tarifas oficiales de la API para GPT-6 Sol y Luna?
¿Cómo reduce el almacenamiento en caché de prompts los costes en conversaciones largas?
¿Por qué unos tokens más baratos aumentan el riesgo operativo del backend?
Puntos clave para los equipos de ingeniería
El lanzamiento de GPT-6 Sol y Luna acelera una tendencia más amplia: la inteligencia de frontera se está abaratando y volviendo más accesible. A medida que los costes unitarios de los tokens caen drásticamente, las restricciones financieras dejan de ser un mecanismo de control efectivo para las arquitecturas de software.
A medida que las organizaciones adoptan agentes de alta frecuencia y topologías de modelos de múltiples niveles, la ingeniería operativa se vuelve crítica para el éxito empresarial. Los equipos deben ir más allá de evaluar los modelos únicamente por los precios nominales de los tokens o las puntuaciones de los benchmarks. La fiabilidad a largo plazo dependerá de cuán eficazmente gestionen los sistemas la concurrencia, alineen los contextos de prompts para la reutilización de caché, manejen los límites de velocidad ascendentes de forma fluida y desacoplen la telemetría de las rutas de aplicaciones críticas. Las organizaciones que construyan una infraestructura resiliente escalarán con éxito sus flujos de trabajo de agentes automatizados sin sacrificar el tiempo de actividad de la aplicación ni la estabilidad del sistema.
Fuentes primarias y documentación de referencia
-
Referencia de precios de la API para desarrolladores de OpenAI: Tarjetas de tarifas oficiales para desarrolladores, restricciones de la ventana de contexto (umbral estándar de ≤272K) y calendarios de precios de lectura/escritura en caché para GPT-6 Sol, Luna y Astra.
-
Anuncio de la comunidad de OpenAI: Divulgación pública que confirma la reducción de precios base del 50% en relación con los niveles promocionales de GPT-5.6 y los detalles del despliegue por fases.
-
Especificación de almacenamiento en caché de prompts de OpenAI: Documentación arquitectónica sobre la reutilización de prefijos de pares clave-valor (KV) del lado del servidor, los costes generales de escritura en caché y las reglas de invalidación de configuración.
-
Especificación de la plataforma Anthropic Claude Opus 5.5: Especificación de lanzamiento oficial que confirma las tarifas de tokens de $4 de entrada / $20 de salida / $0.20 de lectura de caché y el rendimiento en benchmarks.
-
Descripción general de Anthropic Claude Sonnet 5: Tarjeta de tarifas oficial para desarrolladores y métricas de eficiencia de almacenamiento en caché de prompts ($2 de entrada / $10 de salida / hasta 90% de descuento en caché).
-
Tarjeta de tarifas de Google AI para desarrolladores: Descripción general de las tarjetas de tarifas para desarrolladores y las políticas de precios introductorias para Gemini 3.8 Flash.
-
Calendario de tarifas y precios de la API oficial de Xiaomi MiMo: Tarifas canónicas de tokens de pago por uso en el extranjero para la inferencia de MiMo-V2.6-Pro ($0.435 de entrada / $0.87 de salida / $0.0036 por acierto de caché).
-
Reportaje de VentureBeat sobre los benchmarks de GPT-6 Sol y Luna: Cobertura de la economía del lanzamiento, garantías de precios permanentes y cifras de coste por tarea de AutomationBench 1.0.6 ($0.27 por tarea intentada).
Share this article