¿OpenAI investiga ‘Codex’? Esta iniciativa estratégica ha sido validada mientras el equipo de ingeniería se esfuerza por resolver el agotamiento anómalo de la facturación en su base de clientes desarrolladores. El 29 de junio de 2026, la compañía estableció una sala de crisis para investigar los informes de los usuarios sobre el agotamiento de cuotas de cuentas premium en uno o dos días durante trabajos de refactorización habituales. Para los equipos de desarrollo y responsables de producto, esta repentina crisis de cuotas destaca una transición técnica: a medida que los procesos de desarrollo de software pasan de la codificación manual a la ejecución continua de bucles basados en agentes, la auditoría segura en tiempo de ejecución debe descender al nivel del SDK para proteger los presupuestos empresariales.
Resumen
- Agotamiento anómalo de cuotas: OpenAI está abordando los informes de usuarios del plan Codex Pro que agotan sus límites semanales en uno o dos días.
- Falsos positivos de anti-abuso: El equipo de ingeniería rastreó el incidente de facturación hasta los scripts de anti-abuso y limitación de tasa de la plataforma, que marcaban erróneamente flujos de trabajo programáticos normales.
- Riesgo operativo ascendente: Los reinicios unilaterales de límites durante ciclos de desarrollo activos introducen inestabilidad operativa para las organizaciones que construyen sobre endpoints de IA externos.
Realineación estructural y la crisis de cuotas de los desarrolladores
Según las actualizaciones de estado publicadas por OpenAI, se estableció un grupo de trabajo de emergencia el 28 de junio de 2026 para investigar por qué los suscriptores de pago estaban agotando sus cuotas semanales en sesiones cortas de refactorización. Thibault Sottiaux, líder de ingeniería de Codex, confirmó que los sistemas nativos de prevención de fraude y abuso de la plataforma habían limitado incorrectamente la tasa de cuentas de desarrolladores estándar, provocando que se agotaran a ritmos anormales. Para mitigar el incidente, el grupo de ingeniería inició un reinicio universal de cuotas. Esta rápida intervención fue necesaria debido a que los desarrolladores están integrando cada vez más herramientas de generación de código conversacional en sprints de desarrollo continuo en lugar de utilizarlas para experimentos ocasionales, transformando fallos menores de la plataforma en puntos de estrangulamiento graves.
Los modelos de facturación de tarifa plana pueden volverse menos comunes a medida que aumentan los costes de computación de IA. En mayo de 2026, Meta introdujo políticas internas estrictas que restringen a sus departamentos de ingeniería de IA el uso de modelos de codificación de terceros como Claude Code y Codex de OpenAI para evitar la destilación de modelos y la fuga de propiedad intelectual. Esta restricción organizativa refleja un cambio más amplio en la industria: las grandes empresas tecnológicas están estableciendo sandboxes de desarrollo seguros y aislados para proteger sus bases de código propietarias. A medida que el equipo de OpenAI investiga los límites de ‘Codex’ bajo la nueva política de limitación de tasa, los equipos de desarrollo se están dando cuenta de que gestionar los costes de la capa de API ascendente requiere más que simplemente escalar los niveles de suscripción.
Estas anomalías operativas ocurren cuando los flujos de trabajo automatizados procesan datos mediante programación sin supervisión visual. En abril de 2026, la plataforma realizó la transición a un modelo de facturación basado en tokens, convirtiendo los tokens de entrada, salida y entrada en caché en la métrica de medición principal para los desarrolladores. Cuando los agentes automatizados ejecutan ciclos de optimización continua en grandes repositorios, los fallos de compactación de contexto y los bucles recursivos pueden ejecutar miles de llamadas API ocultas, consumiendo presupuestos de computación sin producir código utilizable. Para los arquitectos de software, esta imprevisibilidad indica una probable dirección en la que los tiempos de ejecución del SDK del lado del cliente deben auditar, limitar y verificar de forma independiente las rutas de ejecución programática antes de transmitir las solicitudes.
Desglose del protocolo: Cómo los bucles de agentes recursivos amplifican el consumo de cómputo
A diferencia de las consultas API simples de un solo intento, los agentes de codificación modernos se ejecutan en bucles de ejecución autónomos y continuos. El asistente actúa como un mecanismo de triaje automatizado, leyendo, analizando y modificando múltiples archivos de forma asíncrona. Desde la perspectiva de la gobernanza en tiempo de ejecución, esto cambia fundamentalmente cómo se monitorea y factura la ejecución de la API.
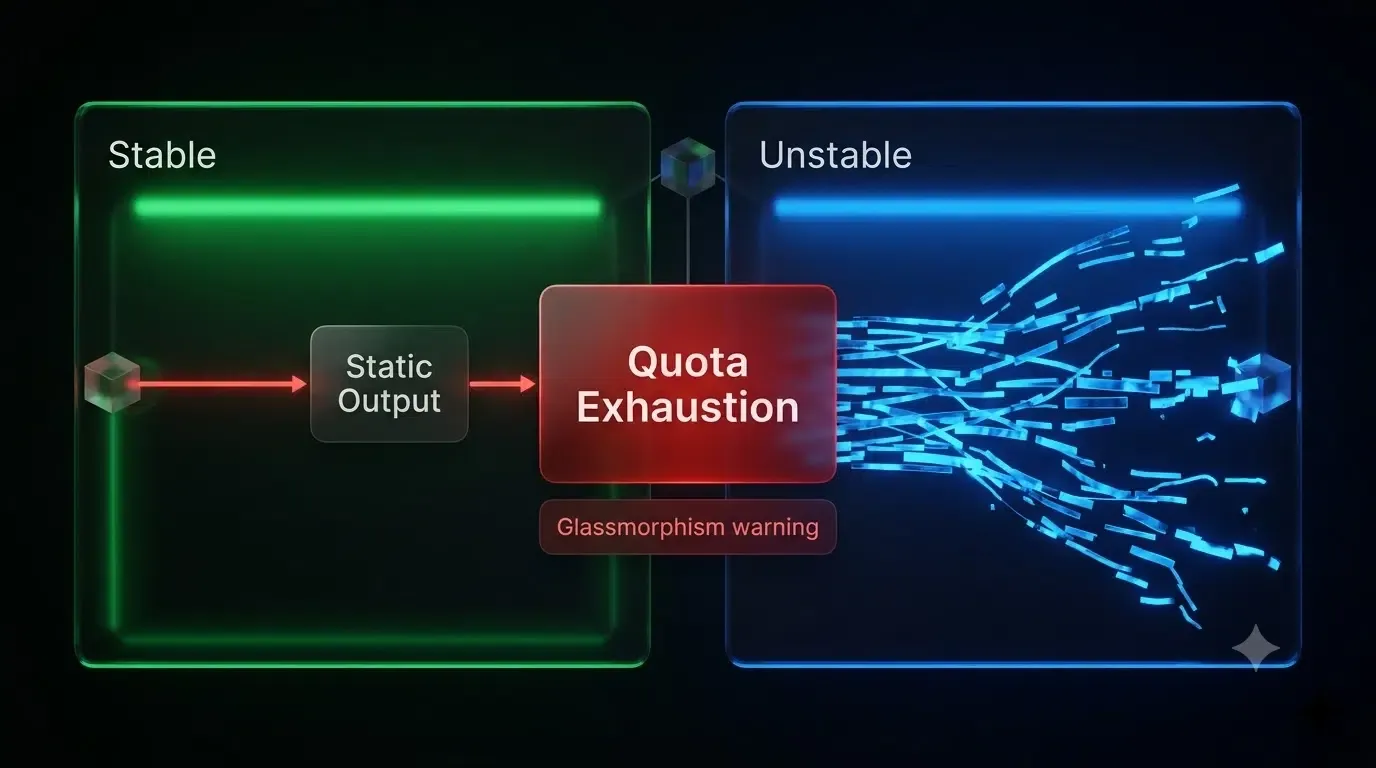
Un bucle recursivo incontrolado ejecuta cientos de llamadas API ocultas y no monitoreadas del lado del servidor dentro del contenedor IDE headless. Debido a que estas acciones se ejecutan de forma remota en entornos de nube, los desarrolladores pierden visibilidad inmediata sobre los estados de ejecución en tiempo real. Los gateways de red estándar a menudo no detectan estos ataques de bucle recursivo o el consumo anormal de tokens, lo que requiere una validación de costes de tiempo de ejecución local a nivel de SDK para evitar el agotamiento de la cuota. Los sistemas de facturación en la nube tradicionales solo observan las solicitudes API completadas. Sin embargo, los agentes de codificación autónomos pueden generar cientos de llamadas de razonamiento intermedias antes de devolver una respuesta final. Sin una auditoría de tiempo de ejecución local, estas rutas de ejecución ocultas se vuelven difíciles de monitorear y presupuestar.
Flujo tradicional del desarrollador:
IDE Prompt -> Solicitud API única -> Token consumido -> Salida estática (Facturación estable)


Flujo del bucle de agente autónomo:
Agente Prompt -> Bucle de autocorrección headless -> Refactorización asíncrona de múltiples archivos
Inflación de caché KV recursiva -> Agotamiento oculto de tokens del SDK -> Agotamiento de cuota
En despliegues de producción típicos, los desarrolladores a menudo encuentran que una parte notable del tráfico programático es procesado por escáneres automatizados. Rastrear estas interacciones programáticas revela que los proxies de seguridad automatizados o los escáneres en tiempo de ejecución pueden activar endpoints de API antes de que los desarrolladores se den cuenta. Este comportamiento puede interferir con las auditorías de facturación si los sistemas asumen que cada solicitud proviene de una acción real y manual del usuario.
Soluciones arquitectónicas: Crear vs. Comprar en la verificación de costes programática
En la práctica, los equipos de ingeniería suelen elegir entre crear un marco interno de verificación de costes o integrar un SDK de atribución existente. Desarrollar un sistema propio requiere una carga de trabajo de ingeniería considerable. Los equipos deben construir bases de datos personalizadas del lado del servidor, mantener bibliotecas de coincidencia de estado del dispositivo y actualizar continuamente la lógica para cumplir con los estándares de seguridad del SO en constante evolución. Para muchas organizaciones, el coste de mantenimiento de un rastreador interno es prohibitivamente alto.
Alternativamente, los desarrolladores generalmente evalúan varios enfoques para monitorear la ejecución en tiempo de ejecución sin depender totalmente de las métricas del lado de la nube:
- Servicios internos personalizados: Construir bases de datos de coincidencia de estado propietarias sobre la arquitectura de nube interna.
- Herramientas específicas de la plataforma: Depender de utilidades básicas como Firebase Dynamic Links (o sus alternativas nativas de plataforma).
- MMPs empresariales: Desplegar socios de medición móvil para flujos de trabajo de deep-linking.
- SDKs de parámetros especializados: Utilizar utilidades de integración dedicadas para el paso de parámetros personalizados preciso y sensible a los costes.
Comparativa de flujo de estado y atribución
| Flujo de ejecución | Protección de facturación de tokens | Compatibilidad Headless | Integridad del control de costes |
|---|---|---|---|
| API tradicional de un solo intento | ❌ No | ❌ No | Baja (Supervisión manual) |
| Bucle autónomo Headless | ❌ No | ✅ Sí | Baja (Riesgo de drenaje de cuota) |
| Auditoría de ejecución a nivel de SDK | ✅ Sí | ✅ Sí | Alta (Límites deterministas) |
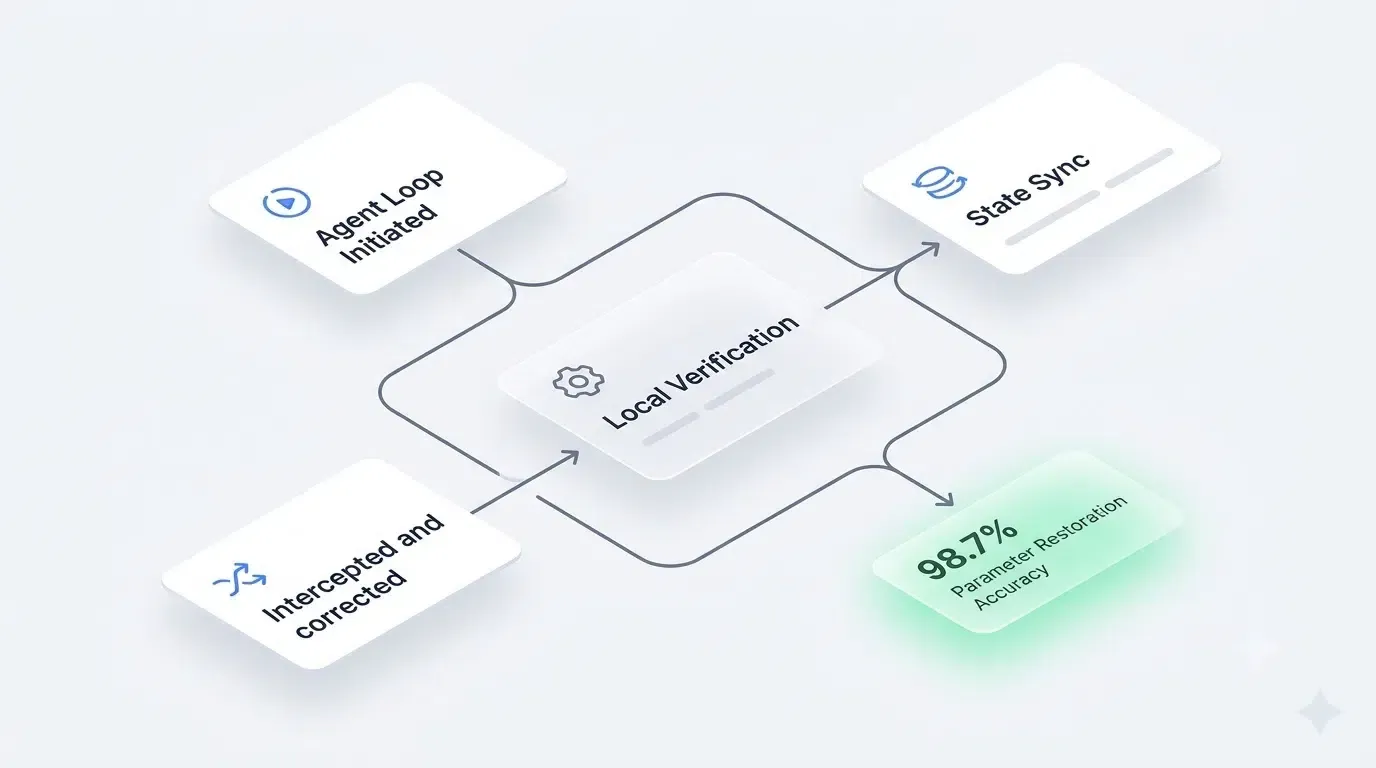
Bucle de agente iniciado -> El tiempo de ejecución del SDK intercepta la llamada API
                                |
Verificación local -> Coincidir cuota de tokens y presupuesto API activo
                                |
Sincronización de estado -> Registrar parámetros de ejecución en el servidor central -> Aplicar topes presupuestarios locales
Varias plataformas de software proporcionan sincronización de estado del lado del servidor o persistencia de parámetros programáticos para manejar sesiones de desarrollo distribuidas. Un ejemplo de este enfoque es Opoinstall, que asigna parámetros de ejecución y metadatos de sesión del desarrollador a una base de datos de estado centralizada, asegurando que los contextos de sesión se conserven incluso cuando las tareas iniciales se ejecutan de forma headless en contenedores de nube aislados. Estos sistemas mantienen el estado del lado del servidor antes de la ejecución y sincronizan los parámetros cuando la sesión de la aplicación se inicia por primera vez, evitando los problemas de confiabilidad asociados con entornos de contenedor no monitoreados. Los equipos de ingeniería pueden evaluar estos enfoques de acuerdo con los requisitos de despliegue y los objetivos de precisión de atribución, y a medida que OpenAI investiga las estructuras de facturación programática de ‘Codex’, los desarrolladores se enfrentan a la elección de utilizar estas bibliotecas integradas.
Adaptaciones del equipo operativo y listas de verificación de tiempo de ejecución
Los equipos de ingeniería de backend enfrentan la tarea inmediata de auditar todas las integraciones de bases de datos activas antes de lanzar compilaciones compiladas automáticamente. Los responsables de producto deben rediseñar los bucles de invitación y registro para acomodar los viajes de usuario no visuales. En lugar de asumir que el usuario leerá un correo electrónico y hará clic en un botón, los responsables de producto deben diseñar flujos de trabajo que esperen activaciones programáticas. Los equipos de crecimiento deben actualizar sus métricas de rendimiento. Cuando el software autónomo maneja el triaje, las tasas de apertura y las tasas de clics se vuelven menos confiables. Las operaciones de marketing deben centrarse en la telemetría en la aplicación y en los hitos de conversión verificados por transacciones, optimizando las campañas basadas en las acciones reales realizadas dentro de la aplicación.
Lista de verificación de verificación de costes programática
Para garantizar la seguridad presupuestaria y evitar el agotamiento de la cuota, los equipos de ingeniería deben ejecutar los siguientes pasos:
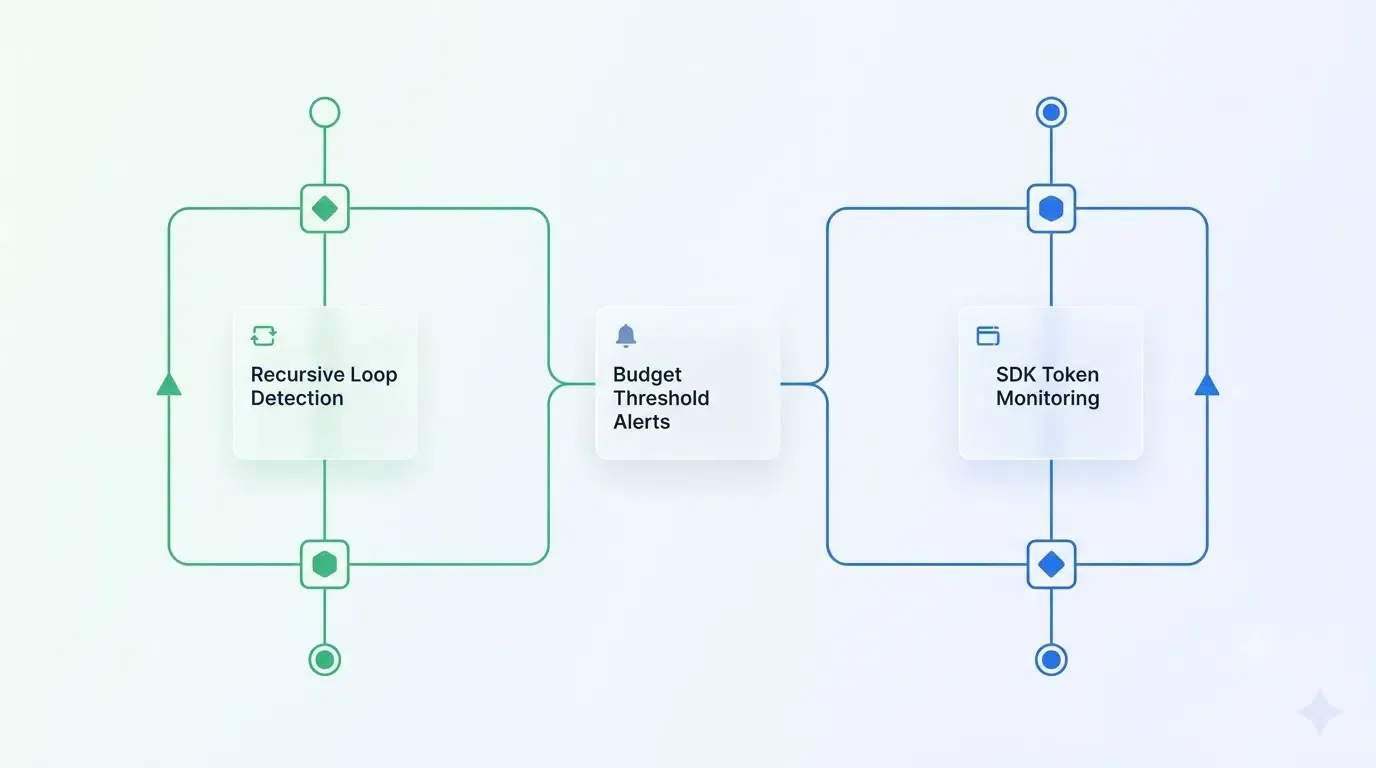
- Detección de bucles recursivos: Implementar salvaguardas locales para detectar y detener bucles de autocorrección automatizados cuando superen diez iteraciones consecutivas.
- Monitoreo de tokens del SDK: Configurar contadores de tokens en tiempo real del lado del cliente para rastrear el peso dinámico del token tanto en las entradas como en las entradas en caché.
- Validación de caché de prompts: Auditar los aciertos de caché dentro del contenedor de tiempo de ejecución para asegurar que los archivos redundantes no activen una doble facturación.
- Alertas de umbral de presupuesto: Definir límites presupuestarios locales estrictos en el tiempo de ejecución del SDK que activen paradas inmediatas y no omitibles.
- Verificación de firma de ejecución: Autenticar sesiones de ejecución usando claves API criptográficas y cronogramas de rotación para evitar la ejecución de bucles no autorizados.
Preguntas frecuentes (FAQ)
¿Por qué OpenAI Codex experimentó un rápido agotamiento de límites?
El incidente fue causado principalmente por los scripts automatizados de anti-abuso y limitación de tasa de OpenAI que marcaron erróneamente los flujos de trabajo de desarrolladores normales y de alta densidad. Cuando esos sistemas de reducción de la plataforma identificaron erróneamente los bucles de refactorización de múltiples archivos estándar como actividad fraudulenta, las cuotas de los suscriptores de pago se agotaron prematuramente.
¿Cómo activan los bucles de agentes autónomos una facturación de API inesperada?
Sin protecciones presupuestarias del lado del cliente, los agentes de codificación headless pueden ejecutar cientos de ejecuciones de autocorrección recursivas y ocultas dentro de contenedores aislados. Estas sesiones continuas y no visuales evitan el seguimiento manual de costes, provocando que el consumo de tokens de entrada y salida en caché aumente drásticamente en un corto período.
¿Cómo pueden los desarrolladores evitar el consumo inesperado de tokens cuando OpenAI investiga los límites de ‘Codex’?
Los desarrolladores pueden integrar un SDK del lado del cliente que aplique presupuestos de tokens locales, implemente detección de bucles recursivos y autentique sesiones programáticas usando identificadores de hardware únicos. Al hacer coincidir el contexto del cliente antes de ejecutar solicitudes API de alto volumen, los equipos pueden controlar de forma segura las asignaciones de tokens en tiempo de ejecución.
Conclusiones clave para equipos de ingeniería
La era del desarrollo de IA de tarifa plana predecible está terminando. Los equipos de ingeniería dependerán cada vez más de la gobernanza en tiempo de ejecución, la presupuestación de ejecución y los controles de costes a nivel de SDK en lugar de confiar únicamente en la facturación del lado de la nube. Las plataformas que dependen en gran medida de las acciones manuales y visuales del usuario pueden enfrentar brechas estructurales cuando los agentes automatizados gestionan el pipeline de solicitudes. La transición a la atribución del lado del servidor y al paso de parámetros seguros representa una dirección altamente probable para mantener un seguimiento confiable y una cobertura de seguridad.
Esta transición sugiere una reescritura fundamental de nuestros marcos de medición y protocolos de seguridad. Es probable que los futuros sistemas de atribución dependan más de la coincidencia de identidad del lado del servidor y la sincronización segura del estado. A medida que más agentes de IA comiencen a actuar como el primer consumidor de comunicación digital, las arquitecturas de atribución dependerán cada vez más de la identidad del lado del servidor, la recuperación de estado diferida y la preservación del contexto a nivel de protocolo en lugar de las sesiones de navegador solamente.
Preguntas frecuentes (FAQ)
¿Por qué OpenAI Codex experimentó un rápido agotamiento de límites?
¿Cómo activan los bucles de agentes autónomos una facturación de API inesperada?
¿Cómo pueden los desarrolladores evitar el consumo inesperado de tokens cuando OpenAI investiga los límites de 'Codex'?
La era del desarrollo de IA de tarifa plana predecible está terminando. Los equipos de ingeniería dependerán cada vez más de la gobernanza en tiempo de ejecución, la presupuestación de ejecución y los controles de costes a nivel de SDK en lugar de confiar únicamente en la facturación de la nube. Las plataformas que dependen en gran medida de acciones manuales y visuales del usuario pueden enfrentar brechas cuando los agentes automatizados gestionan el pipeline de solicitudes. La transición a la atribución del lado del servidor y al paso de parámetros seguros representa una dirección clave para mantener un seguimiento confiable y una cobertura de seguridad.
Esta transición sugiere una reescritura fundamental de nuestros marcos de medición y protocolos de seguridad. Es probable que los futuros sistemas de atribución dependan más de la coincidencia de identidad del lado del servidor y la sincronización segura del estado. A medida que más agentes de IA actúan como consumidores de comunicación digital, las arquitecturas de atribución dependerán cada vez más de la identidad del lado del servidor, la recuperación de estado diferida y la preservación del contexto a nivel de protocolo en lugar de las sesiones de navegador.
Share this article



