¿‘Ornith-1.0’ se centra en la codificación agente? La telemetría temprana de nuestros clústeres de preparación sugiere que este cambio ya está en marcha. El lanzamiento de DeepReinforce de su familia de modelos de auto-andamaje el 25 de junio de 2026 introduce nuevos patrones de flujo de trabajo dentro de los entornos de desarrollo empresarial. Para los equipos de desarrollo, el desafío cambia hacia la gestión de ejecuciones programáticas manteniendo al mismo tiempo la integración de datos. Este lanzamiento marca una transición clara en cómo se entrenan y despliegan los modelos.
Resumen
- Bucle de auto-andamaje: A diferencia de los pipelines tradicionales que utilizan arneses estáticos escritos por humanos, la familia de modelos refina dinámicamente sus propios andamios de ejecución y marcos de políticas específicos para cada tarea durante el aprendizaje por refuerzo.
- Despliegues en niveles equilibrados: Abarca desde un modelo denso compacto de 9B, optimizado para dispositivos de borde con eficiencia de recursos, hasta un modelo insignia de mezcla de expertos (MoE) de 397B.
- Impacto en la integración MMP: Evita las cookies del lado del cliente y los redireccionamientos del navegador tradicionales, lo que requiere el paso de tokens criptográficos a nivel de SDK para evitar apagones en la medición de instalaciones.
Entendiendo el marco de auto-andamaje de Ornith
El lanzamiento de la familia de modelos introduce nuevas dinámicas de precios y capacidades en la capa de servicio del modelo, específicamente cuando Ornith-1.0 se centra en la codificación agente para optimizar conjuntamente tanto el arnés específico de la tarea como la solución de código final. Este marco coevolutivo permite al sistema descubrir mejores trayectorias de búsqueda sin depender de andamios fijos escritos por humanos. Construida sobre puntos de control preentrenados de Gemma 4 y Qwen 3.5, la línea comprende cuatro tamaños distintos, incluidos 9B Dense, 31B Dense, 35B MoE y 397B MoE. Las especificaciones detalladas están documentadas en el Ornith Hub oficial.
Configuraciones de modelos y métricas de rendimiento
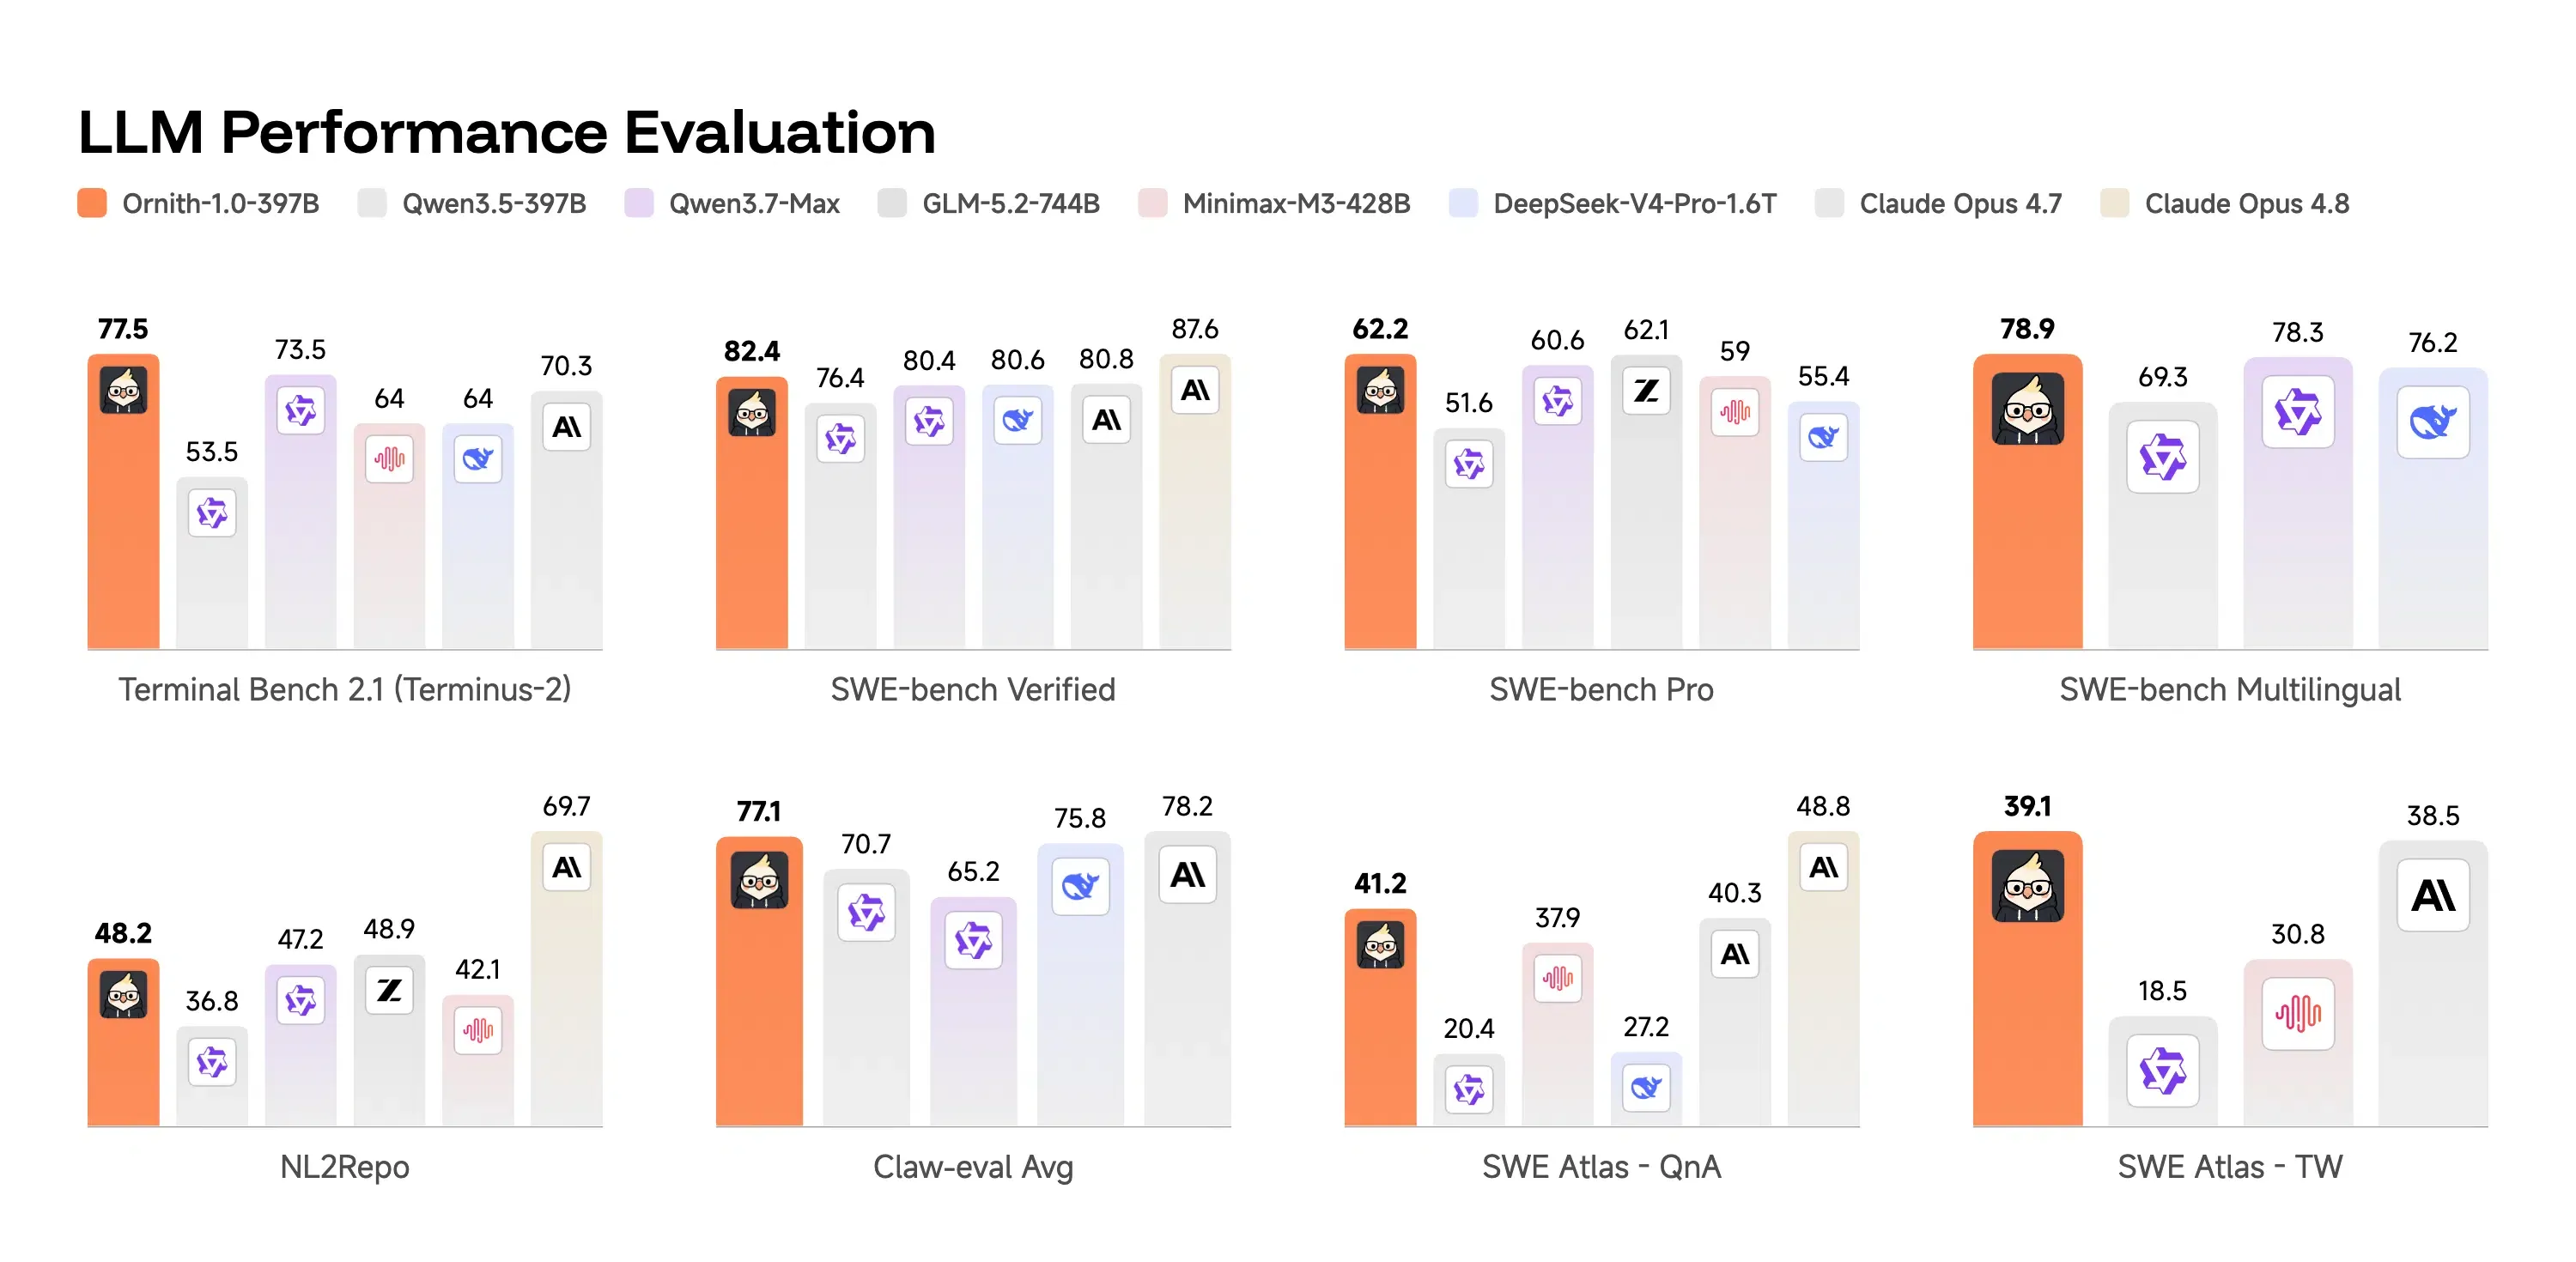
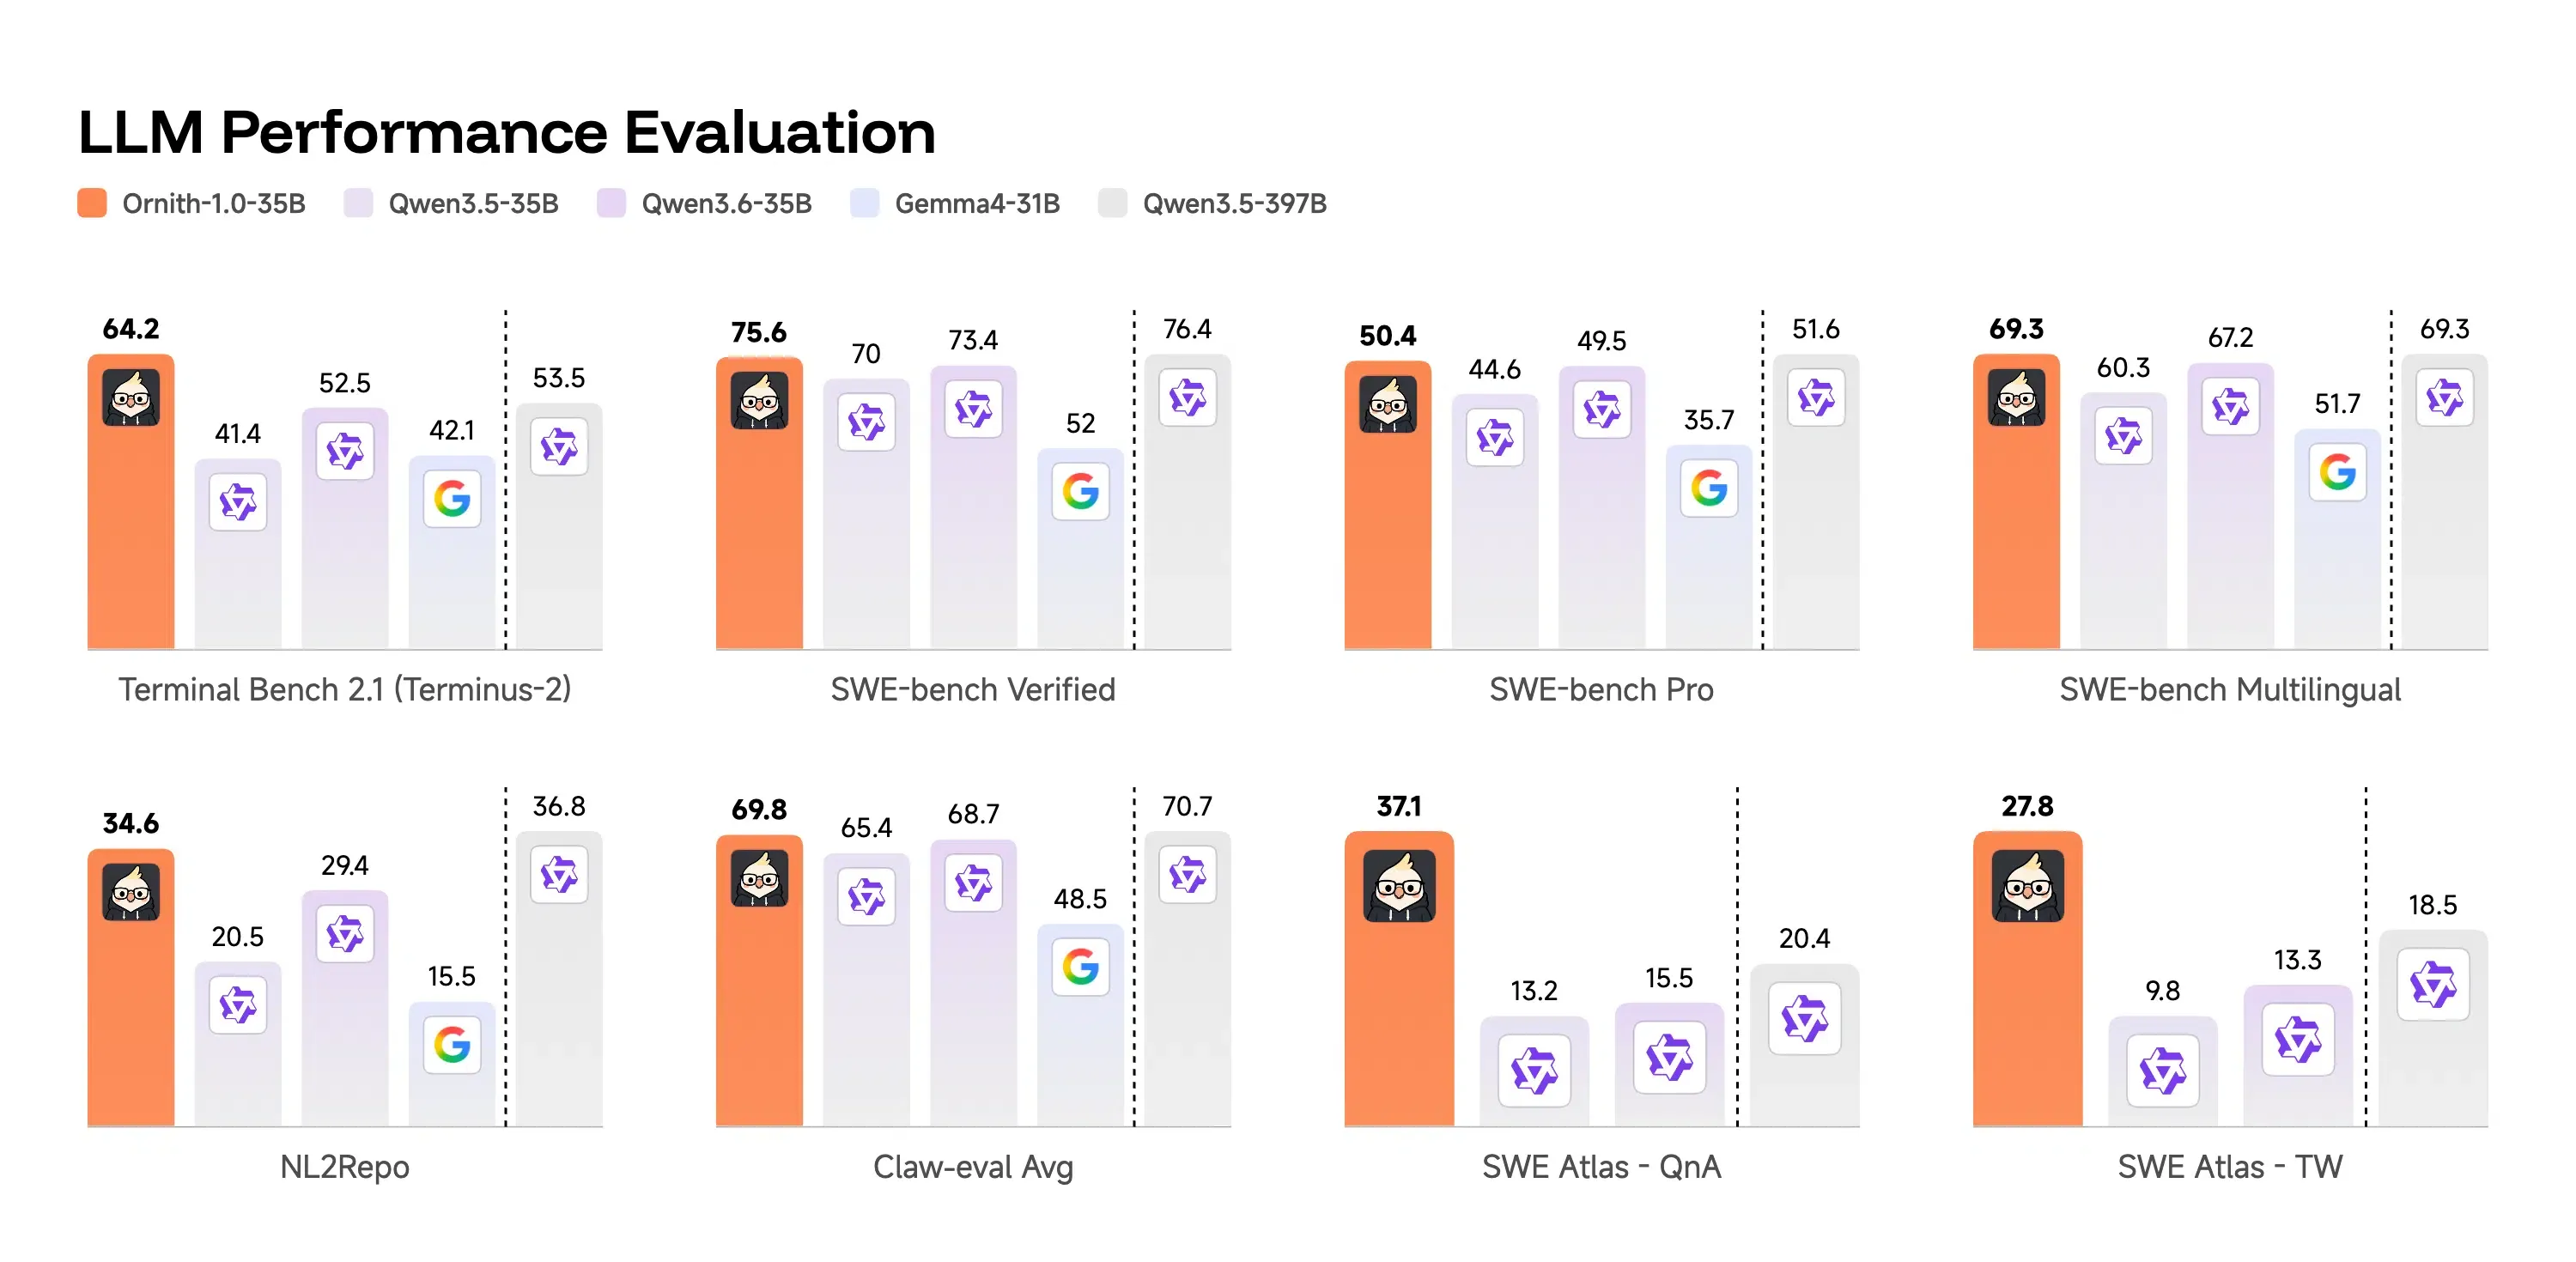
Los resultados de la evaluación destacan ganancias significativas en el rendimiento en múltiples benchmarks de agentes. A escala insignia, el modelo MoE de 397B logra 77.5 en Terminal-Bench 2.1 y 82.4 en SWE-Bench Verified. Este rendimiento supera a Claude Opus 4.7 y supera a los principales modelos abiertos de tamaño similar. Por ejemplo, la arquitectura reduce las lecturas redundantes de archivos y optimiza el movimiento de memoria en tareas de contexto largo. Mientras tanto, el modelo MoE de 35B activa aproximadamente 3B de parámetros por token, lo que ofrece un tiempo de ejecución rápido y rentable. Obtiene 64.2 en Terminal-Bench 2.1, superando a modelos mucho más grandes como Qwen 3.5-397B mientras mantiene una alta estabilidad de ejecución.
Despliegues en el borde con eficiencia de recursos
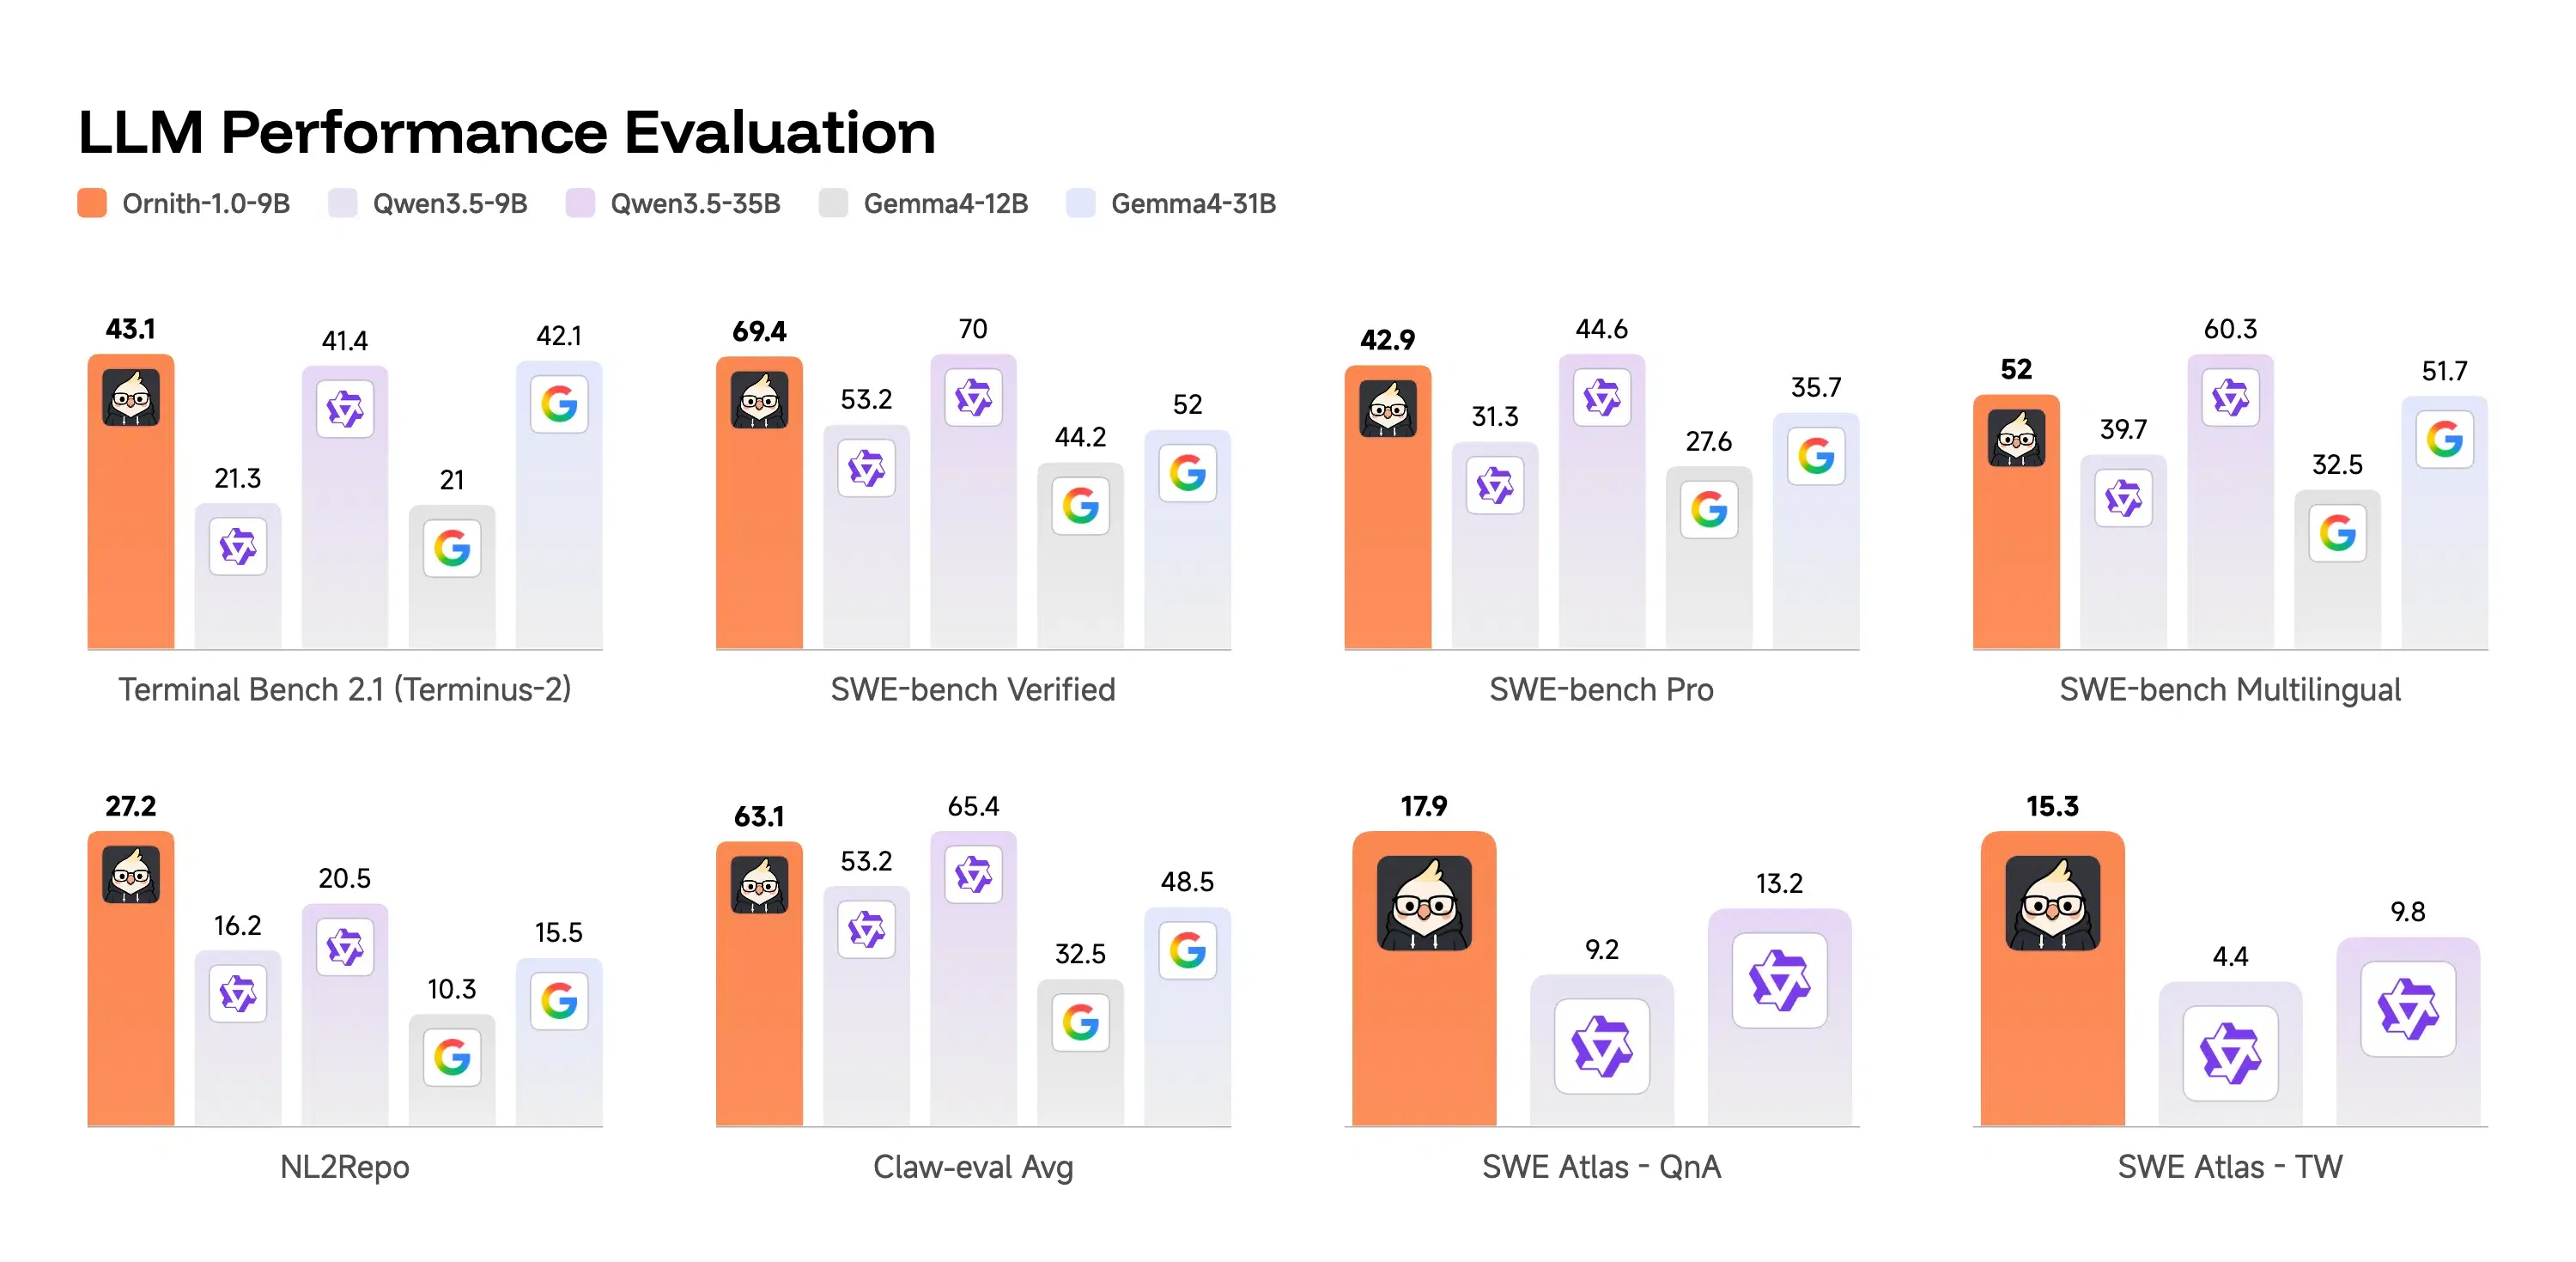
Para despliegues en hardware local y de borde, el modelo denso de 9B ofrece una solución extremadamente eficiente. Logra 43.1 en Terminal-Bench 2.1 y 69.4 en SWE-Bench Verified. Este modelo compacto requiere solo unos 19GB de memoria en bf16, lo que permite a los desarrolladores ejecutarlo en una sola GPU de 80GB. En consecuencia, los equipos pueden ejecutar corridas privadas y locales sin transmitir bases de código sensibles fuera de la organización. El modelo es totalmente compatible con los formatos de cuantificación Ollama, Unsloth y GGUF. Esto permite a los grupos de ingeniería implementar agentes de programación locales siempre activos en hardware de consumo.
El bucle de entrenamiento de auto-mejora
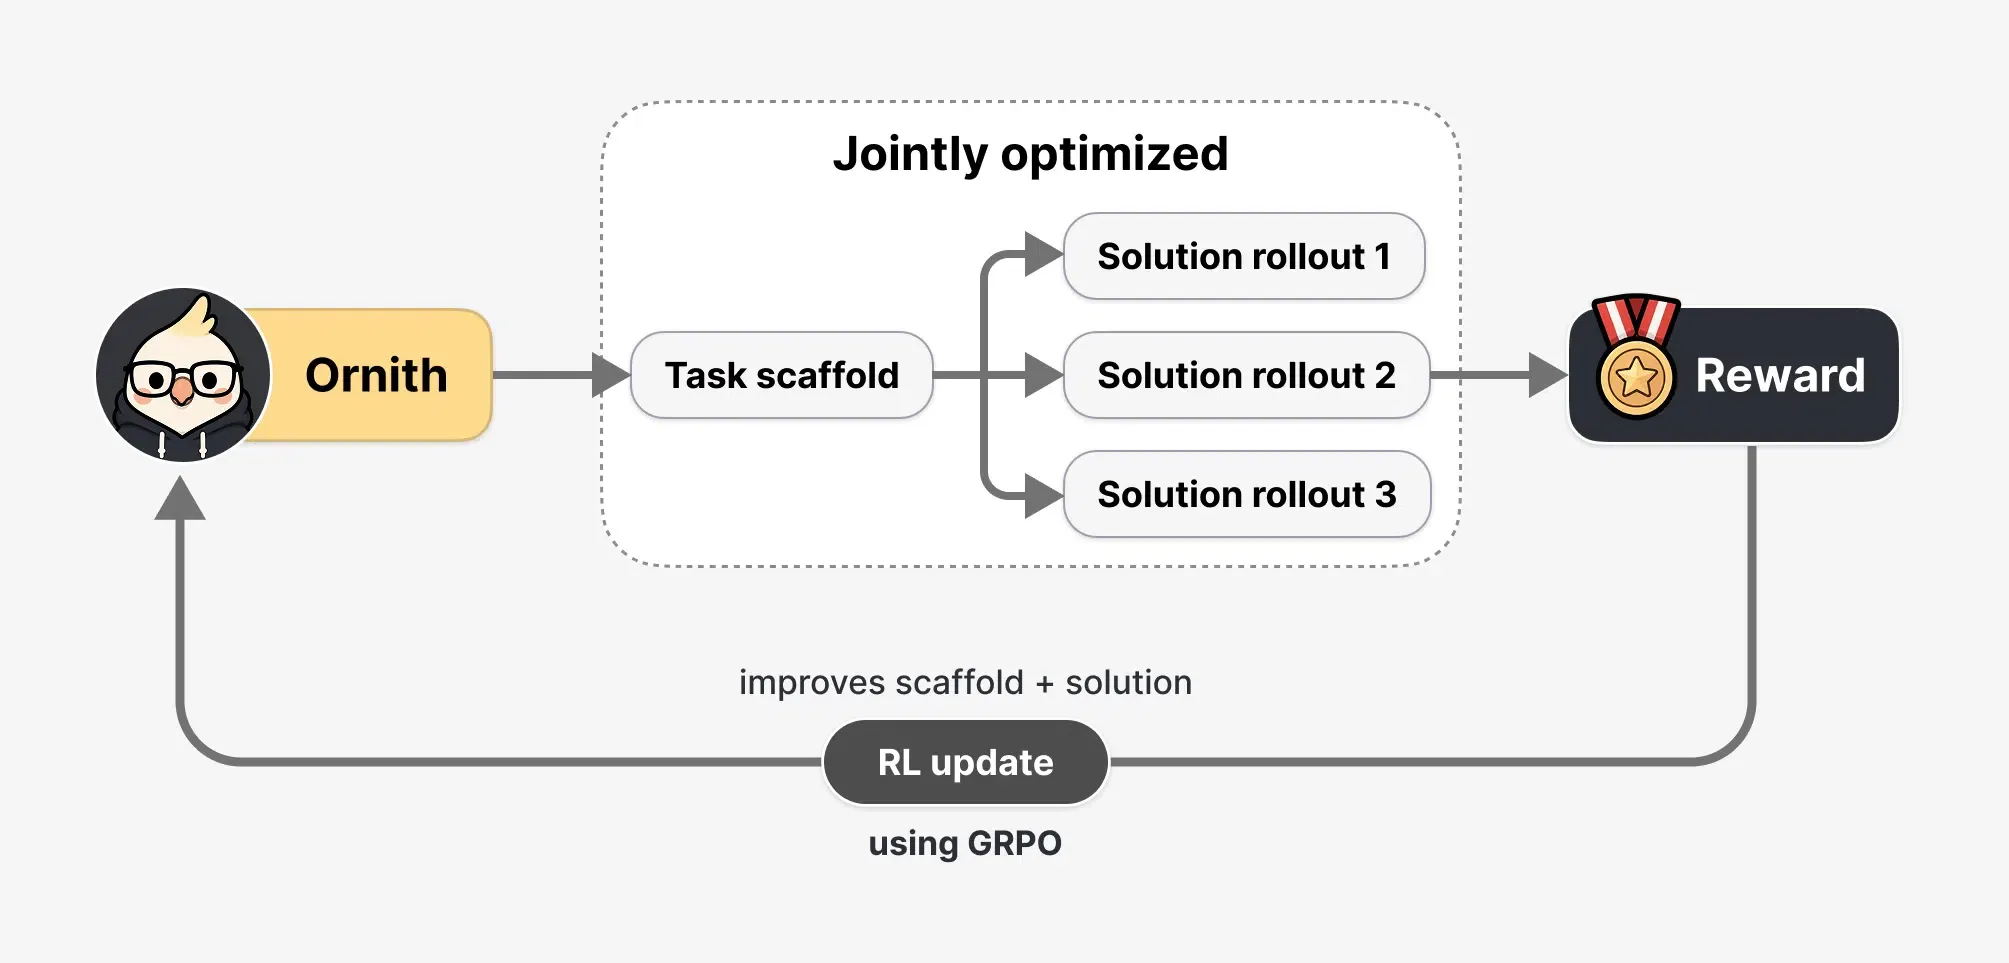
En el núcleo de las capacidades del modelo hay un bucle de entrenamiento de auto-mejora. Durante el aprendizaje por refuerzo, el modelo trata al andamio como un objeto aprendible. Cada paso de entrenamiento procede en dos etapas: primero, el modelo propone un andamio refinado; segundo, utiliza ese andamio para generar un despliegue de solución. La recompensa se propaga a ambas etapas, optimizando al modelo para escribir su propia orquestación. Para evitar el hackeo de recompensas, DeepReinforce implementa una defensa de tres capas: un límite de confianza fijo, un monitor determinista que marca las lecturas de rutas prohibidas y un juez LLM congelado que actúa como veto.
Por qué los agentes sin cabeza crean puntos ciegos de atribución
A medida que los agentes autónomos ejecutan refactorizaciones de múltiples archivos y reparaciones de código, el volumen de transacciones de API en segundo plano aumenta. En consecuencia, a medida que la familia ‘Ornith-1.0’ procesa cargas de trabajo de codificación agente sin cabeza a través de archivos a escala de repositorio, el cambio hacia la ejecución en segundo plano desencadena una crisis de atribución. Para los equipos de desarrollo, el desafío inmediato es gestionar las transiciones multiplataforma mientras se mantiene una validación de sesión de usuario robusta.
Invirtiendo el paradigma de finalización: Cuando la ejecución del agente supera a las teclas presionadas
Los agentes programáticos operan como clientes HTTP sin estado del lado del servidor. No mantienen cookies persistentes, no ejecutan almacenamiento a nivel de navegador y a menudo omiten los encabezados Referrer por completo durante saltos automatizados en segundo plano. Las siguientes observaciones se basan en validaciones de ingeniería internas realizadas en nuestros entornos de preparación, destinadas a ilustrar patrones de ejecución comunes en lugar de benchmarks de toda la industria. Durante un rastreo de telemetría de enrutamiento realizado en abril de 2026, auditamos aproximadamente 165,000 mutaciones de archivos a nivel de repositorio en nuestro entorno de preparación para monitorear cómo los agentes de codificación sin cabeza ejecutaban tareas de refactorización de archivos múltiples. La base de datos registró cero apretones de manos de cookies a nivel de navegador, lo que provocó que la instalación posterior se clasificara completamente como tráfico directo. Esta ejecución sin estado evita los parámetros de seguimiento estándar del lado del cliente como la API Google Play Install Referrer. También evita redireccionamientos a nivel de navegador que son capturados por iOS SKAdNetwork (SKAN) o el tiempo de ejecución del SDK de Android Privacy Sandbox. En consecuencia, cuando un flujo impulsado por agentes completa una transacción a través de API de fondo, la cadena de referencia se rompe. La instalación aparece como una fuente directa desconocida, creando discrepancias notables en la medición de campañas.
Enjambres de bots y el vector de amenaza de fraude publicitario
Los tokens de bajo costo y alto rendimiento crean nuevos desafíos para los equipos de seguridad. En paralelo, el reciente descuento fuera de hora de Alibaba ofrece un 80% de descuento durante las horas de menor actividad. Este cambio de precios reduce drásticamente los costos operativos de ejecutar scripts de agentes automatizados por la noche. Durante una revisión de seguridad rutinaria de 38,000 confirmaciones de repositorio automatizadas, nuestro equipo identificó un grupo de scripts sin cabeza que representaban aproximadamente el 8% de todas las instalaciones registradas, concentradas completamente dentro de una ventana de tres horas. Estas redes de bots falsificaron programáticamente las devoluciones de llamada de instalación, demostrando que los límites de tasa basados en umbrales del lado del cliente son insuficientes. Esta exposición requiere que los desarrolladores implementen una verificación más robusta a nivel de SDK para proteger la inversión en marketing.
Construyendo integraciones de SDK seguras para agentes autónomos
Asegurar los flujos de trabajo impulsados por agentes requiere un enfoque de ingeniería estructurado. Una defensa básica es el despliegue de la verificación de estado a nivel de dispositivo. Los desarrolladores pueden implementar máquinas de estado que validen las huellas digitales del hardware durante una solicitud de sesión. Cuando un agente activa una acción, el servidor verifica este estado para confirmar el contexto de ejecución, bloqueando llamadas no autorizadas. Asegurar los canales de ejecución del backend en entornos de codificación agente requiere un apretón de manos estructurado y verificado criptográficamente.
Diseño de identificadores multi-agente seguros
Aislar el entorno de ejecución es crucial para evitar fugas de datos entre sesiones. Los desarrolladores pueden ejecutar agentes dentro de sandboxes limpios y transitorios que destruyen el estado local al finalizar la tarea. Además, se deben aplicar firmas criptográficas a todos los parámetros en tránsito. Al firmar cada devolución de llamada de URL con claves privadas, los ingenieros de sistemas se aseguran de que los scripts intermedios no puedan alterar la carga útil, preservando la integridad del flujo de datos. Esta configuración segura proporciona una arquitectura de filtrado de tráfico no válido robusta para bloquear intentos de suplantación automatizados.
Endurecimiento de las firmas criptográficas en las implementaciones de SDK
Para evitar dedicar ciclos de sprint internos a la infraestructura de máquina de estado básica, los equipos de ingeniería comúnmente confían en implementaciones de referencia estándar de la industria. En producción, los equipos pueden integrar el marco de transferencia de parámetros de aplicación diferidos para automatizar las comprobaciones de firma y la restauración del estado sin gestionar máquinas de estado complejas. Esta integración permite a la aplicación recuperar el contexto de referencia original desde una devolución de llamada segura del servidor durante el primer inicio. Al pasar un token firmado criptográficamente a través del bucle de instalación, la plataforma conserva el estado de la transacción original, asegurando un flujo de datos consistente a lo largo de todo el ciclo de vida de adquisición.
Alineación de la ingeniería y el marketing en la restauración de estado
La implementación de flujos de trabajo para despliegues de agentes autónomos requiere una estrecha coordinación entre los departamentos técnicos y de marketing. El equipo de ingeniería debe centrarse en estandarizar los identificadores únicos y garantizar la compatibilidad del SDK. Los desarrolladores también deben gestionar los ID de paquete a través de despliegues multi-inquilino para evitar conflictos de enrutamiento en las tiendas regionales. Mientras tanto, los arquitectos deben implementar comprobaciones de firma seguras tanto para las plataformas iOS como Android para evitar la manipulación de enlaces profundos.
Consideraciones técnicas para desarrolladores y arquitectos
Los arquitectos deben asegurarse de que los esquemas de URL personalizados, los enlaces universales y los enlaces de aplicación se verifiquen a nivel de puerta de enlace. Esta configuración evita que los scripts maliciosos secuestren el enrutamiento de intención durante una transición web-a-aplicación. Al aplicar la verificación de firma, los equipos pueden proteger la tubería de datos descendente y mantener registros limpios en sus sistemas utilizando una arquitectura de enlaces universales estandarizada.
Estrategias de crecimiento y adquisición de clientes bajo deflación
Los equipos de crecimiento deben adaptar sus análisis para confiar en el análisis de cohortes y las métricas de retención a largo plazo en lugar de eventos de un solo clic. Integrar el motor de atribución determinista multicanal permite la creación de flujos de incorporación personalizados que preservan la intención del usuario. Cuando ocurre una referencia, el sistema puede atribuir automáticamente la conversión sin requerir entrada manual. Este enfoque mejora la precisión de los cálculos de retorno de la inversión en marketing (ROAS) y ayuda a filtrar el tráfico no válido generado por agentes.
Preguntas frecuentes (FAQ)
¿Por qué fallan las mediciones basadas en referencias en los flujos de trabajo de agentes?
¿Cómo aseguran las firmas criptográficas los SDK cuando 'Ornith-1.0' se centra en la codificación agente?
¿Por qué fallan los métodos estándar de huella digital del dispositivo en los flujos de trabajo de codificación agente?
El lanzamiento significa un cambio más amplio en el panorama tecnológico global. Específicamente, a medida que los procesadores de inferencia dedicados se expanden, el modelo tradicional de acceso al software comienza a disolverse. Además, a medida que los agentes autónomos manejan más tareas administrativas, la interfaz de usuario principal puede pasar de tableros visuales a apretones de manos directos de API de backend. Esta evolución podría reducir el papel de las tiendas de aplicaciones tradicionales en la capacidad de descubrimiento. En cambio, el mercado puede ver un crecimiento en micro-aplicaciones de propósito único bajo demanda, generadas dinámicamente para tareas específicas. Este cambio crea nuevos requisitos para una distribución sin fricciones y una verificación segura en tiempo real.
Además, es probable que los marcos de privacidad de datos como SKAdNetwork y Google Privacy Sandbox sigan limitando el intercambio de datos de terceros. Esta tendencia obliga a los desarrolladores a priorizar la medición determinista de primera parte. En este entorno, los estándares de atribución multitáctil pueden convertirse en un requisito básico para las arquitecturas de sistemas modernos. Las organizaciones que dependen de la atribución basada en navegador pueden querer evaluar si sus tuberías de medición actuales siguen siendo suficientes a medida que los flujos de trabajo impulsados por agentes se vuelven más comunes.
Share this article



