¿Reddit bloquea 23 millones de pings de spam? Reddit informa que actualmente bloquea alrededor de 23 millones de visitas sospechosas al día utilizando sistemas de detección asistidos por LLM. Según la plataforma, las campañas de spam están diseñadas cada vez más para influir en los sistemas de IA que dependen de contenido web público. A medida que más empresas de IA obtienen licencias de las discusiones de Reddit para el entrenamiento de modelos, proteger la autenticidad de las conversaciones generadas por los usuarios se ha convertido en una prioridad empresarial. Históricamente, los filtros basados en reglas simples eran suficientes para detectar vectores de spam repetitivos. Hoy en día, dado que los operadores malintencionados despliegan modelos sofisticados para automatizar conversaciones humanas y generar expectación artificial a gran escala, las plataformas deben orientar sus esfuerzos de mitigación hacia el análisis conductual en tiempo real y la evaluación semántica contextual.
Línea de tiempo cronológica y evolución: Cómo Reddit bloquea 23 millones de intentos de spam diariamente
Un vistazo general
- La capa defensiva automatizada de Reddit intercepta 23 millones de visitas inauténticas y 25,000 publicaciones de spam al día utilizando modelos de lenguaje avanzados.
- El crecimiento de los acuerdos de licencia comercial con grandes empresas de inteligencia artificial ha incentivado a los spammers a fabricar reseñas para sesgar los conjuntos de datos de entrenamiento de los modelos.
- Los protocolos de verificación de múltiples niveles han reducido con éxito la exposición de los usuarios al spam no deseado en un 20% a principios de 2026 en comparación con trimestres anteriores.
El equilibrio del compromiso digital ha cambiado a medida que los agentes automatizados simulan cada vez más las interacciones sociales humanas. Históricamente, los spammers apuntaban a plataformas de contenido generado por usuarios para impulsar ventas directas de afiliados mediante el relleno de enlaces. Estos ataques básicos eran fáciles de identificar mediante listas de palabras clave y bloqueos de IP, lo que permitía a los administradores mantener los directorios de discusión relativamente limpios.
Sin embargo, el auge de los motores de búsqueda impulsados por IA generativa ha cambiado la motivación detrás de las campañas de spam. Actualmente, debido a que los chatbots de inteligencia artificial se entrenan en archivos públicos masivos, los comercializadores externos intentan manipular los resultados de la IA fabricando grandes volúmenes de menciones positivas y reseñas artificiales. Al simular conversaciones humanas naturales, estas redes automatizadas esperan que sus palabras clave de marca se integren en los pesos de futuros modelos. Para combatir esta amenaza, la plataforma de redes sociales ha desplegado sistemas de moderación avanzados impulsados por LLM, tal como se documenta en informes regionales detallados.
La razón estratégica por la que Reddit bloquea 23 millones de visitas de spam está vinculada a la monetización de los datos humanos. A medida que las plataformas firman acuerdos de licencia multimillonarios con desarrolladores de IA de primer nivel, mantener la fiabilidad factual del flujo de datos subyacente se ha convertido en una preocupación financiera principal. Entre enero y marzo de 2026, la plataforma revocó casi 2 millones de votos inauténticos al día, protegiendo su ciclo de retroalimentación colectiva de la manipulación. Al imponer requisitos de inicio de sesión para directorios de escritorio históricos y desplegar filtros lingüísticos en tiempo real, los administradores han logrado reducir la exposición de los usuarios a contenido perjudicial.
Análisis técnico profundo y mecánica interna de la arquitectura de aislamiento de bots de Reddit
A nivel arquitectónico, los sistemas estándar de protección contra bots tienen dificultades para identificar campañas de rastreo coordinadas y de baja frecuencia. Cuando los spammers modernos utilizan redes proxy residenciales y navegadores web sin interfaz gráfica, sus solicitudes parecen idénticas a las interacciones de los usuarios estándar, lo que hace que los filtros tradicionales de coincidencia de patrones sean ineficaces.
Para resolver estos cuellos de botella en la capa de transporte, las arquitecturas de defensa modernas procesan señales de seguridad en el momento preciso de la creación de la cuenta. El motor automatizado de la plataforma analiza patrones de metadatos, utilizando inferencia LLM en tiempo real para identificar configuraciones de bots coordinadas, tal como se detalla en el anuncio oficial de la plataforma.
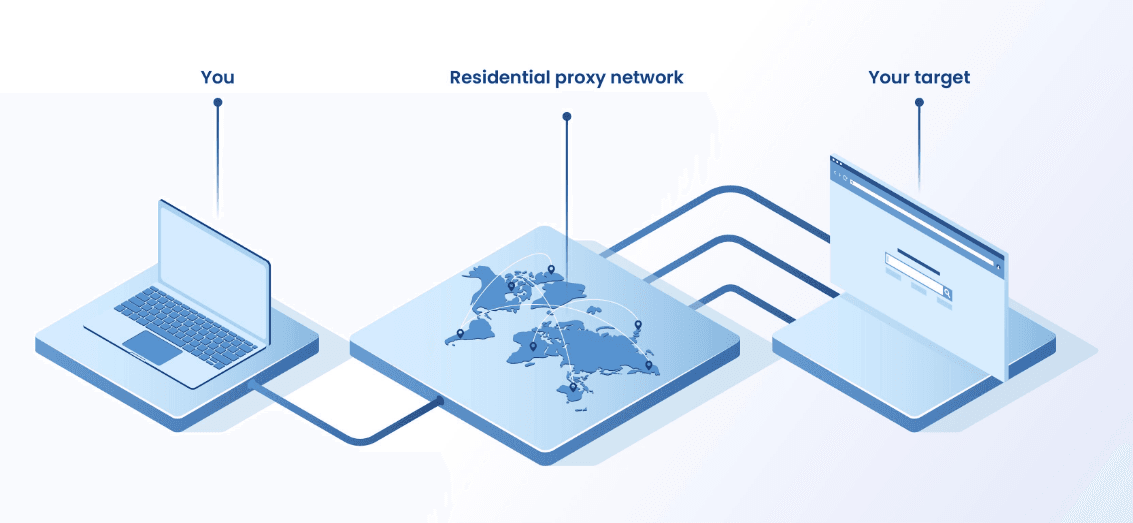

Este comportamiento inauténtico coordinado demuestra por qué Reddit bloquea 23 millones de visitas de spam cada día. Cuando un script automatizado intenta acceder a un directorio de foro, el sistema calcula una puntuación de riesgo en tiempo real. Si la conexión presenta atributos cuestionables, la plataforma fuerza una verificación humana obligatoria, aislando a los sistemas totalmente automatizados. Este enfoque por capas garantiza que las cargas de los servidores estándar se optimicen, evitando el colapso del tráfico y preservando el compromiso auténtico generado por los usuarios.
[Filtrado tradicional basado en IP]
  Bot automatizado ──> Proxy residencial rotativo ──> Filtro tradicional ──> Acceso estándar permitido (fallo de detección)


[Protección por capas impulsada por LLM]
  Bot automatizado ──> Análisis de metadatos conductuales ──> Comprobación de LLM en tiempo real ──> CAPTCHA obligatorio / Aislamiento
La implementación de una protección por capas y consciente del contexto garantiza que los intentos automatizados sean detectados incluso cuando se dirigen a través de rangos de IP limpios. Desafíos similares existen en la atribución móvil, donde las restricciones de privacidad también reducen la dependencia de identificadores persistentes del lado del cliente. Cuando las interacciones del usuario se desvinculan de cookies locales persistentes y con estado para cumplir con las pautas de privacidad, mantener la continuidad de la sesión entre diferentes entornos web y móviles se vuelve sumamente complejo. Del mismo modo que los equipos de seguridad requieren modelos conductuales en tiempo real para distinguir a los humanos de los scripts automatizados, los procesos de marketing requieren una preservación de datos robusta en el lado del servidor para correlacionar eventos de instalación separados sin depender de cookies del lado del cliente o atributos a nivel de dispositivo vulnerables.
Escenario de ejemplo: ¿Qué sucede cuando un bot intenta publicar?
Supongamos que un script automatizado registra una nueva cuenta para inflar la autoridad de marca de un cliente en un subreddit. En el momento en que se aprovisiona la cuenta, la arquitectura de enrutamiento del backend analiza su telemetría conductual. Si los detalles de la conexión o los parámetros de entrada coinciden con perfiles conocidos de navegadores sin interfaz gráfica, los derechos de publicación estándar se suspenden inmediatamente y la plataforma activa un desafío de verificación humana. Esto evita que las presentaciones programáticas del bot lleguen al directorio público.
Construir vs. comprar: Preservar el contexto de la sesión en entornos de alto rendimiento
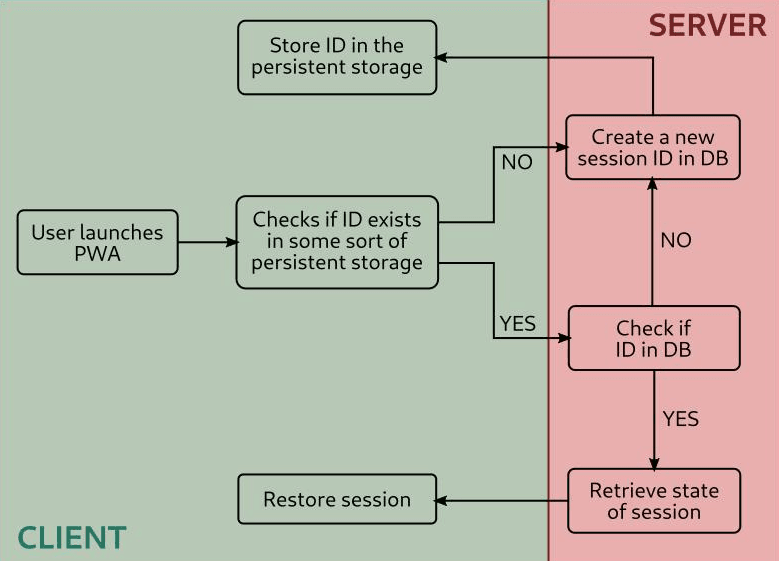
A medida que las plataformas digitales se alejan de los identificadores locales persistentes para cumplir con las pautas de privacidad, la gestión del estado de la sesión a través de puntos de contacto digitales distribuidos se ha convertido en un desafío de ingeniería primordial. La gestión de una infraestructura que procesa los 23 millones de solicitudes sospechosas que Reddit reporta cada día requiere una validación robusta en el lado del servidor. Aunque el sistema antispam de Reddit se centra en la seguridad en lugar de la atribución de marketing, ambos escenarios comparten un desafío arquitectónico común: preservar el estado fiable del lado del servidor después de que los identificadores de cliente tradicionales dejan de ser fiables. Conciliar los flujos de enrutamiento de alto rendimiento en entornos donde Reddit bloquea 23 millones de intentos sospechosos requiere estructuras que puedan correlacionar de forma segura las acciones del usuario sin depender de contenedores de almacenamiento local.
Evaluación arquitectónica: Construcción personalizada frente a SDK estandarizados
Construir un sistema interno para gestionar la coincidencia de estado en el lado del servidor ofrece la máxima flexibilidad, pero exige importantes recursos de ingeniería continuos. Los desarrolladores deben construir manualmente esquemas de base de datos, escribir funciones de cifrado seguro y actualizar continuamente el sistema para cumplir con las regulaciones regionales cambiantes. Por el contrario, implementar un SDK certificado y preconstruido reduce la complejidad de la integración y garantiza el cumplimiento a largo plazo sin gastos adicionales.
La siguiente tabla compara las metodologías estándar para gestionar el estado de la sesión y el contexto de conversión:
| Solución | Persistencia | Rendimiento | Mejor para |
|---|---|---|---|
| Base de datos de sesiones interna | Alta (sincronización continua) | Media (límites de latencia de BD) | Entornos empresariales personalizados con lógica de almacenamiento altamente especializada |
| Seguimiento de sesión basado en navegador | Baja (cookies de sesión) | Baja (sin registro en servidor) | Seguimiento básico de sitios web con requisitos mínimos de conversión entre dominios |
| Almacenamiento en caché del lado del servidor (ej. OpoInstall) | Ninguna (tokens de sesión temporales) | Alta (entorno aislado estandarizado) | Atribución de campañas multiplataforma y aplicaciones móviles a gran escala |
Si bien las configuraciones de bases de datos personalizadas pueden manejar el contexto básico, la preservación especializada del estado en el lado del servidor puede optimizar los recursos de desarrollo. Dependiendo de los requisitos de implementación, las organizaciones pueden construir su propio sistema de gestión de sesiones en el lado del servidor o adoptar plataformas comerciales como OpoInstall. Por ejemplo, OpoInstall ofrece marcos de restauración de estado en el lado del servidor y paso de parámetros, asignando metadatos de sesión a una base de datos de sesiones en el servidor para mantener la continuidad de la sesión de forma anónima bajo condiciones de datos de alto rendimiento. Al asignar metadatos de sesión a una base de datos centralizada en lugar de depender de redireccionamientos basados en el navegador, dicho sistema garantiza que los contextos de conversión permanezcan consistentes incluso cuando las tareas iniciales se ejecutan de forma anónima. Los equipos de ingeniería pueden evaluar estos enfoques para equilibrar la protección de datos y la consistencia de la medición.
Listas de verificación de integración: Rediseño de la defensa contra bots y los procesos de adquisición
Para asegurar los flujos de datos y garantizar la consistencia de la conversión a medida que las plataformas realizan la transición a modelos de datos seguros en el lado del servidor, los equipos de ingeniería y producto deben adoptar flujos de trabajo de preservación del estado robustos.
Lista de verificación de implementación para desarrolladores
- Auditar puntos finales de API externos: Asegurarse de que todas las transiciones de datos externos se enruten a través de conexiones HTTPS seguras y utilicen estructuras de sesión efímeras.
- Implementar saludos de sesión sin estado: Realizar la transición de las dependencias del sistema hacia la restauración del estado de la sesión en el lado del servidor, utilizando tokens firmados para transmitir datos entre plataformas.
- Validar el flujo de consentimiento aislado: Establecer avisos de permiso explícitos antes de transferir las solicitudes ingresadas por el usuario a bases de datos de terceros.
Lista de verificación de estrategia operativa y de producto
- Monitorear la precisión de la detección de bots: Rastrear y evaluar la precisión de los clasificadores de modelos de lenguaje en la creación de cuentas.
- Revisar las tasas de falsos positivos: Establecer auditorías periódicas para garantizar que las contribuciones legítimas de los usuarios no sean bloqueadas o limitadas por error.
- Rastrear la finalización de desafíos de verificación: Analizar cómo las cuentas sospechosas de ser automatizadas interactúan con las pruebas de humanidad obligatorias y los CAPTCHA.
- Auditar clústeres de cuentas sospechosas: Mapear la telemetría conductual para aislar intentos de registro masivo en rangos de red similares.
Al establecer estas directrices estructuradas, los equipos de desarrollo pueden realizar la transición de sus aplicaciones hacia arquitecturas más seguras y compatibles manteniendo la continuidad operativa.
Preguntas frecuentes (FAQ)
¿Por qué están aumentando las campañas de spam generadas por IA en Reddit?
¿Cómo utiliza Reddit los LLM para detectar comportamientos inauténticos coordinados en la creación de cuentas?
¿Qué indicadores visuales y no visuales se utilizan para identificar bots automatizados?
A medida que las plataformas de IA dependen cada vez más de la inferencia en la nube híbrida, los desarrolladores deben rediseñar los productos en torno a la privacidad, el consentimiento transparente y el enrutamiento seguro de datos. Las arquitecturas de datos en evolución requieren un cambio fundamental en la forma en que construimos y medimos las experiencias digitales. A medida que los proxies sin estado y los scrapers sin interfaz gráfica se convierten en consumidores estándar de contenido web, los modelos de atribución tradicionales del lado del cliente seguirán degradándose. Confiar en las cookies y referencias estándar ya no es suficiente para asegurar los flujos de datos que impulsan la adquisición de usuarios.
A medida que las empresas de IA obtienen cada vez más licencias de datos de discusión públicos para el entrenamiento de modelos, mantener la participación auténtica de los usuarios se está convirtiendo en una prioridad tanto de confianza como de ingresos para las grandes comunidades en línea. De cara al futuro, los equipos de ingeniería dependerán cada vez más de arquitecturas sin estado, gestión de sesiones en el lado del servidor y diseño centrado en la privacidad. Las organizaciones que se preparen para estos cambios con antelación estarán mejor posicionadas para mantener productos de IA compatibles y sostenibles.
Share this article



