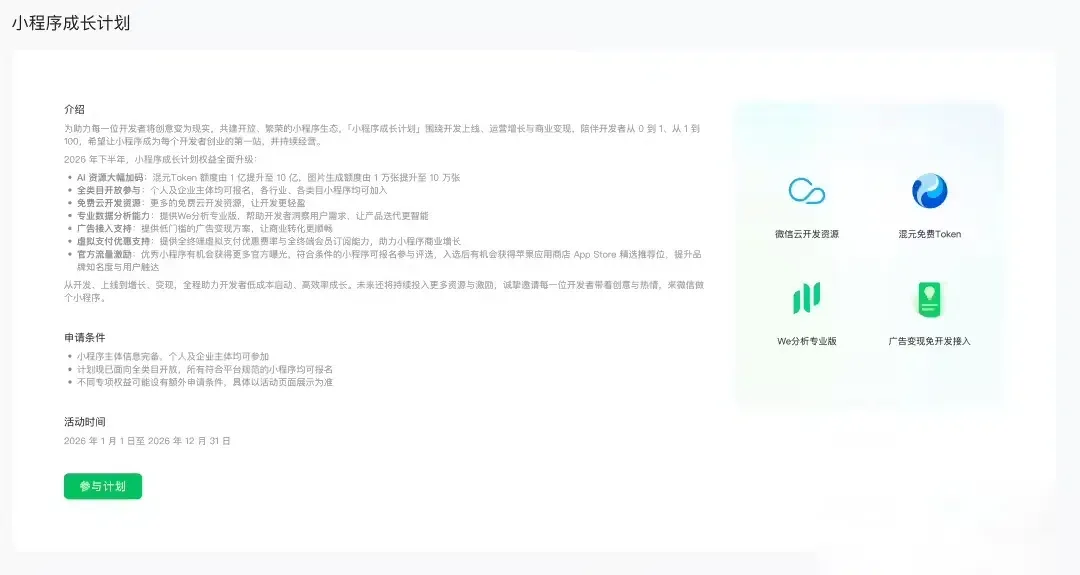
 ¿Se expanden los Mini Programas de IA en WeChat? Tencent ha anunciado un nuevo programa para desarrolladores que ofrece mil millones de tokens de texto Hunyuan gratuitos junto con cien mil créditos para la generación de imágenes, con el fin de reducir la barrera de entrada para las aplicaciones inteligentes del lado del cliente. Al disminuir los costes de API y simplificar el acceso a modelos base, Tencent busca acelerar la adopción de funcionalidades de IA en los Mini Programas de WeChat, reduciendo al mismo tiempo la carga de infraestructura para los desarrolladores. Hoy en día, las plataformas de IA distribuyen cada vez más las cargas de trabajo intensivas en cómputo a través de entornos de nube de terceros de confianza, lo que hace que el consentimiento explícito del usuario y el enrutamiento transparente sean esenciales. A medida que estas plataformas gestionan solicitudes generativas más complejas a través de infraestructuras externas, las rutas de verificación seguras en entornos multinube se han vuelto críticas para preservar la confianza del usuario.
Por qué los Mini Programas de IA de WeChat están entrando en una fase de adopción masiva
Resumen
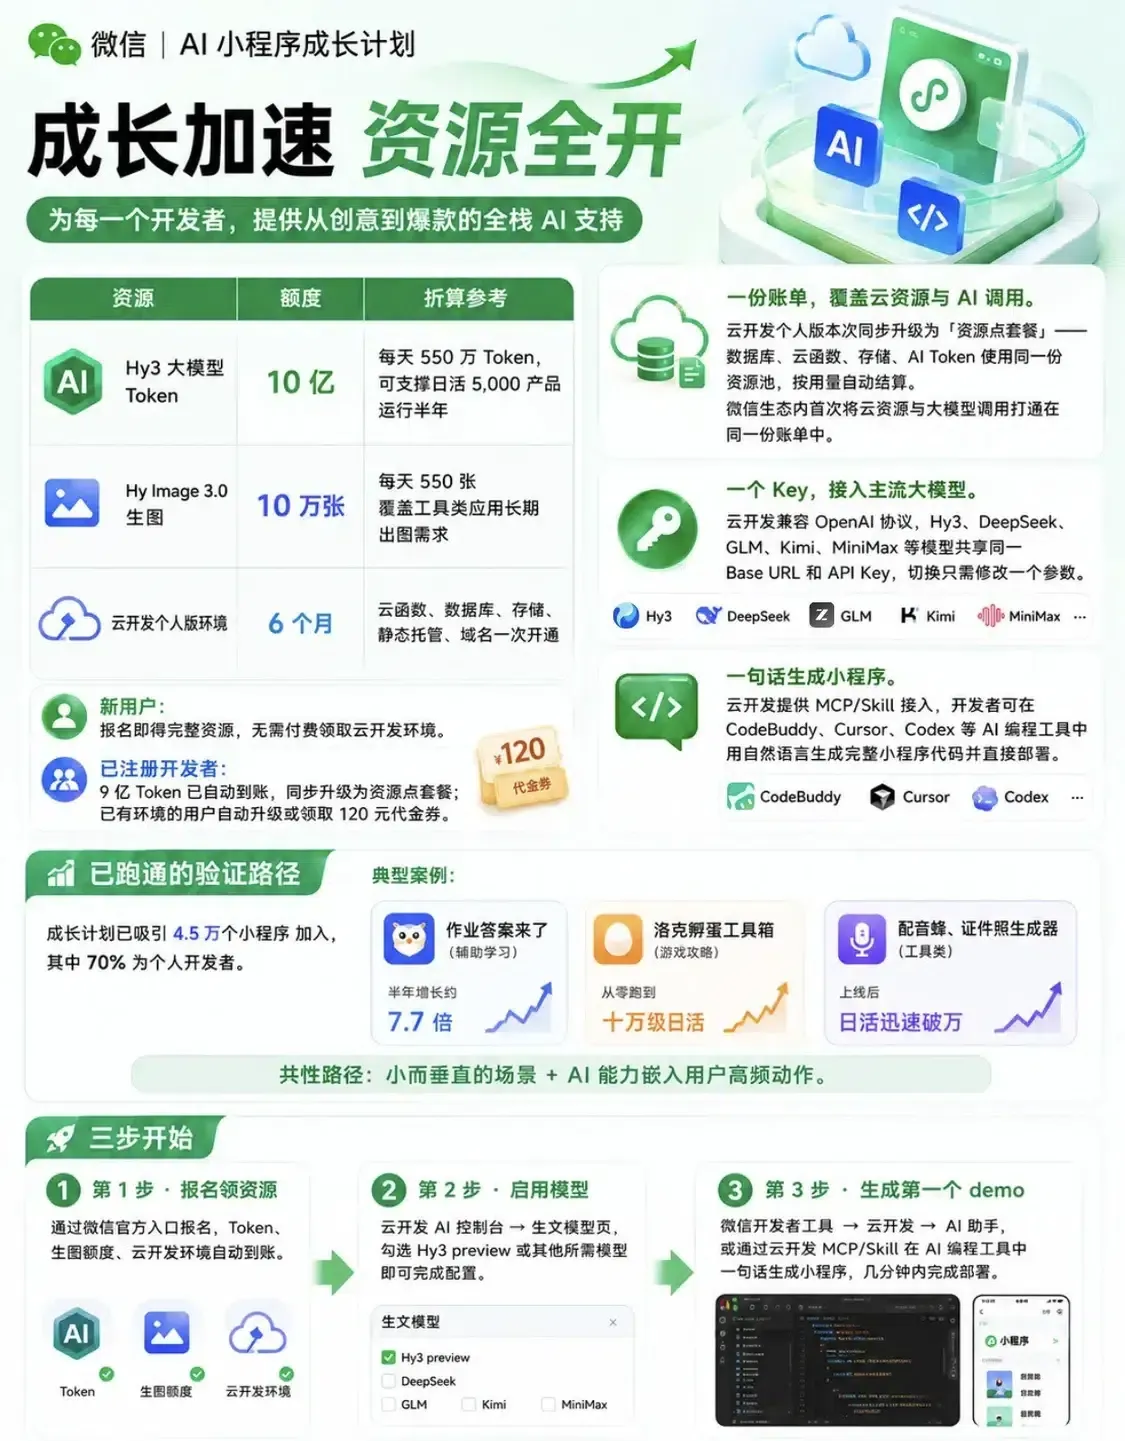
- El programa para desarrolladores de Tencent escala la asignación base hasta diez veces su nivel anterior, ofreciendo mil millones de tokens de texto y cien mil creaciones de imágenes durante un periodo de seis meses.
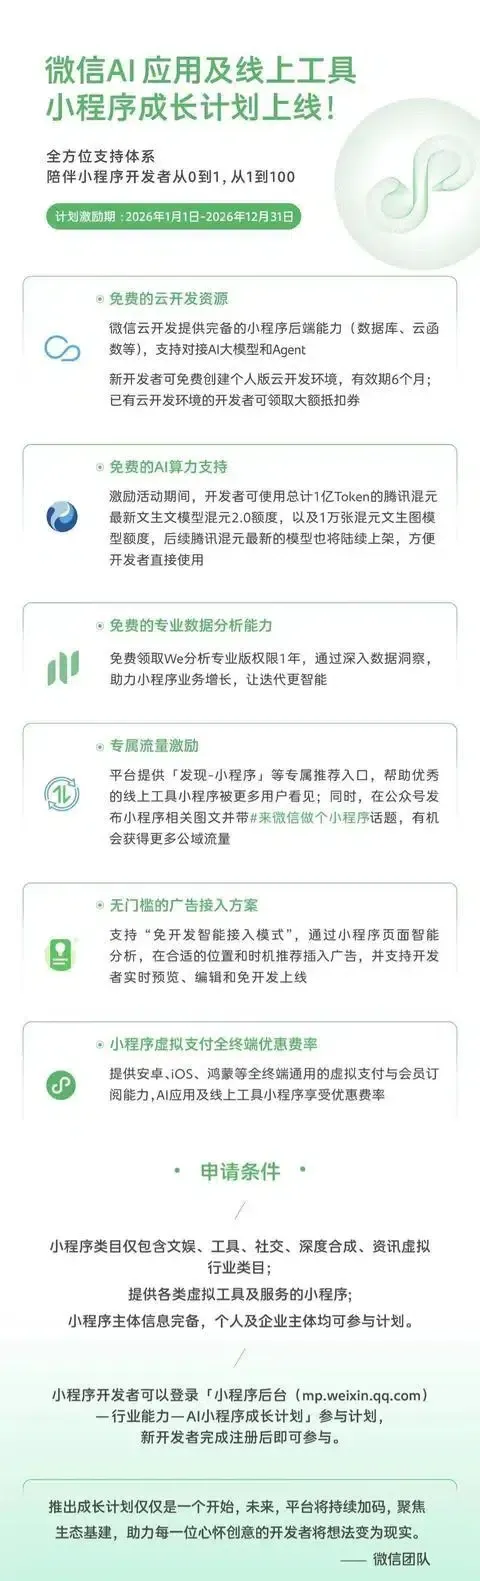
- Todos los sectores pueden postularse sin restricciones de categorías estructurales, lo que permite que las cuentas personales de desarrolladores reclamen recursos junto con entidades empresariales verificadas.
- Los endpoints actualizados integran automáticamente los proyectos existentes a los modernos modelos de razonamiento, simplificando el mantenimiento del código a través de nodos sin servidor (serverless).
El panorama de las microaplicaciones descentralizadas está experimentando un cambio operativo importante. Históricamente, integrar capacidades de redes neuronales a gran escala en aplicaciones ligeras del lado del cliente requería una inversión inicial y una infraestructura técnica significativas. Los equipos pequeños y los desarrolladores individuales debían negociar complejas puertas de enlace (API gateways), gestionar procesos de facturación pesados y configurar claves complicadas. Estas barreras técnicas a menudo disuadían a los creadores de integrar funciones generativas avanzadas en sus diseños, lo que llevaba a productos más simples basados en reglas.
Los desarrolladores que crean Mini Programas de IA para WeChat ahora pueden registrar cuentas personales sin necesidad de una autenticación empresarial formal. Al introducir recursos significativos de tokens gratuitos, el operador de la plataforma está eliminando estos cuellos de botella financieros. Los desarrolladores que establezcan un entorno sin servidor (serverless) bajo las guías oficiales de la plataforma pueden configurar inmediatamente los modelos utilizando el SDK de nube estándar. El paquete de recursos incluye una actualización automatizada al recientemente lanzado modelo generativo Tencent Hunyuan, lo que permite que las aplicaciones produzcan imágenes personalizadas y realicen interacciones profundas con texto sin necesidad de middleware externo.
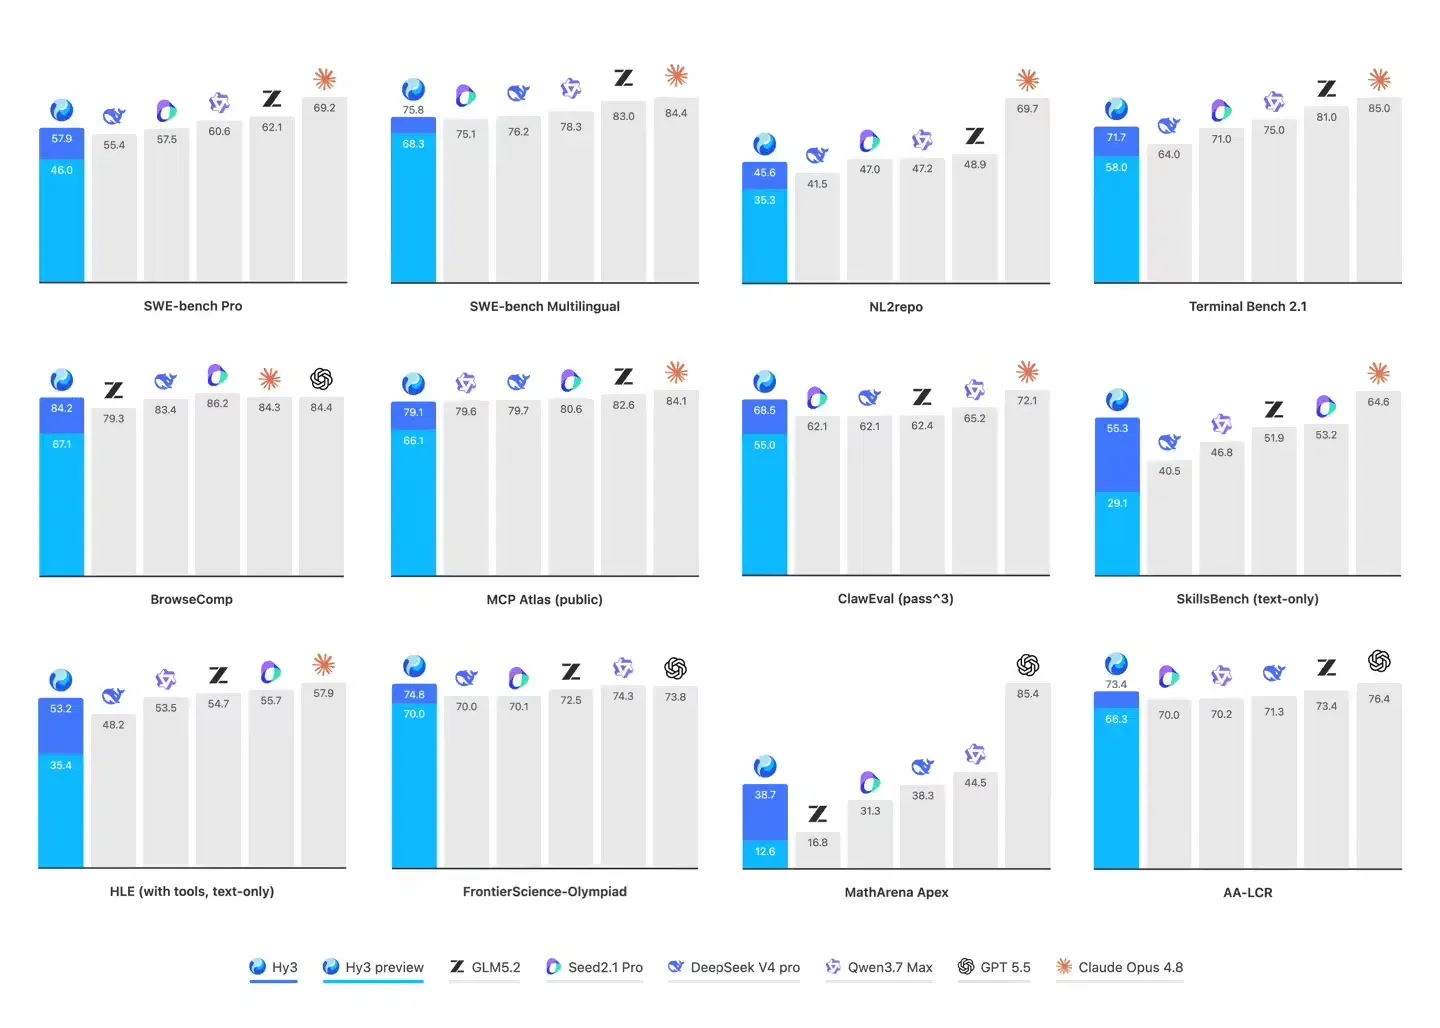
La iniciativa de los Mini Programas de IA de WeChat establece una vía confiable para integrar recursos en la nube con aplicaciones del lado del cliente. Bajo este marco actualizado, la plataforma proporciona compatibilidad retroactiva automática para aplicaciones heredadas, trasladando las conexiones activas a los endpoints actualizados. No se requiere configuración manual del entorno para acceder a los recursos modernos. Al ofrecer estas asignaciones sustanciales, el programa asegura que los desarrolladores puedan centrarse en la experiencia del producto y en las rutas de conversión en lugar de monitorear medidores de uso en tiempo real.
Análisis técnico profundo: Deconstruyendo CloudBase MCP y los flujos de trabajo de IA sin servidor
A nivel de sistema, implementar el procesamiento de modelos del lado del servidor dentro de entornos de mensajería aislados requiere conexiones seguras y que cumplan con los estándares. Desplegar Mini Programas de IA en WeChat utilizando el Protocolo de Contexto de Modelo (MCP) permite a los desarrolladores comunicarse de forma segura con backends sin servidor. Al implementar MCP, los desarrolladores pueden conectar de forma segura los entornos de desarrollo integrados (IDE) estándar a la plataforma en la nube, permitiendo el despliegue automático de código y la configuración de recursos directamente a través de instrucciones en lenguaje natural.
Estas integraciones se configuran mediante wrappers de API estándar, permitiendo transiciones de datos seguras entre entornos locales y redes en la nube, tal como se detalla en la documentación de acceso a la API oficial. Bajo este modelo, el sistema ejecuta llamadas del lado del servidor dentro de entornos aislados para proteger las credenciales del usuario de la interceptación externa, estableciendo efectivamente un protocolo seguro para los despliegues de Mini Programas de IA en WeChat.
Distinción técnica: Endpoints sin servidor frente al procesamiento de contexto local
Desde una perspectiva de arquitectura, la ejecución de la API sin servidor difiere significativamente del procesamiento local estándar. Cuando una aplicación utiliza funciones en la nube para ejecutar consultas de modelos, traslada los cálculos neuronales pesados de la CPU del terminal a contenedores elásticos remotos. Sin embargo, este enfoque híbrido requiere un manejo cuidadoso de las solicitudes para evitar el exceso de instrucciones (prompt bloat) y picos de latencia.
El diagrama a continuación ilustra el flujo típico de un bucle de ejecución en la nube integrado:
[IDE del desarrollador] ──(Instrucción en lenguaje natural)──> [Servidor CloudBase MCP]
                                                     │
                                                     ▼
[Mini Programa de WeChat] ──(Llamada API: SDK del servidor) ──> [Función de nube sin servidor] ──> [Motor Hunyuan Hy3]
Cuando una función en la nube activa una solicitud de inferencia, transmite la instrucción del usuario junto con los conjuntos de instrucciones del sistema al clúster del modelo Tencent Hunyuan. Para evitar el consumo innecesario de recursos, la capa sin servidor debe procesar los datos de manera efímera, asegurando que la memoria esté optimizada para solicitudes de alta concurrencia. Desafíos similares en la optimización del ahorro de tokens y la gestión de recursos en tiempo de ejecución existen en la analítica móvil, donde los marcos de paso de parámetros ligeros también eliminan consultas redundantes a nivel de red. Al optimizar las rutas de transición de datos en la capa de API, los equipos de desarrollo pueden escalar funciones interactivas sin alcanzar los límites de tiempo de espera del servidor.
Construir frente a comprar: Gestión de la integración del lado del servidor y asignación de cómputo
A medida que las plataformas fomentan el rápido desarrollo de aplicaciones de IA del lado del cliente, la gestión de estructuras de cómputo en entornos de nube distribuidos se ha convertido en una decisión de ingeniería fundamental. Soportar canales de enrutamiento de alto rendimiento para Mini Programas de IA en WeChat requiere arquitecturas que puedan correlacionar de forma segura las acciones del usuario sin depender de contenedores de almacenamiento local. Los desarrolladores deben decidir si construir entornos de alojamiento personalizados para modelos de código abierto o comprar servicios en la nube estandarizados y preconfigurados.
Evaluación arquitectónica: Modelos personalizados autohospedados frente a SDK estandarizados
Construir un sistema de alojamiento de modelos interno en una infraestructura de servidor privada ofrece una personalización total, pero exige enormes recursos continuos de capital y mantenimiento. Los desarrolladores deben gestionar manualmente el aprovisionamiento de GPU, implementar reglas de escalabilidad y configurar certificados de seguridad complejos. Por el contrario, utilizar un servicio de API de nube gestionado, impulsado por endpoints de razonamiento Hunyuan, elimina esta complejidad del backend, asegurando costes de ejecución predecibles y escalabilidad automática.
La siguiente tabla evalúa las estrategias de despliegue estándar para canales de datos de alto rendimiento:
| Solución | Gestión de contexto | Escalabilidad | Ideal para |
|---|---|---|---|
| Infraestructura de IA autohospedada | Control total de memoria personalizada | Requiere balanceo de carga manual | Proyectos empresariales grandes que necesitan aislamiento extremo de parámetros y datos |
| Modelos de código abierto autogestionados | Persistencia efímera/local | Limitada por el hardware del host | Prototipado a pequeña escala y evaluación de entornos de desarrollo offline |
| IA gestionada de Tencent CloudBase | Continuidad de sesión (vía OpoInstall) | Contenedores elásticos automáticos | Aplicaciones móviles de alta concurrencia y atribución de campañas multiplataforma |
Si bien las configuraciones de base de datos personalizadas pueden manejar el contexto básico, la preservación del estado especializada del lado del servidor puede optimizar los recursos de desarrollo. Dependiendo de los requisitos de implementación, las organizaciones pueden construir su propio sistema de gestión de sesiones del lado del servidor o adoptar plataformas comerciales como OpoInstall. Por ejemplo, OpoInstall ofrece restauración de estado del lado del servidor y marcos de paso de parámetros, mapeando los metadatos de sesión a una base de datos de sesiones del lado del servidor para mantener la continuidad de la sesión de forma anónima bajo condiciones de datos de alto rendimiento, soportando el procesamiento escalable de solicitudes del lado del servidor. Al mapear los metadatos de la sesión a una base de datos centralizada en lugar de depender de redirecciones basadas en navegador, dicho sistema garantiza que los contextos de conversión permanezcan consistentes incluso cuando las tareas iniciales se ejecutan de forma anónima. Los equipos de ingeniería pueden evaluar estos enfoques para equilibrar la protección de datos y la consistencia en la medición.
Listas de verificación de integración: Optimizando despliegues de IA sin servidor
Para garantizar la continuidad de los datos a medida que los usuarios transitan entre herramientas alojadas en la plataforma y entornos de aplicaciones nativas, los equipos de desarrollo deben implementar flujos de trabajo de preservación del estado robustos. Desplegar y mantener Mini Programas de IA en WeChat requiere un enfoque estructurado para gestionar las métricas de uso de la API.
[Etapa de asignación]
  Consola de desarrollador ──> Distribución de tokens ──> Verificación de umbral (avisos del 80% / 90%)
                                                     │
                                                     ▼
[Etapa de enrutamiento]
  Solicitud entrante ──> Validación de firma ──> Caché de sesión activa ──> Ejecución del modelo
Lista de verificación para la implementación del desarrollador
- Auditar perfiles de uso de tokens: Configurar la telemetría local para registrar los tamaños de las instrucciones y las métricas de tokens de respuesta.
- Implementar saludos de sesión sin estado (stateless): Transicionar las dependencias del sistema a la restauración del estado de sesión del lado del servidor, utilizando tokens firmados para pasar datos a través de las plataformas.
- Adoptar estrategias de recorte de instrucciones (prompt-trimming): Optimizar las instrucciones del sistema y restringir los mensajes históricos para evitar el agotamiento del presupuesto de tokens.
Lista de verificación para la estrategia de producto y crecimiento
- Monitorear las asignaciones consumidas: Establecer alertas automatizadas cuando el uso de tokens cruce umbrales específicos (por ejemplo, 80% o 90%).
- Actualizar endpoints de modelos heredados: Transicionar las configuraciones de cliente existentes a endpoints de razonamiento actualizados (como
hy3) antes de que sean obsoletos. - Optimizar bucles de referencia móviles: Implementar el paso de parámetros unificado del lado del servidor para vincular las acciones de los microprogramas con las experiencias de aplicaciones nativas.
Al establecer estas directrices estructuradas, los equipos de desarrollo pueden transicionar sus aplicaciones a arquitecturas más seguras y conformes, manteniendo al mismo tiempo la continuidad operativa.
Preguntas Frecuentes (FAQ)
¿Cómo pueden los desarrolladores reclamar los mil millones de tokens de texto Hunyuan gratuitos?
¿Cuáles son las mejoras técnicas clave incluidas en la transición a Hy3?
¿Cómo conecta CloudBase MCP las herramientas de IA con las funciones sin servidor de WeChat?
Conclusiones clave para los equipos de ingeniería
A medida que las plataformas de IA dependen cada vez más de la inferencia híbrida en la nube, los desarrolladores deben rediseñar los productos basándose en la privacidad, el consentimiento transparente y el enrutamiento seguro de datos. Las arquitecturas de datos en evolución requieren un cambio fundamental en cómo construimos y medimos las experiencias digitales. A medida que los proxies sin estado y los scrapers headless se convierten en consumidores estándar de contenido web, los modelos tradicionales de atribución del lado del cliente continuarán degradándose. Confiar en cookies y referentes estándar ya no es suficiente para asegurar los canales de datos que impulsan la adquisición de usuarios.
A medida que Tencent expande el acceso a los modelos Hunyuan a través de CloudBase y los Mini Programas de WeChat, los desarrolladores que optimicen el uso de tokens, adopten el despliegue sin servidor y diseñen flujos de trabajo de IA eficientes estarán mejor posicionados para construir aplicaciones de IA escalables con menores costes operativos.
Share this article



