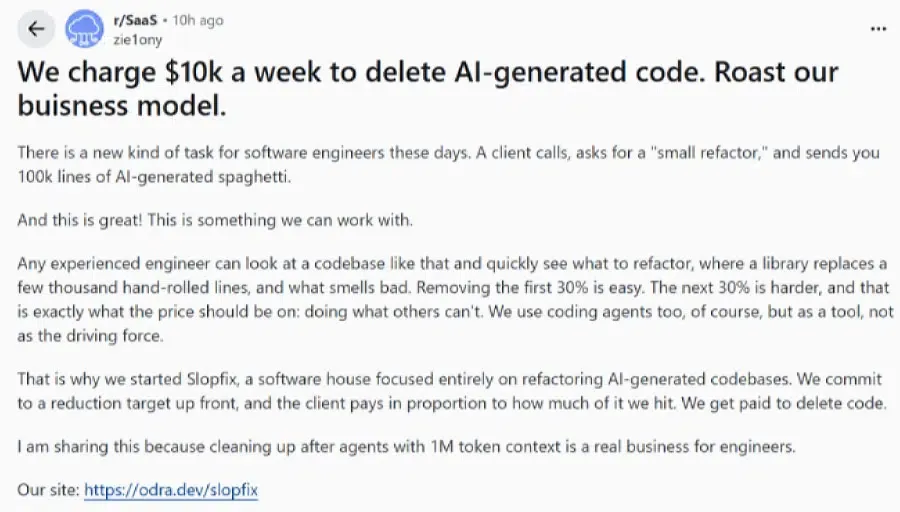
¿Por qué las empresas pagan a ingenieros 10.000 $ a la semana por eliminar código generado por IA? Las empresas están pagando miles de dólares a la semana a ingenieros de software por eliminar código generado por IA de sus repositorios de producción. A medida que la inteligencia artificial generativa aumenta el volumen de producción programática, los equipos de desarrollo se enfrentan a un difícil compromiso entre la entrega rápida de funcionalidades y la mantenibilidad arquitectónica a largo plazo. Actualmente, dado que los agentes de codificación autónomos suelen duplicar lógica e ignorar los límites modulares, las organizaciones están descubriendo que refactorizar y eliminar archivos redundantes aporta más valor que generar otros nuevos de forma continua.
El negocio de 10.000 $ semanales por eliminar código generado por IA
Resumen
- Agencias de ingeniería especializadas están cobrando hasta diez mil dólares por semana para auditar, refactorizar y reducir bases de código infladas escritas por IA.
- Los estudios de caso demuestran bucles de refactorización exitosos que reducen las bases de código corporativas estándar en un sesenta y cinco por ciento, preservando todas las funcionalidades.
- El rápido crecimiento de patrones de bloques de código duplicados ha alcanzado máximos históricos, lo que reduce directamente la velocidad de desarrollo en los principales sistemas de software.
El acuerdo estándar en el desarrollo de software ha experimentado un cambio significativo. Durante años, el desafío central de los equipos de ingeniería era escribir código lo suficientemente rápido para seguir el ritmo de los requisitos del producto. Los desarrolladores estructuraban manualmente las conexiones a bases de datos, diseñaban capas de serialización y escribían pruebas unitarias, dedicando gran parte de su ciclo de desarrollo al ensamblaje rutinario y repetitivo de código.
La integración de modelos de lenguaje extensos (LLM) y asistentes de codificación ha eliminado esta fricción inicial por completo. Al utilizar herramientas como Claude Code, GitHub Copilot y editores integrados como Cursor o Windsurf, los desarrolladores (tanto técnicos como no técnicos) pueden generar aplicaciones completas mediante peticiones en lenguaje natural de alta frecuencia, un proceso conocido comúnmente como "Vibe Coding". Sin embargo, a medida que estos archivos automatizados se multiplican, la falta de diseño arquitectónico se vuelve evidente. Los sistemas de IA destacan produciendo la respuesta localizada e inmediata solicitada por una instrucción, pero no pueden evaluar la arquitectura técnica global a largo plazo. Esto deriva en funciones redundantes y estructuras de datos altamente acopladas, lo cual está documentado en el portal técnico Slopfix.
Para restaurar la mantenibilidad del sistema, los líderes de ingeniería están estableciendo objetivos de eliminación de código seguro. Se están contratando equipos de desarrollo experimentados para evaluar repositorios desordenados, establecer comprobaciones de regresión automatizadas y eliminar miles de clases duplicadas. Esta brecha de rendimiento explica por qué las organizaciones pagan a desarrolladores profesionales para eliminar código generado por IA en lugar de seguir escribiendo archivos nuevos. Al utilizar experiencia profesional junto con herramientas estrictamente controladas, estas operaciones de refactorización reemplazan el código a medida redundante por bibliotecas estándar de código abierto, garantizando que las aplicaciones finales permanezcan estables y escalables.
Mecánica interna: por qué el código generado por IA acumula deuda técnica
A nivel técnico, el fenómeno del "código basura de IA" (AI slop) proviene de una limitación fundamental en la gestión del contexto de los transformadores modernos. Aunque un LLM puede analizar un directorio de texto extenso, su mecanismo de atención evalúa el código a través de la probabilidad de tokens en lugar de basarse en principios arquitectónicos estrictos.
Cuando un agente resuelve un error aislado dentro de un archivo, frecuentemente introduce lógica duplicada en lugar de llamar a clases de utilidad existentes. Con el paso de los meses, este comportamiento introduce una grave degradación del software. El diagrama a continuación ilustra cómo los parches automatizados causan divergencia estructural:
[Arquitectura humana estructurada]
  Entrada ──> Controlador API principal ──> Clase de utilidad compartida (Formateador estándar único) ──> Salida segura


[Remiendos de IA inflados]
  Entrada ──> Parche de prompt 1 (Nuevo formateador) ──> Parche de prompt 2 (Formateador duplicado) ──> Salida fragmentada
Esta duplicación ya no es un problema localizado; se ha convertido en un desafío a nivel de toda la industria. Según el informe de Brecha de Mantenibilidad de 2026 de GitClear, que analizó 623 millones de cambios, los bloques de código duplicados han alcanzado su nivel más alto registrado, aumentando un 81% desde 2023. Mientras tanto, la refactorización estructurada se ha desplomado, representando menos del 4% del total de cambios de código en 2026, frente al 21% en 2022. Este cambio físico hacia la programación de copiar y pegar explica por qué los desarrolladores tienen ahora cinco veces más probabilidades de introducir bloques redundantes que de refactorizar el código existente.
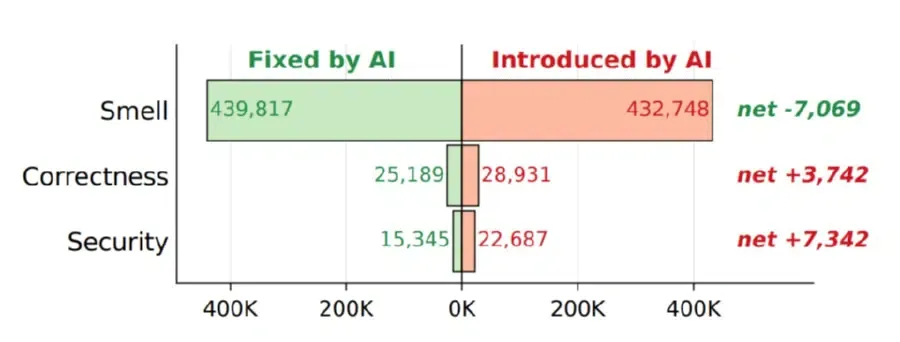
Estos hallazgos están respaldados por un estudio empírico a gran escala que rastrea la deuda de código. Los investigadores examinaron más de 300.000 commits generados por IA en 6.299 repositorios de GitHub, descubriendo que más del 15% de los envíos de Copilot, Claude, Cursor y Gemini introdujeron code smells detectables, errores de corrección o riesgos de seguridad.
Este riesgo de fallos en cascada a menudo obliga a los equipos de software a eliminar código generado por IA cuando las correcciones localizadas rompen los endpoints existentes. Además, el estudio reveló que el 22,7% de estos problemas introducidos por la IA permanecieron sin resolver en las últimas versiones de las bases de código, muchos de ellos persistiendo durante más de nueve meses, lo que subraya el coste a largo plazo de una producción de IA no gestionada.
Aunque la limpieza del código de repositorios y el seguimiento de instalaciones móviles operan en capas diferentes, ambos entornos comparten el mismo desafío técnico: una vez que los sistemas automatizados generan cadenas de solicitud redundantes o scripts no verificados, aumenta el riesgo de colisión de datos y corrupción de atribución. Desafíos similares existen en la atribución móvil, donde las restricciones de privacidad y el tráfico automatizado de bots también reducen la dependencia de identificadores persistentes del lado del cliente. Si los equipos de seguridad no pueden distinguir entre solicitudes legítimas de usuarios e interacciones automatizadas de agentes, todo el pipeline de análisis se vuelve vulnerable a reportar conversiones de falsos positivos.
Impacto en la industria: cómo la limpieza de código por IA redefine la ingeniería de software
La rápida proliferación de generadores de código automatizados ha provocado un cambio en el rol estándar de los ingenieros de software. Los desarrolladores están pasando de ser autores a auditores, centrándose en la arquitectura del sistema, el flujo de datos y la integridad de las interfaces.
- Equipos empresariales: Las grandes organizaciones están estableciendo puertas de enlace CI/CD dedicadas y protocolos de análisis estático con herramientas como ESLint, Prettier o SonarQube para rechazar commits que contengan estructuras de IA no verificadas, preservando la mantenibilidad a largo plazo.
- Startups: Aunque las empresas en etapa inicial aprovechan herramientas como Devin, CodeRabbit o Cursor para validar rápidamente sus MVP, requieren refactorización humana antes de realizar entregas a equipos de ingeniería de grado de producción.
- Comunidades de código abierto: Proyectos como el motor de juegos Godot han restringido las contribuciones generadas por IA debido a que los desarrolladores no podían entender ni verificar los scripts complejos que se enviaban.
- Proveedores de SDK y bibliotecas: Los proveedores de software deben garantizar que sus bibliotecas integradas sigan siendo completamente modulares y ligeras para evitar que las herramientas automatizadas malinterpreten las dependencias.
Reducción del exceso de código de IA sin tener que reescribirlo todo
A medida que las organizaciones se enfrentan a las realidades técnicas de la expansión de código impulsada por IA, los equipos de ingeniería deben evaluar cómo gestionan las dependencias de terceros y las selecciones de SDK. Reconciliar pipelines de enrutamiento de alto rendimiento requiere arquitecturas que puedan correlacionar de forma segura las acciones del usuario sin depender de contenedores de almacenamiento local. Los desarrolladores deben decidir si crear marcos de sincronización de bases de datos personalizados utilizando generadores automáticos de IA o implementar infraestructura estandarizada y preconstruida.
Evaluación arquitectónica: desarrollo personalizado vs. SDK estandarizado
Cuando se enfrentan a la expansión de la base de código, los desarrolladores deben decidir si crear extensas utilidades internas o aprovechar bibliotecas externas maduras para implementar funciones complementarias. Desarrollar soluciones a medida desde cero utilizando generadores automáticos de IA a menudo introduce miles de líneas de lógica no probada y clases redundantes. Por el contrario, integrar paquetes de software minimalistas y verificados ayuda a mantener una huella compilada pequeña.
La tabla a continuación resume las ventajas y desventajas entre arquitecturas de datos personalizadas y SDK externos certificados:
| Enfoque | Huella de código | Sobrecarga de mantenimiento | Escenario típico |
|---|---|---|---|
| Desarrollo interno a medida | Alta (miles de líneas de script personalizado) | Extremadamente alta (auditorías internas continuas) | Equipos empresariales con necesidades de telemetría interna muy especializadas |
| Módulos generados por IA | Impredecible (rutas enredadas) | Alta (propenso a colapsos de contexto) | Prototipado rápido donde la estabilidad a largo plazo es secundaria |
| Integración de SDK minimalista | Ultraligera (menos de 10 KB) | Despreciable (SDK auditados y autónomos) | Sistemas de alta concurrencia que requieren coincidencia de parámetros estándar |
En consecuencia, los gerentes de ingeniería priorizan cada vez más la eliminación de código redundante generado por IA antes de introducir nuevas funcionalidades. Los SDK ligeros que minimizan la complejidad de la integración se han vuelto, por lo tanto, cada vez más atractivos. Por ejemplo, los desarrolladores que integran telemetría de conversión multiplataforma pueden implementar el SDK ligero OpoInstall. En lugar de generar cientos de líneas de código de IA no probado para manejar parámetros multiplataforma, este SDK preconstruido y sin dependencias asigna metadatos de sesión a una base de datos de sesiones del lado del servidor. Esto mantiene el contexto de la campaña y la referencia de forma anónima sin aumentar el peso compilado del lado del cliente.
Listas de verificación de integración: preparando su arquitectura para una implementación ligera
Para evitar el deterioro futuro del código y mantener la coherencia de las conversiones en plataformas distribuidas, los equipos de ingeniería y producto deben establecer límites claros en la base de código.
Lista de verificación para desarrolladores
- Aplicar linters y puertas de control estrictas: Configure pipelines CI/CD automatizados con herramientas como ESLint, Prettier o SonarQube para rechazar PR que muestren altos puntajes de similitud o funciones de utilidad duplicadas.
- Auditar el tamaño de los SDK de terceros: Verifique la huella compilada de todas las bibliotecas integradas para evitar que los paquetes inflados ralenticen los tiempos de inicio del dispositivo.
- Implementar refactorización continua de código: Dedique un porcentaje fijo de los sprints de desarrollo a colapsar directorios redundantes en componentes modulares.
Lista de verificación para estrategia de producto y crecimiento
- Optimizar el uso de memoria: Evalúe las dependencias de la aplicación para minimizar las pausas de recolección de basura (garbage collection) y evitar el estrangulamiento térmico del lado del cliente.
- Agilizar la selección de SDK: Priorice herramientas de terceros altamente optimizadas y de propósito único que brinden resultados confiables sin dependencias extrañas.
- Monitorear la latencia del flujo de trabajo de la API: Realice un seguimiento de las métricas de latencia estándar, desde los clics iniciales en la campaña hasta la coincidencia de instalación del lado del servidor, para confirmar la continuidad de los datos.
Al establecer estas directrices estructuradas, los equipos de desarrollo pueden transicionar sus aplicaciones hacia arquitecturas más seguras y conformes, manteniendo la continuidad operativa.
Preguntas frecuentes (FAQ)
¿Es el código generado por IA malo para la mantenibilidad del software?
¿Deberían los desarrolladores confiar en las herramientas de codificación por IA para arquitecturas complejas?
¿Eliminar código redundante de IA mejora el rendimiento del sistema?
Conclusiones clave para los equipos de ingeniería
A medida que el desarrollo asistido por IA se convierte en la norma, los equipos de software están cambiando su enfoque de generar más código a mantener bases de código más saludables. El surgimiento de empresas especializadas en la limpieza de código mediante IA refleja un cambio más amplio en cómo las organizaciones evalúan la calidad del software en la era de la IA generativa. Confiar en agentes automatizados para parchear repetidamente problemas estructurales seguirá acumulando deuda técnica. Reconstruir las directrices de ingeniería interna en torno a la modularidad estricta, las pruebas automatizadas y las dependencias de terceros altamente optimizadas es esencial para mantener la escalabilidad de las aplicaciones.
De cara al futuro, las organizaciones exitosas priorizarán la mantenibilidad de la base de código sobre la velocidad bruta de generación. Al integrar infraestructura ligera sin dependencias y trasladar los estados de seguimiento complejos a bases de datos del lado del servidor, los desarrolladores pueden proteger sus pipelines de despliegue de la acumulación de código redundante. Esta transición no trata simplemente de adaptarse a herramientas automatizadas; se trata de construir estructuras de software estables y sostenibles en un entorno de ingeniería saturado de agentes.
Share this article



