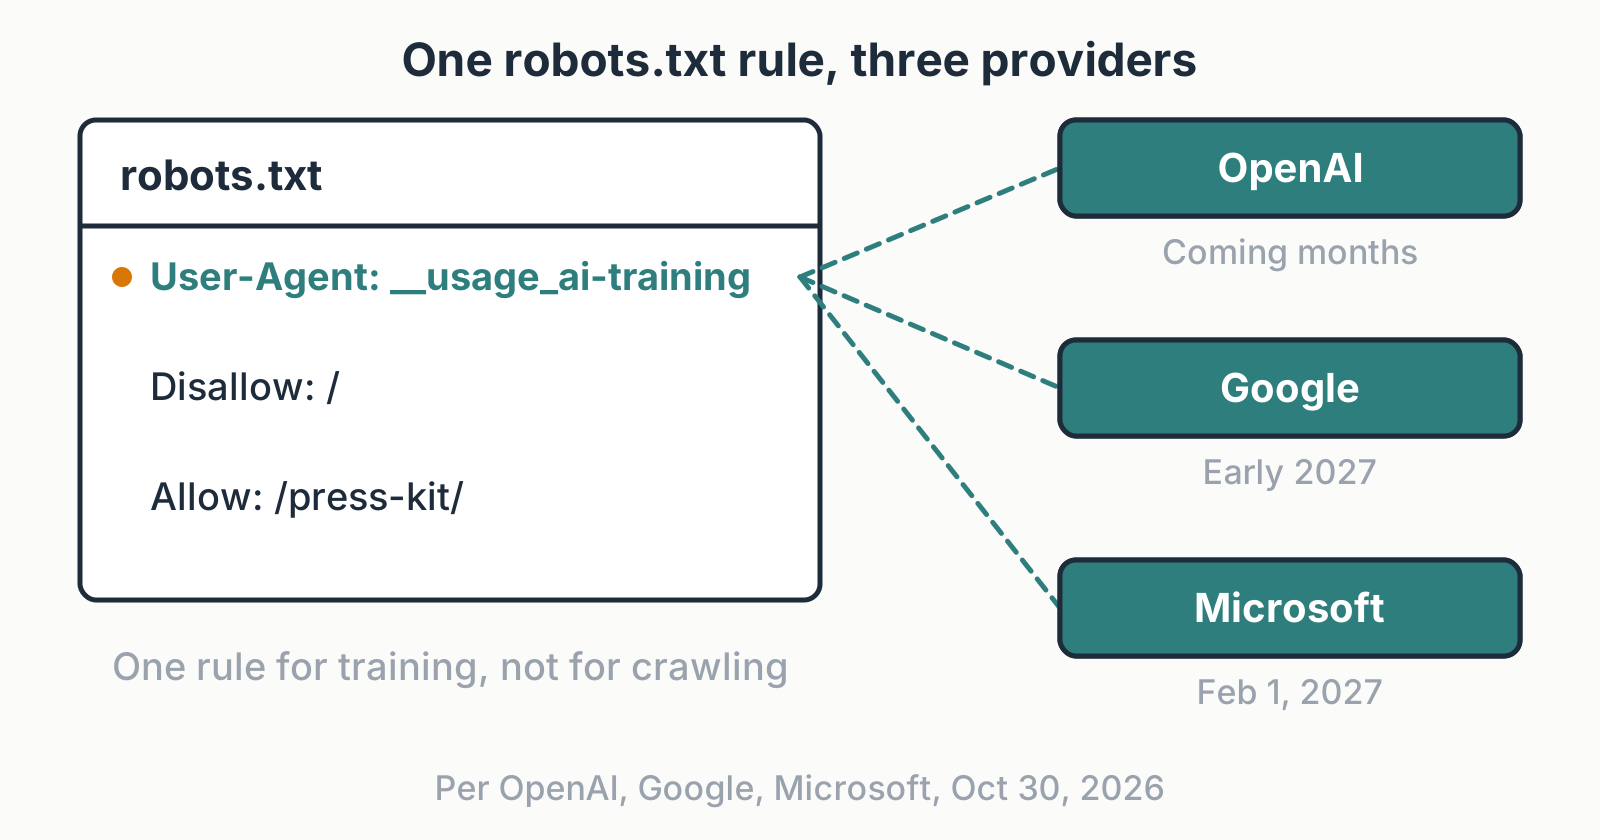
OpenAI और Google साझा AI प्रशिक्षण ऑप्ट-आउट का समर्थन करते हैं? OpenAI, Google, और Microsoft ने 30 अक्टूबर, 2026 को robots.txt में एक एकल, साझा पॉलिसी टोकन का सम्मान करने की योजनाओं की घोषणा की, जो वेबसाइट संचालकों को एक साथ कई प्रदाताओं में जनरेटिव AI मॉडल प्रशिक्षण प्राथमिकताओं को व्यक्त करने की अनुमति देता है। प्रस्तावित तंत्र एंथ्रोपिक इंजीनियर केविन केली द्वारा IETF AI प्रेफरेंसेस वर्किंग ग्रुप को प्रस्तुत एक व्यक्तिगत इंटरनेट-ड्राफ्ट से उत्पन्न हुआ है। जबकि यह पहल प्रकाशकों को मानक Allow और Disallow सिंटैक्स का उपयोग करके प्रशिक्षण ऑप्ट-आउट घोषित करने के लिए एक सुव्यवस्थित विधि प्रदान करती है, कार्यान्वयन समयसीमा 2027 तक फैली हुई है, और प्रत्येक प्रमुख प्लेटफॉर्म मॉडल प्रशिक्षण और लाइव संवादात्मक ग्राउंडिंग में सिग्नल की अलग-अलग व्याख्या और अनुप्रयोग करने की योजना बना रहा है।
कोर इंडस्ट्री रीअलाइनमेंट: प्रमुख AI लैब Robots.txt मानकों पर समन्वय करती हैं
एक नज़र में
- OpenAI, Google, और Microsoft ने जनरेटिव मॉडल प्रशिक्षण प्राथमिकताओं को प्रबंधित करने के लिए एक साझा robots.txt पॉलिसी टोकन,
__usage_ai-trainingको पहचानने के लिए 30 अक्टूबर, 2026 को समन्वित योजनाओं की घोषणा की। - इस सिग्नल को एंथ्रोपिक इंजीनियर केविन केली द्वारा लिखित एक व्यक्तिगत IETF इंटरनेट-ड्राफ्ट में परिभाषित किया गया है, जो आधिकारिक या अंतिम रूप दिए गए IETF RFC मानक का प्रतिनिधित्व किए बिना एक मानकीकृत सिंटैक्स स्थापित करता है।
- प्लेटफॉर्म अपनाने का शेड्यूल काफी अलग है: एंथ्रोपिक ने आंतरिक इंजीनियरिंग कार्य शुरू कर दिया है, OpenAI आने वाले महीनों में रोलआउट का लक्ष्य रखता है, Microsoft 1 फरवरी, 2027 को शुरू होता है, और Google 2027 में समर्थन का अनुमान लगाता है।
लगभग तीस वर्षों तक, रोबोट्स एक्सक्लूजन प्रोटोकॉल ने नियंत्रित किया कि स्वचालित वेब क्रॉलर सार्वजनिक ऑनलाइन सामग्री के साथ कैसे बातचीत करते हैं। वेबसाइट प्रशासक अपने रूट निर्देशिका में एक साधारण robots.txt सादा-पाठ फ़ाइल रखते थे, जो यह परिभाषित करती थी कि किस सर्च इंजन यूजर-एजेंट के पास विशिष्ट URL पथ लाने की अनुमति थी। यह प्रोटोकॉल एक मूलभूत व्यावसायिक सौदे पर संचालित होता था: वेबसाइट प्रकाशक खोज इंजन परिणाम पृष्ठों पर खोज योग्यता, आउटबाउंड रेफ़रल ट्रैफ़िक और ब्रांड एक्सपोजर के बदले में क्रॉलर्स को अपनी सामग्री को अनुक्रमित करने की अनुमति देते थे।
जनरेटिव आर्टिफिशियल इंटेलिजेंस के तीव्र उदय ने उस आर्थिक मॉडल को बाधित कर दिया। फ्रंटियर AI लैब्स द्वारा तैनात स्वचालित स्क्रैपर ने फाउंडेशन मॉडल को प्रशिक्षित करने के लिए वेब डोमेन का सेवन करना शुरू कर दिया, जो अक्सर प्रकाशकों को रेफ़रल क्लिक दिए बिना उत्तर इंटरफेस के भीतर सीधे मूल सामग्री का सारांश प्रस्तुत करते थे। अपनी बौद्धिक संपदा को निगले जाने से रोकने के इच्छुक सामग्री स्वामियों को GPTBot, ClaudeBot, और Google-Extended सहित मालिकाना यूजर-एजेंटों की खंडित, जटिल सूचियों को बनाए रखने के लिए मजबूर होना पड़ा। इस प्रशासनिक ओवरहेड ने एक साथ कई क्रॉलर निर्देशों का प्रबंधन करते समय कॉन्फ़िगरेशन त्रुटियों या आकस्मिक खोज डी-इंडेक्सिंग के परिचालन जोखिम को बढ़ा दिया।

एक साझा AI प्रशिक्षण ऑप्ट-आउट का उद्भव खंडित विक्रेता अवरोधन से सहकारी प्रोटोकॉल शासन की ओर एक महत्वपूर्ण बदलाव को चिह्नित करता है। एक साझा पॉलिसी टोकन के आसपास समर्थन का समन्वय करके, प्रमुख AI प्रदाताओं का उद्देश्य उन सामग्री निर्माताओं के लिए तकनीकी बाधा को कम करना है जो जनरेटिव मॉडल प्रशिक्षण के संबंध में स्पष्ट सीमाएं स्थापित करना चाहते हैं। आधिकारिक Google Search Central घोषणा के अनुसार, यह एकल नियम वेबसाइट प्रशासकों को बाजार में प्रवेश करने वाले प्रत्येक व्यक्तिगत वाणिज्यिक AI क्रॉलर के लिए अलग-अलग निर्देशों को ट्रैक और कॉन्फ़िगर करने के बजाय एक ही चरण में अपनी जनरेटिव AI प्रशिक्षण स्थिति घोषित करने की अनुमति देता है।
अंडर-द-हुड आर्किटेक्चरल मैकेनिक्स: __usage_ai-training टोकन कैसे काम करता है
साझा प्राथमिकता सिग्नल के पीछे का तकनीकी आर्किटेक्चर मशीन-पठनीय प्रशिक्षण प्राथमिकता संकेतों पर IETF इंटरनेट-ड्राफ्ट में निर्दिष्ट है। मुख्य रूप से, ड्राफ्ट नए निर्देश पेश नहीं करता है या RFC 9309 में परिभाषित रोबोट्स एक्सक्लूजन प्रोटोकॉल के अंतर्निहित व्याकरण को बदलता नहीं है। इसके बजाय, यह एक आरक्षित पॉलिसी टोकन: __usage_ai-training निर्दिष्ट करके मानक User-Agent रिकॉर्ड का पुन: उपयोग करता है.
ऑप्ट-आउट कॉन्फ़िगर करने के लिए, एक वेबमास्टर इस पॉलिसी टोकन को यूजर-एजेंट के रूप में नामित करते हुए एक साधारण नियम ब्लॉक बनाता है, जिसके बाद मानक Disallow और Allow नियम आते हैं। नीचे दिया गया उदाहरण दर्शाता है कि कैसे एक वेबसाइट मालिक सार्वजनिक प्रचार सामग्री के लिए अपवाद रखते हुए सभी साइट निर्देशिकाओं में ऑप्ट-आउट व्यक्त करता है:
User-Agent: __usage_ai-training
Disallow: /
Allow: /press-kit/
"AI प्रशिक्षण" क्या है, इसकी सिमेंटिक परिभाषा IETF वर्किंग ग्रुप की बुनियादी शब्दावली विनिर्देशों में निहित है। इस ढांचे के तहत, प्रशिक्षण को कड़ाई से एक जनरेटिव आर्टिफिशियल इंटेलिजेंस मॉडल के सीखे गए वजन और मापदंडों को संशोधित करने या ठीक करने के लिए स्क्रैप की गई वेब सामग्री का उपयोग करने के रूप में परिभाषित किया गया है। गैर-जनरेटिव कम्प्यूटेशनल संचालन, जैसे कि मानक दस्तावेज़ वर्गीकरण, खोज सूचकांक रैंकिंग, वर्तनी सुधार, और स्पैम फ़िल्टरिंग, को इस परिभाषा से स्पष्ट रूप से बाहर रखा गया है।
प्रोटोकॉल सीमाएं: क्रॉलिंग बनाम प्रशिक्षण बनाम ग्राउंडिंग
इस प्रस्तावित टोकन की परिचालन सीमाओं को समझने के लिए स्वचालित डेटा अंतर्ग्रहण के विभिन्न चरणों को अलग करने की आवश्यकता है:
[सार्वजनिक वेब सामग्री]
       │
       ▼
[1. HTTP क्रॉल / फ़ेच] ──> विशिष्ट क्रॉलर यूजर-एजेंटों द्वारा शासित (जैसे, GPTBot, Bingbot)
       │                    *__usage_ai-training HTTP फ़ेच व्यवहार को नियंत्रित नहीं करता है*
       ├────────────────────────────────────────┐
       ▼                                        ▼
[2. मॉडल प्रशिक्षण उपयोग]                  [3. लाइव ग्राउंडिंग / RAG]
   *__usage_ai-training: Disallow*          *पेज टैग और विक्रेता सेटिंग्स द्वारा शासित*
   प्रशिक्षण के विरुद्ध प्राथमिकता का संकेत देता है    AI मॉडल को वास्तविक समय वेब संदर्भ प्रदान करता है
       │                                        │
       ▼                                        ▼
   प्रवर्तन इस पर निर्भर करता है               पात्रता मानदंड द्वारा निर्धारित
   भाग लेने वाले AI प्रदाता                   व्यक्तिगत प्लेटफ़ॉर्म नीतियां
तकनीकी टीमों को इस ड्राफ्ट विनिर्देश में निहित चार संरचनात्मक सीमाओं का मूल्यांकन करना चाहिए:
- सिग्नल प्रशिक्षण को नियंत्रित करता है, क्रॉलिंग को नहीं: पॉलिसी टोकन नेटवर्क क्रॉलिंग व्यवहार के लिए कोई निर्देश नहीं है।
__usage_ai-trainingके तहतDisallow: /का सामना करने वाले AI क्रॉलर को अभी भी HTTP पर HTML दस्तावेज़ लाने की अनुमति है। इसे केवल मॉडल प्रशिक्षण पाइपलाइनों में उस पुनर्प्राप्त पाठ को न खिलाने का निर्देश दिया जाता है। बॉट को पूरी तरह से URL का अनुरोध करने से रोकने के लिए, प्रशासकों को क्रॉलर के विशिष्ट पहचान नाम को ब्लॉक करना जारी रखना चाहिए। - वाइल्डकार्ड नियम लागू नहीं होते हैं: सामान्य वाइल्डकार्ड ब्लॉक, जैसे कि
User-Agent: *जिसके बादDisallow: /आता है, पॉलिसी टोकन से मेल नहीं खाते हैं। ड्राफ्ट अनिवार्य करता है कि भाग लेने वाली AI कंपनियों को एक सार्वभौमिक वाइल्डकार्ड समूह को AI प्रशिक्षण प्राथमिकता की अभिव्यक्ति के रूप में व्याख्या नहीं करनी चाहिए। यदि कोई फ़ाइल स्पष्ट__usage_ai-trainingटोकन को छोड़ देती है, तो मानक साइट को कोई प्रशिक्षण प्राथमिकता व्यक्त न करने के रूप में व्याख्या करता है। - कोई पूर्वव्यापी मॉडल अनलर्निंग नहीं: किसी वेबसाइट की
robots.txtफ़ाइल को अपडेट करना समय के साथ आगे की ओर संचालित होता है। यह भविष्य के क्रॉल और प्रशिक्षण चक्रों के लिए एक संकेत प्रदान करता है लेकिन किसी AI लैब को ऐतिहासिक प्रशिक्षण डेटासेट में पहले से एकीकृत डेटा को शुद्ध करने या पूर्व-मौजूद फाउंडेशन मॉडल से वजन हटाने के लिए बाध्य नहीं करता है। - तकनीकी प्रवर्तन पर स्वैच्छिक समन्वय: सिग्नल एक प्रकाशक प्राथमिकता व्यक्त करता है; यह गैर-भाग लेने वाले या गैर-अनुपालन करने वाले डेटा उपभोक्ताओं के खिलाफ तकनीकी प्रवर्तन प्रदान नहीं करता है। RFC 9309 सिद्धांतों के तहत, robots.txt एक्सेस-कंट्रोल फ़ायरवॉल के बजाय एक सहकारी सलाहकार तंत्र बना हुआ है।
प्रदाता कार्यान्वयन अंतर और माइग्रेशन शेड्यूल
जबकि Google, Microsoft, और OpenAI ने साझा सिग्नल का समर्थन करने की योजनाओं की घोषणा की है, उनके तकनीकी कार्यान्वयन और रोलआउट शेड्यूल काफी अलग हैं। प्रत्येक प्रदाता खोज इंजन अनुक्रमण, जनरेटिव मॉडल प्रशिक्षण, और संवादात्मक पुनर्प्राप्ति-संवर्धित जनरेशन (RAG) के बीच संतुलन के लिए अपने स्वयं के उत्पाद बुनियादी ढाँचे के माध्यम से दृष्टिकोण रखता है।
नीचे दी गई तालिका पुष्टि किए गए प्लेटफ़ॉर्म प्रतिबद्धताओं, व्याख्या नियमों और माइग्रेशन समयसीमा की तुलना करती है:
| प्लेटफॉर्म | पुष्टि की गई स्थिति और समयसीमा | पॉलिसी टोकन व्याख्या | ग्राउंडिंग और पुनर्प्राप्ति हैंडलिंग | लेगेसी टैग माइग्रेशन और अपवाद |
|---|---|---|---|---|
| समर्थन की घोषणा की; 2027 के लिए योजनाबद्ध (सटीक तिथि TBD) | जब कोई स्पष्ट Google-Extended नियम मौजूद नहीं होता है तो इसे Google-Extended: Disallow के रूप में व्याख्या किया जाता है |
डिफ़ॉल्ट मैपिंग Gemini ऐप्स ग्राउंडिंग को प्रभावित करती है; स्पष्ट नियम ओवरराइड करते हैं | मौजूदा Google-Extended निर्देश पूरी तरह से वैध रहते हैं; खोज अनुक्रमण प्रभावित नहीं होता है |
|
| Microsoft | पुष्टि की गई प्रतिबद्धता; 1 फरवरी, 2027 से सम्मान करना शुरू करता है | वेब क्रॉलिंग के दौरान एक प्रशिक्षण ऑप्ट-आउट के रूप में मान्यता प्राप्त | प्रशिक्षण से अलग किया गया; पेज-स्तर के टैग के माध्यम से अलग से प्रबंधित | 1 मार्च, 2027 को AI के लिए NoArchive/NoCache को रिटायर करता है; अस्थायी Bing वेबमास्टर टूल्स सेटिंग 15 दिसंबर को खुलती है |
| OpenAI | आगामी महीनों में कार्यान्वयन के लिए प्रतिबद्ध | डेटा अंतर्ग्रहण पाइपलाइनों में प्रत्यक्ष समर्थन | GPTBot निर्देशों के साथ मूल्यांकन किया गया |
मौजूदा GPTBot कॉन्फ़िगरेशन सक्रिय और लागू करने योग्य रहते हैं |
| Anthropic | कर्मचारी द्वारा लिखित ड्राफ्ट; वर्किंग ग्रुप सूची पर विकास की सूचना दी गई | सेवाओं में इच्छित समर्थन; औपचारिक न्यूज़रूम समयसीमा TBD | ClaudeBot निर्देशों के साथ मूल्यांकन किया गया |
मौजूदा ClaudeBot क्रॉलर नियंत्रण संचालित होते रहते हैं |
Google एक साझा AI प्रशिक्षण ऑप्ट-आउट को Google-Extended अस्वीकार के रूप में व्याख्या करने की योजना बना रहा है जब कोई स्पष्ट Google-Extended नियम मौजूद नहीं होता है। चूँकि Google-Extended Gemini ऐप्स में ग्राउंडिंग के लिए पात्रता को भी नियंत्रित करता है, यह डिफ़ॉल्ट मैपिंग प्रभावित कर सकती है कि क्या किसी प्रकाशक की सामग्री उन अनुभवों के लिए उपलब्ध है। एक स्पष्ट Google-Extended नियम Google के कार्यान्वयन में साझा सिग्नल पर प्राथमिकता लेता है, लेकिन प्रकाशकों को यह नहीं मानना चाहिए कि Google के वर्तमान नियंत्रण मॉडल प्रशिक्षण और Gemini ऐप्स ग्राउंडिंग के लिए स्वतंत्र ऑप्ट-आउट प्रदान करते हैं। Google-Extended के तहत अनुमति दी गई सामग्री बिना किसी समावेशन या उद्धरण की गारंटी के Gemini ग्राउंडिंग के लिए पात्र हो सकती है।
इसके विपरीत, Microsoft Bing मॉडल प्रशिक्षण और वास्तविक समय ग्राउंडिंग को अलग-अलग वास्तुकला अवधारणाओं के रूप में मानता है, जैसा कि आधिकारिक Bing वेबमास्टर अपडेट में विस्तृत है। Microsoft प्रकाशकों को Microsoft Copilot उत्तरों में लाइव ग्राउंडिंग की अनुमति देना जारी रखते हुए जनरेटिव मॉडल प्रशिक्षण से बाहर निकलने की अनुमति देता है। इन प्राथमिकताओं का प्रबंधन करने वाली साइटें robots.txt में या पेज-स्तरीय HTML मेटा टैग और HTTP हेडर के माध्यम से प्रशिक्षण प्रतिबंध घोषित कर सकती हैं, जो व्यक्तिगत URL के लिए robots.txt को ओवरराइड करते हैं। ग्राउंडिंग को पेज-स्तरीय प्राथमिकताओं के माध्यम से नियंत्रित किया जाता है, जिसमें एक DisallowExtended विकल्प शामिल है जो Microsoft के अपने टूल (जैसे Copilot) में ग्राउंडिंग की अनुमति देता है जबकि Microsoft ग्राउंडिंग API द्वारा संचालित तृतीय-पक्ष सेवाओं को बाहर करता है। इसके अलावा, Microsoft AI नियंत्रणों के लिए NoArchive और NoCache टैग पर अपनी ऐतिहासिक निर्भरता को चरणबद्ध तरीके से समाप्त कर रहा है; उन टैग पर निर्भर साइटों को 1 मार्च, 2027 से पहले नए विकल्पों में माइग्रेट करना होगा। अस्थायी Bing वेबमास्टर टूल्स ग्राउंडिंग सेटिंग केवल 15 दिसंबर, 2026 तक NoArchive या NoCache का उपयोग करने वाली साइटों के लिए उपलब्ध है। यह तब तक प्रभावी रहता है जब तक Microsoft पेज को फिर से क्रॉल नहीं करता है और नई प्राथमिकता की खोज करता है, या 30 सितंबर, 2027 तक, जो भी पहले हो।
इंजीनियरिंग चेकलिस्ट: एजेंटिक वेब के लिए वेब प्राथमिकताओं का ऑडिट करना
साझा AI प्रशिक्षण प्राथमिकता सिग्नल को तैनात करने के लिए सिस्टम आर्किटेक्चर, सामग्री संचालन और कानूनी शासन टीमों के बीच समन्वय की आवश्यकता होती है। इंजीनियरिंग नेताओं को यह सुनिश्चित करना चाहिए कि सर्वर कॉन्फ़िगरेशन खोज इंजन खोज को अनजाने में बाधित किए बिना संगठनात्मक नीतियों को सटीक रूप से दर्शाते हैं।
वेबमास्टर और सिस्टम कार्यान्वयन चेकलिस्ट
- वर्तमान रोबोट मेनिफेस्ट का ऑडिट करें: विक्रेता-विशिष्ट निर्देशों को कैटलॉग करने के लिए मौजूदा
robots.txtफ़ाइलों की समीक्षा करें, यह सत्यापित करते हुए किGPTBot,ClaudeBot, याGoogle-Extendedके नियम संगठनात्मक प्रशिक्षण नीतियों के साथ संघर्ष करते हैं या नहीं। - आरक्षित पॉलिसी टोकन तैनात करें: एक एकीकृत प्रारूप में भाग लेने वाले AI प्रदाताओं में वैश्विक प्रशिक्षण सीमाओं को व्यक्त करने के लिए
User-Agent: __usage_ai-trainingब्लॉक को लागू करें। - ग्रैनुलर अपवाद पथ बनाए रखें: यदि सार्वजनिक संपत्ति—जैसे प्रेस विज्ञप्ति, मीडिया किट, या खुले डेवलपर दस्तावेज़—मॉडल उपभोग के लिए अभिप्रेत हैं, तो अस्वीकार निर्देश के नीचे स्पष्ट
Allow:अपवाद घोषित करें। - फ़ेच ब्लॉकिंग को प्रशिक्षण शासन से अलग करें: यदि प्राथमिक उद्देश्य मूल सर्वर लोड को कम करना या अनधिकृत स्क्रैपिंग को रोकना है, तो IP-आधारित दर सीमित करना, CDN बॉट चुनौतियां, और स्पष्ट क्रॉलर यूजर-एजेंट ब्लॉक कॉन्फ़िगर करें।
शासन और अनुपालन चेकलिस्ट
- Microsoft ग्राउंडिंग माइग्रेशन शेड्यूल की समीक्षा करें: Bing Copilot आउटपुट को नियंत्रित करने के लिए
NoArchiveयाNoCacheका उपयोग करने वाली साइटों के लिए, Microsoft की 1 मार्च, 2027 की प्रवर्तन समय सीमा से पहले नए पेज-स्तर के टैग में संक्रमण करने की तैयारी करें। - खोज खोज ट्रेड-ऑफ़ का आकलन करें: संवादात्मक उत्तर इंजन में दृश्यता का मूल्यांकन करने वाले प्लेटफार्मों के लिए, पहचानें कि विक्रेता-विशिष्ट डिफ़ॉल्ट मैपिंग (जैसे Google का
Google-Extendedपर वापस लौटना) वास्तविक समय पुनर्प्राप्ति पात्रता को कैसे प्रभावित करती है। - IETF वर्किंग ग्रुप अपडेट को ट्रैक करें: मई 2027 में इसकी निर्धारित समाप्ति से पहले संभावित सिंटैक्स अपडेट के लिए IETF AIPREF वर्किंग group के भीतर
draft-kelley-aipref-training-preference-signalकी प्रगति की निगरानी करें।
Share this article