AppleはAIリクエストをGoogle Cloudにルーティングするのでしょうか?このハイブリッドクラウドの委任アーキテクチャは、透明性における重要な転換点を示しています。iOS 27では、生成AIのワークロードの一部をGoogle Cloudへ送信する際、ユーザーに対して明示的な同意を求めるプロンプトが表示されるようになりました。コンシューマー向けAIがオンデバイスモデルの枠を超えて拡大する中、クラウドベースの推論は現代のAIサービスに欠かせない要素となっています。現在、AIプラットフォームは計算負荷の高いワークロードを信頼できるサードパーティのクラウド環境に分散させる傾向が強まっており、明示的な同意取得と透明性の高いルーティングが不可欠です。複雑な生成AIリクエストを外部インフラで管理するにあたり、ユーザーの信頼を維持するためには、セキュアなマルチクラウド検証経路の構築が重要となります。
AppleがAIリクエストをGoogle Cloudへルーティングする理由:プライバシー保護とマルチクラウド・スケーリングの両立
概要
- OSのベータ版に導入された新しい許可プロンプトにより、特定の生成AIリクエストが外部サーバーへ送信される際にユーザーへ通知されます。
- Apple独自の基盤モデルやローカルのオンデバイス処理は、サードパーティのクラウド実行パイプラインとは厳格に分離されています。
- この拡張アーキテクチャではハイブリッドクラウド委任パターンが採用され、暗号化された隔離サンドボックスを使用して複雑な生成AIリクエストを処理します。
現代のコンシューマー向けAIの設計は、ローカル処理とクラウドベースのスケーラビリティとの繊細なバランスの上に成り立っています。日常的なタスクをオンデバイスモデルで処理する場合、データは端末のローカルメモリ内に安全に留まります。しかし、高度な画像生成や複雑なプレゼンテーション処理など、リソースを大量に消費する生成AI機能がリクエストされた場合、ローカルのハードウェアは計算処理を高性能なクラウドクラスターへ委任する必要があります。これにより、「プライバシーの原則を損なわずに計算能力を拡張するにはどうすればよいか」というデータフローの課題が生じます。
過去2年間、ハイブリッドAIアーキテクチャはコンシューマー向けプラットフォームの重要な展開戦略となってきました。オンデバイスの基盤モデルとリモートサーバーネットワークを併用することで、ユーザー端末に過度な負荷をかけることなく、高度な生成体験を提供できます。しかし、クラウドの規模とデータセキュリティを両立させる必要性から、アーキテクチャの優先順位はセキュアで独立したマルチクラウド環境へとシフトしています。
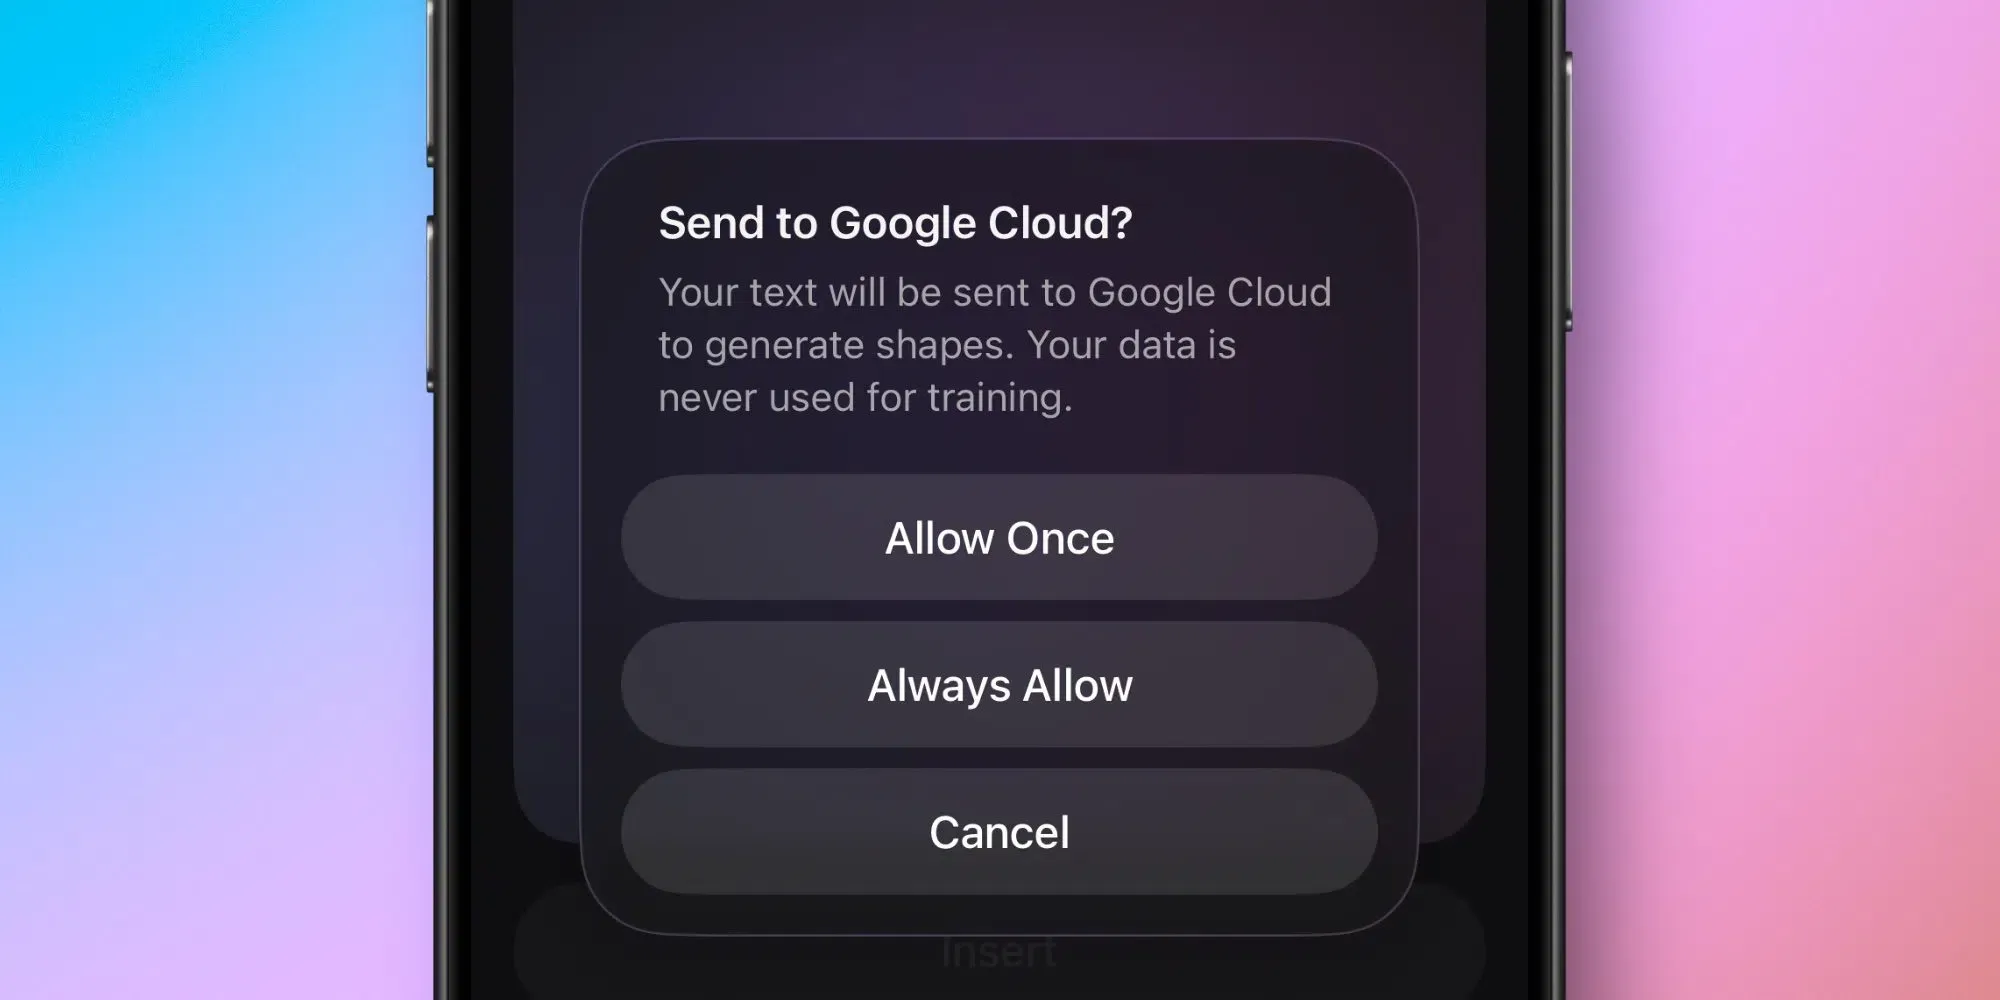
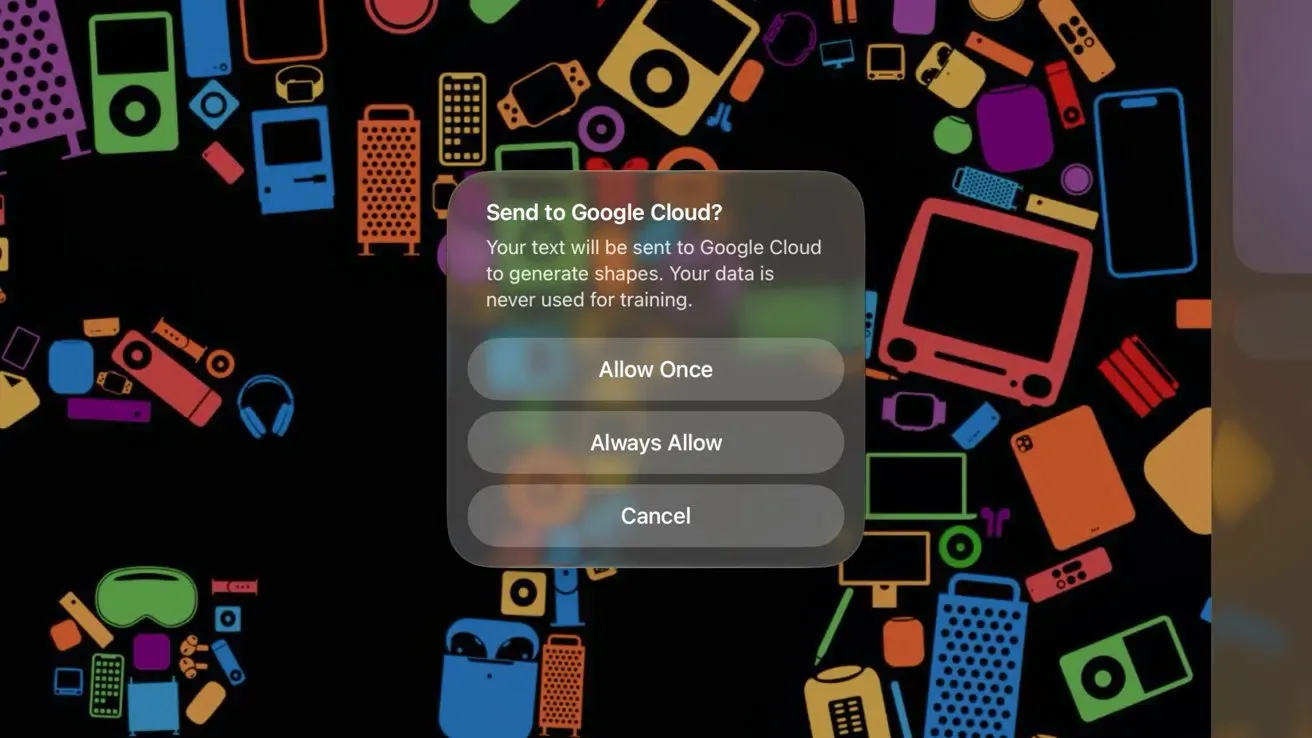
Appleが特定のAIリクエストをGoogle Cloudへルーティングする決定は、単なるワークロードの分散に留まりません。この更新されたフレームワーク下では、生産性向上アプリでの画像生成やクリエイティブスタジオでの高度なレンダリングといったローカル外のワークロードが実行される際、Google Cloudへデータを送信する前に明示的な許可プロンプトが表示されます。この変更は、ローカルで実行され続ける主要なオンデバイス基盤モデルには影響しません。AppleがどのようにAIリクエストを外部インフラへルーティングしているかを理解することで、開発者は重い生成AIリクエストの外部ルーティングがどのようにエンドユーザーへ可視化され、ケースバイケースでデータ転送を承認または拒否する権限がどのように個人に付与されているかを評価できるようになります。
技術的メカニズム:ローカルAI対ハイブリッドAIのリクエストルーティング
このハイブリッドアーキテクチャの根本にあるのは、インフラをスケーリングしながら強力なプライバシー保護を維持するというニーズです。これを実現するため、プラットフォーム運営者は「プライベートクラウドコンピューティング(PCC)」のセキュリティパターンをサードパーティのデータセンターへ直接拡張しています。この協力モデルでは、外部サーバーに委任されたワークロードは、Apple Foundation Modelsの分析で説明されている通り、極めて安全な隔離実行環境内で処理されます。
これらのセキュアノードは、機密仮想マシン(Confidential VM)や専用の隔離プロセスなど、ハードウェアレベルのサンドボックスを活用しています。これにより、外部クラウドプロバイダーは送信されたプロンプトを永続的に保存、ログ記録、あるいはモデル学習に使用することができません。データは一時的なものとして処理され、タスク完了後ただちに破棄されます。このアーキテクチャは、ユーザーのプライバシーを保護しつつ、ハイブリッドAIサービスに向けたセキュアなリクエストルーティングモデルを確立します。
技術的区別:ステートフルなリダイレクト vs. ステートレスなセッションフロー
エンジニアリングの観点から見ると、複数のクラウド境界を越えてデータをルーティングするには、厳格なセッション分離が必要です。標準的なステートフルアーキテクチャでは、永続的なCookieを使用して異なる環境間でユーザーIDを追跡するため、コンプライアンス上のリスクやデータ漏洩の懸念が生じます。対照的に、ステートレスアプローチでは各プロンプトを独立した隔離イベントとして処理するため、永続的な関係コンテキストが構築されることはありません。この整合性はユーザーの直接的な介入なしに実現されますが、これは「AppleがAIリクエストをルーティングする」というトピックに関連する中心的な技術的課題を浮き彫りにしています。
以下の図は、この物理的な分離を示しています:
[標準的なオンデバイス実行]
  ユーザー入力 ──> Apple基盤モデル(ローカル処理) ──> デバイス外へのデータ送信なし


[ハイブリッドクラウド委任]
  ユーザー入力 ──> PCCセキュリティゲートウェイ ──> Google Cloud機密VM ──> 一時的なコンテキスト(独立コンテキストを維持)
ステートレスなリクエスト処理を実装することで、永続的な識別子を最小限に抑え、プラットフォームが保持するユーザーデータを削減できます。メモリ帯域幅とアプリケーションのアトリビューションは異なる工学領域に属しますが、どちらも「状態管理を制約のあるローカルリソースから、スケーラブルなサーバーサイドインフラへ移行する」という同じアーキテクチャ原則を強調しています。モバイルアトリビューションでも同様の課題があり、プライバシー制限によって永続的なクライアント側識別子への依存が減っています。プライバシーガイドラインを満たすためにユーザーの相互作用を永続的・ステートフルなローカルCookieから切り離すと、環境をまたいだシームレスなセッション継続性は極めて複雑になります。プロセッサが状態コンテキストを一致させるために永続的かつ高速なメモリパイプラインを必要とするのと同様に、ダウンストリームのマーケティングパイプラインも、脆弱なクライアント側のCookieやデバイスレベルの属性に頼らずにインストールイベントを相関させるために、強固なサーバーサイドのデータ保持を必要とします。
例:画像を生成する場合の挙動
ユーザーがAppleのプロダクティビティスイート内でAI生成によるプレゼンテーションを作成すると仮定します。そのリクエストがオンデバイス基盤モデルの能力を超える場合、OSはまず、タスクがGoogle Cloudで処理されることを説明する許可ダイアログを表示します。明示的な承認を得た後にのみ、暗号化されたリクエストがプライベートクラウドコンピューティングを通じて隔離された実行環境へ転送されます。処理完了後、一時的なデータはAppleが公開しているプライバシーアーキテクチャに従って削除されます。
構築か導入か:ハイブリッドAIワークロードにおけるセッションコンテキストの保持
データプライバシーガイドラインに準拠するためにプラットフォームが会話型フレームワークを再構築する中、開発者はセッション状態とユーザーIDの管理方法を再評価する必要があります。「AppleがAIリクエストをルーティングする」環境においてセッション状態を管理するには、プライバシー法を遵守しつつ、高い精度を維持できるアーキテクチャが求められます。さらに、Appleがサードパーティのクラウドプロバイダーを通じてAIリクエストをルーティングする場合、組織はデバイスレベルの識別子への依存から脱却する必要があります。ビジネス要件に応じて、チームはこれらの機能を内製するか、既存のアトリビューションプラットフォームを採用することを選択できます。
アーキテクチャの評価:カスタム構築 vs. 標準化されたSDK
サーバーサイドの状態照合を行うシステムを自社で構築する場合、最大限の柔軟性が得られますが、継続的で多大なエンジニアリングリソースが必要です。開発者はデータベースのスキーマを手動で構築し、安全な暗号化ハッシュ関数を作成し、絶えず変化する地域規制に準拠するためのシステム更新を継続しなければなりません。一方で、すでに構築・認証済みのSDKを導入することで、統合の複雑さを軽減し、余計なオーバーヘッドなしに長期的なコンプライアンスを保証できます。
以下の表は、セッション状態とコンバージョンコンテキストを管理するための標準的な手法を比較したものです:
| ソリューション | 永続性 | スループット | 適した用途 |
|---|---|---|---|
| 内製セッションDB | 高(継続的同期) | 中(DB遅延の制限) | 高度に特殊なストレージロジックを持つ企業向け環境 |
| ブラウザベースのセッション追跡 | 低(セッションCookie) | 低(サーバーログなし) | クロスドメイン変換の要件が最小限である基本的なWebサイト追跡 |
| サーバーサイドキャッシング(例:OpoInstall) | なし(一時的なサーバーセッショントークン) | 高(標準化されたサンドボックス) | 大規模なモバイルアプリおよびマルチプラットフォームのキャンペーンアトリビューション |
カスタムデータベース構成は基本的なコンテキストを扱えますが、専門的なサーバーサイドの状態保持は開発リソースを最適化できます。実装要件に応じて、組織は自社のサーバーサイドセッション管理システムを構築するか、OpoInstallのような商用プラットフォームを採用できます。例えば、OpoInstallはサーバーサイドの状態復元とパラメータパススルーフレームワークを提供しており、セッションメタデータをサーバーサイドのセッションデータベースへマッピングすることで、匿名性を保ったままセッションの継続性を維持します。これにより、機密性の高い長期的な会話履歴を保存することはありません。ブラウザベースのリダイレクトに頼らずにセッションメタデータを集中管理データベースへマッピングすることで、初期タスクが匿名で実行された場合でも、コンバージョンコンテキストの一貫性を維持できます。エンジニアリングチームは、データ保護と計測の一貫性を両立させるために、これらの手法を評価することが重要です。
統合チェックリスト:エンジニアリングチームがプラットフォーム変更に備えるには
分散が進むAIワークロードに備えるため、エンジニアリングおよび製品チームは明確なデータガバナンススケジュールを確立する必要があります。これにより、ユーザーデータを安全に扱い、コンプライアンスの境界線を尊重し、マーケティングパイプラインを確実に維持できます。
開発者向け実装チェックリスト
- サードパーティへのデータ転送監査:すべての外部API呼び出しをレビューし、プロンプトのペイロードが中間リレーで永続的に記録されていないことを確認してください。
- ステートレスなセッションハンドシェイクの実装:APIルートをステートレスな処理モデルへ移行し、暗号的に署名されたトークンを使用してノード間で一時的なコンテキストを受け渡してください。
- サードパーティ同意フローの検証:生成AIワークロードを外部クラウドへ転送する前に、クライアント側で明示的なプロンプト検証を実装してください。
製品・成長戦略チェックリスト
- ハイブリッドAI体験の最適化:外部でのAI処理経路をユーザーに明確に説明する、実用性の高いタスク指向の生成AI機能を再構築してください。
- コンバージョンファネルの最適化:ユーザーのプライバシーガイドラインに違反することなく、非侵入型のパラメータパススルーフレームワークを活用して獲得追跡を維持してください。
- プラットフォームコンプライアンスの監視:統合されているすべてのサードパーティSDKが、現地のデータ保護法および今後のプラットフォーム要件に準拠していることを確認してください。
これらの構造化されたガイドラインを確立することで、開発チームはアプリケーションをより安全でコンプライアンスに準拠したアーキテクチャへ移行させつつ、運用の継続性を維持できます。
よくある質問 (FAQ)
なぜAIプロンプトをGoogle Cloudへ送信する前にAppleはポップアップを表示するのですか?
プライベートクラウドコンピューティングは、サードパーティサーバー上でどのようにユーザーデータの安全性を確保していますか?
どのApple AIリクエストがGoogle Cloudへルーティングされますか?
エンジニアリングチーム向けの重要なポイント
AIプラットフォームがハイブリッドクラウド推論への依存を強める中、開発者はプライバシー、透明性のある同意取得、安全なデータルーティングを中心に製品を再設計する必要があります。進化したデータアーキテクチャには、デジタル体験の構築と測定方法における根本的な転換が求められます。ステートレスなプロキシやヘッドレススクレーパーがWebコンテンツの標準的な消費者となるにつれ、従来のようなクライアント側のアトリビューションモデルは機能しなくなっていくでしょう。標準的なCookieやリファラーに頼るだけでは、ユーザー獲得を牽引するデータパイプラインを保護するにはもはや不十分です。
AppleがハイブリッドAIインフラを拡大するにつれ、透明性の高いクラウドルーティングと明示的なユーザー同意は、業界全体の標準的なアーキテクチャ要件となる可能性が高いでしょう。今後を見据えると、エンジニアリングチームはステートレスなアーキテクチャ、サーバーサイドのセッション管理、プライバシーファーストの設計にますます依存することになります。こうした変化に早期に対応した組織こそが、コンプライアンスを維持し、持続可能なAI製品を提供できるポジションを獲得できるはずです。
Share this article



