CloudflareがAI学習ボットをブロック?Cloudflareは、パブリッシャーのサイトを対象にAI学習用クローラーをデフォルトで遮断し、コンテンツ所有者に新たな収益化の選択肢を提供する新ポリシーを発表しました。生成AIがウェブコンテンツの消費方法を変える中、AIプラットフォームは相互に価値を還元する仕組みを構築することなく、ウェブ上の膨大なリソースを消費し続けています。これまでは、検索エンジンによるインデックスを許可することで、広告やサブスクリプションを通じた収益につながる参照トラフィックを得ることができました。しかし現在では、汎用クローラーがモデル学習のために独自のデータを組織的にスクレイピングし、クリックの必要性を排除する要約を生成するため、パブリッシャーは深刻な収益低下に見舞われています。
運用上の課題と経済的ボトルネック:Cloudflareによる広告ページでのボット遮断
要点
- 2026年第3四半期より、収益化されているコンテンツディレクトリにおいて、モデル学習用スクレイピングやプログラム系エージェントを自動的に遮断する制限が開始されます。
- 検索インデックスとデータ収集を兼ねるクローラーについては、目的ごとにパイプラインを分離しない限り、制限の対象となります。
- リクエスト数に応じた従来の報酬体系に代わり、コンテンツ管理者に直接的な取引報酬を提供する新たな収益化フレームワークが登場しています。
ウェブパブリッシャーと自動ウェブスクレイパーの間にあった伝統的な均衡は完全に崩れ去りました。約30年間にわたり、インターネットのグローバルな基盤を支えてきた暗黙の了解がありました。それは、ウェブ管理者がクローラーによるページのスキャンを許可し、検索クエリから質の高いユーザーアクセスを得るという相互補完の関係です。この互恵的な交換が、独立したソフトウェアマニュアルやジャーナリズムを支える広告インプレッション、デジタルスポンサーシップ、継続的なメンバーシップを維持してきました。
大規模生成AIネットワークへの移行はクローラーの活動を変容させ、単なるパス探索からデータ抽出へと目的を転換させました。自律的な収集システムはデジタルディレクトリ全体を取り込み、意味データを解析し、閉じたチャットウィジェット内で統合された回答を提示します。この即時的な解決策は、サイトへの通常の訪問を不要にしてしまいます。調査によると、検索インターフェースで生成AIの回答が表示されると、外部ディレクトリへのリンクをクリックする確率は大幅に低下し、多くの事例で数パーセント以下にまで落ち込んでいます。このようなトラフィックパターンの変化は、標準的な広告配信モデルに依存して運用コストを賄っているプラットフォームに深刻な資金不足をもたらします。
Cloudflareのボット遮断がパブリッシャーの必須事項となった理由
パブリッシャーは長年、コンテンツの保護と検索可視性の維持という難しいトレードオフに直面してきました。Googlebot、Applebot、Bingbotなどをブロックしてモデル学習を阻止すれば、従来の検索インデックスから消えてしまうリスクを負うことになります。このような構造的な独占状態は、コンテンツ作成者に「自社の貴重なデータを無料で提供するか、検索での可視性を完全に犠牲にするか」という過酷な二択を迫ります。この動向は、新興AI企業による巧妙なクレイピング手法を助長し、サーバーコストを負担しているパブリッシャーにさらなる負荷をかけています。
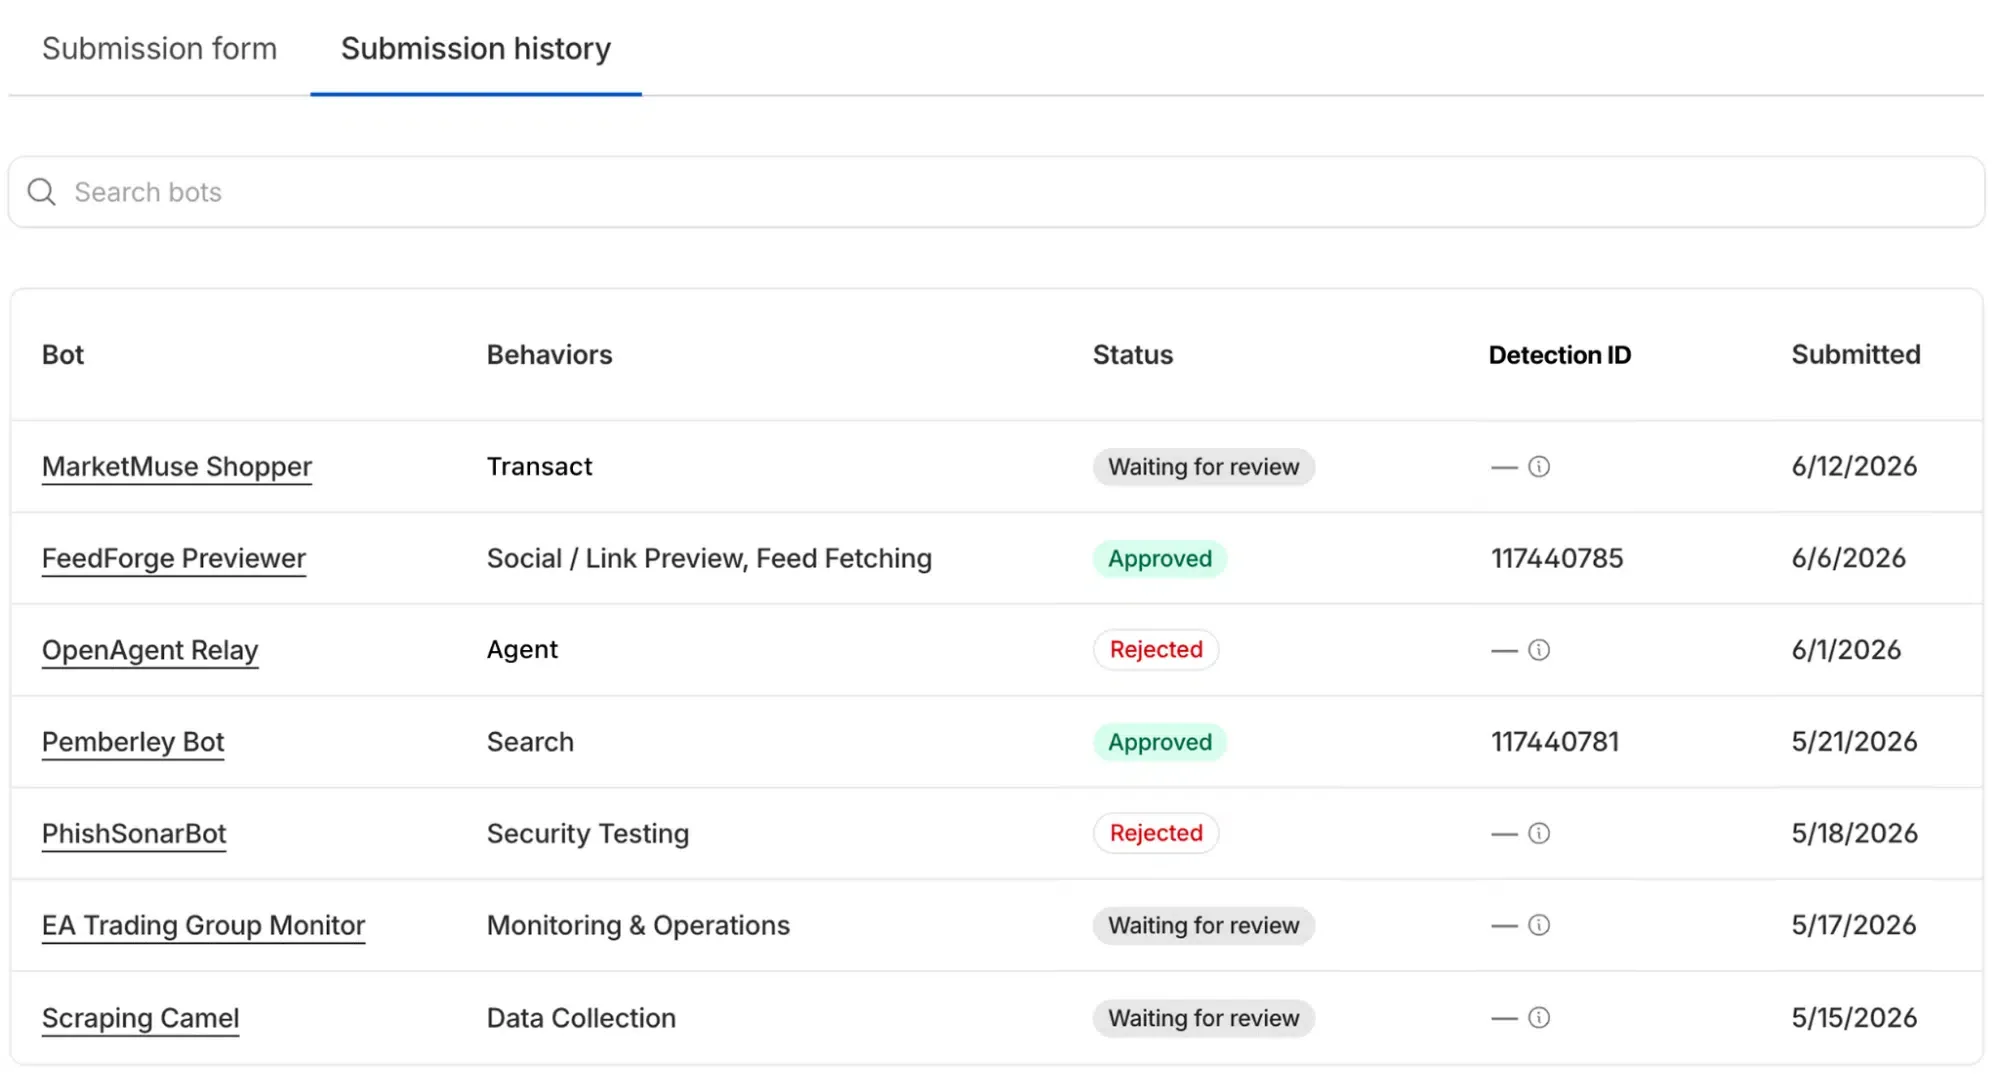
この均衡を保つため、Cloudflareは宣言的なゲート機能メカニズムを導入しました。Cloudflareによれば、2026年9月15日より順次、広告収益化を行っている顧客サイト全体で、学習ボットおよびユーザー誘導型エージェントをデフォルトでブロックする方針を開始します。このアップデートにより、明示的な許可がない限り、収益対象となるコンテンツがクローリングされることはなくなります。同時に、ネットワーク大手である同社は、従来の「Pay Per Crawl(クロールごとの支払い)」モデルから、成果に応じた「Pay Per Use(利用ごとの支払い)」エコシステムへの転換を図っています。You.comやCeramic.aiといったプラットフォームとの連携を通じ、パブリッシャーはAIエージェントがクエリの回答にコンテンツを利用するたびに直接的な報酬を得ることができ、持続可能な取引ベースの収益源を確保できるようになります。
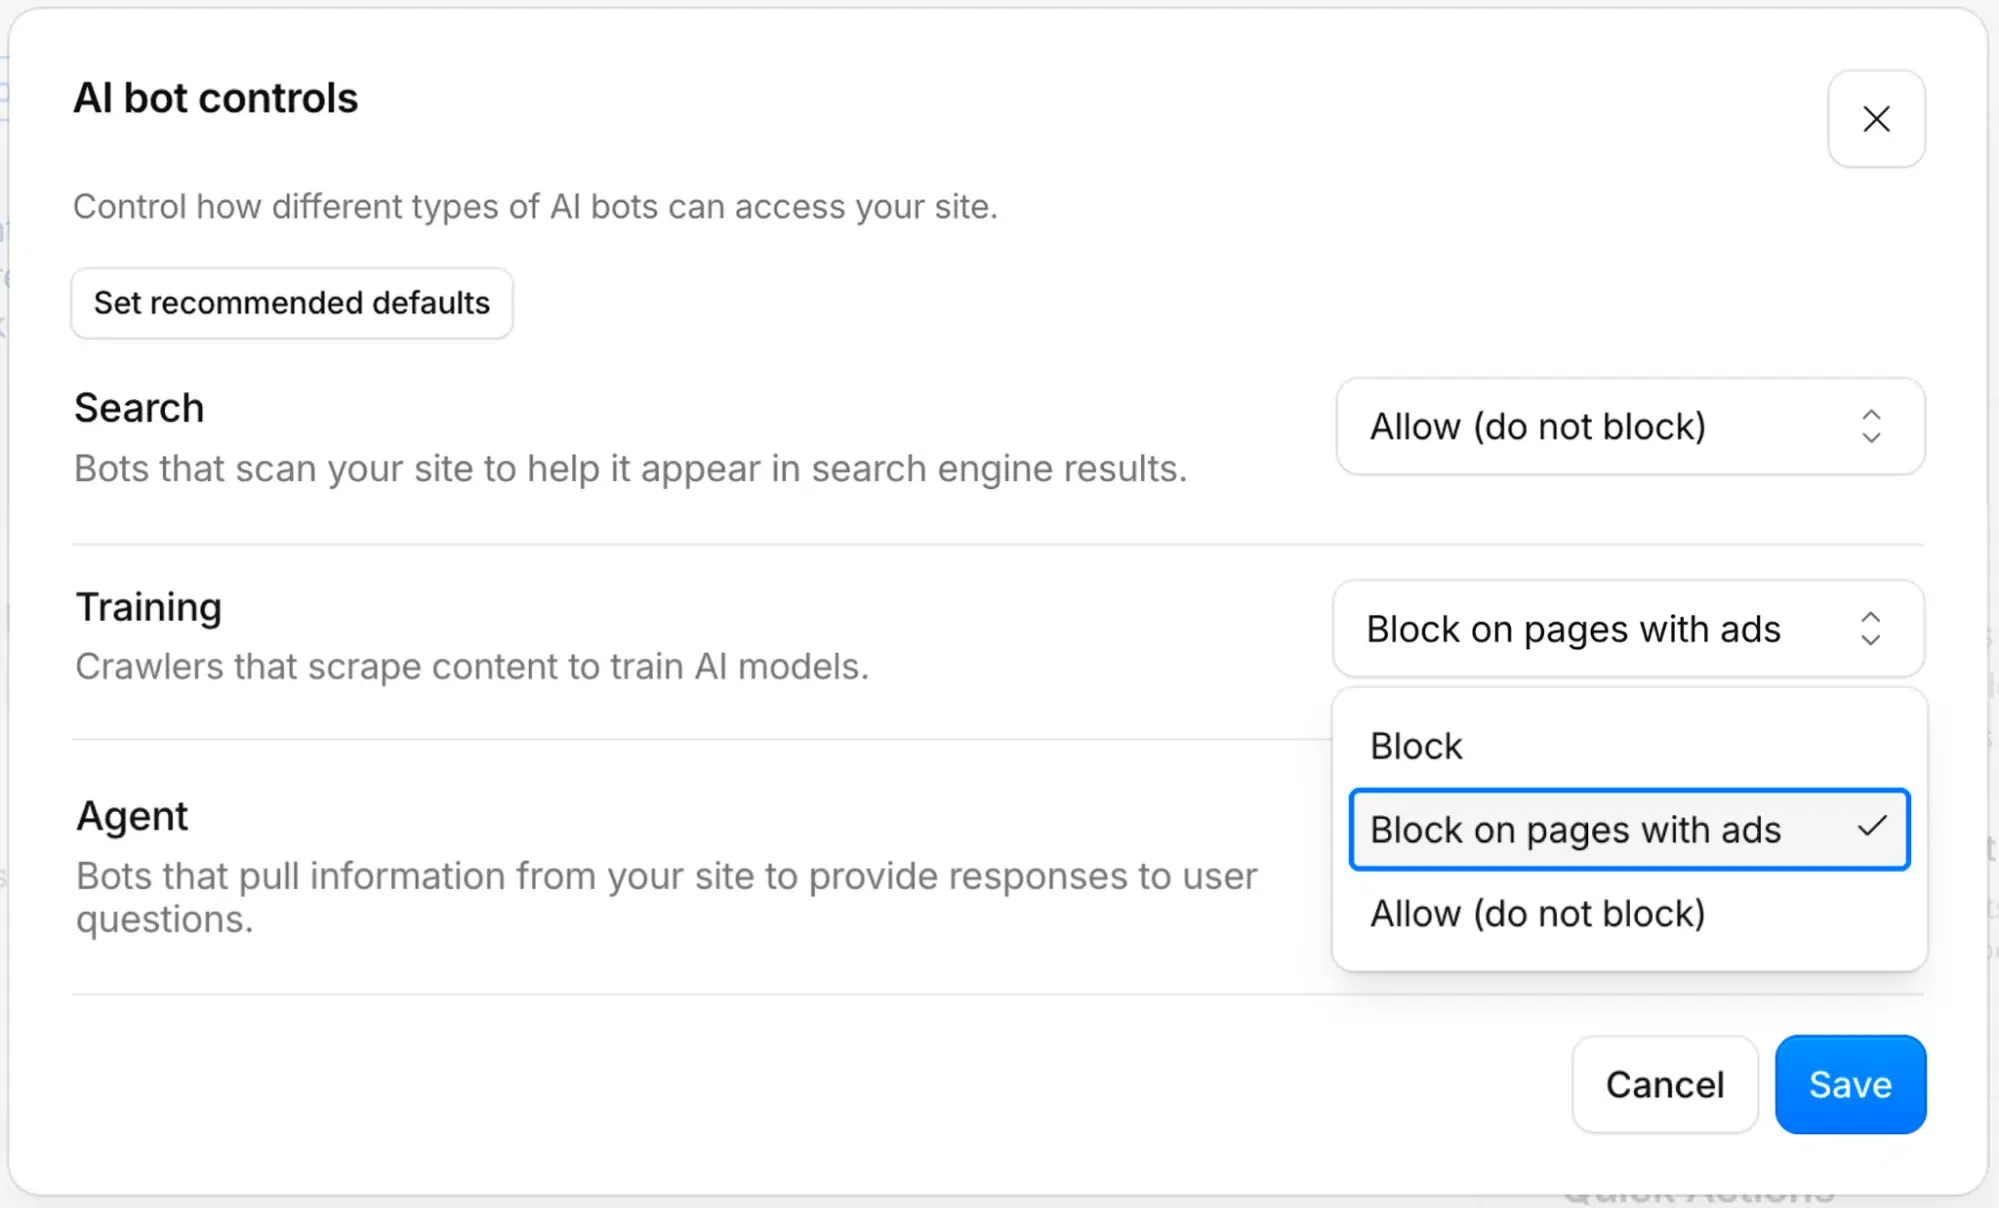
Cloudflareの学習ボット遮断ポリシーにおけるシステム的要因と非ビジュアル的なリクエストチェーン
インターネットトラフィックの構成を分析すると、自動ボットが全オンラインアクティビティの50%以上を占めていることが分かります。この量はオリジンサーバーに多大な負荷をかけており、特に変更のないコンテンツを何度も取得する重複リクエストが問題となっています。Cloudflareのテレメトリデータによると、検証済みのクローラーによるトラフィックの半分以上が完全に冗長なものであり、接続の両端で計算リソースを浪費しています。根本的な問題は、現代の検索・スクレイピング手法を支えるアーキテクチャにあり、本来の意図を隠蔽する汎用的なボットに依存していることにあります。
アプリケーション層では、ユーザー誘導型エージェントの技術的特性は、通常の人間によるブラウザセッションとは大きく異なります。この区別は極めて重要です。なぜなら、最新のヘッドレススクレイパーは従来のインタラクティブ要素を完全にバイパスするため、下流の計測システムにおいて深刻なトラッキング障害を引き起こすからです。
プロトコルの不整合:ステートレスなエージェントとステートフルなウェブブラウザ
従来のウェブ最適化では、標準的なブラウザセッションはクッキー、ローカルストレージ、構造化されたUser-Agent文字列を通じて状態(ステート)を管理することを前提としています。対照的に、自律的なエージェントやヘッドレスクローラーはステートレスなHTTPリクエストを実行します。この違いにより、パブリッシャーが広告価値を証明するために使用している計測パイプラインが機能しなくなります。以下の図は、アプリケーション層における根本的な違いを示しています。
[標準的なウェブセッション]
  ユーザーブラウザ (ステート・クッキー保持) ──> ウェブHTTPリクエスト ──> 広告インプレッション・参照元が記録される


[ステートレスなエージェントセッション]
  自動クローラー (ステートレスHTTP / ヘッドレスツール) ──> 個別フェッチ ──> 参照元が欠落・アトリビューション消失
自動ブラウザエージェントがページを取得し、テキストを処理してクローズドなチャット環境内で回答を生成すると、クライアントサイドのコンテキストは完全に消失します。従来のトラッキングスクリプトは実行できず、広告インプレッションは記録されず、標準的なリファラーヘッダーも消滅します。これにより、パブリッシャーが情報の価値を提供しているにもかかわらず、後続のシステムではエンゲージメントがゼロとして記録される「アトリビューションの空白」が生じます。このブラウザコンテキストの損失は、ユーザーが最終的にアプリをインストールする際、モバイルアトリビューションのワークフローにも悪影響を及ぼします。ヘッドレス訪問ではステートフルなトラッキングコンテナが存在しないため、標準的なモバイル計測ツールは、最初の発見イベントとそれに続くアプリインストールを結びつけることができません。この事態は、従来のマルチタッチアトリビューションモデルの崩壊を加速させています。
ソリューション比較:Cloudflare学習ボット遮断時代における「自社構築 vs 外部導入」
新しい自動スクレイパー規制の下でクライアントサイドトラッキングの境界線が曖昧になる中、エンジニアリングチームはアトリビューションアーキテクチャの再評価を迫られています。標準的なクライアントサイドのブラウザクッキーやデバイスレベルの属性だけに頼ることは、もはや長期的な戦略として有効ではありません。開発者は、サーバーサイドでのコンテキスト照合データベースを自社構築するか、ヘッドレス操作に耐えうる堅牢な計測システムを導入するかという、本質的な選択を迫られています。
アーキテクチャの評価:ステートレス時代における「Build vs Buy」
社内でコンテキスト照合システムを構築するには、開発者のセッションをキャッシュし照合するためのサーバーサイド・ステートデータベースの設定が必要です。この手法はデータパイプラインを完全に制御できる一方、エンジニアリングのオーバーヘッドは膨大です。開発者は、APIペイロードの受信、セッションの有効期限管理、不正防止のためのセキュアな暗号署名を自力で実装しなければなりません。対照的に、既製の計測SDKを統合すれば、こうしたメンテナンスの手間は解消されます。
以下の比較マトリクスは、ステートレスでエージェントによるアクセスが多い環境において、各トラッキング手法がどのようなパフォーマンスを示すかを示しています。
| 指標と機能 | 自社構築型データベースセッション | Firebase / Webviewリダイレクト | プレミアムMMPプラットフォーム (Adjust, AppsFlyer等) | Deferred Deep Linking SDK (OpoInstall) |
|---|---|---|---|---|
| アトリビューション継続性 | 高 (サーバーサイド) | 低 (クライアントサイド) | 高 (マルチタッチ) | 高 (プログラム的マッピング) |
| 開発コスト | 非常に高い | 低い | 高い | 低い |
| 運用負荷 | 高い (継続的) | 低い | 低い | 低い |
| 不正防止 | 中 (手動ルール) | 低い | 高い (アルゴリズム的) | 高い (ゼロトラスト署名) |
| レイテンシへの影響 | 変動あり | 中 | 中 | 低い (軽量フットプリント) |
このモデルの商用実装としては、Adjust、AppsFlyer、Branch、その他の遅延アトリビューション(Deferred Attribution)システムが存在します。その一例であるOpoInstallは、Deferred Deep Linking(遅延ディープリンク)とサーバーサイドでのパラメータ復元を提供し、分散されたウェブとモバイルコンテキスト間でセッションメタデータを保護します。リダイレクトチェーンをクライアントサイドから切り離すことで、最初の検索イベントから最終的なアプリ起動に至るまでのユーザーのジャーニーメタデータを保持し、スクレイパー遮断による制限を回避します。モバイルアトリビューションプラットフォームは、同様のサーバーサイドでの状態復元という考え方を活用し、ブラウザコンテキストが完全に存在しない状況下でもコンバージョンの整合性を維持しています。
統合チェックリストとガバナンススケジュール:Cloudflareのボット遮断による混乱を乗り切る
Cloudflareが広告掲載ページでの学習ボット遮断を実装する中でデータの継続性を確保するため、エンジニアリングチームおよびプロダクトチームは組織的な移行スケジュールを策定する必要があります。開発者にとっては、クライアントサイドのリダイレクトから離れ、堅牢なサーバーサイド検証手法を採用することが重要です。グロースチームにとっては、標準的なブラウザアトリビューションデータの消失を考慮し、ROAS算出パイプラインを見直す必要があります。
開発者向け実装チェックリスト
- RFC 7239 Forwardedヘッダーの実装:受信するすべてのAPIゲートウェイを設定し、標準化された
Forwardedヘッダーを解析して、信頼できる中間プロキシを特定できるようにします。
Forwarded: for=203.0.113.1;proto=https
- 暗号化されたURL署名の採用:すべてのプロモーション用リンクに対し、自動化されたボットによるリファラー値の改ざんを防ぐため、暗号署名付きパラメータを使用します。
- サーバーサイドセッション照合の有効化:クッキーベースのクライアントサイドリダイレクトから、最初のアプリ起動時にセッションキーを照合するプログラム的な状態データベースへと移行します。
プロダクト・グロース戦略チェックリスト
- ROASモデルの再構築:獲得ファネルを調整し、サーバーサイドのアクティベーションイベントを、従来のクライアントサイドのウェブ広告クリックよりも高く評価するように変更します。
- コンテキスト体験復元機能の導入:ウェブ上の参照元情報がエージェントによって削除された場合でも、パラメータ引き継ぎフレームワークを活用し、ユーザーが意図した到達先を復元します。
- BotBaseでのボットトラフィックの監査:リアルタイムの行動分類を用いて、自動化されたスクレイパーがマーケティングファネルとどのように対話しているかを監査します。
開発者は、標準的なrobots.txtの設定に最新のメタデータフィールドを追加することで、明示的なインデックス優先順位を伝えることができます。
# 提案されているメタデータ拡張機能に基づく実例
User-agent: *
Content-Signal: search=yes,ai-train=no,use=reference
Allow: /
この構造化されたアプローチにより、コンテンツ所有者は検索での発見可能性を維持しながら、AIプラットフォームが貴重な独自コンテンツをクローズドな学習データセットとして永続的に吸収することを防ぐことができます。
よくある質問 (FAQ)
なぜ同じボットが検索とAI学習の両方のためにページをクロールするのでしょうか?
Cloudflareはページに広告が含まれているかどうかをどのように判断し、ブロックを発動させるのですか?
「Pay Per Crawl」と「Pay Per Use」の違いは何ですか?
インターネットが人間中心のブラウジング環境からエージェント主導のエコシステムへと移行する中で、デジタル体験の構築と計測の方法を根本から見直す必要があります。自動プロキシやステートレスなエージェントがウェブコンテンツの主要な消費者となる中、従来型のクライアントサイドのアトリビューションモデルは劣化し続けています。ブラウザクッキーや基本的なHTTPリファラーへの依存だけでは、ユーザー獲得やデジタル収益化を支えるデータパイプラインを保護するにはもはや不十分です。
新しい時代において成長を維持するためには、エンジニアリングチームやプロダクトチームはアトリビューションロジックを標準的なクライアントサイドのブラウザアクションから切り離さなければなりません。サーバーサイドでのアイデンティティ解決、暗号署名付きパラメータ、堅牢なパラメータ引き継ぎフレームワークを採用することで、自動スクレイパーによる遮断からデータパイプラインを守ることが可能になります。この移行は単なるポリシー更新への適応ではなく、分散化されたエージェント対応のインターネット環境で生き残るためのシステム再構築を意味しています。
Share this article



