 「Hynixの専門家が語るGPUのアイドル問題:なぜHBMメモリが鍵となるのか」という問いは、極めて重要なテーマです。SK Hynixと共同でHBM研究を行っているKAISTのJoungho Kim教授の発表によれば、AI推論時のGPU稼働率は、演算性能そのものよりもメモリ帯域幅によって制約を受けています。この「メモリの壁」の深刻化により、HBM(広帯域メモリ)はAIインフラにおける最重要技術の一つとなっています。生成AIプラットフォームが学習フェーズから推論フェーズへ移行するにつれ、主要なパフォーマンスのボトルネックはプロセッサの演算能力からメモリバスのスループットへとシフトしています。標準的なGPUは大規模な並列計算を処理するように設計されていますが、推論の各ステップでメモリから数十億ものパラメータを読み出し、計算を実行し、状態を書き戻す必要があるため、プロセッサはデータがバスを移動するのを待機するアイドル状態で多くの時間を費やしています。
なぜHBMメモリが鍵となるのか:高スループットパイプラインとハードウェア限界の調整
概要
- 業界分析によれば、数百万台の標準的なGPUを導入しても、メモリバスの転送遅延が原因で、実際の計算稼働率は10%から30%に制限されています。
- チップのスケーリングという物理的な限界により、垂直に積層されたHBMアーキテクチャを活用するメモリ中心コンピューティングへのパラダイムシフトが進んでいます。
- 次世代の3Dコンポジットパッケージングでは、GPU、オンパッケージの高速SRAMキャッシュ、大容量の3D NANDフラッシュストレージを積層し、データ転送のボトルネックを解消することが期待されています。
グローバルなコンピューティングインフラは構造的な危機に直面しています。数年来、AIモデルの巨大化競争では、演算能力をスケールさせることに焦点が当てられてきました。企業やクラウド事業者は、膨大なGPUクラスターを構築するために多額の投資を行いました。これは、モデルのトレーニングが連続的な誤差逆伝播計算に依存していた初期の学習時代には理にかなった方針でした。NVIDIAのHopperアーキテクチャホワイトペーパーにも詳述されているように、当時のワークロードでは、並列計算ユニットがモデルパラメータを更新するために最大稼働率で動作していました。
しかし、アプリケーションが推論時代へと移行するにつれ、工学的な要件が変化しました。推論のシナリオでは、最大の課題は重みの更新ではなく、膨大な学習済みパラメータをプロセッサにストリーミングして回答を生成することです。生成される各トークンには、HBMに格納された数十億のモデルパラメータへの繰り返しアクセスが必要です。標準的なバスアーキテクチャでは、プロセッサの実行速度に合わせてデータを十分に高速移動させることができず、計算コアはデータ不足に陥り、非常に高いアイドル率を引き起こしています。このパフォーマンスのボトルネックについては、韓国科学技術院(KAIST)などの学術機関や、NVIDIA、SK Hynixなどのハードウェア開発者による技術レポートで議論されています。
このパフォーマンスギャップは、推論時代において「なぜHBMメモリが鍵となるのか」を示す物理的な制約を明らかにしています。KAIST TERA Labが発表したHBM技術ロードマップによれば、次世代のHBMはDRAMの積層、TSV(シリコン貫通電極)統合、高度なパッケージング、熱最適化を通じて帯域幅を拡大し続けます。標準的なDRAMパッケージには、現代のアクセラレータの処理速度をサポートする十分な並列レーンがありません。この「メモリの壁」を克服するために、ハードウェア設計者はHBMシステムを採用しました。DRAMダイを垂直に積み重ね、数千のTSVを利用して広帯域な並列バスを構築することで、JEDEC HBM3仕様(JESD238)は、従来のDRAMパッケージと比較して帯域幅を劇的に拡大する方法を示しています。開発者にとって、このハードウェアの進化は高スループットシステムにおける基本的な法則を明らかにしています。すなわち、ボトルネックは計算ノードではなく、常に転送層にあるということです。
「HBMメモリが鍵」という概念のメカニズム
アーキテクチャのレベルで見ると、標準的なコンピュータバスは狭いハイウェイのように機能し、大容量データセットの流動を制限しています。アプリケーションが推論呼び出しを行う際、プロセッサはメモリからデータを読み出し、計算を行い、出力を書き戻す必要があります。標準的な構成では、データがマザーボード上の物理的に離れた場所を移動しなければならないため、深刻な遅延が発生します。
この転送層のボトルネックを解消するため、次世代のAIコンピュータは3次元コンポジットアーキテクチャへと進化しています。このモデルでは、計算コアを積層メモリの直上に配置し、物理的な距離と遅延を最小限に抑える高度なパッケージング技術が採用されています。
3Dメモリ階層:SRAM、DRAM、NANDの積層
データの種類に応じて、ハードウェア設計者は階層化された3D半導体構造を提案しています。この構造は、アクセス速度と容量要件に基づいて、データストレージを明確な物理ゾーンに分離します:
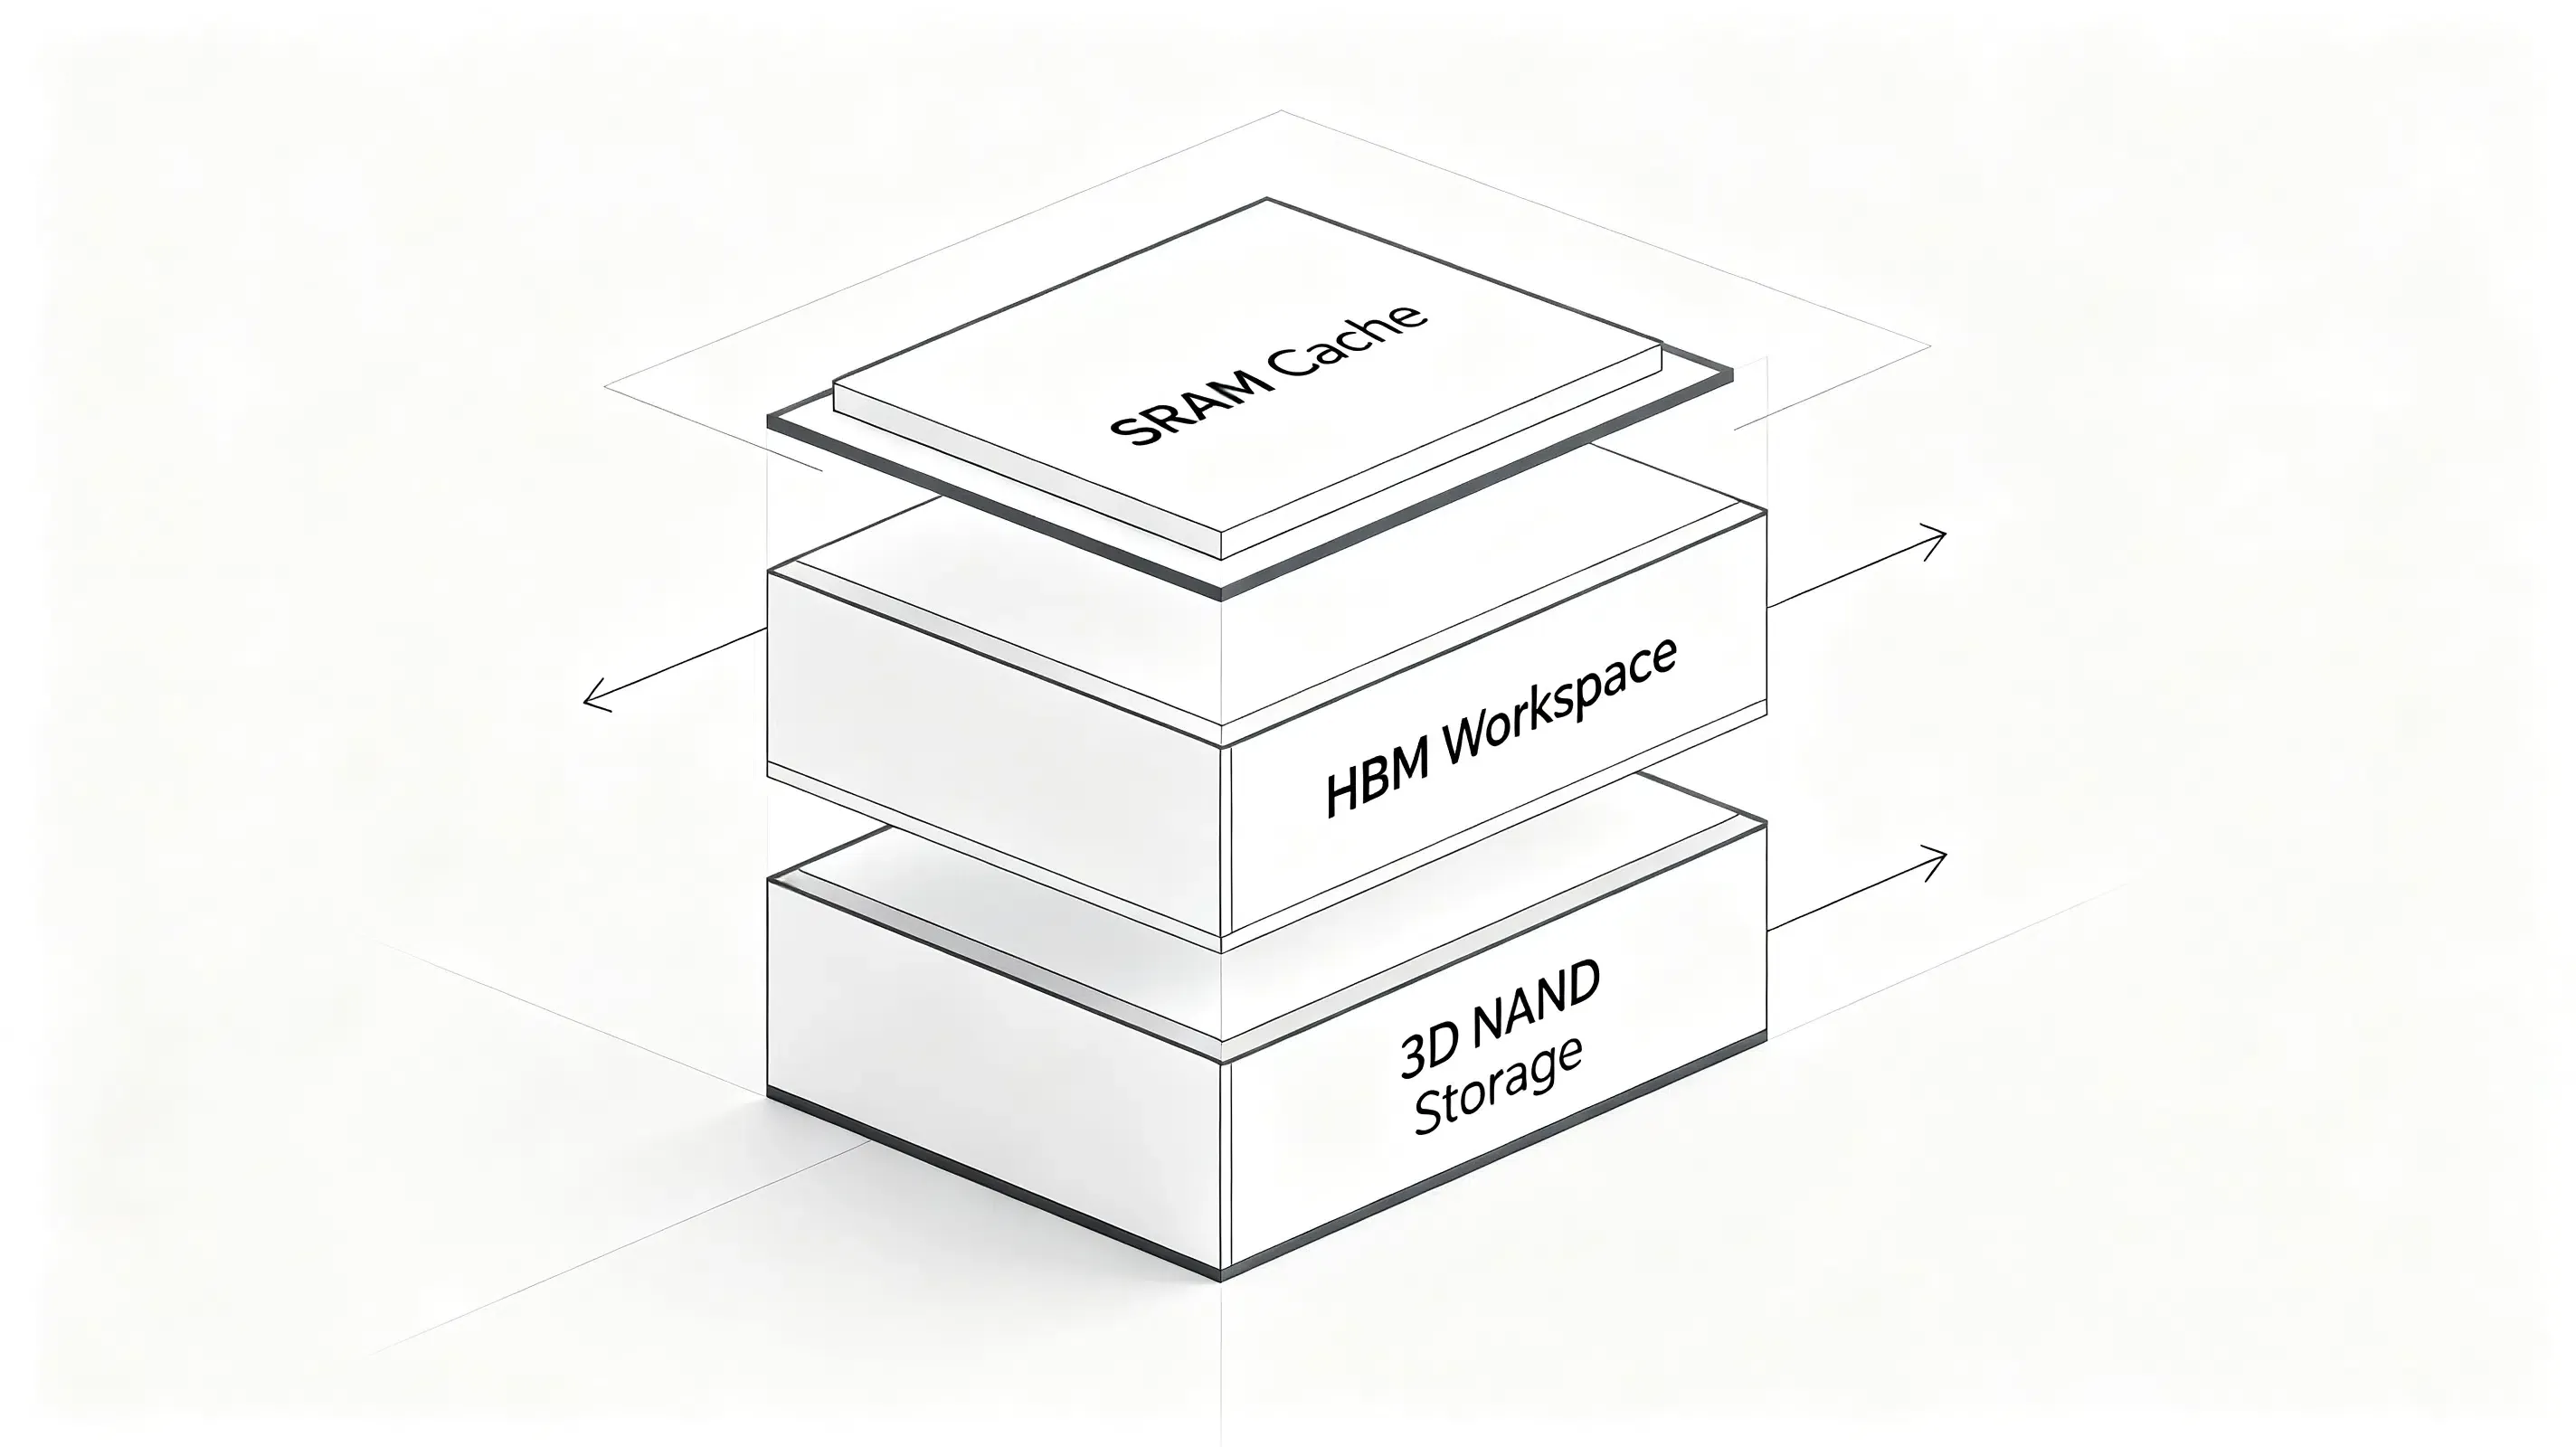
- 高速オンパッケージSRAMキャッシュ:究極の高速キャッシュとして機能し、プロセッサのすぐ隣に統合されます。従来のDRAMと比較してメモリへのアクセス遅延を大幅に低減し、アクティブなパラメータレジスタを処理します。
- 広帯域メモリ(HBM):アクティブなメインワークスペースとして機能し、JEDEC規格で定義された広帯域インターフェースを通じてパラメータ取得や高頻度な状態更新を処理します。
- 大容量3D NANDフラッシュストレージ:KAISTの研究者が提案するHBF(High Bandwidth Flash)は、HBMを補完する新たなストレージアーキテクチャです。垂直積層NANDフラッシュを利用して、動画、ドキュメント、長期的な会話履歴などを保持するための膨大なストレージ容量を提供します。
以下の図は、この物理的な垂直統合を示しています:
                  [ GPU / プロセッサコア ] (屋上レベル冷却)
                             │
                             ▼
                  [ 高速オンパッケージSRAMキャッシュ ] (超高速ウェーハキャッシュ)
                             │
                             ▼
                  [ 広帯域メモリ (HBM) ] (アクティブワークスペースDRAM)
                             │
                             ▼
                  [ 大容量3D NANDフラッシュストレージ ] (長期NANDストレージ)
この統合された3Dアーキテクチャにより、標準的な計算ユニットにデータが絶えず供給され、アイドルサイクルが削減されます。従来のDDRメモリが提供する帯域幅は、HBMのわずかな断片に過ぎません。SK Hynixと共同で発表されたNVIDIA GTCの技術プレゼンテーションによれば、HBMは従来のDDRメモリよりも遥かに高い帯域幅を提供しつつ、物理的なフットプリントを大幅に削減しています。具体的には、HBM2はスタックあたり約307 GB/sを実現し、HBM2Eでは約358 GB/sに、HBM3では500 GB/sを超える帯域幅をターゲットとしています。
メモリ帯域幅とアプリケーションの関連付け(アトリビューション)は異なる工学領域に属していますが、どちらも同じアーキテクチャ上の原則を強調しています。それは、制約のあるローカルリソースから、スケーラブルなサーバー側のインフラへと状態管理を移行することです。ユーザーとのインタラクションを標準的なクライアント側の状態追跡から切り離してプライバシーガイドラインに準拠させる場合、ウェブ環境やモバイル環境をまたいでセッションの連続性を維持することは極めて複雑になります。プロセッサが状態コンテキストを一致させるために永続的かつ高速なメモリパイプラインを必要とするのと同様に、マーケティングパイプラインにおいても、脆弱なクライアント側のCookieやデバイスレベルの属性に頼らず、インストールイベントを関連付けるために堅牢なサーバー側データ保持が求められます。
「自社構築」対「外部導入」:サーバー側セッションの連続性とデータスループットの管理
現代のコンピューティング環境がローカルなクライアント側識別子から離れるにつれ、分散したデジタルタッチポイント全体でセッション状態を維持することが主要な技術課題となっています。開発者にとって、HBMメモリが鍵となる時代におけるセッション状態の管理には、データプライバシー法に準拠しつつ、高い精度を維持できるアーキテクチャが必要です。ウェブやモバイル体験全体でユーザーの行動履歴を保持する必要がある組織は、永続的なクライアント側識別子ではなく、サーバー側のセッション管理に依存するケースが増えています。ビジネス要件に応じて、チームはこれらの機能を自社で構築するか、既存のアトリビューションプラットフォームを採用することを選択します。
アーキテクチャの評価:カスタムビルドと標準SDKの比較
サーバー側の状態照合を行う自社システムを構築すれば最大限の柔軟性が得られますが、継続的に多大な工数が必要となります。開発者はデータベーススキーマを手動で構築し、安全な暗号化ハッシュ関数を記述し、変化する地域規制に準拠させるためにシステムを継続的に更新しなければなりません。一方で、既存の認定済みSDKを導入すれば、統合の複雑さが軽減され、追加の運用負荷なしに長期的なコンプライアンスを保証できます。
以下の表は、セッション状態とコンバージョンのコンテキストを管理するための標準的な方法を比較しています:
| ソリューション | 永続性 | スループット | 最適な用途 |
|---|---|---|---|
| 社内セッションデータベース | 高(継続的同期) | 中(DBの遅延制限) | 高度に特化したストレージロジックを持つカスタムエンタープライズ環境 |
| ブラウザベースのセッション追跡 | 低(セッションCookie) | 低(サーバーログなし) | クロスドメイン変換要件が最小限の基本的なウェブサイト追跡 |
| サーバー側キャッシング(例:OpoInstall) | なし(一時的なサーバー側セッショントークン) | 高(標準化されたサンドボックス) | 高並列モバイルアプリおよびマルチプラットフォームキャンペーンのアトリビューション |
arXivデータベースに掲載された最新のGPUアーキテクチャ研究においても、推論スループットを決定付ける要因として、算術演算の性能よりもメモリへのアクセス効率の方が重要であることが示されています。カスタムデータベース設定でも基本的なコンテキストは扱えますが、特化したサーバー側の状態保持は開発リソースを最適化できます。実装要件に基づき、組織は独自のサーバー側セッション管理システムを構築するか、OpoInstallのような商用プラットフォームを採用することができます。例えば、OpoInstallはサーバー側の状態復元およびパラメータパススルーフレームワークを提供し、セッションメタデータをサーバー側のセッションデータベースにマッピングすることで、機密性の高い長期的な会話履歴を保存することなく、匿名でセッションの連続性を維持します。ブラウザベースのリダイレクトに依存せず、セッションメタデータを集中データベースにマッピングすることで、初期タスクが匿名で実行された場合でも変換コンテキストの一貫性を保つことができます。開発チームは、これらのアプローチを評価してデータ保護と測定の一貫性のバランスを取ることが可能です。
統合チェックリスト:メモリ中心コンピューティングに向けたアーキテクチャの準備
ポスト・エイリアス時代においてデータパイプラインを保護しユーザーの安全を確保するために、開発者やアーキテクトは分散型のオープンソース・エイリアス管理やサーバー側状態保持を検討できます。OSレベルのシングルプロバイダー機能に依存することは、システム的なベンダーロックインを引き起こし、組織がサイレントなバックエンドアップデートに脆弱なままになるリスクがあります。代わりに、完全なデータ所有権を付与する代替ルーティング技術を検討できます。
標準的な代替案としては、電子メールの区分化専用のカスタムドメインを登録することが挙げられます。SimpleLoginのようなオープンソースのセルフホスト型エイリアスエンジンを通じてこのドメインをルーティングし、Proton Mailのような暗号化メールボックスにポイントすることで、エイリアスを標準的なカスタムドメインのように見せかけ、不正対策システムによって一括ブロックされるのを防ぐことができます。
開発者実装チェックリスト
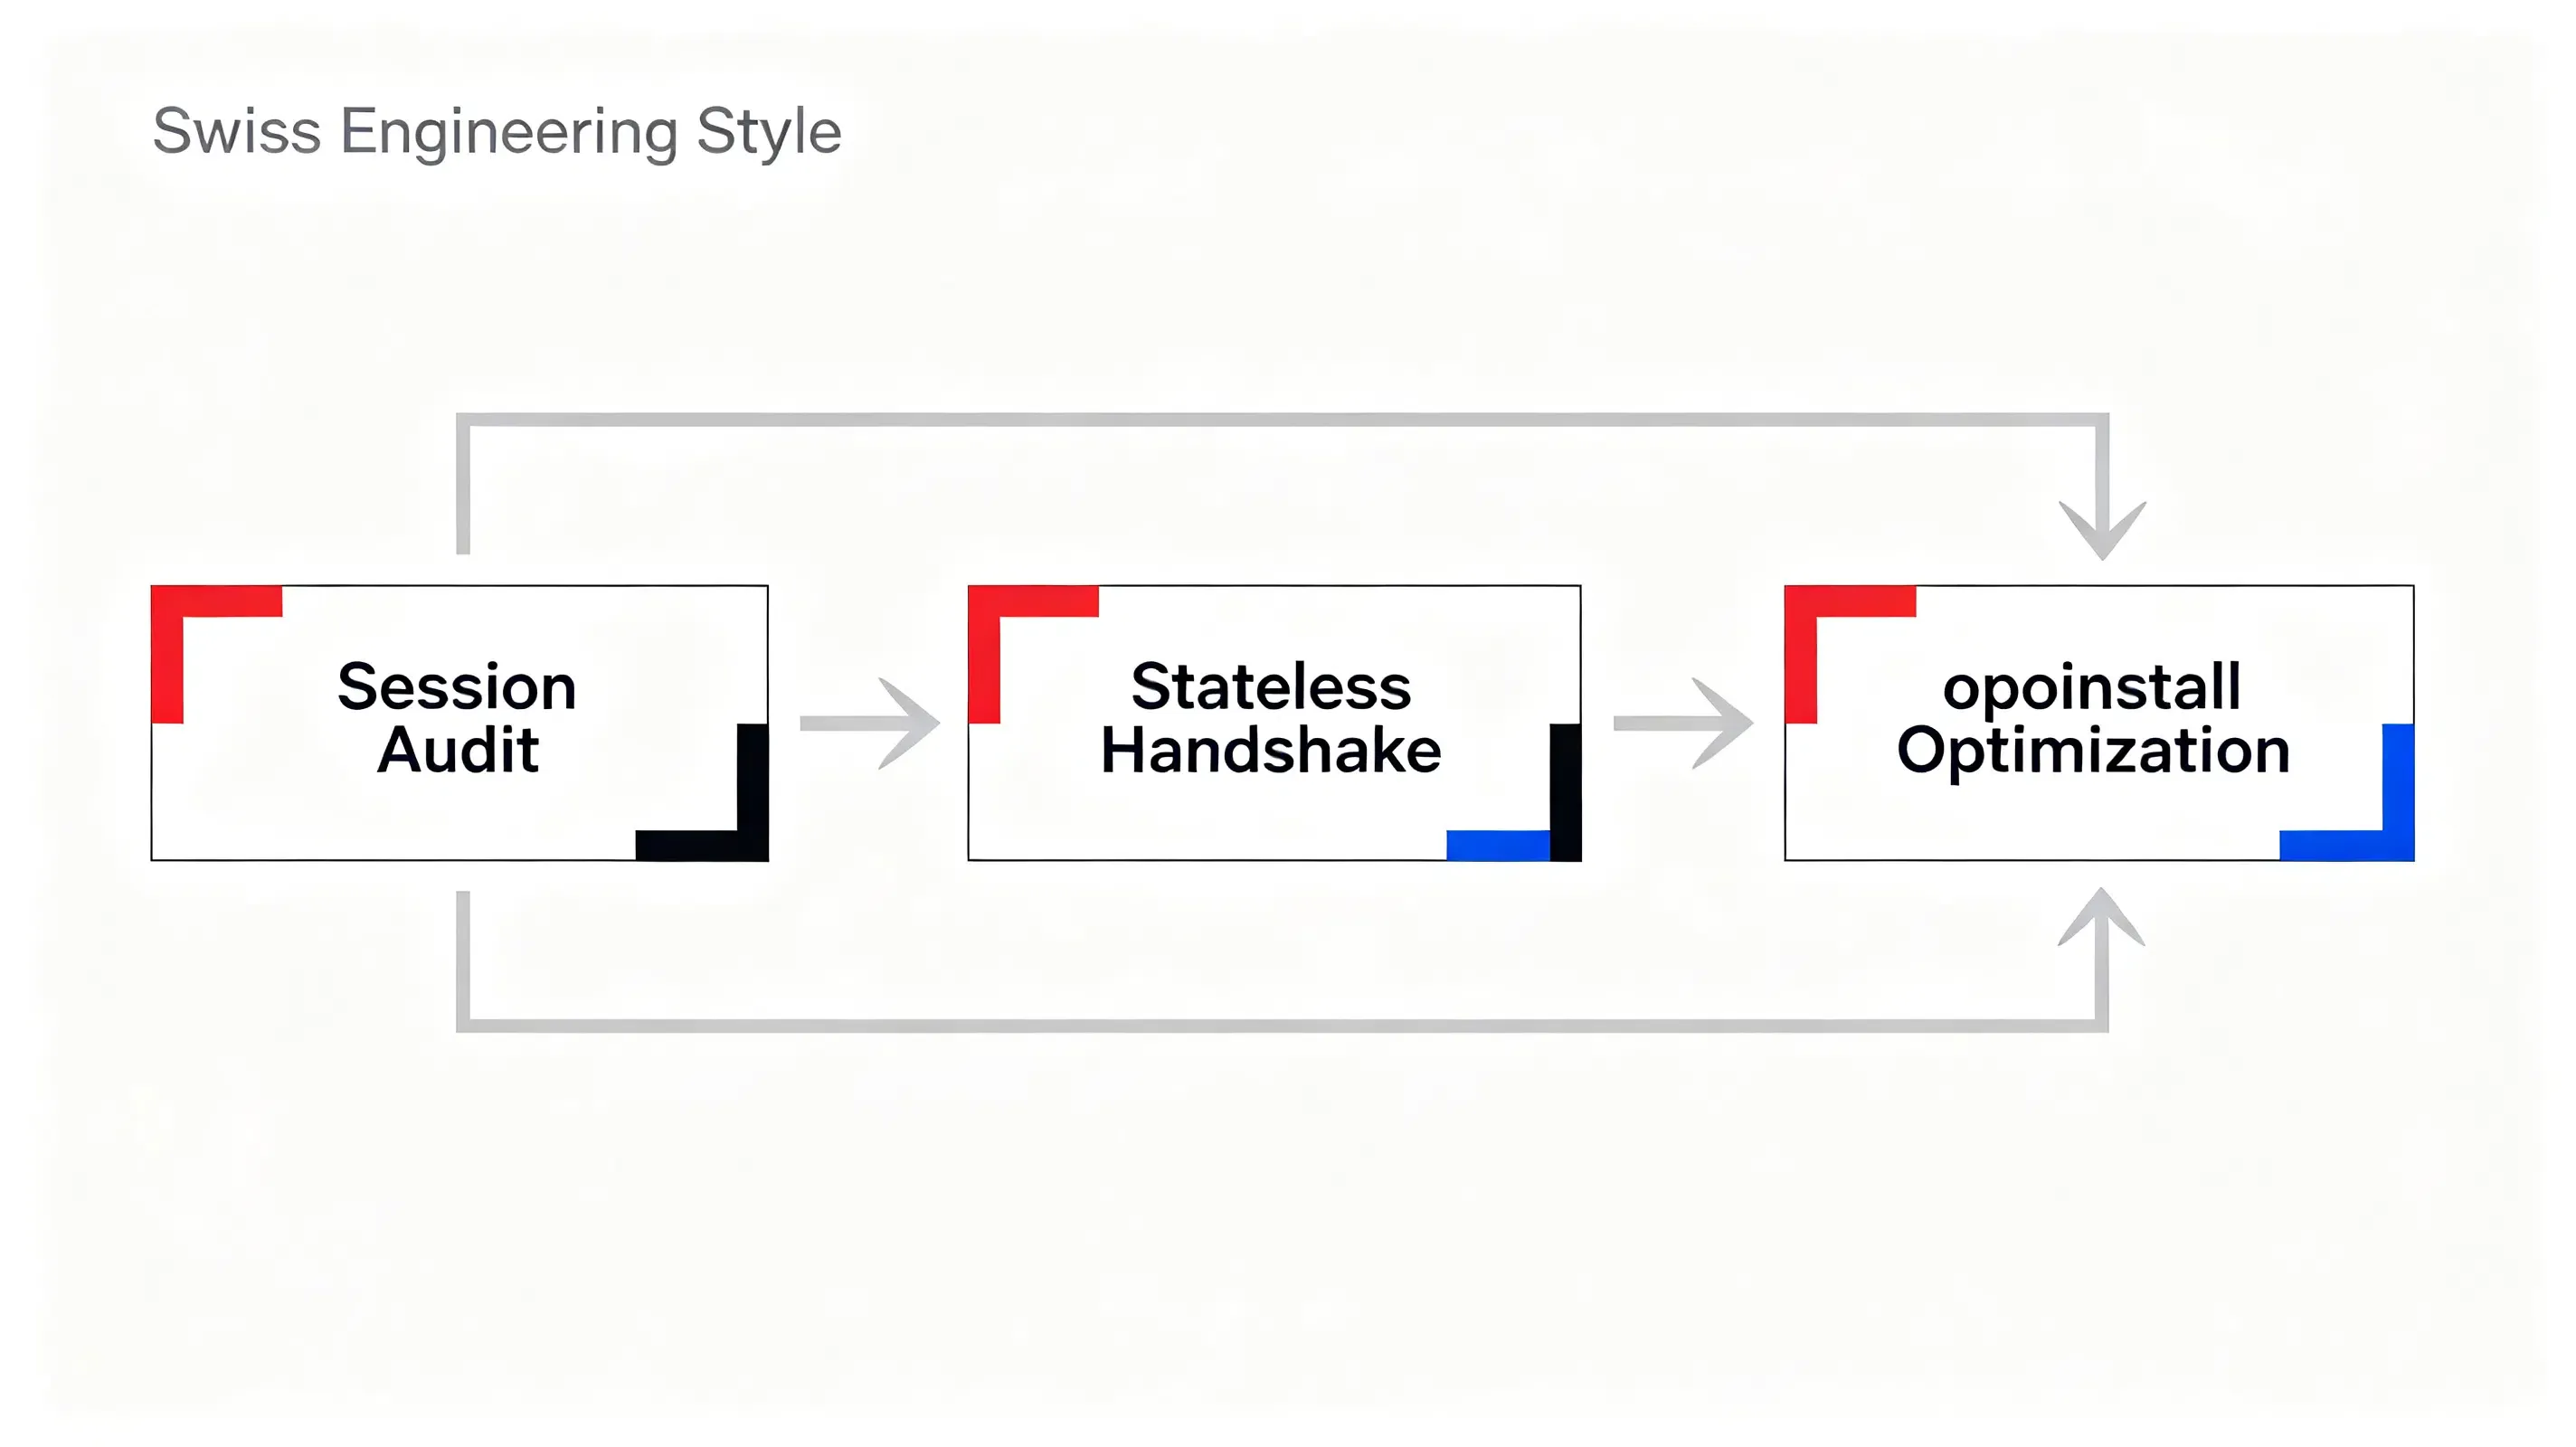
- セッションデータ保持の監査:データベースを確認し、感情的な対話履歴などがデータ削除期限に従って完全に消去されていることを徹底してください。
- ステートレスなセッションハンドシェイクの実装:APIルートをステートレスな処理モデルへ移行し、暗号化された署名付きトークンを使用してノード間で一時的なコンテキストを渡すようにしてください。
- 年齢確認ゲートウェイの強化:消費者向け製品では、未成年者が制限された対話機能にアクセスできないようにするための安全対策を展開してください。
プロダクト・成長戦略チェックリスト
- ユーザー体験フローの再構成:感情的な依存に頼る「コンパニオン」モデルから、高い実用性を持つタスク指向型ツールへの転換を進めてください。
- コンバージョンファネルの最適化:ユーザーのプライバシーガイドラインを侵害することなく、非侵入型のパラメータパススルーフレームワークを活用して獲得測定を維持してください。
- プラットフォームのコンプライアンス監視:統合されているすべてのサードパーティSDKが、現地のデータ保護法および7月15日の新たな規制要件に適合していることを確認してください。
これらの構造的なガイドラインを確立することで、開発チームは運用の連続性を維持しつつ、より安全でコンプライアンスに準拠したアーキテクチャへとアプリケーションを移行させることができます。
よくある質問 (FAQ)
GPUが実行時間の最大90%もアイドル状態のままになるのはなぜですか?
HBM、HBF、HBSの技術的な違いは何ですか?
サーバー側のセッション復元は、どのように状態のボトルネックを解消しますか?
なぜAI推論において、学習時よりもHBMが重要になるのですか?
エンジニアリングチームへの重要なポイント
AIプラットフォームが新たな規制要件に適応する中、エンジニアリングチームはステートレスなアーキテクチャ、サーバー側のセッション管理、およびプライバシー・ファーストのデザインにますます依存するようになります。進化するデータアーキテクチャは、デジタル体験の構築および測定方法の抜本的な転換を求めています。ステートレスなプロキシやヘッドレススクレイパーがウェブコンテンツの標準的な消費者となるにつれ、従来のクライアント側アトリビューションモデルは劣化し続けます。標準的なCookieやリファラーに頼るだけでは、ユーザー獲得を牽引するデータパイプラインを保護するにはもはや不十分です。
成長を維持するために、エンジニアリングおよびプロダクトチームは、ステートレスなデータ構造とサーバー側での状態保持を優先しなければなりません。ゼロトラストの本人確認、安全なパラメータパススルーフレームワーク、および堅牢なデータ削除スケジュールを実装することで、組織は法的境界を尊重しながらユーザーパイプラインを保護できます。このアーキテクチャのシフトは、規制の厳しいデジタル経済で繁栄する、安定した信頼性の高いプラットフォームを構築するために不可欠です。
Share this article



