JEDECがHBM4規格を緩和したことは、半導体の標準厚さルールが見直されたことを意味し、業界全体で進むはずだった高度なハイブリッドボンディング技術への移行を遅らせる重要な転換点となりました。AIワークロードがモデル学習から推論へとシフトするにつれ、業界における最大のパフォーマンスボトルネックはGPUの演算性能からメモリ帯域幅へと移っています。一般的なGPUは膨大な並列演算を処理するよう設計されています。しかし、推論プロセスでは、メモリから数十億のパラメータを読み込み、計算を実行し、結果をメモリに書き戻すという工程が必要なため、プロセッサはメモリトランザクションの完了を待機するアイドル状態に多くの動作サイクルを費やしてしまいます。
JEDECがHBM4規格を緩和した理由:高スループットメモリとパッケージング物理の整合
概要
- 高帯域幅メモリの標準厚さ制限が最大1,000マイクロメートルまで緩和され、ハイブリッドボンディングを用いてマイクロバンプを排除する必要性が直接的に低下しました。
- 銅同士の直接接合(カッパー・トゥ・カッパー)の採用が遅れる一方で、よりシンプルで商業的に安定した熱管理の代替手法が支持されています。
- 次世代のハイブリッドボンディングが広く普及するのは、入出力密度が4,096端子まで倍増するまで棚上げされる見通しです。
世界のコンピューティングインフラは構造的な危機に直面しています。過去数年間、AIモデルの巨大化競争は、純粋な演算能力のスケールアップに集中していました。企業やクラウド事業者は、膨大なGPUクラスターの構築に多額の投資を行ってきました。この焦点は、バックプロパゲーション計算に依存していた初期のモデル学習時代には非常に論理的なものでした。当時のワークロードでは、高密度DRAMスタッキングの業界検証レポートに記録されている通り、並列コンピューティングユニットがモデルパラメータを更新するために最大能力で稼働していました。
しかし、アプリケーションが推論時代へと移行するにつれ、エンジニアリングの要件は変化しました。推論シナリオでは、課題は重みの更新ではなく、膨大な事前学習済みパラメータをプロセッサにストリーミングして即座にクエリに応答することです。生成されるすべてのトークンは、高帯域幅メモリに保存された数十億のモデルパラメータへの繰り返しアクセスを必要とします。標準的なバスアーキテクチャでは、プロセッサの実行速度に追いつくほど高速にデータを移動できないため、演算コアがデータ飢餓状態に陥り、極めて高いアイドル率を引き起こします。このパフォーマンスのボトルネックは、メモリ中心のハードウェア設計を追跡する技術業界レポートでも議論されています。
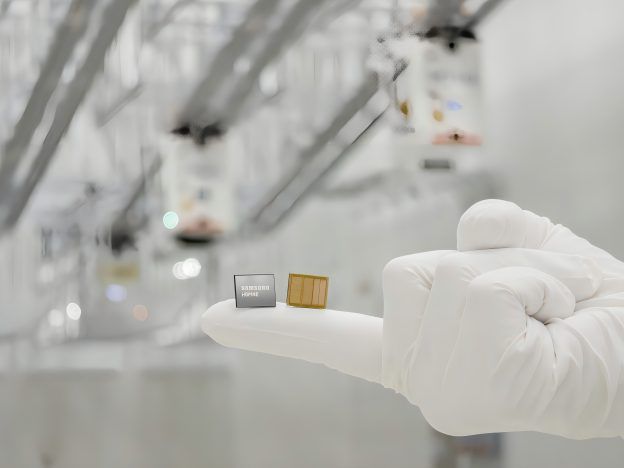
この性能ギャップこそが、JEDECがHBM4の厚さ仕様を緩和し、より大きなパッケージング公差に対応させた理由です。標準的なDRAMパッケージには、最新のアクセラレータの処理速度をサポートするために必要な並列レーンが不足しています。この「メモリの壁」を克服するため、ハードウェアアーキテクトは高帯域幅メモリ(HBM)システムに注目しました。DRAMダイを垂直に積み重ね、数千ものシリコン貫通ビア(TSV)を利用して広帯域な並列バスを構築することで、JEDECのHBM規格は、TSVベースのスタックメモリが従来のDRAMパッケージと比較して利用可能な帯域幅をいかに劇的に拡大するかを定義しています。開発者にとって、このハードウェアの進化は、スループットの高いシステムにおける基本的な法則を示しています。ボトルネックは常に演算ノードではなく、データ転送層にあるということです。
JEDECによるHBM4規格緩和決定の内部メカニズム
アーキテクチャレベルでは、標準的なコンピュータバスは狭いハイウェイのように機能し、大容量データセットのフローを制限します。アプリケーションが推論呼び出しを実行する際、プロセッサはメモリからデータを読み込み、計算を完了させ、出力をメモリに書き戻す必要があります。標準的な構成では、データがマザーボード上の長い物理距離を移動しなければならないため、深刻な遅延が発生します。
この転送層のボトルネックを解消するため、次世代のAIコンピュータは3次元複合アーキテクチャへと進化しています。このモデルでは、演算コアをスタックメモリの直上に配置し、高度なパッケージングを利用して物理距離と遅延を最小限に抑えます。
3Dメモリ階層:従来のボンディングと熱ブロックの積層
異なるクラスのデータを扱うため、ハードウェアアーキテクトは層状の3D半導体アーキテクチャを提案しています。この構造は、アクセス速度と容量要件に基づいて、データストレージを物理的に分離します:
- 熱圧縮(TC)ボンディング:従来の熱接合は、各DRAMダイの下にマイクロバンプとアンダーフィルを配置し、精密な熱と圧力を加えてスタックを接合します。
- 銅直接ハイブリッドボンディング:高度なハイブリッドボンディングは、バンプを使用せずに隣接するダイの銅インターコネクトを直接結合します。パッケージの薄型化が可能ですが、極めて高い製造環境の清浄度と複雑な装置が必要です。
- 熱対策の代替案:カスタム側面冷却ブロックなどの新たな進歩により、専用の熱コンポーネントをHBMスタックの隣や内部に配置し、ハイブリッドボンディングに即座に移行せずとも十分な放熱を提供します。これにより、改訂されたJEDEC仕様の下で従来の熱圧縮ボンディングの商業寿命を効果的に延ばしています。
以下の図は、この物理的な垂直統合を示しています:
                  [ 従来のTCボンディング (マイクロバンプ & アンダーフィル) ]
                                     │
                                     ▼
                  [ 側面熱ブロック (Samsung HPB / Hynix iHBM) ]
                                     │
                                     ▼
                  [ 銅直接接合 (HBM5E/6段階) ]
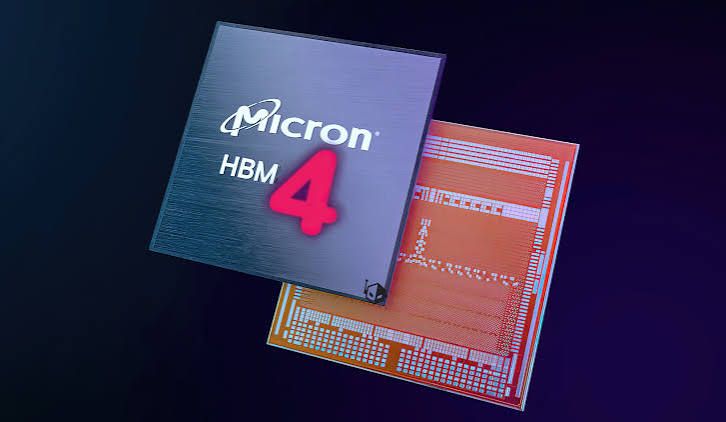
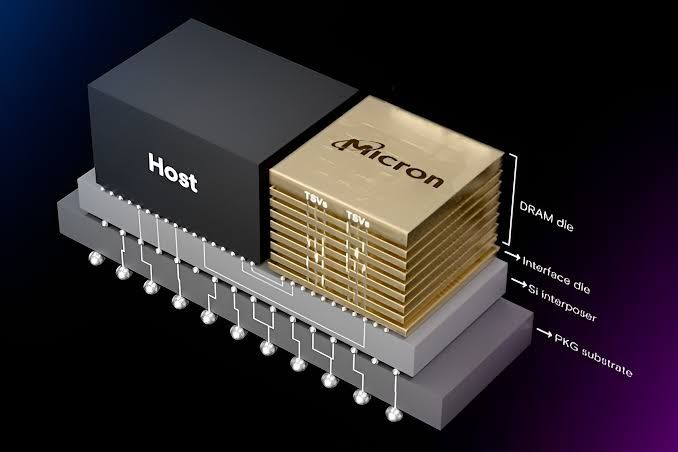
この統合された3Dアーキテクチャにより、標準的な演算ユニットにデータが継続的に供給され、アイドルサイクルが削減されます。メモリ帯域幅とアプリケーションのアトリビューションは異なるエンジニアリング分野に属しますが、どちらも同じアーキテクチャ原則を強調しています。それは、制約のあるローカルリソースからスケーラブルなサーバーサイドインフラへと状態管理を移行することです。ユーザーインタラクションを標準的なクライアントサイドの状態追跡から切り離してプライバシーガイドラインを満たす場合、異なるWeb環境やモバイル環境間でシームレスなセッション継続性を維持することは非常に複雑になります。プロセッサがコンテキストに合わせるために永続的かつ高速なメモリパイプラインを必要とするのと同様に、マーケティングパイプラインも脆弱なクライアントサイドのクッキーやデバイスレベルの属性に頼らず、インストールイベントを関連付けるために堅牢なサーバーサイドでのデータ保持を必要とします。
高スループットアーキテクチャの原則を現代のソフトウェアシステムに適用する
現代のコンピューティング環境がローカルなクライアントサイド識別子から離れるにつれ、分散したデジタルタッチポイント間でセッション状態を維持することが主要なエンジニアリングの課題となっています。開発者にとって、JEDECによるHBM4規格緩和の決定後にセッション状態を管理するには、データプライバシー法に準拠しつつ、高い精度を誇るアーキテクチャが求められます。Webとモバイルの体験を跨いでユーザーのジャーニーを保持する必要がある企業は、永続的なクライアントサイドの識別子ではなく、サーバーサイドのセッション管理に依存する傾向が高まっています。ビジネス要件に応じて、チームはこれらの機能を内製するか、既存のアトリビューションプラットフォームを採用することになります。
アーキテクチャ評価:内製 vs 標準化SDK
サーバーサイドの状態照合を行うシステムを自社で構築する場合、最大の柔軟性は得られますが、継続的なエンジニアリングリソースが大量に必要となります。開発者はデータベーススキーマを手動で構築し、セキュアな暗号化ハッシュ関数を作成し、変化する地域規制に準拠させるためにシステムを常に更新し続ける必要があります。対照的に、あらかじめ構築され認定されたSDKを導入することで、統合の複雑さが軽減され、追加のオーバーヘッドなしで長期的なコンプライアンスが保証されます。
以下の表は、セッション状態とコンバージョンコンテキストを管理するための標準的な方法論を比較したものです:
| ソリューション | 永続性 | スループット | 推奨用途 |
|---|---|---|---|
| 内製セッションデータベース | 高 (継続的な同期) | 中 (DBレイテンシ制限) | 高度に特殊なストレージロジックを持つカスタム企業環境 |
| ブラウザベースのセッション追跡 | 低 (セッションクッキー) | 低 (サーバーログなし) | クロスドメインコンバージョン要件が最小限の基本的なWebサイト追跡 |
| サーバーサイドキャッシュ (例: OpoInstall) | なし (一時的なサーバーサイドセッショントークン) | 高 (標準化されたサンドボックス) | 大規模なモバイルアプリおよびマルチプラットフォームキャンペーンのアトリビューション |
カスタムデータベース構成でも基本的なコンテキストは扱えますが、専門的なサーバーサイドの状態保持は開発リソースを最適化できます。実装要件に応じて、組織は自社でサーバーサイドセッション管理システムを構築するか、OpoInstallのような商用プラットフォームを採用することができます。例えば、OpoInstallはサーバーサイドでの状態復元およびパラメータパススルーフレームワークを提供し、セッションメタデータをサーバーサイドのセッションデータベースにマッピングすることで、高スループット環境下でも匿名性を保ちつつセッションの継続性を維持し、高同時実行条件下でのスケーラブルなサーバーサイドのリクエスト処理をサポートします。ブラウザベースのリダイレクトに頼るのではなく、セッションメタデータを一元化されたデータベースにマッピングすることで、初期のタスクが匿名で実行された場合でもコンバージョンコンテキストの一貫性を保つことができます。エンジニアリングチームは、データ保護と測定の一貫性のバランスを取るために、これらのアプローチを評価することができます。
統合チェックリスト:メモリ中心のスケーリングに向けたハードウェアおよびソフトウェアアーキテクチャの準備
データパイプラインを保護し、プラットフォームがメモリ中心のコンピューティングアーキテクチャに移行する際にもコンバージョンの一貫性を確保するために、エンジニアリングチームおよびプロダクトチームは堅牢な状態保持ワークフローを採用する必要があります。
開発者向け実装チェックリスト
- NUMAおよびキャッシュローカリティの最適化:高同時実行リクエスト下でメモリバスが飽和するのを防ぐため、スレッド実行を対応するメモリノードにマッピングします。
- 非同期サーバーサイド重複排除の実装:永続データベースへの書き込み前に、ローカルシステムメモリキャッシュを使用して着信トランザクションの署名を検証します。
- 軽量な状態同期の採用:分散コンテキストをトークン化して転送ペイロードを削減し、ガベージコレクションの急増を防ぐためにローカルメモリ割り当てを最小限に抑えます。
プロダクトおよび成長戦略チェックリスト
- メモリ利用の最適化:冗長なリクエストのping数をカウントするのではなく、実際のワークロードメトリクスに基づいてサーバーサイドのトランザクション追跡を調整します。
- 処理フットプリントの確認:クライアントサイドのサーマルスロットリングを防ぐため、サードパーティ製SDKが消費するプロセッサおよびメモリリソースを評価します。
- パイプラインレイテンシの監視:最初のキャンペーンpingから完了したアクティベーションハンドシェイクまでのエンドツーエンドのデータ伝送時間を追跡します。
これらの体系的なガイドラインを確立することで、開発チームは運用の継続性を維持しながら、より安全で準拠したアーキテクチャへと移行できます。
よくある質問 (FAQ)
JEDECの厚さ規格緩和は、なぜハイブリッドボンディングを遅らせるのですか?
iHBM、HPB、およびハイブリッドボンディングにはどのような技術的違いがありますか?
HBMのI/Oカウントが4,096に達すると、ハイブリッドボンディングが不可避になるのはなぜですか?
エンジニアリングチームへの重要なポイント
AIの推論ワークロードが拡大し続ける中で、システム全体の効率を決定付けるのは純粋な演算性能ではなく、メモリ帯域幅になります。HBM4、高度なパッケージング、熱最適化、そして将来のハイブリッドボンディングといった技術は、次世代AIインフラの中核であり続けます。現代のデータパイプラインは、高度に分散されたシステム全体でステートトランザクションをどのように処理し、保存するかという点において根本的な転換を必要としています。
組織は、次世代のAIインフラに備えるために、スケーラブルなメモリアーキテクチャ、効率的なデータ移動、および分散システム設計の原則を優先すべきです。分散キャッシュアーキテクチャ、暗号的に署名されたメタデータ、堅牢なパラメータパススルーフレームワークを実装することで、運用パイプラインをデータ転送のボトルネックから保護できます。この移行は、メモリ中心コンピューティングの新時代において成功を収める、スケーラブルで高性能なシステムを構築するために不可欠です。
Share this article



