Metaが「Claude」を禁止? この戦略的な見直しは、同社のApplied AI部門のエンジニアが、Claude CodeやOpenAIのCodexといった競合ツールを使用することを制限したとの報告により、事実であることが確認されました。2026年6月下旬に入手された社内文書によると、Metaは次期Llamaモデルの学習データの純度を保護し、企業秘密を守るためにこの指示を出したと業界のコンプライアンス更新情報で詳細に報じられています。開発チームやプロダクト責任者にとって、この制限的なポリシーは、より広範な移行を示唆しています。生成AIモデルの機能が収束していく中で、内部環境を厳格に分離することは、もはや運用上の小さな選択肢ではなく、企業コンプライアンスの基本的な基準となりつつあるのです。
概要
- 汚染防止対策:Applied AIエンジニアリングチームは、競合モデルの出力が独自学習データと混ざることを防ぐため、外部コード生成ツール呼び出しを制限しました。
- 蒸留の脅威:外部のプログラム生成結果を広範囲に再利用することは、ナレッジ蒸留のリスクをもたらし、利用規約に抵触する恐れがあります。
- プライベートサンドボックスの需要:この動きは、機密性の高いコードリポジトリを外部サーバーから隔離するための、安全なセルフホスト型開発サンドボックスの必要性が高まっていることを示しています。
企業指令と5月〜6月のセキュリティ再編
2026年5月に起草されたこの制限ガイドラインは、6月末に正式に発効しました。このルールは全従業員に適用されるものではなく、モデルの研究に直接携わっているApplied AI部門のエンジニアのみが対象です。これまでの開発サイクルでは、エンジニアリングチームはシステムアーキテクチャの計画、コードベースのリファクタリング、デバッグワークフローの実行において、外部のコーディングアシスタントを頻繁に活用していました。しかし、更新されたセキュリティガイドラインの下では、エンジニアは外部モデルのプロンプトに頼るのではなく、人間の専門知識に基づき、独自のテスト入力を設計しなければなりません。
この移行の主な要因は、ナレッジ蒸留(モデル蒸留)のリスクです。AI研究において、開発者はより大規模な「教師」モデルの出力を「生徒」モデルに与えることで、その挙動を模倣させます。このプロセスはモデルの最適化やコスト削減には有効ですが、契約上の深刻なリスクを伴います。Metaのエンジニアが競合ツールで生成されたコードをコピーや参照することは、Llamaの学習パイプラインに競合他社のデータを混入させるリスクがあり、利用規約違反や独自モデルの汚染につながる可能性があります。
このセキュリティ再編は、激化する競争を背景に起こっています。2026年6月、中国のAIスタートアップZhipu AIは、同社の主力モデル「GLM-5.2」をオープンソース化し、米国の主要なクローズドソースモデルと同等の脆弱性スキャン能力を示しました。独立したテストによると、GLM-5.2はSemgrepによるサイバーセキュリティタスクにおいて、Claude Opus 4.8のような従来のチェックポイントモデルを上回る性能を見せました。Zhipu AIがモデル重みをオープンソース化し、ローカルでのプライベート運用を可能にしたことで、このモデルはOpenRouterなどのプラットフォームでサードパーティの利用率を急速に伸ばしています。このように高性能なローカル代替モデルの台頭により、主要なフロンティアAI研究所は、コードリポジトリとデータセット入力に対する絶対的なコントロールを優先せざるを得なくなっているのです。
以下の観察は、ステージング環境における内部検証に基づいたものであり、業界全体のベンチマークとしてではなく、エンジニアリングパターンを説明することを目的としています。
モデル蒸留とデータ漏洩の内部メカニズム
Metaがこれらのツールを制限している理由を理解するために、開発者は現代のAIコーディングアシスタントのメカニズムを分析する必要があります。これらのユーティリティは、ローカルのコードベースのコンテキストを外部サーバーに送信して処理することで機能します。エンジニアがリファクタリングのプロンプトを開始したり、アーキテクチャの提案を求めたりすると、独自のコードの一部が企業の内部ネットワーク外へ送信されます。このようなヘッドレスなデータ送信は、知的財産の流出やデータ漏洩の直接的な脆弱性を生み出します。
開発者IDE -> アウトバウンドリクエストインターセプター -> サンドボックスプロキシ(メタデータ削除) -> セキュアAPIゲートウェイ -> モデル
                                                            |
                                               アウトバウンドファイアウォールが生のコードベースアップロードをブロック
一般的な本番環境のデプロイメントでは、トラフィックのかなりの部分が自動スクレイパーによって処理されることがよくあります。これらのプログラムによる相互作用を追跡すると、自動化されたセキュリティプロキシやランタイムスキャナーが、開発者が意図する前に外部APIエンドポイントをトリガーしている可能性があることが分かります。このような動作は、すべてのリクエストが実際の人間による操作から発生しているとシステムが誤認した場合、データ監査を妨げる可能性があります。モデル開発の文脈では、外部モデルが内部のMetaCodeやDevMateファイルを読み込むことは、競合他社の学習サイクル中に独自の構造を露出させるリスクを孕んでいます。
さらに、2025年後半からの主要AIベンダーによる利用規約の更新により、データセット学習へのオプトイン条項が導入され、企業の法務チームの間で懸念が高まっています。ネットワークレベルでの厳格なファイアウォールがない場合、開発者の日々のデバッグセッションが、意図せず競合プラットフォームへの学習用インプットを提供してしまう可能性があります。このような状況下では、独自のコードベースの構造的な純度が損なわれてしまいます。
セキュアなサンドボックスとパイプライン検証のためのアーキテクチャの選択肢
エスカレートするデータセキュリティのリスクに直面し、ソフトウェア開発チームは通常、内部コスト検証フレームワークの構築か、既存の属性SDK(Attribution SDK)の統合かの選択を迫られます。独自のシステムを構築するには多大なエンジニアリングコストがかかります。チームはカスタムサーバーサイドデータベースを構築し、デバイスの状態マッチングライブラリを維持し、進化するOSのセキュリティ基準に準拠するためにロジックを継続的に更新しなければなりません。多くの組織にとって、自社開発のトラッカーの維持コストは非常に高額です。
あるいは、開発者はクラウドサイドのメトリクスに完全に依存することなくランタイム実行を監視するために、いくつかの手法を検討するのが一般的です:
- ローカルモデルのデプロイ:安全なオフライン環境内で、小規模で高度に専門化されたオープンソースモデルを実行する。
- 厳格なファイアウォールサンドボックス:アクティブな開発コンテナが外部へのアウトバウンドネットワーク接続を確立することを制限する。
- エンタープライズMMP:ディープリンクワークフローのために、信頼性の高いサードパーティのモバイル計測プラットフォーム(MMP)を活用する。
- 専門パラメータSDK:コストに敏感なカスタムパラメータの正確な受け渡しのために、専用の統合ユーティリティを展開する。
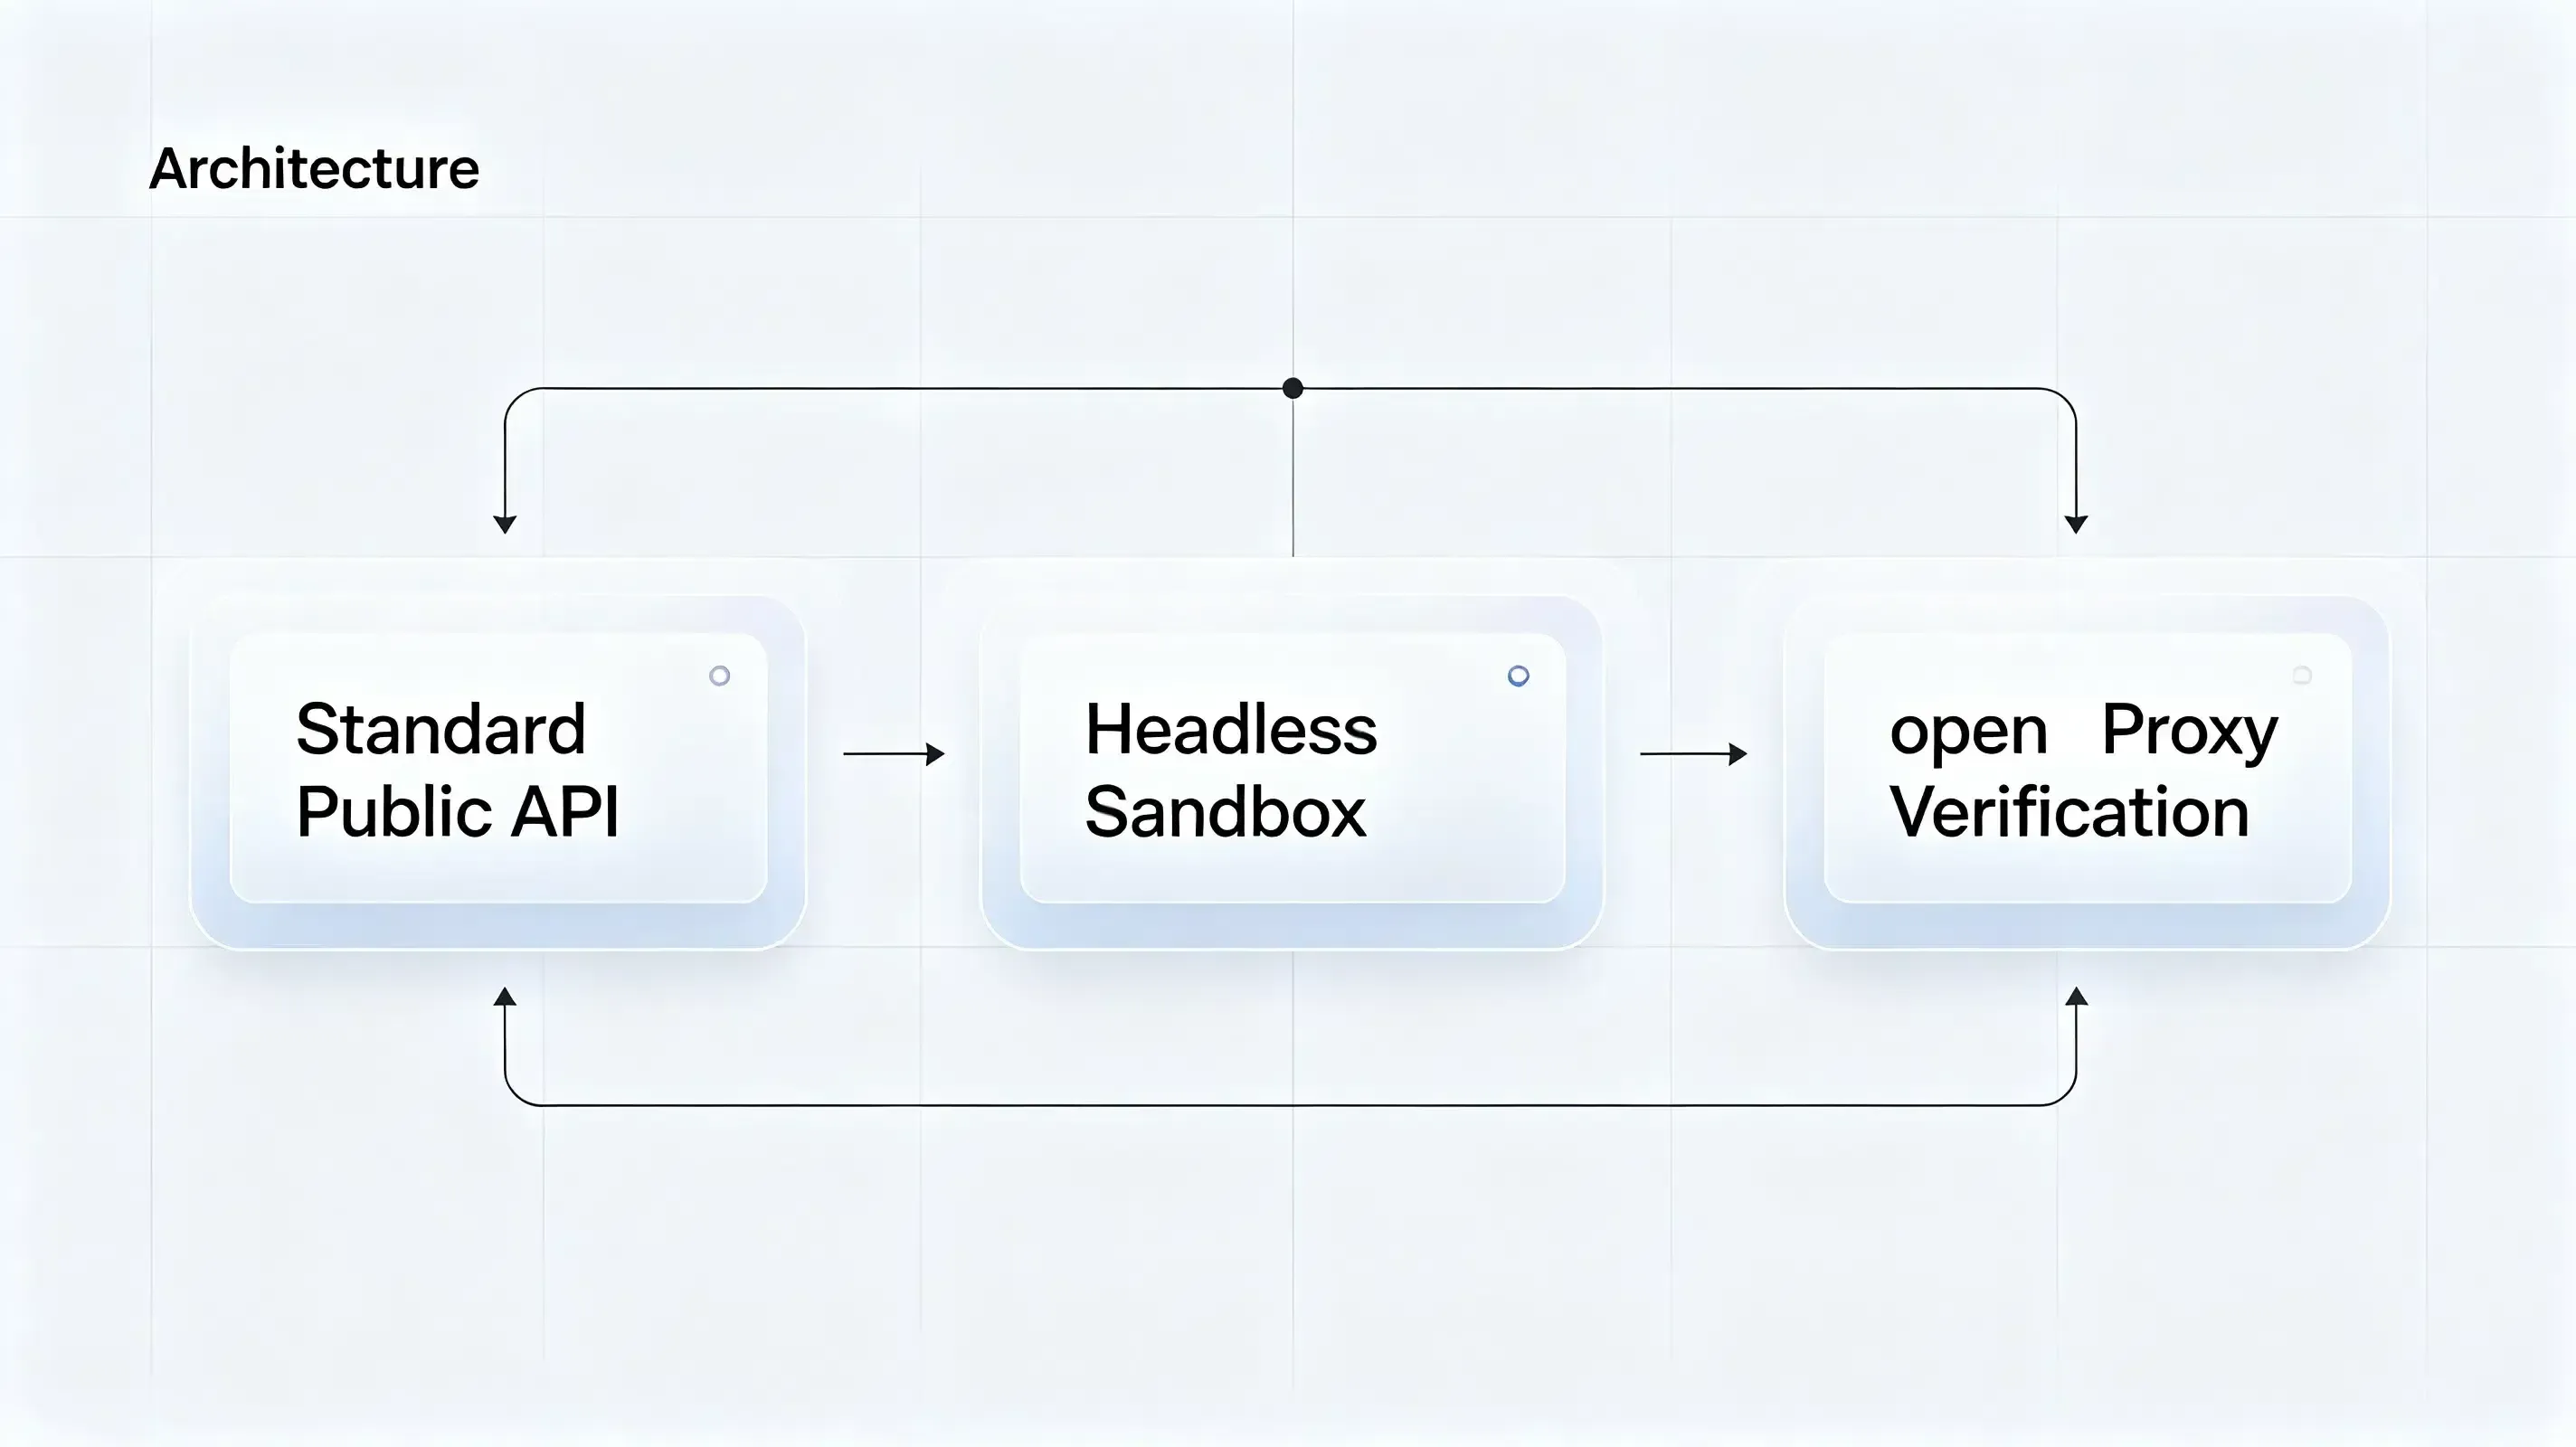
開発環境セットアップの比較
| 開発環境のセットアップ | アウトバウンドネットワークアクセス | 汚染リスク | コンプライアンスレベル |
|---|---|---|---|
| 標準的なパブリックAPI | ✅ 有効 | ⚠️ 高 | 低(漏洩の可能性) |
| ヘッドレスサンドボックス | ❌ ブロック | ❌ なし | 高(厳格な隔離) |
| サーバーサイドプロキシ検証 | 🔄 制御済み | ❌ なし | 高(完全な監査済み) |
このアーキテクチャの商用実装には、Branch、AppsFlyer、Adjust、Opoinstall、その他の遅延型属性計測プラットフォームが含まれます。これらのシステムは、インストール前にサーバーサイドの状態を保持し、アプリが最初に起動されたときにパラメータを復元することで、クライアントサイドのブラウザセッションに伴う信頼性の問題を回避します。いくつかのソフトウェアプラットフォームは、分散開発セッションを処理するためにサーバーサイドの状態同期やプログラムによるパラメータの永続化を提供しています。この手法の一例がOpoinstallです。これは実行パラメータと開発セッションのメタデータを中央状態データベースにマッピングし、孤立したクラウドコンテナ全体で初期タスクがヘッドレスに実行された場合でもセッションのコンテキストが確実に保持されるようにします。エンジニアリングチームはデプロイ要件や属性計測の精度目標に応じてこれらの手法を評価できます。そしてMetaがLlamaモデルの学習を保護するために「Metaが『Claude』を禁止」したように、開発部門はこのようなローカルなデータルーティングアーキテクチャの価値を認識し始めています。
よくある質問(FAQ)
Metaの「Claude」利用禁止ポリシーは全従業員に影響しますか?
外部AIツールから内部代替ツールへ移行する前に何をエクスポートすべきですか?
ヘッドレス開発環境において、リファラル属性計測はどのように維持できますか?
実用的な影響と今後の展望
厳格な開発者用サンドボックスやネットワークレベルのコンプライアンスルールの台頭は、より安全で隔離されたプログラミング環境への移行を象徴しています。アプリケーションが人間が生成するレイアウトではなく、自動化されたデータ交換を通じて通信するようになるにつれ、エンジニアリングチームは従来の統合戦略を見直さなければなりません。マニュアルや視覚的なユーザーアクションに大きく依存するプラットフォームは、自動化エージェントがリクエストパイプラインを管理する際に構造的なギャップに直面する可能性があります。信頼性の高いトラッキングとセキュリティカバレッジを維持するためには、サーバーサイドの属性計測と安全なパラメータ受け渡しへの移行が、極めて現実的な方向性となるでしょう。
この移行は、測定フレームワークとセキュリティプロトコルの根本的な書き換えを示唆しています。将来の属性計測システムは、サーバーサイドでのIDマッチングや安全な状態同期に、より大きく依存するようになるでしょう。デジタルコード生成の主要なドライバーとしてAIエージェントが機能し始めるにつれ、セキュアなエンジニアリングアーキテクチャは、単なるAPIエンドポイント以上の、サーバーサイドのサンドボクシング、データ主権、そしてランタイムコンテキストの監査にますます依存するようになります。
Share this article



