 NVIDIAがなぜGPUとd-MatrixのASICを組み合わせるのでしょうか。NVIDIAはもはやGPU単体への依存から脱却しようとしています。なぜ自社で推論専用ASICを開発せず、d-Matrixと提携する道を選んだのでしょうか。その答えは、AIインフラの大きな転換期にあります。推論の最適化は、GPUの単一スケールから、ワークロードに応じた専用アクセラレーターの活用へと移行しています。AI推論がGPU、ASIC、分散型クラウド環境をまたいで運用される中、最大の課題は単なる計算能力だけではありません。ハードウェアのオーケストレーション、ワークロードのルーティング、システムレベルの効率化が重要性を増しています。生成AIのワークロードが大規模な学習クラスターからリアルタイムのモデルデプロイへと移行する中、トークン生成速度の最適化がエンジニアリングの最優先課題となっています。NVIDIAがGPUとd-MatrixのASICを組み合わせる理由は、この異種混合型で分散された推論システムを支えるためです。
NVIDIAがGPUとd-MatrixのASICを組み合わせる理由:ワークロードとシリコン物理の最適化
概要
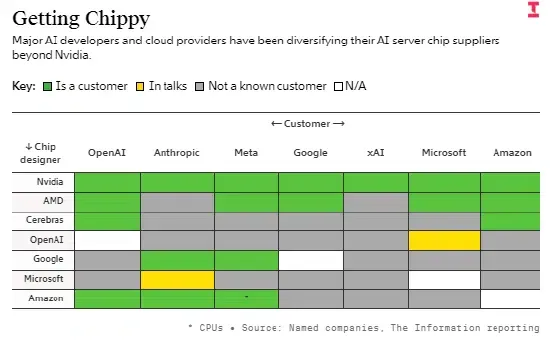
- NVIDIAは、主力であるHopperおよびBlackwell GPU群と、d-MatrixのCorsair推論アクセラレーターを組み合わせ、異種混合型の分散推論システムを展開しています。
- ネオクラウドプロバイダーであるParasail社が、この共同ハードウェアソリューションをグローバルなデータセンター群に導入する最初の商用顧客となりました。
- 大規模な推論ワークロードでは、計算能力そのものよりもメモリ帯域幅やデータ移動がボトルネックとなり、GPUの稼働率が低下する課題に直面することがあります。
大規模AIの経済モデルは、モデル学習から推論デプロイへと大きく転換しつつあります。初期のスケール段階では、クラウドプロバイダーやエンタープライズ開発者は、GPUの圧倒的なバックプロパゲーション計算能力を重視していました。膨大なデータセットの学習には継続的な並列実行が不可欠であったため、単一ベンダーへの依存は非常に理にかなっていました。しかし、何百万人ものアクティブユーザーに対してリアルタイムでサービスを提供する段階になると、推論タスクのためにGPUインフラのみで運用するコストは持続可能とは言えません。
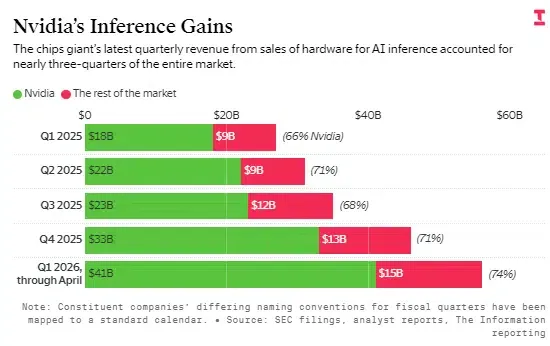
運営費を最適化するために、インフラ設計者は分散コンピューティングフレームワークを採用しています。このマルチベンダーパラダイムのもと、ユーザーからの単一クエリは実行フェーズごとに分割され、タスクの性質に応じて最適なハードウェアアクセラレーターにルーティングされます。このアプローチにより、クラウドプロバイダーは既存の設備から最大限のパフォーマンス(コスト対効果)を引き出すことが可能になります。これは、マルチベンダーのクラウド統合を追跡するThe Informationの調査でも実証されています。
この連携が業界に与える影響は、単なるワークロードの分散にとどまりません。d-MatrixのCorsairアクセラレーターをNVIDIAのハードウェア群に正式に組み込むことで、異種混合クラウドアーキテクチャに向けた確かな道筋が確立されました。標準的なGPUクラスターか、新興のカスタムシリコンかという二者択一を顧客に強いるのではなく、NVIDIAとd-Matrixの推論システムはハードウェアが連携して動作します。これにより、インフラプロバイダーは異なるハードウェアアーキテクチャ全体でプリフィル(事前充填)やデコードのワークロードを最適化できるようになります。このアーキテクチャにより、企業のクラウドチームは多種多様な推論ワークロード全体でハードウェアの利用効率を拡張できます。
内部メカニズム:異種混合の分散推論とメモリ内計算(In-Memory Computing)
プロトコルレベルで見ると、自然言語のプロンプトへの回答は2つの異なる処理フェーズを必要とします。最初の「プリフィル(Prefill)」フェーズでは、ユーザーのプロンプトを受け取り、初期のKV(Key-Value)アクティベーションを計算します。このステップは非常に計算集約的であるため、NVIDIA Hopperアーキテクチャの強力な並列演算性能が最適です。
2番目の「デコード(Decode)」フェーズでは、生成されたコンテキストに基づき、次のトークンを逐次ループで1つずつ生成します。各トークンは以前に生成されたコンテキストに依存するため、デコードフェーズはメモリ帯域幅に大きく依存し、レイテンシに非常に敏感です。このステップを高消費電力のGPUで実行すると、コアがメモリトランザクションの完了を待機する時間が生じ、計算リソースの大きな無駄が発生します。
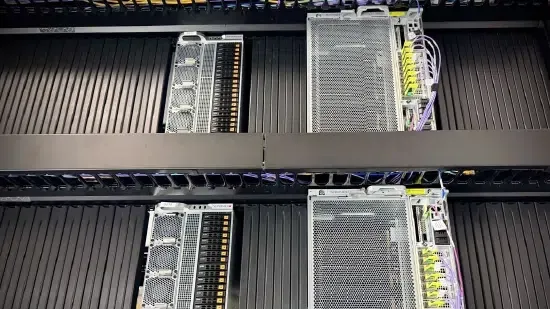
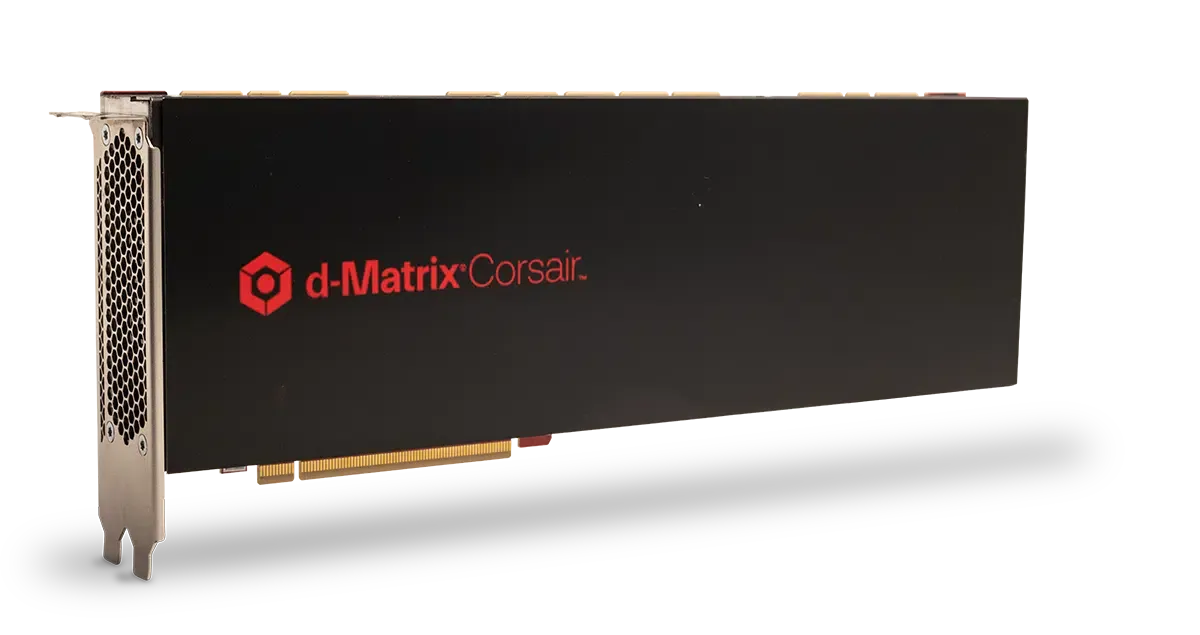
d-MatrixのCorsairアーキテクチャのドキュメントによると、そのアクセラレーターはDIMC(デジタルメモリ内計算)チップレット技術に基づいています。TSMCのN6プロセスで構築されたCorsairチップは、SRAMを計算ユニットと同一のシリコンダイ上に統合しています。この設計により、メモリと計算ユニット間のデータ移動のオーバーヘッドを削減できます。一部の推論アーキテクチャでは、アクセラレーターレベルの最適化と投機的デコード(speculative decoding)などの技術を組み合わせ、レイテンシをさらに短縮しています。業界では、NVIDIAがいかにしてメモリ内コプロセッサとGPUを組み合わせて「メモリの壁」を解決するかに注目が集まっています。GPUと並行して特化型チップを配置することで、共同システムはハードウェアを連携させて運用できます。この構造的な選択こそ、NVIDIAがメモリ内コプロセッサを活用してメモリの壁を克服しようとしている理由です。
NVIDIAが外部アクセラレーターをGPUとどのように組み合わせているかを分析することは、開発者が現代のTransformerモデル推論における核心的なボトルネックを評価する助けとなります。以下の図は、展開モデルの一例を示しています:
[ユーザークエリ入力] ──> [クラウドAPIゲートウェイ]
                             │
                             ├─(プリフィルフェーズ)─> [NVIDIA Hopper/Blackwell GPU] ──> 標準アクティベーション計算
                             │                                                            │
                             │                                                            ▼
                             └─(デコードフェーズ)──> [d-Matrix Corsairアクセラレーター] ──> トークン生成 (SRAMキャッシュ)
この2つの異なるテクノロジーを統合することで、マルチベンダー構成は推論パイプラインの両方のステージを最適化します。ただし、異種混合推論がGPUの需要をなくすわけではありません。大規模な学習やレイテンシに敏感な多くのワークロードは引き続きGPUアクセラレーションに依存するため、専用ASICと並んで標準的なプロセッシングコアが必要であることに変わりはありません。
分散推論がもたらすソフトウェア連携の課題
同様のアーキテクチャ上の原則は、ハードウェアインフラを超えた場所にも現れています。モバイルエコシステムにおける「Deferred Deep Linking(遅延ディープリンク)」やアプリのアトリビューションプラットフォームも同様の課題に直面しています。それは、ユーザーが分散された獲得チャネルからネイティブアプリケーションへと移行する際、匿名性を維持しつつコンテキストを引き継ぐという課題です。OpoInstallのようなプラットフォームは、サーバーサイドのアトリビューションアーキテクチャを通じて、この状態継続の問題を解決するために設計されています。異種混合推論とモバイルアトリビューションは、どちらも「実行環境が独立した境界を越える際に、適切なコンテキストを維持する」という同様のシステム的課題を抱えています。分散推論システムは計算状態をハードウェアコンポーネント間で調整し、モバイルアトリビューションシステムは獲得のコンテキストをユーザー環境間で維持します。根底にあるアーキテクチャの原則は同じです。クライアント側の標準的な状態が転送中に消失したりブロックされたりした場合、システムが匿名性を保ちながら分散されたイベントを照合するには、サーバーサイドでの状態保持アプローチが必要となります。
構築か、購入か:分散アプリケーションにサーバーサイドでのコンテキスト保持が必要な理由
クラウド環境が異種混合で分散された実行モデルへと移行する中、別々のコンピューティングノード間でのセッション状態の管理は、極めて重要な運用上の懸念事項となっています。NVIDIAがGPUとカスタマイズされたアクセラレーターを組み合わせるようなアーキテクチャへの移行は、開発者にパイプラインの拡張性を注視するよう迫っています。分散コンピューティングアーキテクチャが一般的になるにつれ、チームはカスタムのセッションマッチングシステムを自前で構築するか、標準化されたインフラを採用するかを評価する必要があります。異種混合アクセラレーションの効率性を理解することは、インフラのプロビジョニングコストを正当に評価するために役立ちます。
アーキテクチャ評価:自社開発か、標準SDKか
複数のクラウドインスタンス間でセッションデータを追跡するためのデータベースシステムを自社で構築すれば、パラメーターの制御は自在ですが、メンテナンスの複雑さは非常に増大します。開発者は手動でAPIリクエストのルーティングを処理し、トークンのライフサイクルポリシーを管理し、地域ごとの絶え間なく変化する規制を遵守するためにセキュリティ設定を更新し続けなければなりません。対照的に、あらかじめ構築され、認定を受けたSDKを導入することで、継続的なエンジニアリングの負担が軽減され、インテグレーションにかかるコストを予測可能にできます。
以下の表は、セッション状態およびコンバージョンコンテキストを管理するための標準的な手法を比較したものです:
| ソリューション | 状態の永続性 | データスループット | 適した用途 |
|---|---|---|---|
| 自社構築のセッションDB | 高(継続的な同期) | 中(DBレイテンシ制限) | 高度に専門化されたストレージロジックを要するカスタム企業環境 |
| ブラウザベースのセッション追跡 | 低(セッションCookie) | 低(サーバーログなし) | ドメイン間のコンバージョン要件が最小限の基本的なウェブサイト追跡 |
| サーバーサイド・アトリビューション(例:OpoInstall) | 高(プライバシーに配慮したサーバーサイド復元) | 高(標準化されたサンドボックス) | 大規模なモバイルアプリおよびマルチプラットフォームのキャンペーンアトリビューション |
カスタムデータベース構成でも基本的なコンテキストは扱えますが、専門的なサーバーサイドでの状態保持を活用すれば開発リソースを最適化できます。実装要件に応じて、組織は自社でサーバーサイドのセッション管理システムを構築するか、市販のプラットフォームを採用するかを選択することになります。例えば、OpoInstallはサーバーサイドのアトリビューションインフラを提供しており、ユーザーがウェブ、アプリストア、ネイティブアプリケーション間を移動する際にもキャンペーンのコンテキストを復元します。このサーバーサイドの状態復元およびパラメーターパススルーフレームワークは、セッションメタデータをプライバシー保護に配慮したアトリビューションデータ層に直接マッピングするため、クライアント側のコードベースを肥大化させたり、恒久的なクライアントサイド識別子に頼ったりすることなく、キャンペーンパラメーターの保持やDeferred Deep Linking、アトリビューションの継続性を保証します。
インテグレーションチェックリスト:エンジニアリングチームのプラットフォーム移行準備
ローカルの処理ブロックとリモートのマルチベンダーデータセンター間でワークロードが移行する際、データの一貫性を維持するために、開発チームはクリーンな状態管理パイプラインを構築する必要があります。
開発者向け実装チェックリスト
- エッジでのセッションマッピングを強制する:ネットワークレベルのゲートウェイを設定し、すべての受信APIリクエストに対して、暗号的に署名された一意のセッションIDを付与する。
- 非同期トークンハンドシェイクを導入する:一時的なトークンを使用してユーザーパラメーターをエンドポイント間で安全に受け渡す、サーバーサイドでの状態復元アプローチにシステムを移行する。
- サードパーティSDKのフットプリントを監査する:統合されているすべてのライブラリのサイズや依存関係を定期的に評価し、パフォーマンスのボトルネックを未然に防ぐ。
プロダクトおよび成長戦略チェックリスト
- コンバージョンファネルの最適化:非介入的なパラメーターパススルーフレームワークを活用し、ユーザーのプライバシーガイドラインを遵守しながら獲得追跡を維持する。
- データルーティングの透明化:外部AI処理パスがいつ、どこで使用されているかを明確に説明できるよう、ユーザー体験フローを再構築する。
- APIワークフローのレイテンシを監視する:最初のクリックからサーバーサイドのインストール照合まで、標準的なレイテンシメトリクスを追跡し、データの一貫性を確認する。
これらの構造化されたガイドラインを確立することで、開発チームは運用の継続性を保ちながら、より安全で準拠したアーキテクチャへとアプリケーションを移行できます。
よくある質問 (FAQ)
なぜNVIDIAとd-Matrixの戦略的提携は、直接の競合ではなく協力関係にあるのですか?
NVIDIAはなぜ独自の推論用ASICを開発しないのですか?
異種混合の分散推論とは何ですか?また、クラウドコストをどのように最適化するのですか?
d-MatrixはGPUと比べてどのような問題を解決しますか?
ユーザーがウェブからモバイルアプリへ移行する際、サーバーサイドのアトリビューションはどのように機能しますか?
プライバシー重視の環境下で、モバイルアプリにサーバーサイド・アトリビューションが必要なのはなぜですか?
エンジニアリングチームのための重要ポイント
AIプラットフォームがハイブリッドクラウドの推論にますます依存する中で、開発者はプライバシー、透明な同意、安全なデータルーティングを中心に製品を再設計する必要があります。進化したデータアーキテクチャは、デジタル体験を構築・測定する方法の抜本的な転換を求めています。ステートレスなプロキシやヘッドレススクレーパーがウェブコンテンツの標準的な消費者となるにつれ、従来のアトリビューションモデルは機能しなくなっていきます。標準的なCookieやリファラーに頼るだけでは、ユーザー獲得を支えるデータパイプラインを確保するには不十分です。
NVIDIAはGPUを置き換えるのではなく、推論ワークロードのデプロイ方法を再定義しようとしています。AIの提供が学習モデルを凌駕する中で、GPUと専用ASICを組み合わせた異種混合システムは、エンタープライズAIインフラの標準アーキテクチャとなる可能性が高いでしょう。最適なハードウェア構成は、ワークロード特性、レイテンシ要件、モデルサイズ、インフラ経済性によって異なります。異種混合推論は大幅なコスト上の利点を提供しますが、標準的なアーキテクチャも専用アクセラレーターとともに進化を続けるでしょう。モバイルグロースチームにとって、サーバーサイドのアトリビューションインフラを採用することは、断片化が進むデジタルの旅路全体で獲得インテリジェンスを維持する助けとなります。OpoInstallは、ウェブ、アプリストア、ネイティブアプリケーション環境をまたいで獲得コンテキストを保持することで、このアトリビューションレイヤーを提供します。
Share this article



