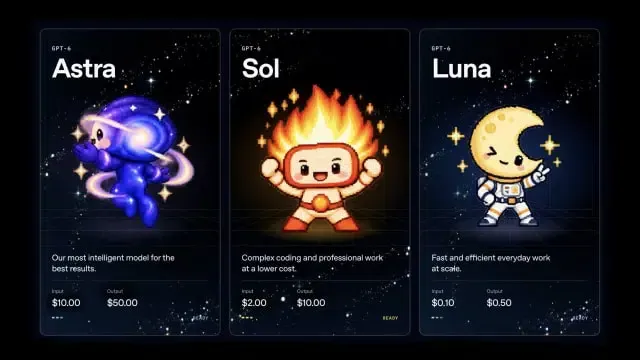
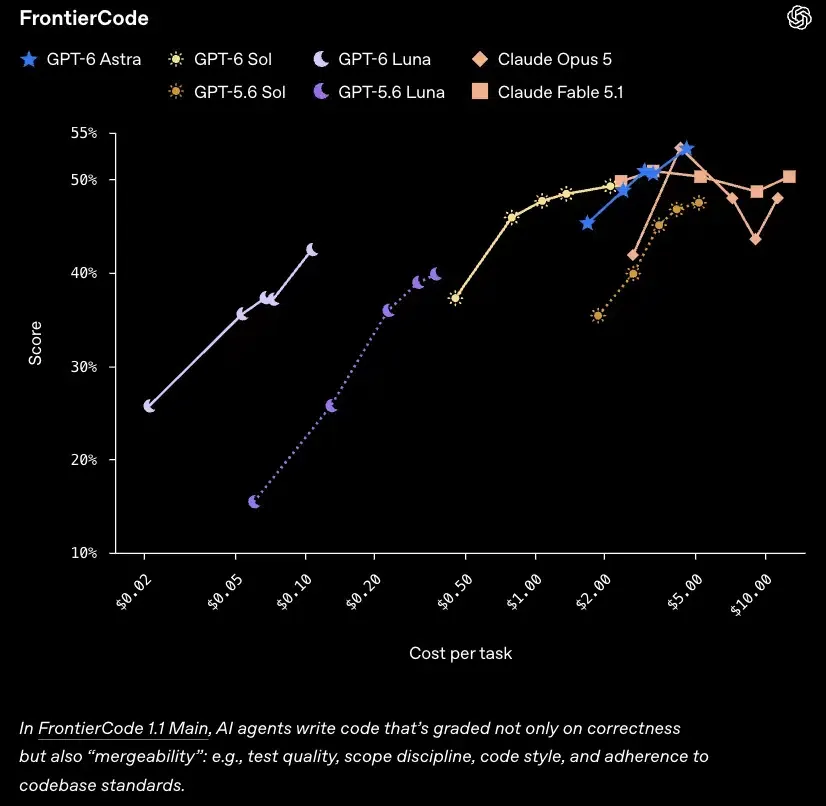
OpenAIがSol APIのコストを半減させました。OpenAIは2026年9月22日、「GPT-6 Sol」および「GPT-6 Luna」の商業提供を正式発表し、標準エンドポイントにおけるAPIトークンレートを従来のGPT-5.6のプロモーション価格と比較して50%以上引き下げました。最大272Kの入力トークンを持つプロンプトの標準処理において、GPT-6 Solは入力100万トークンあたり$2.00、出力100万トークンあたり$10.00に設定されており、小型のGPT-6 Lunaモデルは入力100万トークンあたり$0.10、出力あたり$0.50となっています。OpenAIが標準的な開発者ティア全体でSol APIのコストを半減させたことにより、構造的なコンピュートの低価格化は生成AIソフトウェアの運用制約を変化させています。ユニットプライシングの低下により、再帰的なエージェントループ、バックグラウンドでのバッチ抽出、自律的なマルチステップワーカーが、大規模な運用において経済的に現実的なものとなりました。しかし、システムアーキテクト、信頼性エンジニア、バックエンド開発者にとって、財務的摩擦の軽減は、下流のスケーラビリティ課題を表面化させ、エンジニアリングの焦点をトークンバ予算からレートリミットの境界、同時実行数の制限、テレメトリーパイプライン、バックプレッシャーのボトルネックへとシフトさせています。
運用上の課題と経済的ボトルネック
エンタープライズ向けLLM導入の初期段階を通じて、公称トークン料金は非公式なアーキテクチャ上のガバナーとして機能していました。高い推論コストのため、開発チームはモデルの呼び出しを個別のユーザー起因のトランザクションとして扱う必要がありました。アプリケーションは、人間の介入による承認、制限された会話履歴、厳しく制限されたスケジュール済みワーカーに大きく依存することで、月々のプロバイダー請求書を予測可能な範囲内に維持していました。ミドルティアモデルの恒久的な値下げの導入は、こうした従来のトレードオフに一石を投じ、システムエンジニアリングの関心をモデルの価格設定からバックエンドインフラストラクチャのレジリエンスへと移行させています。
概要
- ベースラインの価格引き下げ: 2026年9月22日、OpenAIは272Kトークンまでのプロンプトに対する標準処理向けとして、GPT-6 Solを入力$2.00 / 出力$10.00、GPT-6 Lunaを入力$0.10 / 出力$0.50(100万トークンあたり)で導入しました。これは、GPT-5.6のプロモーションAPI価格と比較して50%以上の名目上の引き下げとなります。
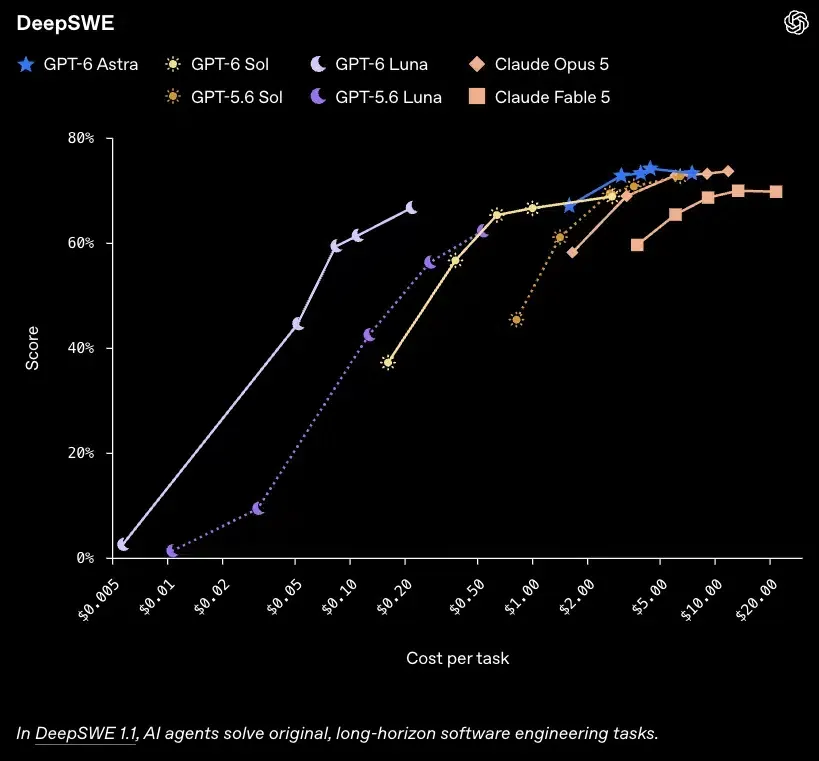
- タスクレベルのベンチマーク経済性: AutomationBench 1.0.6において、推論努力レベルを「xhigh」に設定したGPT-6 Solは、試行タスクあたりの平均コスト$0.27で33.2%のワークフロースコアを達成したとOpenAIは報告しており、開発者の評価軸を生のトークン価格から作業単位あたりのコストへと移行させています。
- プロンプトキャッシングのダイナミクス: プラットフォームは、キャッシュされた入力トークンの読み取りに対して自動的に90%の割引(基本入力トークンレートの0.1倍で請求)を提供します。一方、最初のキャッシュ書き込みは、キャッシュされていない入力トークンレートの1.25倍で請求されるため、動的なマルチステップの実行全体で高いキャッシュヒット率を維持するには、慎重なプレフィックスの正規化が必要です。
公式のOpenAI Developer API Pricing ReferenceおよびOpenAI Community Announcementに詳述されているように、これらの価格構造は、低レベルの推論パイプラインとKVキャッシュシステム全体の継続的な改善に起因しています。しかし、自動化されたタスクシーケンスを実行するコストが大幅に低下すると、エンジニアリングチームはバックグラウンドタスクのスコープを拡大します。これまでバックグラウンドワーカーによる継続的なポーリング、自動コードレビューパス、または多段階ドキュメント抽出パイプラインの実行を思いとどまらせていた経済的なハードルが低下したのです。
市場全体において、複数の基盤モデルプロバイダーが開発者ティア全体のAPI価格を引き下げまたは再構築しています。Anthropicは、Anthropic Claude Opus 5.5 Platform Specificationで更新された仕様とともにClaude Opus 5.5をリリースし、入力100万トークンあたり$4、キャッシュされた入力読み取り100万トークンあたり$0.20、出力100万トークンあたり$20を提示し、コードリファクタリングベンチマークにおけるトークン消費量の削減を強調しています。同時に、GoogleはGoogle AI for Developersに記載されているGemini 3.8 Flashのプロモーション用の導入価格を維持しており、XiaomiのMiMo-V2.6-Proなどのオープンウェイトリリースは、寛大なソフトウェアライセンスの下で自社ホスティングチームに積極的なトークンコストのオプションを提供しています。
モデルのコストが低下すると、開発の行動様式が変化します。エンジニアリングチームは、より深い再帰的ループをデプロイし、包括的なエンタープライズドキュメントをシステムプロンプトに注入し、複雑なタスクグラフ全体で自動リトライロジックを構成します。API層でのコスト削減として始まるものが、内部サービスに対するレイテンシやトラフィックの急増を引き起こす可能性があります。単一のユーザーのトランザクションに対して、オーケストレーションワーカーが数十回の順次または並列モデル呼び出しを発行する場合、内部データベースプール、補助ストレージクラスター、テレメトリーパイプライン、およびレートリミッターは、その結果生じる負荷を吸収しなければなりません。
システムの根本原因と非視覚的リクエストチェーン
クライアントアプリケーションが、対話型のチャットインターフェースから非視覚的なバックグラウンド自動化へと移行する場合、アップストリームのリクエストプロファイルは劇的に変化します。1つのビジネスイベントが、スキーマの検査、環境変数の評価、外部ツールの呼び出し、および複数の継続的なパスにわたる出力の検証を行う自律型パイプラインをトリガーする可能性があります。
+-----------------------------------------------------------------------------------------+
|                  RECURSIVE AGENT EXECUTION & BACKPRESSURE BOTTLENECK                    |
+-----------------------------------------------------------------------------------------+
|                                                                                         |
|  [ User Web / App Trigger ]                                                             |
|         |                                                                               |
|         v                                                                               |
|  [ Ingestion API Gateway ]                                                              |
|         |                                                                               |
|         +---> Spawns Autonomous Worker Instance                                         |
|         |                                                                               |
|         v                                                                               |
|  [ Autonomous Orchestration Loop (GPT-6 Sol / Luna) ]                                   |
|         |                                                                               |
|         +--- Step 1: Query Context (Cache Read) -----------------+                      |
|         |                                                        |                      |
|         +--- Step 2: Tool Execution (Uncached Call)              |                      |
|         |                                                        |                      |
|         +--- Step 3: Self-Correction Validation                  |                      |
|         |                                                        v                      |
|         +--- Step 4: Recursive Execution Fork ----> [ Bursting Internal RPCs ]          |
|                                                                  |                      |
|  [ Downstream System Bottlenecks ]                               |                      |
|         |                                                        |                      |
|         +--- Internal Microservices <-- (Connection Starvation) -+                      |
|         +--- PostgreSQL / Cache Stores <-- (Connection Pool Saturation)                 |
|         +--- Distributed Telemetry Stream <-- (Lossy Drop Buffer Applied)               |
|         +--- Audit Compliance Store <-- (Durable / Replayable Queue Lag)                |
|         +--- Upstream Provider Thresholds <-- (HTTP 429 Rate Limit Exhaustion)          |
|                                                                                         |
+-----------------------------------------------------------------------------------------+
再帰的エージェントの実行と同時実行数の乗算
従来の対話型Webシステムでは、リクエストのボリュームは人間のインタラクションのリズムを反映しています。各HTTPスレッドは通常、明示的なユーザーインタラクションにマッピングされ、ファンアウト全体が少なく、ペースは人間の思考時間によって制限されます。クライアントランタイムはペイロードを送信し、応答を待ち、後続のインタラクションを開始する前に一時停止します。
概念的なリクエストプロファイルの比較:対話型 vs. エージェント型
| アーキテクチャ指標 | 対話型ユーザーフロー | 自律型エージェントループ |
|---|---|---|
| 同時実行モデル | 人間のペースに合わせたリクエストのファンアウトは通常少ない | 1つの取り込みイベント = N個のチェインされた子呼び出し |
| 実行タイミング | ユーザーの応答と思考時間によってペース配分される | ポリシーの制限が介入するまで自動的に進行する |
| コンテキストの無効化 | セッションごとにフレッシュなペイロードを使用 | キャッシュされたコンテキストに強く依存する |
| エラー処理 | エラー時にユーザーがリトライする | 自動化されたプログラムによるリトライ |
| システムのボトルネック | フロントエンドゲートウェイの帯域幅 | 内部データベースプールの制限 |
| 障害のカスケード | 単一のセッションに限定される | キューの飽和を引き起こす可能性がある |
システムに自律型エージェントが統合されると、このペース配分は切り離されます。トリガーされた1つのイベントが、自動化された呼び出しの途切れないシーケンスを生成する可能性があります。エージェントが一時的なエラーや不正な形式のツール出力に遭遇した場合、単純なリトライロジックによって、バックエンドサービスに対して急速なリクエストのバーストが発生する可能性があります。トークンコストの削減により、長時間の実行が手頃な価格で行えるようになるため、自動化されたワークフローは、アクティブなユーザーベースが一定であっても、バックグラウンドのリクエストボリュームを大幅に拡大させる可能性があります。
プロンプトキャッシュのメカニズム:KVの再利用、書き込みのオーバーヘッド、プレフィックスの安定性
OpenAIは、SolおよびLunaのリリースに合わせて、プロンプトキャッシングサブシステム全体の最適化を行いました。OpenAI Prompt Caching Specificationに記載されているように、キャッシュされたプレフィックスと一致する入力トークンは、読み取り価格が90%割引されます。プロンプトキャッシングは、汎用的なネットワークペイロードの圧縮メカニズムとして機能するのではなく、主にモデル側の再計算を削減します。標準的なステートレスのインタラクションにおいて、クライアントアプリケーションはリクエストコンテキストを送信し、プロバイダーは一致するプレフィックスのKVテンソルの再計算をスキップするため、初回トークンまでのレイテンシと入力の課金が大幅に削減されます。
重要な点として、サーバー側のキャッシュに初期プレフィックスを書き込む際の費用は、キャッシュされていない入力トークンレートの1.25倍として請求されます。コスト効率を最大化するには、複数のクエリにわたってプレフィックスの安定性を維持する必要があります。
公開されている主要なAPI定価 — プロバイダー間で直接比較することはできません
| モデル識別子 | 入力 ($/100万Tok) | 出力 ($/100万Tok) | キャッシュ読み取りポリシー |
|---|---|---|---|
| OpenAI GPT-6 Luna (Std) | $0.10 | $0.50 | 90%割引 (0.10倍) |
| OpenAI GPT-6 Sol (Std) | $2.00 | $10.00 | 90%割引 (0.10倍) |
| OpenAI GPT-6 Astra (Std) | $10.00 | $50.00 | 動的階層価格設定 |
| Anthropic Opus 5.5 | $4.00 | $20.00 | $0.20/100万 読み取り (0.05倍) |
| Anthropic Sonnet 5 | $2.00 | $10.00 | キャッシュで最大90% |
| Google Gemini 3.8 Flash | $0.75 (導入) | $3.75 (導入) | $0.075/100万 キャッシュ読み取り |
| Xiaomi MiMo-V2.6-Pro | $0.435 | $0.87 | $0.0036/100万 キャッシュ読み取り |
注: 標準レートは、短コンテキストティア(OpenAIの場合は最大272K入力トークンのプロンプト)に適用されます。プロバイダーによって、キャッシュ書き込みのオーバーヘッド、コンテキスト制限、および期限付きのプロモーション条件が異なります。
プレフィックスを保持するには、API構成オプションの慎重なハンドリングが必要です。OpenAIのAPIアーキテクチャでは、推論の努力レベルパラメータを直接変更したり、ツール定義の配列を変更したりすると、レンダリングされるプロンプトプレフィックスが変化し、以前のキャッシュ状態が無効になります。
マルチターンセッション中にキャッシュされたコンテキストを保持するため、開発者はツールスキーマとベースライン指示を一貫した順序で維持する必要があります。実行時の調整が必要な場合は、ツール定義の配列を直接変更するのではなく、構造化されたセッションコントロール(configuration_updateなど)を介してパラメータを更新するか、tool_choiceやallowed_toolsを使用してツールの実行を切り替える必要があります。
キャッシュミスが発生した場合、アッププロバイダーは90%の読み取り割引なしで入力シーケンスを再処理します。大規模運用においては、これにより推論レイテンシとタイムアウトのプレッシャーが増大する可能性があります。VentureBeatによるGPT-6 SolおよびLunaベンチマークの報道で見られるように、マルチステップのタスク実行では、コスト評価は単純なトークンの乗数から完了したタスクの支出へと移行し、GPT-6 SolはAutomationBench 1.0.6で試行タスクあたり平均$0.27で33.2%のスコアを達成しています。
テレメトリーアーキテクチャ:運用メトリクスとコンプライアンス監査の切り離し
自動化されたLLMリクエストの急増は、バックエンドのオブザーバビリティ(可観測性)とコンプライアンスパイプラインに大きな負担をかけます。高同時実行のエージェントワークフローでは、運用テレメトリーと法的な監査証跡との間に明確なアーキテクチャ上の分離が必要です。
企業のコンプライアンスポリシーでは、多くの場合、セッションメタデータ、ツールの実行証明、およびトランザクションレコードの記録が義務付けられています。運用テレメトリーとコンプライアンスデータを同一に扱うと、重大なエンジニアリング上のトレードオフが生じます。
- コンプライアンスおよびセキュリティ監査チャネル: 明示的なリトライ、永続性、障害処理を備えた、変更不可で再生可能な配信を、書き込み1回・アクセス制御された監査ストアに対して提供する必要があります。ペイロードは、構造化されたメタデータ、呼び出し元の身元、暗号学的状態をキャプチャすると同時に、個人特定情報(PII)やシークレットキーを体系的にサニタイズする必要があります。高負荷時には、これらのパイプラインはレコードを破棄するのではなく、バックプレッシャーを適用するか、タスクを永続的にキューイングする必要があります。
- 運用テレメトリーチャネル: トークン数、プロンプトキャッシュのヒット率、アップストリームの応答レイテンシなどのパフォーマンス指標を追跡します。これらのトレースはリアルタイムのモニタリングとデバッグに使用されるため、境界のある損失性ドロップバッファを通じて処理することができます。下流のコレクターの処理が遅くなった場合、アプリケーションは過剰な運用テレメトリーを安全に破棄して、コアサービスの可用性を維持することができます。
外部プロバイダーがHTTP 429レートリミットエラーを返した際、不適切に構成されたリトライポリシーは深刻な運用上の問題を引き起こす可能性があります。ランダム化されたジッター(揺らぎ)のない即時リトライや同期された指数バックオフルーチンは、中間マイクロサービスを介してカスケードする可能性のあるリトライの波を生み出し、スレッドプールやデータベース接続を消費します。
ソリューションの比較:内製と外部調達のトレードオフ
推論コストの低下から生じる運用負荷を管理するため、組織はAIゲートウェイおよびプロキシのアーキテクチャを評価する必要があります。チームは、カスタムのルーティング、レートリミット、およびテレメトリープロキシを自社開発するか、専門のサードパーティインフラストラクチャをデプロイするかを決定する必要があります。
+-----------------------------------------------------------------------------------------+
|                 SYSTEM RESILIENCY PIPELINE WITH DECOUPLED TELEMETRY                     |
+-----------------------------------------------------------------------------------------+
|                                                                                         |
|  [ Inbound Application Requests ]                                                       |
|         |                                                                               |
|         v                                                                               |
|  [ Sliding-Window Rate Limiter ] <--- Local In-Memory or Distributed Cache              |
|         |                                                                               |
|         +---> Rejects / Delays Excess Concurrency (HTTP 429 Protection)                 |
|         |                                                                               |
|         v                                                                               |
|  [ Prompt Normalization & Cache Alignment Engine ]                                      |
|         |                                                                               |
|         +---> Pins Static System Prompts & Tool Definitions to Base Prefix              |
|         +---> Uses Structured Controls to Modify Session Parameters                     |
|         |                                                                               |
|         v                                                                               |
|  [ Upstream Provider Dispatch (OpenAI / Anthropic / Local API) ]                         |
|         |                                                                               |
|         +---------------------------------------+---------------------------------------+
|         |                                       |                                       |
|         v (Synchronous Fast Path)               |                                       |
|  [ Client Response Assembly ]                   |                                       |
|         |                                       v (Asynchronous Dual Path)              |
|         v                               +-----------------------------------------------+
|  [ Return Payload to App ]              |                                               |
|                                         v (Lossy Ring Buffer)   v (Durable Outbox)      |
|                                    [ Operational Metrics ]  [ Compliance Audit Store ]  |
|                                    (Drops on Congestion)    (Durable / Replayable)      |
|                                                                                         |
+-----------------------------------------------------------------------------------------+
カスタム自社製レジリエンスパイプライン
カスタムインフラストラクチャの開発により、エンジニアリングチームはネットワーキングポリシー、データのサニタイズ、ルーティング戦略を完全に制御できるようになります。組織は、正確な内部マイクロサービスのトポロジに合わせたエッジプロキシを構築できます。
// リファレンス実装:端数剰余と制限された飽和を持つ同期型トークンバケット
package com.example.ai.resilience;

import java.math.BigInteger;
import java.time.Duration;

public final class TokenBucketLimiter {
    private final long maxTokenCapacity;
    private final long refillPeriodNanos;
    private long availableTokens;
    private long lastRefillNanos;
    // 範囲 [0, refillPeriodNanos) におけるスケーリングされた剰余分子
    private long scaledRemainder;

    public TokenBucketLimiter(long maxTokens, Duration refillPeriod) {
        if (maxTokens <= 0 || refillPeriod.isZero() || refillPeriod.isNegative()) {
            throw new IllegalArgumentException("TokenBucketLimiterの境界設定が無効です。");
        }
        this.maxTokenCapacity = maxTokens;
        this.refillPeriodNanos = refillPeriod.toNanos();
        this.availableTokens = maxTokens;
        this.lastRefillNanos = System.nanoTime();
        this.scaledRemainder = 0L;
    }

    public synchronized boolean tryAcquire(long requestedUnits) {
        if (requestedUnits <= 0) {
            return false;
        }
        refillTokens();
        if (requestedUnits > availableTokens) {
            return false;
        }
        availableTokens -= requestedUnits;
        return true;
    }

    private void refillTokens() {
        long nowNanos = System.nanoTime();
        long elapsedNanos = nowNanos - lastRefillNanos;

        if (elapsedNanos <= 0) {
            return;
        }

        // ベースラインのタイムスタンプを単調増加させる
        this.lastRefillNanos = nowNanos;

        // バケットがすでに満杯の場合は、タイミングのズレを防ぐために消費されていない端数クレジットを破棄する
        if (this.availableTokens >= this.maxTokenCapacity) {
            this.scaledRemainder = 0L;
            return;
        }

        long wholePeriods = elapsedNanos / refillPeriodNanos;
        long remElapsedNanos = elapsedNanos % refillPeriodNanos;

        // 高速パス:少なくとも1つの完全な期間が経過している場合、バケットは容量まで完全に補充されます。
        // これにより、乗算オーバフローサーフェス(wholePeriods * maxTokenCapacity)が排除されます。
        if (wholePeriods > 0) {
            this.availableTokens = maxTokenCapacity;
            this.scaledRemainder = 0L;
            return;
        }

        // サブ期間のマイクロ間隔において、BigInteger演算を使用して正確な端数トークンを計算する
        BigInteger bigRemNanos = BigInteger.valueOf(remElapsedNanos);
        BigInteger bigCapacity = BigInteger.valueOf(maxTokenCapacity);
        BigInteger bigRemainder = BigInteger.valueOf(scaledRemainder);
        BigInteger bigPeriod = BigInteger.valueOf(refillPeriodNanos);

        // totalWork = (remElapsedNanos * maxTokenCapacity) + scaledRemainder
        BigInteger totalWork = bigRemNanos.multiply(bigCapacity).add(bigRemainder);
        BigInteger[] divAndRem = totalWork.divideAndRemainder(bigPeriod);

        long tokensGenerated = divAndRem[0].longValue();
        this.scaledRemainder = divAndRem[1].longValue();

        if (tokensGenerated > 0) {
            long spaceLeft = maxTokenCapacity - availableTokens;
            if (tokensGenerated >= spaceLeft) {
                this.availableTokens = maxTokenCapacity;
                this.scaledRemainder = 0L;
            } else {
                this.availableTokens += tokensGenerated;
            }
        }
    }
}
しかし、内製開発には継続的なエンジニアリングのメンテナンスが必要です。チームはプロバイダーのAPIアップデートへの手動適応、複数のベンダーにわたる進化するレートリミットの処理、分散テレメトリーキューの管理を行う必要があります。このメンテナンスのオーバーヘッドにより、内部の開発リソースがコアプロダクトの機能から逸らされる可能性があります。
商用ゲートウェイとインフラストラクチャツール
これらの機能をゼロから構築することを避けるため、多くの企業がマネージドAPIプロキシ、LLMゲートウェイ、およびエッジコントロールプレーンをデプロイしています。マネージドゲートウェイの中には、プロバイダーを認識したレートリミットの協調、オブザーバビリティ、ポリシーコントロール、キャッシュを認識したルーティングを提供するものもあります。正確な機能はベンダーによって異なり、プレフィックスの最適化には通常、アプリケーションレベルでのリクエストの規律が依然として必要となります。
商用プラットフォームを使用することで、エンジニアリングチームは環境ごとのコストクォータの強制、モデルファミリ間での自動フォールバックルーティングの構成、リクエストメタデータのログ記録前の機密顧客情報の除去を行うことができます。目的に特化したゲートウェイは、同時実行数の急増を管理し、APIの消費動向を監査し、複雑なアプリケーション環境全体で下流のマイクロサービスを保護します。
決定マトリックス:内製パイプライン vs. マネージドプラットフォーム
| 評価基準 | 内製レジリエンスツール | マネージドルーティングインフラストラクチャ |
|---|---|---|
| 初期開発工数 | 高(3〜6エンジニアリング週) | 低(標準API経由で統合) |
| プロトコルメンテナンス | チームによる継続的な責任 | ベンダーのアップデートにより処理される |
| 運用制御 | スタック全体の可視性 | ベンダーインターフェースによって制限される |
| プロンプトキャッシュチューニング | カスタムプロキシが必要 | ベンダー依存。通常はアプリケーションの協力が必要 |
| テレメトリーの分離 | カスタムキュー管理 | ベンダー依存 |
| 財務コストプロファイル | エンジニアリングの人件費オーバーヘッド | 定期的なSaaS / 従量制料金 |
統合チェックリストとガバナンススケジュール
GPT-6 SolおよびLunaの価格引き下げに続いてモデルの利用を拡大している組織は、システム的な過負荷を防ぐために、この運用フレームワークを使用できます。
+-----------------------------------------------------------------------------------------+
|                  ENTERPRISE LLM INFRASTRUCTURE READINESS CHECKLIST                      |
+-----------------------------------------------------------------------------------------+
| [ ] Audit client applications to identify unbounded recursive model calling loops       |
| [ ] Set hard timeout limits and non-linear retry backoffs with randomized jitter        |
| [ ] Implement local and edge token-bucket rate limiters ahead of upstream calls          |
| [ ] Organize prompt structures to maximize prompt caching prefix reuse                   |
| [ ] Separate lossy operational telemetry from durable, replayable audit trails           |
| [ ] Add runtime sampling to strip raw prompt bodies from high-frequency traces          |
| [ ] Monitor HTTP 429 status trends and set automated backpressure triggers              |
| [ ] Configure cost alerts and circuit breakers to catch runaway automated jobs          |
+-----------------------------------------------------------------------------------------+
テレメトリーパイプラインの構成
オブザーバビリティシステムは、プロンプトのロギングをリアルタイムのリクエストパスから切り離す必要があります。高頻度のエージェントワークフローを処理する場合、アプリケーションはテレメトリーメタデータをメモリバウンドの非同期キューに書き込むべきであり、下流のテレメトリーコレクターの処理が遅くなった場合のI/Oの停止を防ぎます。
// リファレンス実装:損失性ロードシェディングを備えたメモリバウンドのテレメトリーロガー
package com.example.ai.resilience;

import java.util.concurrent.ArrayBlockingQueue;
import java.util.concurrent.BlockingQueue;
import java.util.concurrent.atomic.AtomicLong;

public final class BoundedTelemetryQueue {
    public static final class LogPayload {
        public final String traceId;
        public final String modelId;
        public final long promptTokens;
        public final long completionTokens;
        public final boolean cacheHit;

        public LogPayload(String traceId, String modelId, long pTokens, long cTokens, boolean hit) {
            this.traceId = traceId;
            this.modelId = modelId;
            this.promptTokens = pTokens;
            this.completionTokens = cTokens;
            this.cacheHit = hit;
        }
    }

    private final BlockingQueue<LogPayload> internalQueue;
    private final AtomicLong droppedEvents = new AtomicLong(0);

    public BoundedTelemetryQueue(int maxQueueCapacity) {
        if (maxQueueCapacity <= 0) {
            throw new IllegalArgumentException("キューの容量は正の値である必要があります。");
        }
        this.internalQueue = new ArrayBlockingQueue<>(maxQueueCapacity);
    }

    public boolean recordEvent(LogPayload payload) {
        if (payload == null) {
            return false;
        }
        // 非ブロッキング送信:アプリの安定性を維持するために高負荷時にテレメトリーをドロップする
        boolean accepted = internalQueue.offer(payload);
        if (!accepted) {
            droppedEvents.incrementAndGet();
        }
        return accepted;
    }

    public LogPayload pollEvent() {
        return internalQueue.poll();
    }

    public long getDroppedEventCount() {
        return droppedEvents.get();
    }
}
よくある質問 (FAQ)
GPT-6 SolおよびLunaの公式APIレートはいくらですか?
プロンプトキャッシングは、長時間の会話においてどのようにコストを削減しますか?
なぜトークン安がバックエンドの運用リスクを高めるのですか?
エンジニアリングチームへの重要なポイント
GPT-6 SolとLunaの発表は、より広いトレンドを加速させています。フロンティアインテリジェンスはより安価になり、よりアクセスしやすくなっています。ユニットトークンのコストが急激に低下するにつれて、財政的制約はソフトウェアアーキテクチャの効果的な制御メカニズムではなくなります。
組織が高頻度エージェントやマルチティアモデルトポロジを採用するにつれて、運用エンジニアリングが企業の成功にとって不可欠となります。チームは、モデルを名目上のトークン価格やベンチマークスコアのみで評価する段階から脱却する必要があります。長期的な信頼性は、システムが同時実行性をどれほど効果的に管理し、キャッシュ再利用のためにプロンプトコンテキストを整合させ、アップストリームのレートリミットを正常に処理し、クリティカルなアプリケーションパスからテレメトリーを切り離すかどうかにかかっています。レジリエントなインフラストラクチャを構築する組織は、アプリケーションの稼働時間やシステムの安定性を犠牲にすることなく、自動化されたエージェントワークフローを成功裏にスケールさせることができます。
一次情報および参照ドキュメント
-
OpenAI Developer API Pricing Reference: GPT-6 Sol、Luna、Astraの公式開発者レートカード、コンテキストウィンドウの制約(≤272K標準閾値)、キャッシュの読み取り/書き込み価格スケジュール。
-
OpenAI Community Announcement: GPT-5.6のプロモーションティアに対する50%のベースライン価格引き下げと、マイルストーンのロールアウト詳細を確認する一般向け開示情報。
-
OpenAI Prompt Caching Specification: サーバー側のKey-Valueプレフィックスの再利用、キャッシュ書き込みのオーバーヘッド、および構成無効化ルールに関するアーキテクチャドキュメント。
-
Anthropic Claude Opus 5.5 Platform Specification: 入力$4 / 出力$20 / キャッシュ読み取りトークンレート$0.20およびベンチマークパフォーマンスを確認する公式リリース仕様。
-
Anthropic Claude Sonnet 5 Overview: 公式開発者レートカードとプロンプトキャッシング効率指標(入力$2 / 出力$10 / キャッシュ割引最大90%)。
-
Google AI for Developers Rate Card: Gemini 3.8 Flashの開発者レートカードと導入価格ポリシーの概要。
-
Xiaomi MiMo Official API Pricing & Rate Schedule: MiMo-V2.6-Pro推論の標準的な海外向け従量制トークンレート(入力$0.435 / 出力$0.87 / キャッシュヒット$0.0036)。
-
VentureBeat Reporting on GPT-6 Sol and Luna Benchmarks: リリースの経済性、永続的な価格保証、AutomationBench 1.0.6のタスクコスト数値(試行タスクあたり$0.27)に関する報道。
Share this article



