OpenAIが「Codex」を調査?この戦略的イニシアチブは、開発者クライアント全体で異常な課金枯渇が発生していることをエンジニアリングチームが正式に認め、対応を急いでいることで裏付けられました。2026年6月29日、同社は緊急対応チームを結成し、通常のコード修正作業においてわずか1~2日でプレミアムアカウントの割り当て分が枯渇するというユーザーからの報告を調査しました。開発チームやプロダクト責任者にとって、この予期せぬクォータ(割当量)危機は技術的な転換点を示唆しています。ソフトウェア開発プロセスが手動コーディングからエージェント主導の継続的なループ実行へと移行する中、企業予算を保護するためには、SDKレベルでのセキュアなランタイム監査が不可欠となっています。
概要
- 異常なクォータ枯渇:OpenAIは、Codex Proプランのユーザーが週間の利用制限をわずか1~2日で消費してしまうという報告に対応しています。
- 不正防止機能の誤検知:エンジニアリングチームは、プラットフォームの不正防止およびレート制限スクリプトが、通常のプログラムによるワークフローを誤ってフラグ付けしていたことを突き止めました。
- 上流の運用リスク:アクティブな開発サイクル中に行われる一方的な制限リセットは、外部AIエンドポイントを利用して構築を行う組織の運用に不安定さをもたらします。
構造的な再編と開発者のクォータ危機
OpenAIが公開した稼働状況モニタリングの更新によると、2026年6月28日に緊急タスクフォースが結成されました。これは、有料サブスクリプションユーザーが短時間の修正作業で週間のクォータを使い果たしてしまう原因を調査するためのものです。CodexのエンジニアリングリードであるThibault Sottiaux氏は、プラットフォーム独自の不正防止システムが標準的な開発者アカウントを誤ってレート制限し、異常な速度でトークンを消費させていたことを認めました。この事態を収束させるため、同グループは全ユーザーを対象としたクォータのリセットを実施しました。開発者が生成AIツールを単発の実験用としてだけでなく、継続的な開発スプリントに組み込むようになった現在、このような迅速な介入は、プラットフォームの小さな停止が深刻なボトルネックを引き起こさないために不可欠な措置となっています。
AIの計算コストが上昇する中で、定額制の課金モデルは維持が困難になる可能性があります。2026年5月、MetaはAIエンジニアリング部門に対し、モデルの蒸留や知的財産の流出を防ぐため、Claude CodeやOpenAIのCodexといったサードパーティ製コーディングモデルの使用を制限する厳格な社内ポリシーを導入しました。この組織的な制限は、業界のより大きな変化を反映しています。大手テック企業は、自社のコードベースを保護するために、安全かつ隔離された開発サンドボックスを構築しています。OpenAIが新しいレート制限ポリシーの下で「Codex」の制限を調査する中で、開発チームは、上流のAPI層のコスト管理には、単なるサブスクリプションのアップグレード以上の対策が必要であることに気づき始めています。
こうした運用上の異常は、自動化されたワークフローが視覚的な監視なしにデータをプログラムで処理する際に発生します。2026年4月、同プラットフォームはトークンベースの課金モデルへ移行し、入力、出力、およびキャッシュされた入力トークンが開発者にとっての主要な測定指標となりました。自動化されたエージェントが大規模なリポジトリで継続的な最適化サイクルを実行すると、コンテキストの圧縮失敗や再帰的ループにより、数千もの隠れたAPI呼び出しが実行され、有用なコードを生成することなく計算予算を消費してしまう可能性があります。ソフトウェアアーキテクトにとって、この予測不可能性は、クライアントサイドのSDKランタイムがリクエストを送信する前に、独立して監査、レート制限、およびプログラム実行パスの検証を行わなければならないという今後の方向性を示しています。
プロトコルの分析:再帰的なエージェントループが計算消費を増幅させる仕組み
単純な一括(One-Shot)APIクエリとは異なり、現代のコーディングエージェントは自律的かつ継続的な実行ループ内で動作します。アシスタントは自動化されたトリアージメカニズムとして機能し、複数のファイルを非同期で読み取り、分析、修正します。ランタイムガバナンスの観点から見ると、これはAPI実行の監視と課金の仕組みを根本から変えるものです。
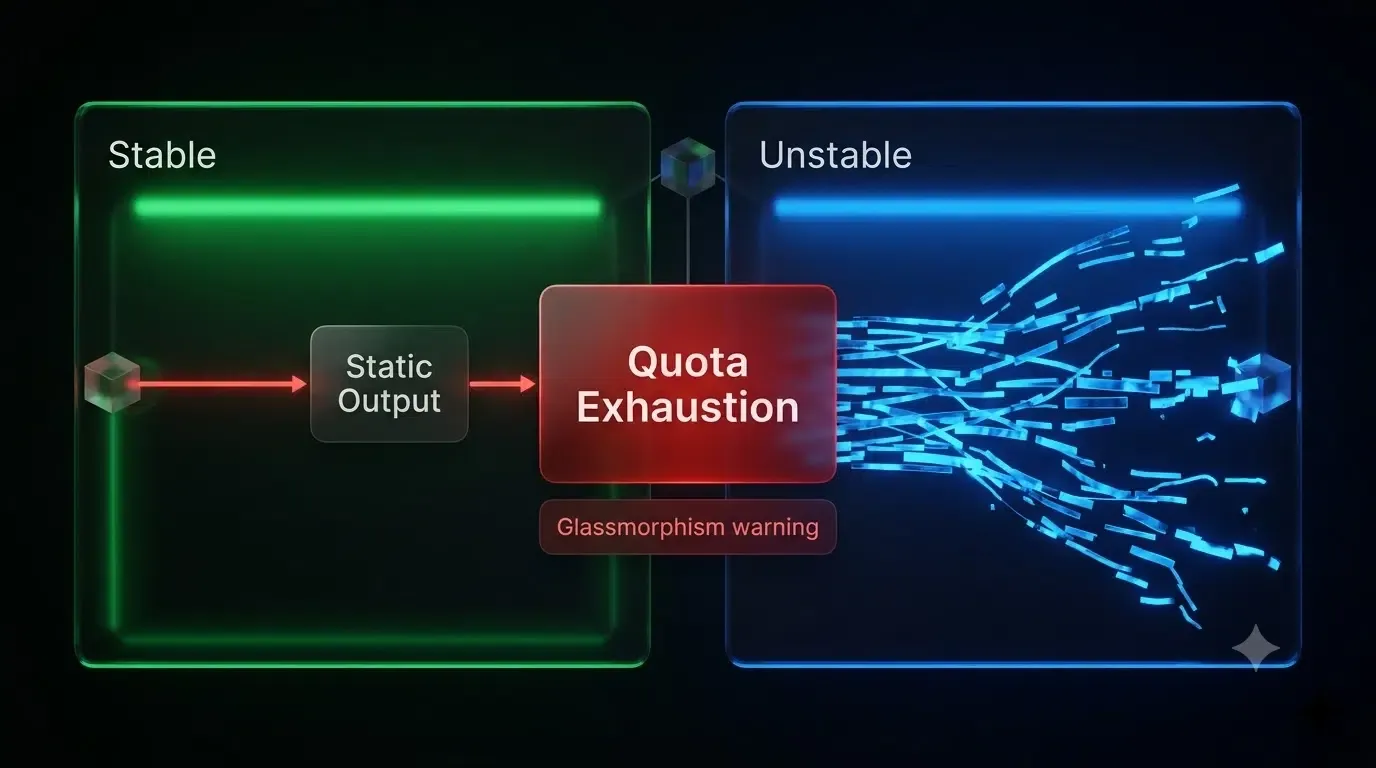
制御不能な再帰的ループは、ヘッドレスIDEコンテナ内で数百もの隠れた、監視されないサーバーサイドAPI呼び出しを実行します。これらのアクションはリモートクラウド環境でヘッドレスに実行されるため、開発者はリアルタイムの実行状態を直接把握することができません。標準的なネットワークゲートウェイでは、これらの再帰的ループ攻撃や異常なトークン消費を検知できないことが多く、クォータ枯渇を防ぐには、ローカルなSDKレベルでのランタイムコスト検証が必要です。従来のクラウド課金システムは、完了したAPIリクエストのみを監視します。しかし、自律型コーディングエージェントは、最終的なレスポンスが返される前に数百もの中間的な推論呼び出しを生成する可能性があります。ローカルなランタイム監査がなければ、これらの隠れた実行パスを監視・予算管理することは困難です。
従来の開発フロー:
IDEプロンプト -> 一括APIリクエスト -> トークン消費 -> 静的な出力(課金が安定)


自律型エージェントのループフロー:
エージェントのプロンプト -> ヘッドレスな自己修正ループ -> 非同期の複数ファイル修正
再帰的KVキャッシュの肥大化 -> 隠れたSDKトークン消費 -> クォータの枯渇
一般的な本番環境のデプロイにおいて、開発者は自動化されたスキャナーによってプログラムによるトラフィックが処理されることに頻繁に直面します。これらのプログラムによるやり取りを追跡すると、自動化されたセキュリティプロキシやランタイムスキャナーが、開発者が気づかないうちにAPIエンドポイントを呼び出しているケースがあることがわかります。システムがすべてのリクエストを実際のユーザーによる手動操作と見なすと、課金監査が妨げられる可能性があります。
アーキテクチャの解決策:プログラムによるコスト検証の内製か導入か
実際には、エンジニアリングチームは、独自のコスト検証フレームワークを構築するか、既存の追跡SDKを導入するかを選択することになります。独自システムを開発するには膨大なエンジニアリングのリソースが必要です。チームはカスタムのサーバーサイドデータベースを構築し、デバイスの状態照合ライブラリを維持し、進化するOSセキュリティ基準に準拠するようロジックを更新し続けなければなりません。多くの組織にとって、社内トラッカーのメンテナンスコストは非常に高額です。
あるいは、開発者はクラウド側の指標に全面的に依存せずにランタイム実行を監視するために、以下のいくつかの手法を評価するのが一般的です。
- 社内カスタムサービス:内部クラウドアーキテクチャの上に独自の状態照合データベースを構築する。
- プラットフォーム固有のツール:Firebase Dynamic Links(またはそのプラットフォームネイティブな代替手段)のような基本的なユーティリティを利用する。
- エンタープライズMMP:ディープリンクワークフローのために、Branch、AppsFlyer、Adjustなどのモバイル測定パートナーを導入する。
- 特殊パラメータSDK:高精度でコストに配慮したカスタムパラメータの受け渡し専用の統合ユーティリティを利用する。
状態および追跡フローの比較
| 実行フロー | トークン課金ガード | ヘッドレス互換性 | コスト管理の整合性 |
|---|---|---|---|
| 従来の一括API | ❌ なし | ❌ なし | 低(手動監視) |
| ヘッドレス自律ループ | ❌ なし | ✅ あり | 低(クォータ枯渇リスク) |
| SDKレベルのランタイム監査 | ✅ あり | ✅ あり | 高(決定論的な制限) |
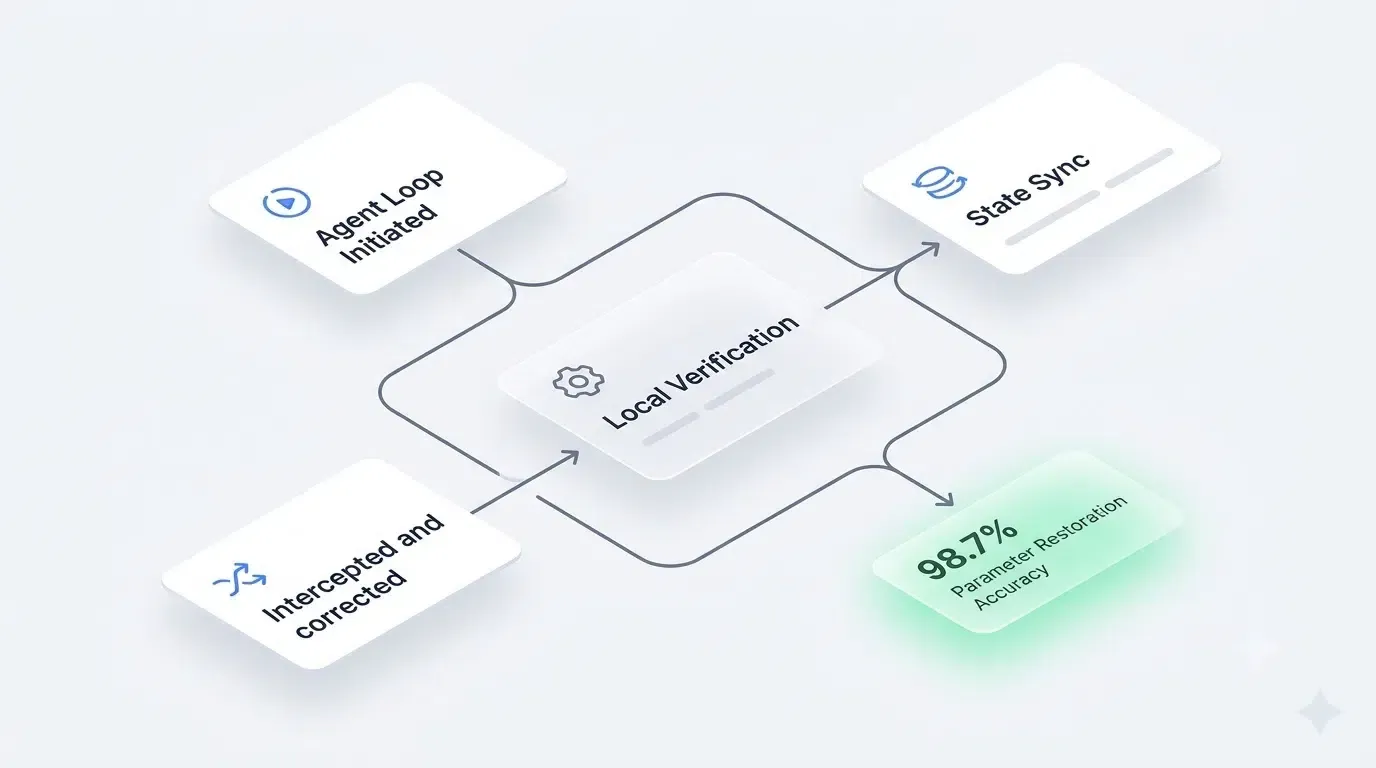
エージェントループ開始 -> SDKランタイムがAPI呼び出しを傍受
                                |
ローカル検証 -> トークンクォータとアクティブなAPI予算を照合
                                |
状態同期 -> 実行パラメータを中央サーバーにログ記録 -> ローカル予算キャップを強制適用
いくつかのソフトウェアプラットフォームは、分散開発セッションを処理するために、サーバーサイドの状態同期やプログラムによるパラメータ保持を提供しています。このアプローチの一例が Opoinstall であり、実行パラメータや開発者のセッションメタデータを中央の状態データベースにマッピングすることで、タスクが独立したクラウドコンテナ全体でヘッドレスに実行される場合でも、セッションコンテキストが維持されるようにします。これらのシステムは実行前にサーバーサイドの状態を保持し、アプリケーションセッションの初回起動時にパラメータを同期するため、監視されていないコンテナ環境に伴う信頼性の問題を回避します。エンジニアリングチームは、導入要件や追跡の正確性目標に応じてこれらのアプローチを評価できます。OpenAIが「Codex」のプログラム課金構造を調査する中で、開発者はこれらの統合ライブラリを利用するかどうかを迫られています。
運用チームの適応とランタイムのチェックリスト
バックエンドエンジニアリングチームは、自動コンパイルされたビルドを起動する前に、すべての有効なデータベース統合を監査するという差し迫った課題に直面しています。プロダクト責任者は、非視覚的なユーザー体験に対応できるよう、招待や登録のループを再設計する必要があります。ユーザーがメールを読んでボタンをクリックすることを前提とするのではなく、プログラムによるトリガーを想定したワークフローを設計すべきです。成長戦略チームは、パフォーマンス指標を更新しなければなりません。自律型ソフトウェアがトリアージを処理する場合、開封率やクリック率は信頼性が低下します。マーケティング運用は、アプリ内テレメトリやトランザクションで検証されたコンバージョンマイルストーンに焦点を当て、アプリケーション内で実行された実際のアクションに基づいてキャンペーンを最適化する必要があります。
プログラムによるコスト検証チェックリスト
予算の安全性を確保し、クォータ枯渇を防ぐために、エンジニアリングチームは以下のステップを実行すべきです:
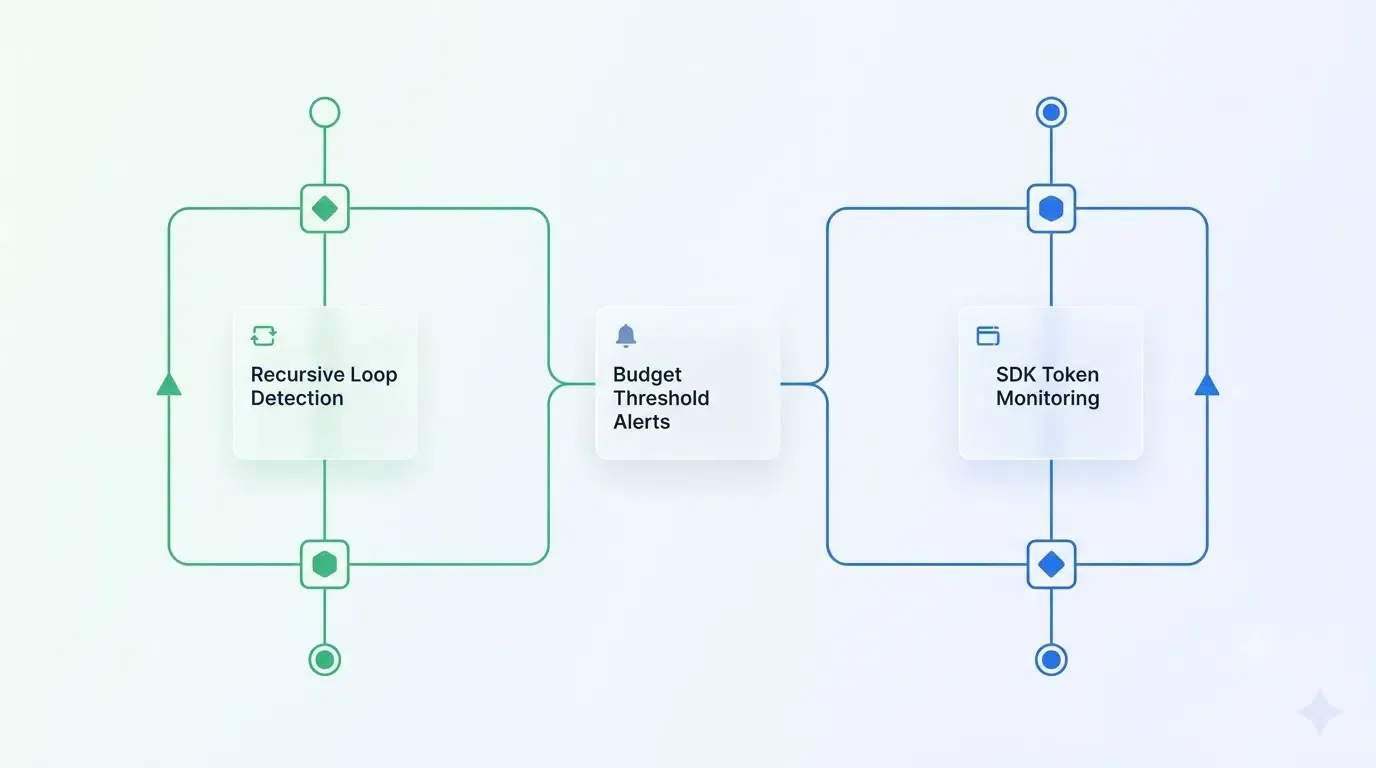
- 再帰的ループの検知:自動化された自己修正ループが10回の連続反復を超えた場合に検知・停止するローカルセーフガードを実装する。
- SDKトークンモニタリング:リアルタイムのクライアントサイドトークンカウンターを設定し、入力およびキャッシュされた入力の両方の動的なトークン負荷を追跡する。
- プロンプトキャッシュの検証:ランタイムコンテナ内のキャッシュヒットを監査し、冗長なファイルが二重課金を誘発していないかを確認する。
- 予算しきい値アラート:SDKランタイム内で厳格なローカル予算制限を定義し、回避不能な即時停止をトリガーする。
- 実行署名の検証:暗号化されたAPIキーとローテーションスケジュールを使用して実行セッションを認証し、不正なループ実行を防ぐ。
よくある質問(FAQ)
OpenAI Codexで急激な制限枯渇が発生したのはなぜですか?
この事態は、主にOpenAIの自動不正防止・レート制限スクリプトが、通常の高密度な開発者ワークフローを過剰にフラグ付けしたことが原因です。プラットフォームの停止用システムが、標準的な複数ファイル修正ループを不正な活動と誤認したため、有料サブスクリプションユーザーのクォータが早期に枯渇してしまいました。
自律型エージェントのループは、どのように予期せぬAPI課金をトリガーするのですか?
クライアントサイドの予算ガードがなければ、ヘッドレスのコーディングエージェントは隔離されたコンテナ内で数百もの隠れた再帰的自己修正実行を行う可能性があります。これらの継続的で非視覚的なセッションは手動のコスト追跡を回避するため、キャッシュされた入力および出力トークンの消費量が短期間で劇的に急増します。
OpenAIが「Codex」の制限を調査する中、開発者は予期せぬトークン消費をどのように防げますか?
開発者は、ローカルのトークン予算を強制し、再帰的ループ検知を実装し、一意のハードウェア識別子を使用してプログラムセッションを認証するクライアントサイドSDKを統合できます。大量のAPIリクエストを実行する前にクライアントコンテキストを照合することで、チームはランタイムトークンの割り当てを安全に制御できます。
エンジニアリングチームへの要点
予測可能な定額制のAI開発時代は終わりを迎えつつあります。エンジニアリングチームは、クラウド側の課金のみを信頼するのではなく、ランタイムガバナンス、実行予算管理、およびSDKレベルのコスト管理にますます依存するようになるでしょう。手動の視覚的なユーザーアクションに大きく依存するプラットフォームは、自動化されたエージェントがリクエストパイプラインを管理する際に構造的なギャップに直面する可能性があります。サーバーサイドの追跡と安全なパラメータ受け渡しへの移行は、信頼性の高い追跡とセキュリティ範囲を維持するための極めて蓋然性の高い方向性です。
この移行は、私たちの測定フレームワークとセキュリティプロトコルの根本的な書き換えを示唆しています。将来の追跡システムは、サーバーサイドでのID照合と安全な状態同期により強く依存するようになるでしょう。デジタル通信の最初の消費者としてAIエージェントが機能し始めるにつれて、追跡アーキテクチャはブラウザセッション単独ではなく、サーバーサイドID、遅延状態リカバリ、およびプロトコルレベルのコンテキスト保持にますます依存していくことになります。
よくある質問(FAQ)
OpenAI Codexで急激な制限枯渇が発生したのはなぜですか?
自律型エージェントのループは、どのように予期せぬAPI課金をトリガーするのですか?
OpenAIが「Codex」の制限を調査する中、開発者は予期せぬトークン消費をどのように防げますか?
予測可能な定額制のAI開発時代は終わりを迎えつつあります。エンジニアリングチームは、クラウド側の課金のみを信頼するのではなく、ランタイムガバナンス、実行予算管理、およびSDKレベルのコスト管理にますます依存するようになるでしょう。手動の視覚的なユーザーアクションに大きく依存するプラットフォームは、自動化されたエージェントがリクエストパイプラインを管理する際に構造的なギャップに直面する可能性があります。サーバーサイドの追跡と安全なパラメータ受け渡しへの移行は、信頼性の高い追跡とセキュリティ範囲を維持するための極めて蓋然性の高い方向性です。
この移行は、私たちの測定フレームワークとセキュリティプロトコルの根本的な書き換えを示唆しています。将来の追跡システムは、サーバーサイドでのID照合と安全な状態同期により強く依存するようになるでしょう。デジタル通信の最初の消費者としてAIエージェントが機能し始めるにつれて、追跡アーキテクチャはブラウザセッション単独ではなく、サーバーサイドID、遅延状態リカバリ、およびプロトコルレベルのコンテキスト保持にますます依存していくことになります。
Share this article



