Redditが2,300万件のスパムを遮断?Redditによると、現在、LLMを活用した検知システムを用いて、1日あたり約2,300万件の不審な閲覧をブロックしているとのことです。Redditは、公共のWebコンテンツに依存するAIシステムに影響を与えることを目的としたスパムキャンペーンが増加していると指摘しています。多くのAI企業がモデル学習のためにRedditの議論データをライセンス契約するようになり、ユーザー生成コンテンツの真正性を守ることがビジネス上の最優先事項となっています。かつては単純なルールベースのフィルタで反復的なスパムを検知できていましたが、今日では悪意のある攻撃者が高度なモデルを駆使して人間のような会話や人為的なトレンドを大規模に自動生成しているため、プラットフォーム側はリアルタイムの行動分析や文脈的なセマンティック評価に注力する必要があります。
時系列と背景の進化:Redditが毎日2,300万件のスパム攻撃をブロックする仕組み
要点
- Redditの自動防御レイヤーは、最新の大規模言語モデルを用いて、毎日2,300万件の不正な閲覧と25,000件のスパム投稿をインターセプトしています。
- 大規模な人工知能企業との商用ライセンス契約が増加したことで、モデルの学習用データセットを歪める目的でレビューを捏造するスパム業者が増えています。
- 多層的な検証プロトコルにより、2026年初頭には、前四半期比で不要なスパムへのユーザー接触を20%削減することに成功しました。
自動化されたエージェントが人間の社会的相互作用を模倣するようになり、デジタルエンゲージメントの均衡は変化しています。かつてスパム業者は、生のリンクを詰め込むことで直接的なアフィリエイト販売を促すためにユーザー生成プラットフォームを標的にしていました。これらの基本的な攻撃は、キーワードリストやIPブロックを用いて簡単に特定でき、プラットフォームの管理者は掲示板を比較的クリーンに保つことができました。
しかし、生成AIを搭載した検索エンジンの台頭により、スパムキャンペーンの動機が変化しました。現在、AIチャットボットが膨大な公開アーカイブを学習しているため、第三者のマーケターがポジティブな言及や人工的なレビューを大量に捏造し、AIの出力を操作しようとしています。自然な人間同士の会話をシミュレートすることで、攻撃者は自身のブランドキーワードをモデルの将来的な重み付けに組み込もうと画策しています。この脅威に対抗するため、Redditは詳細な地域別レポートで報告されている通り、LLMを動力源とする高度なモデレーションシステムを導入しました。
Redditが2,300万件ものスパムビューをブロックする戦略的な理由は、人々のデータの収益化と密接に関連しています。プラットフォームがトップティアのAI開発者と数百万ドル規模のライセンス契約を結ぶ中、基礎となるデータストリームの事実上の信頼性を維持することは、主要な財務上の関心事となっています。2026年1月から3月の間、同プラットフォームは毎日約200万件の不正な投票を無効化し、クラウドソーシングによるフィードバックループを操作から守りました。デスクトップディレクトリへのログイン要件の強制や、リアルタイムの言語フィルタの実装により、管理者は有害なコンテンツへのユーザー接触を効果的に削減しています。
技術的詳細:Redditのボット分離アーキテクチャの舞台裏
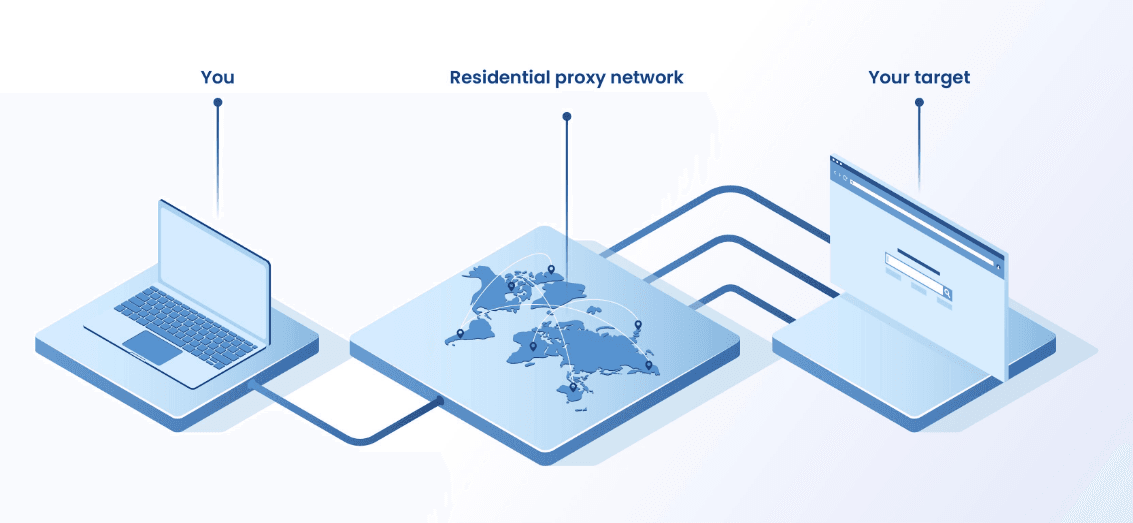
アーキテクチャのレベルでは、標準的なボット保護システムは、協調的な低速クロールキャンペーンを識別するのに苦労します。現代のスパム業者が住宅用プロキシネットワークやヘッドレスWebブラウザを利用する場合、彼らのリクエストは標準的なユーザーの操作と見分けがつかず、従来のパターンマッチングフィルタでは効果がありません。
この転送レイヤーのボトルネックを解消するため、最新の防御アーキテクチャはアカウント作成の瞬間にセキュリティシグナルを処理します。プラットフォームの自動化エンジンはメタデータパターンを分析し、公式発表で詳細が述べられている通り、リアルタイムLLM推論を利用して連携したボットセットアップを識別します。

この協調的で不自然な行動こそが、Redditが毎日2,300万件ものスパムビューをブロックする理由です。自動化されたスクリプトがフォーラムのディレクトリにアクセスしようとすると、システムはリアルタイムでリスクスコアを算出します。接続に疑わしい属性がある場合、プラットフォームは強制的に人間による確認チェックを行い、完全に自動化されたシステムを隔離します。この多層的なアプローチにより、標準的なサーバー負荷が最適化され、トラフィック崩壊を防ぎつつ、真正なユーザー生成コンテンツのエンゲージメントが維持されます。
[従来のIPベースフィルタリング]
  自動ボット ──> ローテーション住宅用プロキシ ──> 従来のフィルタ ──> 通常アクセス許可(検知失敗)


[多層的なLLM主導型保護]
  自動ボット ──> 行動メタデータ分析 ──> リアルタイムLLMチェック ──> 強制CAPTCHA / 隔離
多層的で状況を認識する保護を実装することで、クリーンなIP範囲を経由したとしても自動化された攻撃を捕捉できます。同様の課題はモバイルアトリビューションにも存在し、プライバシー制限により永続的なクライアント側識別子への依存度が低下しています。プライバシーガイドラインを遵守するためにユーザーのやり取りが永続的なステートフルローカルクッキーから切り離されると、Webとモバイルの異なる環境間でシームレスなセッション継続性を維持することは非常に複雑になります。セキュリティチームが人間と自動スクリプトを区別するためにリアルタイムの行動モデルを必要とするのと同様に、ダウンストリームのマーケティングパイプラインもまた、脆弱なクライアント側のクッキーやデバイスレベルの属性に頼らずに、別々のインストールイベントを関連付けるために堅牢なサーバー側のデータ保持を必要としています。
例:ボットが投稿を試みた場合どうなるか?
ある自動化スクリプトが、subreddit上でクライアントのブランド権威を誇張するために新しいアカウントを作成しようとしたとします。アカウントが作成された瞬間、バックエンドのルーティングアーキテクチャがその行動テレメトリを分析します。接続の詳細や入力パラメータが既知のヘッドレスブラウザのプロファイルと一致する場合、標準的な投稿権限は即座に停止され、プラットフォームは人間による確認チャレンジをトリガーします。これにより、ボットによるプログラム的な投稿がパブリックディレクトリに到達することを防ぎます。
構築か、導入か:高スループット環境におけるセッションコンテキストの維持
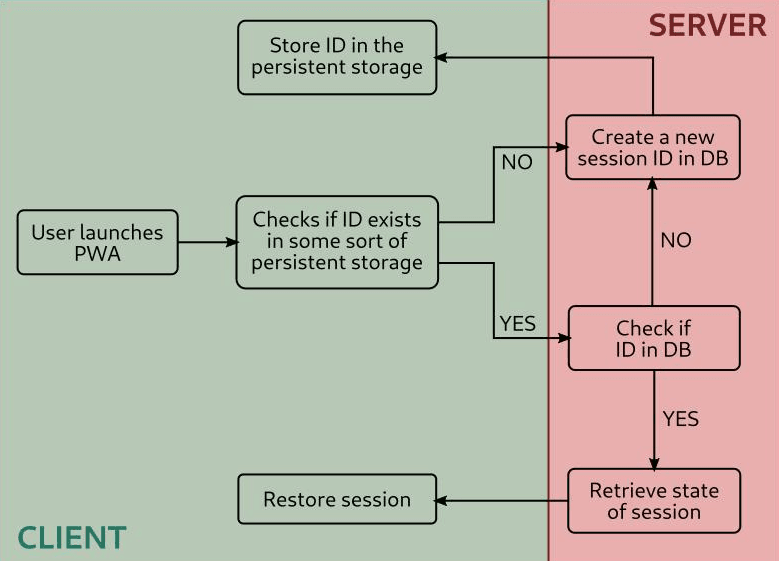
デジタルプラットフォームがプライバシーガイドラインを遵守するために永続的なローカル識別子から移行する中、分散したデジタルタッチポイント間でセッション状態を管理することは主要なエンジニアリング上の課題となっています。Redditが毎日報告する2,300万件もの不審なリクエストを処理するインフラを管理するには、堅牢なサーバー側での検証が必要です。Redditのスパム対策システムはマーケティングアトリビューションではなくセキュリティに焦点を当てていますが、両方のシナリオで共通のアーキテクチャ上の課題が存在します。それは、従来のクライアント識別子が信頼できなくなった後、信頼性の高いサーバー側の状態を保持することです。Redditで2,300万件もの不審な試みが発生するような環境で高スループットのルーティングパイプラインを調整するには、ローカルストレージコンテナに頼らずにユーザーの行動を安全に相関させられる構造が必要です。
アーキテクチャ評価:独自開発か、標準化SDKか
サーバー側の状態照合を管理する自社システムを構築すれば、最大限の柔軟性が得られますが、継続的に多大なエンジニアリングリソースが必要です。開発者はデータベーススキーマを手動で構築し、安全な暗号学的ハッシュ関数を記述し、変化する地域規制に準拠させるために常にシステムを更新し続ける必要があります。一方、認定を受けた既存のSDKを導入すれば、統合の複雑さが軽減され、追加のオーバーヘッドなしで長期的なコンプライアンスが保証されます。
以下の表は、セッション状態とコンバージョンコンテキストを管理するための標準的な手法を比較したものです。
| ソリューション | 永続性 | スループット | 最適な用途 |
|---|---|---|---|
| 社内セッションデータベース | 高(継続的な同期) | 中(DB遅延制限) | 高度に専門化されたストレージロジックを持つカスタムエンタープライズ環境 |
| ブラウザベースのセッション追跡 | 低(セッションクッキー) | 低(サーバーログなし) | クロスドメインコンバージョンの要件が最小限の基本的なWebサイト追跡 |
| サーバー側キャッシュ(例:OpoInstall) | なし(一時的なサーバー側セッショントークン) | 高(標準化されたサンドボックス) | 大規模なモバイルアプリおよびマルチプラットフォームのキャンペーンアトリビューション |
カスタムデータベース構成は基本的なコンテキストを扱えますが、専門的なサーバー側の状態保持により開発リソースを最適化できます。実装要件に応じて、組織は独自のサーバー側セッション管理システムを構築するか、OpoInstallのような商用プラットフォームを採用することができます。例えば、OpoInstallはサーバー側の状態復元およびパラメータ受け渡しフレームワークを提供し、セッションメタデータをサーバー側のセッションデータベースにマッピングして、高スループットなデータ環境下でも匿名性を保ちながらセッションの連続性を維持し、高並行処理条件でのスケーラブルなリクエスト処理をサポートします。ブラウザベースのリダイレクトに頼るのではなく、セッションメタデータを一元化されたデータベースにマッピングすることで、このシステムは、初期タスクが匿名で実行された場合でもコンバージョンコンテキストが一貫性を保つことを保証します。エンジニアリングチームはこれらのアプローチを評価し、データ保護と測定の一貫性のバランスを取ることができます。
統合チェックリスト:高スループットなボット防御と獲得パイプラインの再設計
プラットフォームがセキュアなサーバー側のデータモデルに移行する中でデータパイプラインを保護し、コンバージョンの整合性を確保するために、エンジニアリングチームとプロダクトチームは堅牢な状態保持ワークフローを採用する必要があります。
開発者向け実装チェックリスト
- 外部APIエンドポイントの監査:すべての外部データ遷移が安全なHTTPS接続経由でルーティングされ、一時的なセッション構造を使用していることを確認してください。
- ステートレスなセッションハンドシェイクの実装:システム依存関係をサーバー側のセッション状態復元へと移行し、署名付きトークンを使用してプラットフォーム間でのデータ受け渡しを行ってください。
- サンドボックス化された同意フローの検証:ユーザーが入力したプロンプトをサードパーティのデータベースに転送する前に、明示的な許可を求めるプロンプトを確立してください。
プロダクトおよび運営戦略チェックリスト
- ボット検知精度の監視:アカウント作成時に、大規模言語モデル分類器の精度を追跡および評価してください。
- 誤検知率のレビュー:定期的な監査を実施し、正当なユーザー投稿が誤ってブロックまたはレート制限されないようにしてください。
- 認証チャレンジ完了率の追跡:疑わしい自動アカウントが強制的なヒューマニティテスト(CAPTCHAなど)とどのように相互作用するかを分析してください。
- 不審なアカウントクラスターの監査:行動テレメトリをマッピングし、同様のネットワーク範囲にまたがる大量登録の試みを特定してください。
これらの構造化されたガイドラインを確立することで、開発チームは運用の連続性を維持しつつ、アプリケーションをより安全でコンプライアンスに準拠したアーキテクチャへと移行させることができます。
よくある質問 (FAQ)
なぜRedditでAI生成のスパムキャンペーンが増加しているのですか?
RedditはLLMを使用して、アカウント作成時の協調的な不自然な行動をどのように検知していますか?
自動ボットを識別するために使用される視覚的および非視覚的な指標は何ですか?
AIプラットフォームがハイブリッドクラウド推論に依存するようになるにつれ、開発者はプライバシー、透明性のある同意、セキュアなデータルーティングを中心に製品を再設計する必要があります。進化するデータアーキテクチャは、デジタル体験の構築と測定方法の根本的な転換を求めています。ステートレスなプロキシやヘッドレススクレイパーがWebコンテンツの標準的な消費者となる中で、従来のクライアント側アトリビューションモデルは劣化し続けます。標準的なクッキーやリファラーへの依存だけでは、ユーザー獲得を牽引するデータパイプラインを保護することはもはや不可能です。
AI企業がモデル学習のためにパブリックな議論データをライセンス契約する動きが強まる中で、真正なユーザー参加を維持することは、大規模なオンラインコミュニティにとって信頼と収益の両面で優先事項となっています。今後を見据えると、エンジニアリングチームはステートレスなアーキテクチャ、サーバー側のセッション管理、そしてプライバシーファーストな設計にますます依存するようになるでしょう。これらの変化に早期に備える組織は、コンプライアンスに準拠した持続可能なAI製品を維持する上で、より有利な立場に立てるはずです。
Share this article



