なぜ企業はAI生成コードを削除するためにエンジニアに週1万ドル(約150万円相当)を支払うのでしょうか。近年、プロダクション環境のコードベースからAI生成コードを削除する作業に対し、企業が多額の費用を支払うケースが増えています。生成AIによるプログラム出力の急増に伴い、ソフトウェアチームは「機能開発のスピード」と「長期的なアーキテクチャの保守性」という難しい選択を迫られています。自律型コーディングエージェントはロジックの重複やモジュール境界の無視が頻発するため、組織は新しいコードを生成し続けることよりも、既存の冗長なファイルをリファクタリング(再構築)し削除することの方が価値があると気づき始めています。
AI生成コードを削除する「週1万ドルのビジネス」
概要
- 専門のエンジニアリングエージェンシーは、AIによって肥大化したコードベースの監査、リファクタリング、スリム化に対し、週あたり最大1万ドルの料金を請求しています。
- 事例として、全体の機能を維持したまま企業コードベースの65%を削減することに成功したリファクタリングサイクルが報告されています。
- 重複するコードブロックの急増は歴史的なピークに達しており、主要なソフトウェアシステム全体の開発速度を直接的に低下させています。
ソフトウェア開発の常識は大きな転換点を迎えています。長年、エンジニアリングチームの核心的な課題は、プロダクト要件に追いつくための「開発スピード」でした。開発者はデータベース接続の構造化、シリアライズ層の設計、単体テストの記述などを手動で行い、開発サイクルの大部分をルーチン的で反復的なコード組み立てに費やしてきました。
高度な大規模言語モデル(LLM)やGitHub Copilot、Cursor、Windsurfといったコーディングアシスタントの統合により、この初期の障壁は完全に解消されました。「Vibe Coding(バイブコーディング)」と呼ばれるプロセスを通じて、技術者であるか否かを問わず、自然言語プロンプトでアプリケーション全体を生成できるようになりました。しかし、これらの自動生成ファイルが増殖するにつれ、アーキテクチャ設計の欠如が明らかになります。AIシステムはプロンプトに応じた局所的な応答には優れていますが、長期的な技術アーキテクチャを評価することはできません。その結果、冗長な関数や密結合なデータ構造が生まれ、これはSlopfix技術ポータルでも指摘されています。
システムの保守性を回復させるため、エンジニアリングリーダーは明確なコード削除目標を定めています。経験豊富な開発チームが雇われ、複雑化したリポジトリを評価し、自動回帰チェックを構築し、数千もの重複クラスを削除しています。企業が新しいファイルを書くのではなく、プロの開発者に「AI生成コードの削除」を依頼する理由は、まさにこのパフォーマンスのギャップにあります。専門的な知見と厳密に管理されたツールを併用することで、これらのリファクタリング作業は冗長で独自のコードを標準化されたオープンソースライブラリに置き換え、アプリケーションの安定性と拡張性を確保します。
技術的背景:なぜAI生成コードは技術的負債を蓄積させるのか
技術的なレベルで見ると、「AIスロップ(AI生成のゴミコード)」現象は、現代のTransformerモデルにおけるコンテキスト管理の根本的な限界に起因します。LLMは大規模なテキストディレクトリを解析できますが、その注意機構は厳密なアーキテクチャ原則ではなく、トークンの確率に基づいてコードを評価するためです。
エージェントがファイル内の局所的なバグを修正する際、既存のユーティリティクラスを呼び出すのではなく、重複するロジックを導入することが頻繁にあります。これが数ヶ月続くと、ソフトウェアの品質は著しく低下します。以下の図は、自動パッチがどのように構造的な乖離を引き起こすかを示しています:
[人間が構築した構造]
  入力 ──> コアAPIコントローラー ──> 共有ユーティリティクラス(単一の標準フォーマッタ) ──> 安全な出力


[AIによる肥大化したパッチワーク]
  入力 ──> プロンプトパッチ1(新規フォーマッタ) ──> プロンプトパッチ2(重複フォーマッタ) ──> 断片化された出力
この重複はもはや局所的な問題ではなく、業界全体に広がる課題となっています。GitClearによる「2026年保守性ギャップレポート(6億2300万件の変更を分析)」によると、重複コードブロックは記録的な水準に達しており、2023年比で81%増加しました。一方で、構造的なリファクタリングは激減しており、2026年のコード変更全体に占める割合は4%未満(2022年は21%)となっています。このようなコピー&ペースト型プログラミングへの移行が、現在の開発者がリファクタリングよりも冗長なコードを導入する可能性が5倍高いという事実を裏付けています。
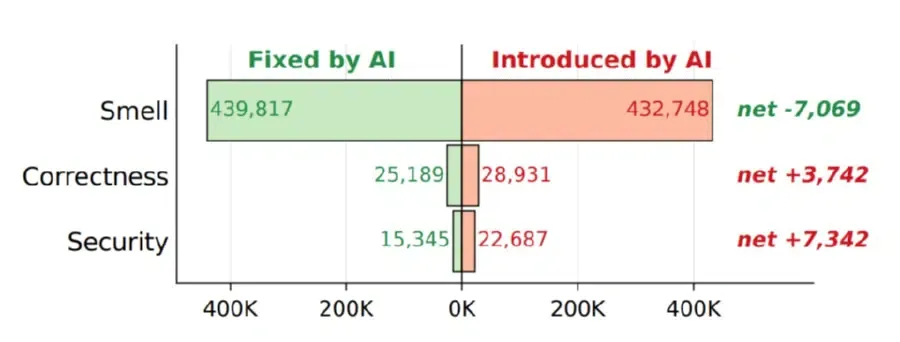
これらの知見は、コード負債を追跡した大規模な実証研究によっても裏付けられています。研究者が6,299個のGitHubリポジトリにおける30万件以上のAI生成コミットを調査したところ、Copilot、Claude、Cursor、Geminiなどによる提出物の15%以上で、検出可能なコードスメル、正当性のエラー、あるいはセキュリティリスクが見つかりました。
こうした連鎖的な障害のリスクがあるため、局所的な修正によって既存のエンドポイントが破損した際には、ソフトウェアチームはAI生成コードを削除せざるを得ません。さらに、研究によると、AIによって導入された問題の22.7%がコードベースの最新版でも未解決のまま残り、その多くが9ヶ月以上放置されていることが判明しており、管理されていないAI出力の長期的なコストを強調しています。
リポジトリのコードクリーニングとモバイルインストール追跡は異なるレイヤーで動作しますが、両者は同じ技術的課題を共有しています。自動システムが冗長なリクエストチェーンや未精査のスクリプトを生成すると、データ衝突やアトリビューション(計測)の破損リスクが増大します。モバイルアトリビューションでも同様の課題があり、プライバシー制限や自動化されたボットトラフィックによって、永続的なクライアントサイドIDへの依存が困難になっています。セキュリティチームがクリーンなユーザーリクエストとエージェントによる自動リクエストを区別できない場合、分析パイプライン全体が偽陽性のコンバージョン報告という脆弱性を抱えることになります。
業界への影響:AIコードクリーニングが変えるソフトウェアエンジニアリング
自動コード生成ツールの急速な普及により、ソフトウェアエンジニアの役割は変化しています。開発者は「作成者」から「監査者」へと移行しており、システムアーキテクチャ、データフロー、インターフェースの整合性に焦点を当てるようになっています。
- エンタープライズチーム:大企業では、ESLint、Prettier、SonarQubeといったツールを使い、CI/CDパイプラインや静的解析プロトコルを確立し、AIによる未精査な構造を含むコミットを拒否することで保守性を維持しています。
- スタートアップ:Devin、CodeRabbit、Cursorなどのツールを活用してMVP(実用最小限の製品)を素早く検証しますが、本格的なエンジニアリングチームへの引き継ぎ前には人間の手によるリファクタリングが不可欠です。
- オープンソースコミュニティ:Godotゲームエンジンのようなプロジェクトでは、提出された複雑なスクリプトを開発者が理解・検証できないため、AI生成コードの貢献を制限しています。
- SDKおよびライブラリベンダー:自動化ツールによる依存関係の誤解を防ぐため、ソフトウェアベンダーは統合するライブラリのモジュール化と軽量化を徹底する必要があります。
すべてを書き直さずにAIコードの肥大化を抑制する方法
AI主導のコード拡張という現実に対し、エンジニアリングチームはサードパーティの依存関係とSDKの選択を再評価しなければなりません。高スループットのルーティングパイプラインを統合するには、ローカルストレージコンテナに依存せず、安全にユーザーアクションを関連付けられるアーキテクチャが必要です。開発者は、AI自動生成ツールを使って専用のデータベース同期フレームワークを構築するのか、それとも標準化された構築済みのインフラを導入するのかを選択しなければなりません。
アーキテクチャの評価:カスタム構築 vs. 標準化SDK
コードベースが拡大する際、開発者は広範な内製ユーティリティを構築するか、成熟した外部ライブラリを活用するかを決定する必要があります。AI自動生成ツールを用いて一から独自ソリューションを開発すると、テストされていないロジックや冗長なクラスが数千行も混入することが多々あります。対照的に、最小限で検証済みのソフトウェアパッケージを統合することは、コンパイル後のサイズを小さく保つのに役立ちます。
以下の表は、カスタムデータアーキテクチャと認定された外部SDKのトレードオフをまとめたものです:
| アプローチ | コードのフットプリント | メンテナンス負荷 | 典型的なシナリオ |
|---|---|---|---|
| 内製による独自開発 | 高(数千行のカスタムスクリプト) | 極めて高い(継続的な内部監査) | 高度に専門化された内部テレメトリが必要な企業チーム |
| AI生成モジュール | 予測不能(スパゲッティコード) | 高い(コンテキスト崩壊の懸念) | 長期安定性よりもスピードを優先する迅速なプロトタイプ |
| 最小限のSDK統合 | 超軽量(10KB未満) | 無視できる程度(監査済み、自己完結型) | 標準的なパラメータマッチングが必要な高並行システム |
その結果、エンジニアリングマネージャーは新しい機能を追加する前に、冗長なAI生成コードを削除することを優先しています。統合の複雑さを最小限に抑える軽量SDKの需要が高まっています。例えば、マルチプラットフォームのコンバージョンテレメトリを統合する場合、軽量な OpoInstall SDKを導入できます。このSDKは、クロスプラットフォームパラメータを処理するために何百行ものテストされていないAIコードを生成するのではなく、セッションメタデータをサーバー側のセッションデータベースにマッピングします。これにより、コンパイル後のクライアントサイドの負荷を増やすことなく、キャンペーンやリファラ情報の文脈を匿名で保持できます。
統合チェックリスト:軽量なデプロイに向けたアーキテクチャの準備
将来的なコードの劣化を防ぎ、分散プラットフォーム全体でコンバージョンの一貫性を保つために、エンジニアリングおよびプロダクトチームはクリーンなコードベースの境界を確立する必要があります。
開発者の実装チェックリスト
- 厳格なリンターとゲート機能の適用:ESLint、Prettier、SonarQubeなどのツールチェーンを使用し、高い類似性スコアや重複したユーティリティ関数を含むPR(プルリクエスト)を拒否するようにCI/CDパイプラインを設定します。
- サードパーティSDKサイズの監査:統合された全ライブラリのコンパイル後のフットプリントを確認し、パッケージの肥大化によるデバイス起動速度の低下を防ぎます。
- 継続的なコードリファクタリングの実施:開発スプリントの一定割合を、冗長なディレクトリをモジュール化されたコンポーネントに統合するために割り当てます。
プロダクト&グロース戦略チェックリスト
- メモリ使用量の最適化:アプリの依存関係を評価し、ガベージコレクションによる停止を最小限に抑え、クライアントサイドでの熱暴走を防ぎます。
- SDKの厳選:単一目的で高度に最適化されており、不要な依存関係がないサードパーティツールを優先的に使用します。
- APIワークフローのレイテンシー監視:キャンペーンクリックからサーバー側のインストールマッチングまでの標準的なレイテンシーを追跡し、データの整合性を確認します。
これらのガイドラインを確立することで、開発チームはアプリケーションをより安全で準拠したアーキテクチャへと移行させ、運用の継続性を維持できます。
よくある質問 (FAQ)
AI生成コードはソフトウェアの保守性に悪影響を及ぼしますか?
複雑なアーキテクチャにおいてAIコーディングツールを信頼すべきですか?
冗長なAIコードを削除するとシステムパフォーマンスは向上しますか?
エンジニアリングチームへの重要なポイント
AIを活用した開発が主流となるにつれ、ソフトウェアチームの関心は「コードを生成すること」から「コードベースの健全性を維持すること」へと移行しています。AIコードクリーニングを専門とするビジネスの台頭は、組織が生成AI時代におけるソフトウェア品質を評価する方法の変化を反映しています。構造的な問題を自動エージェントにパッチさせるだけの運用は、技術的負債を蓄積させ続けます。厳格なモジュール化、自動テスト、最適化された外部依存関係を中心にエンジニアリングガイドラインを再構築することが、アプリケーションの拡張性を維持するために不可欠です。
今後は、生成スピードよりもコードの保守性が組織の競争力を左右します。軽量で依存関係のないインフラを統合し、複雑な追跡ステータスをサーバー側データベースに移行させることで、開発者はデプロイパイプラインを「コードの肥大化」から守ることができます。この変化は単なるツールへの適応ではありません。AIが多用されるエンジニアリング環境において、安定した持続可能なソフトウェア構造を築くための歩みです。
Share this article



