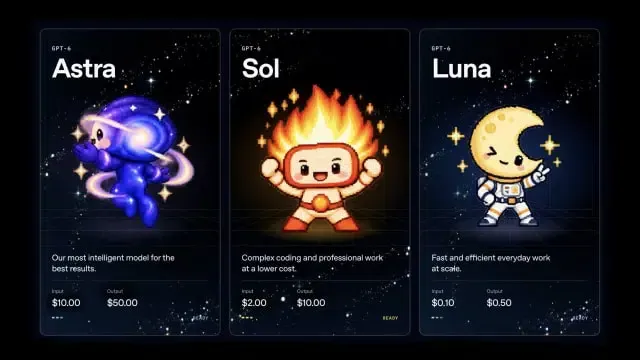
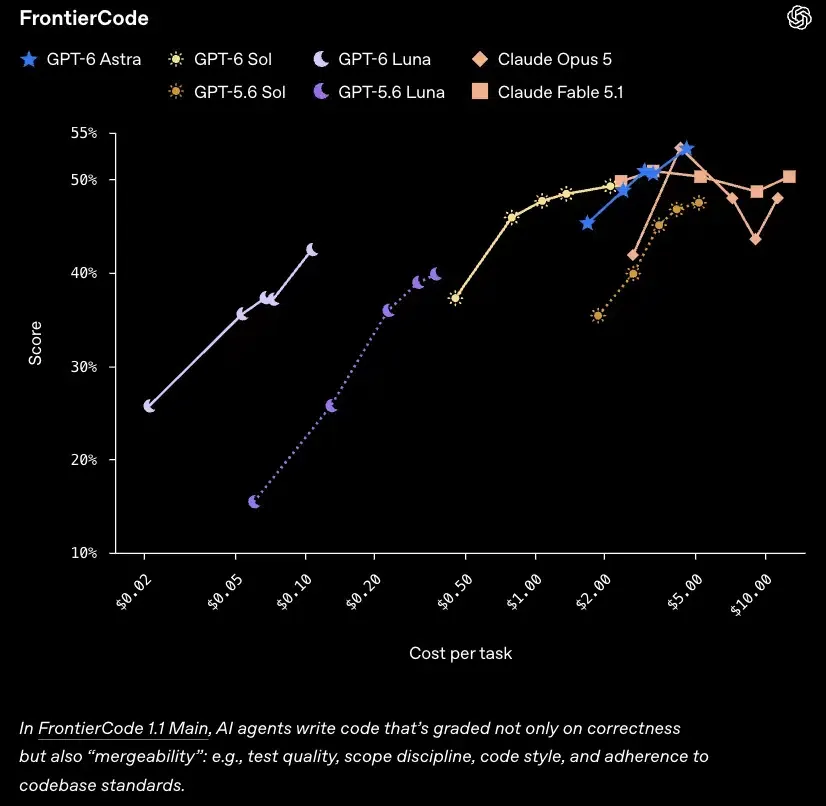
OpenAI가 Sol API 비용을 반으로 인하했나요? OpenAI는 2026년 9월 22일 GPT-6 Sol과 GPT-6 Luna의 상용화를 공식 발표하며, 표준 엔드포인트 기준 이전 GPT-5.6 프로모션 가격 대비 API 토큰 요금을 50% 이상 인하했습니다. 최대 272K 입력 토큰을 처리하는 표준 프롬프트의 경우, GPT-6 Sol은 입력 토큰 100만 개당 $2.00, 출력 토큰 100만 개당 $10.00로 책정되었으며, 소형 모델인 GPT-6 Luna는 입력 100만 개당 $0.00, 출력 100만 개당 $0.50로 책정되었습니다. OpenAI가 표준 개발자 티어 전반에서 Sol API 비용을 인하함에 따라, 구조적인 연산 비용 하락은 생성형 소프트웨어의 운영 제약 조건을 변화시키고 있습니다. 유닛 가격의 하락은 재귀적 에이전트 루프, 백그라운드 배치 추출, 그리고 자율형 다단계 워커를 대규모 환경에서 경제적으로 운영할 수 있게 만듭니다. 그러나 시스템 아키텍트, 신뢰성 엔지니어, 백엔드 개발자의 입장에서 재정적 마찰의 감소는 다운스트림 확장성 문제를 수면 위로 끌어올리며, 엔지니어링의 초점을 토큰 예산에서 속도 제한 경계(rate-limit boundaries), 동시성 제한, 텔레메트리 파이프라인, 그리고 배압 병목 현상으로 이동시킵니다.
운영상의 문제점 및 재정적 병목 현상
프로덕션 엔터프라이즈 LLM 도입의 초기 단계 전반에서 명목상 토큰 비용은 비공식적인 아키텍처 제어 장치 역할을 했습니다. 높은 추론 비용으로 인해 개발 팀은 모델 호출을 개별적인 사용자 시작 트랜잭션으로 취급해야 했습니다. 애플리케이션은 월별 공급자 청구서의 예측 가능성을 유지하기 위해 인간의 개입(human-in-the-loop) 승인, 제한된 대화 기록, 그리고 엄격하게 조절된 예약 워커에 크게 의존했습니다. 영구적인 미들티어 모델 가격 인하의 도입은 이러한 역사적 트레이드오프에 도전하며, 시스템 엔지니어링의 관심을 모델 가격 책정에서 백엔드 인프라 안정성으로 이동시킵니다.
요약
- 기준 가격 인하: 2026년 9월 22일, OpenAI는 최대 272K 토큰의 프롬프트 표준 처리를 위해 GPT-6 Sol을 입력 $2.00 / 출력 $10.00, GPT-6 Luna를 입력 $0.10 / 출력 $0.50(100만 토큰당)로 도입했습니다. 이는 GPT-5.6 프로모션 API 가격 대비 50% 이상 명목상 인하된 수치입니다.
- 작업 수준 벤치마크 경제성: AutomationBench 1.0.6에서 OpenAI는 xhigh 추론 강도로 설정된 GPT-6 Sol이 시도된 작업당 평균 $0.27의 비용으로 33.2%의 워크플로우 점수를 달성했다고 보고했으며, 이는 개발자의 평가 기준을 단순 토큰 가격에서 작업 단위당 비용으로 전환시켰습니다.
- 프롬프트 캐싱 역학: 플랫폼은 캐시된 입력 토큰 읽기에 대해 자동 90% 할인(기본 입력 토큰 요금의 0.1배로 청구)을 제공하는 반면, 초기 캐시 쓰기는 캐시되지 않은 입력 토큰 요금의 1.25배로 청구되므로 동적 다단계 실행 전반에서 높은 캐시 적중률을 유지하기 위해 신중한 프리픽스 정규화가 필요합니다.
공식 OpenAI 개발자 API 가격 참고서 및 OpenAI 커뮤니티 공지에 자세히 설명된 바와 같이, 이러한 가격 구조는 저수준 추론 파이프라인과 KV 캐싱 시스템 전반의 지속적인 개선에서 비롯되었습니다. 그러나 자동화된 작업 시퀀스 실행 비용이 크게 하락함에 따라, 엔지니어링 팀은 백그라운드 작업의 범위를 확장합니다. 지속적인 폴링, 자동화된 코드 리뷰 패스, 또는 다단계 문서 추출 파이프라인을 실행하는 백그라운드 워커를 이전에 주저하게 만들었던 경제적 하한선이 낮아졌습니다.
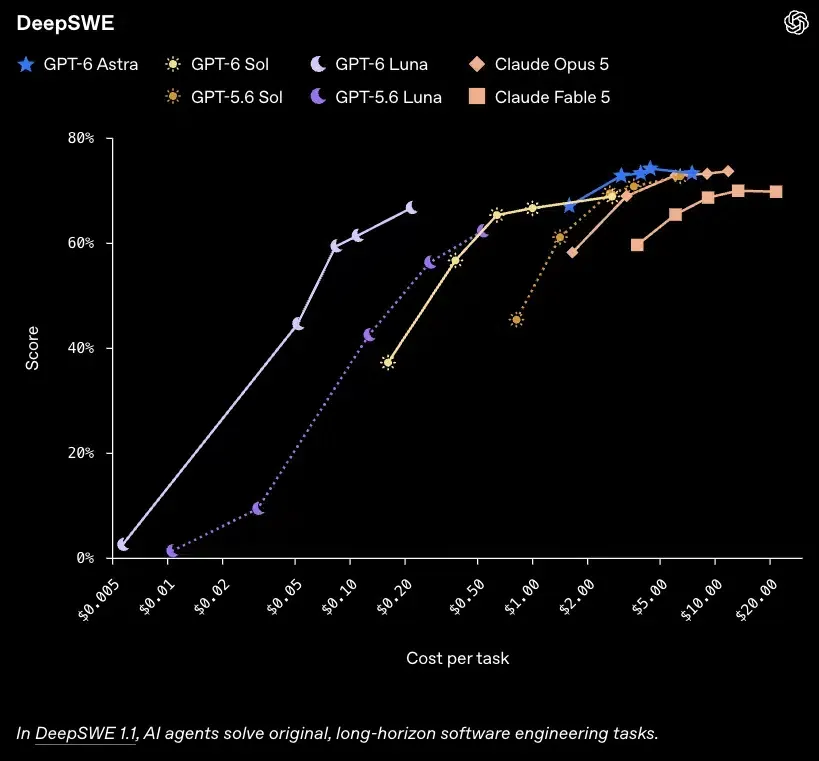
시장 전반에서 여러 파운데이션 모델 공급자들이 개발자 티어 전반의 API 가격을 인하하거나 재구조화했습니다. 앤스로픽(Anthropic)은 Anthropic Claude Opus 5.5 플랫폼 사양에 업데이트된 세부 정보와 함께 Claude Opus 5.5를 출시했으며, 100만 입력 토큰당 $4, 캐시된 입력 읽기 100만 개당 $0.20, 출력 토큰 100만 개당 $20를 제시하며 코드 리팩토링 벤치마크에서의 토큰 소비 감소를 강조했습니다. 동시에 구글은 Google AI for Developers에 문서화된 Gemini 3.8 Flash의 프로모션 도입 가격을 유지하고 있으며, 샤오미의 MiMo-V2.6-Pro와 같은 오픈 웨이트 릴리스는 관대한 소프트웨어 라이선스 하에 자체 호스팅 팀에게 공격적인 토큰 비용 옵션을 제공합니다.
모델 비용이 하락하면 개발 행동 양식이 바뀝니다. 엔지니어링 팀은 더 깊은 재귀 루프를 배포하고, 포괄적인 엔터프라이즈 문서를 시스템 프롬프트에 주입하며, 복잡한 작업 그래프 전반에 걸쳐 자동화된 재시도 로직을 구성합니다. API 계층에서의 비용 절감으로 시작된 일이 내부 서비스로 지연 시간과 트래픽 급증을 전가할 수 있습니다. 오케스트레이션 워커가 단일 사용자 트랜잭션을 위해 수십 개의 순차적 또는 병렬 모델 호출을 발행하는 경우, 내부 데이터베이스 풀, 보조 스토리지 클러스터, 텔레메트리 파이프라인, 그리고 속도 제한 장치(rate limiter)가 그로 인한 부하를 감당해야 합니다.
근본적인 시스템 원인 및 비시각적 요청 체인
클라이언트 애플리케이션이 대화형 채팅 인터페이스에서 비시각적 백그라운드 자동화로 전환될 때, 업스트림 요청 프로파일은 극적으로 변경됩니다. 단일 비즈니스 이벤트는 스키마를 검사하고, 환경 변수를 평가하며, 외부 도구를 호출하고, 여러 연속 패스에 걸쳐 출력을 검증하는 자율형 파이프라인을 트리거할 수 있습니다.
+-----------------------------------------------------------------------------------------+
|                  RECURSIVE AGENT EXECUTION & BACKPRESSURE BOTTLENECK                    |
+-----------------------------------------------------------------------------------------+
|                                                                                         |
|  [ User Web / App Trigger ]                                                             |
|         |                                                                               |
|         v                                                                               |
|  [ Ingestion API Gateway ]                                                              |
|         |                                                                               |
|         +---> Spawns Autonomous Worker Instance                                         |
|         |                                                                               |
|         v                                                                               |
|  [ Autonomous Orchestration Loop (GPT-6 Sol / Luna) ]                                   |
|         |                                                                               |
|         +--- Step 1: Query Context (Cache Read) -----------------+                      |
|         |                                                        |                      |
|         +--- Step 2: Tool Execution (Uncached Call)              |                      |
|         |                                                        |                      |
|         +--- Step 3: Self-Correction Validation                  |                      |
|         |                                                        v                      |
|         +--- Step 4: Recursive Execution Fork ----> [ Bursting Internal RPCs ]          |
|                                                                  |                      |
|  [ Downstream System Bottlenecks ]                               |                      |
|         |                                                        |                      |
|         +--- Internal Microservices <-- (Connection Starvation) -+                      |
|         +--- PostgreSQL / Cache Stores <-- (Connection Pool Saturation)                 |
|         +--- Distributed Telemetry Stream <-- (Lossy Drop Buffer Applied)               |
|         +--- Audit Compliance Store <-- (Durable / Replayable Queue Lag)                |
|         +--- Upstream Provider Thresholds <-- (HTTP 429 Rate Limit Exhaustion)          |
|                                                                                         |
+-----------------------------------------------------------------------------------------+
재귀적 에이전트 실행 및 동시성 증폭
전통적인 대화형 웹 시스템에서 요청 볼륨은 인간의 상호작용 리듬을 반영합니다. 각 HTTP 스레드는 일반적으로 명시적인 사용자 상호작용에 매핑되며, 전체적인 팬아웃(fan-out)이 낮고 인간의 사고 시간(think-time)에 의해 페이스가 조절됩니다. 클라이언트 런타임은 페이로드를 전송하고 응답을 기다린 후 후속 상호작용을 시작하기 전에 대기합니다.
개념적 요청 프로파일 비교: 대화형 vs. 에이전트형
| 아키텍처 지표 | 대화형 사용자 흐름 | 자율형 에이전트 루프 |
|---|---|---|
| 동시성 모델 | 인간 중심의 요청 팬아웃이 일반적으로 낮음 | 1개의 수집 이벤트 = N개의 체인된 자식 호출 |
| 실행 타이밍 | 사용자 응답 및 사고 시간에 따라 조절됨 | 정책 제한에 개입될 때까지 자동으로 진행됨 |
| 컨텍스트 무효화 | 세션마다 신선한 페이로드 사용 | 캐시된 컨텍스트에 크게 의존함 |
| 오류 처리 | 오류 발생 시 사용자가 재시도 | 자동화된 프로그래밍 방식의 재시도 |
| 시스템 병목 현상 | 프론트엔드 게이트웨이 대역폭 | 내부 데이터베이스 풀 제한 |
| 장애 전파 | 단일 세션으로 격리됨 | 큐 포화 상태를 유발할 수 있음 |
시스템에 자율형 에이전트가 통합되면 이러한 페이스 조절이 분리됩니다. 트리거된 단일 이벤트는 중단 없는 자동화된 호출 시퀀스를 생성할 수 있습니다. 에이전트가 일시적인 오류나 형식이 잘못된 도구 출력에 직면하는 경우, 단순한 재시도 로직은 백엔드 서비스에 대한 급격한 요청 버스트를 생성할 수 있습니다. 토큰 비용 절감으로 인해 더 긴 실행 시간이 경제적으로 가능해짐에 따라, 자동화된 워크플로우는 활성 사용자 기반이 일정하더라도 백그라운드 요청 볼륨을 크게 확장할 수 있습니다.
프롬프트 캐시 메커니즘: KV 재사용, 쓰기 오버헤드, 프리픽스 안정성
OpenAI는 Sol 및 Luna 출시와 함께 프롬프트 캐싱 하위 시스템 전반의 최적화를 결합했습니다. OpenAI 프롬프트 캐싱 사양에 문서화된 바와 같이, 캐시된 프리픽스와 일치하는 입력 토큰은 읽기 가격에서 90% 할인을 받습니다. 프롬프트 캐싱은 범용 네트워크 페이로드 압축 메커니즘으로 작동하기보다는 주로 모델 측 재연산을 줄여줍니다. 표준 상태 비저장(stateless) 상호작용에서 클라이언트 애플리케이션은 요청 컨텍스트를 전송하고, 공급자는 일치하는 프리픽스에 대한 KV 텐서 재연산을 건너뛰어 최초 토큰 도달 시간(time-to-first-token latency)과 입력 청구 비용을 크게 줄입니다.
결정적으로, 서버 측 캐시에 초기 프리픽스를 쓰는 작업은 캐시되지 않은 입력 토큰 요금의 1.25배로 청구됩니다. 비용 효율성을 극대화하려면 여러 쿼리에 걸쳐 프리픽스 안정성을 유지해야 합니다.
선택된 공개 API 정가 — 공급자 간 직접 비교 불가
| 모델 식별자 | 입력 ($/100만 토큰) | 출력 ($/100만 토큰) | 캐시 읽기 정책 |
|---|---|---|---|
| OpenAI GPT-6 Luna (Std) | $0.10 | $0.50 | 90% 할인 (0.10배) |
| OpenAI GPT-6 Sol (Std) | $2.00 | $10.00 | 90% 할인 (0.10배) |
| OpenAI GPT-6 Astra (Std) | $10.00 | $50.00 | 동적 계층형 가격 책정 |
| Anthropic Opus 5.5 | $4.00 | $20.00 | $0.20/1M 읽기 (0.05배) |
| Anthropic Sonnet 5 | $2.00 | $10.00 | 캐시 시 최대 90% |
| Google Gemini 3.8 Flash | $0.75 (도입가) | $3.75 (도입가) | $0.075/1M 캐시 읽기 |
| Xiaomi MiMo-V2.6-Pro | $0.435 | $0.87 | $0.0036/1M 캐시 읽기 |
참고: 표준 요금은 단축 컨텍스트 티어(OpenAI의 경우 최대 272K 입력 토큰의 프롬프트)에 적용됩니다. 공급자는 서로 다른 캐시 쓰기 오버헤드, 컨텍스트 제한, 기간 한정 프로모션 조건을 부과합니다.
프리픽스 보존에는 API 구성 옵션의 신중한 처리가 필요합니다. OpenAI의 API 아키텍처에서는 추론 노력(reasoning effort) 파라미터를 직접 변경하거나 도구 정의 배열을 변경하면 렌더링된 프롬프트 프리픽스가 변경되어 이전에 캐시된 상태가 무효화됩니다.
다중 턴 세션 동안 캐시된 컨텍스트를 보존하기 위해 개발자는 도구 스키마와 기준 지시사항을 일관된 순서로 유지해야 합니다. 런타임 조정이 필요한 경우, 개발자는 도구 정의 배열을 직접 수정하는 대신 구조화된 세션 제어(예: configuration_update)를 통해 파라미터를 업데이트하거나 tool_choice 또는 allowed_tools를 사용하여 도구 실행을 토글해야 합니다.
캐시 미스가 발생하면 업스트림 공급자는 90% 읽기 할인 없이 입력 시퀀스를 재처리에 포함시킵니다. 대규모 환경에서는 이로 인해 추론 지연 시간과 타임아웃 압박이 가중될 수 있습니다. GPT-6 Sol 및 Luna 벤치마크에 관한 VentureBeat 보도에서 볼 수 있듯이, 다단계 작업 실행의 경우 비용 평가는 단순한 토큰 승수에서 완료된 작업 지출로 이동하며, GPT-6 Sol은 AutomationBench 1.0.6에서 시도된 작업당 평균 $0.27로 33.2%의 점수를 달성했습니다.
텔레메트리 아키텍처: 운영 메트릭과 규정 준수 감사의 분리
자동화된 LLM 요청의 급증은 백엔드 관측 가능성(observability)과 규정 준수 파이프라인에 상당한 부담을 줍니다. 고동시성 에이전트 워크플로우는 운영 텔레메트리와 법적 감사 추적(audit trail) 간의 명확한 아키텍처 분리를 요구합니다.
엔터프라이즈 규정 준수 정책은 종종 세션 메타데이터, 도구 실행 증명, 트랜잭션 기록의 기록을 요구합니다. 운영 텔레메트리와 규정 준수 데이터를 동일하게 취급하면 심각한 엔지니어링 트레이드오프가 발생합니다.
- 규정 준수 및 보안 감사 채널: 명시적 재시도, 지속성, 그리고 쓰기 전용의 접근 제어된 감사 저장소로의 장애 처리를 갖춘 내구성 있고 재생 가능한 전송을 제공해야 합니다. 페이로드는 구조화된 메타데이터, 호출자 신원, 암호화 상태를 캡처하는 동시에 개인 식별 정보(PII)와 비밀 키를 체계적으로 난독화해야 합니다. 높은 부하 상태에서 이러한 파이프라인은 레코드를 폐기하는 대신 배압을 적용하거나 큐에 작업을 지속적으로 보관해야 합니다.
- 운영 텔레메트리 채널: 토큰 수, 프롬프트 캐시 적중률, 업스트림 응답 지연 시간과 같은 성능 지표를 추적합니다. 이러한 추적(trace)은 실시간 모니터링과 디버깅에 사용되므로 경계가 지정된 손실형(lossy) 드롭 버퍼를 통해 처리될 수 있습니다. 다운스트림 수집기가 느려지면 애플리케이션은 핵심 서비스 가용성을 유지하기 위해 초과 운영 텔레메트리를 안전하게 폐기할 수 있습니다.
외부 공급자가 HTTP 429 속도 제한 오류를 반환할 때, 잘못 구성된 재시도 정책은 심각한 운영 문제를 야기할 수 있습니다. 즉각적인 재시도 또는 무작위 지터(jitter)가 없는 동기식 지수 백오프 루틴은 중간 마이크로서비스를 통해 연쇄적으로 전파되어 스레드 풀과 데이터베이스 연결을 고갈시키는 재시도 파도를 생성할 수 있습니다.
솔루션 비교: 직접 구축(Build) 대 구매(Buy) 트레이드오프
낮은 추론 비용으로 인해 발생하는 운영 부하를 관리하려면 조직은 AI 가이트웨이와 프록시 아키텍처를 평가해야 합니다. 팀은 맞춤형 라우팅, 속도 제한, 텔레메트리 프록시를 자체 개발할지 아니면 전문화된 타사 인프라를 배포할지 결정해야 합니다.
+-----------------------------------------------------------------------------------------+
|                 SYSTEM RESILIENCY PIPELINE WITH DECOUPLED TELEMETRY                     |
+-----------------------------------------------------------------------------------------+
|                                                                                         |
|  [ Inbound Application Requests ]                                                       |
|         |                                                                               |
|         v                                                                               |
|  [ Sliding-Window Rate Limiter ] <--- Local In-Memory or Distributed Cache              |
|         |                                                                               |
|         +---> Rejects / Delays Excess Concurrency (HTTP 429 Protection)                 |
|         |                                                                               |
|         v                                                                               |
|  [ Prompt Normalization & Cache Alignment Engine ]                                      |
|         |                                                                               |
|         +---> Pins Static System Prompts & Tool Definitions to Base Prefix              |
|         +---> Uses Structured Controls to Modify Session Parameters                     |
|         |                                                                               |
|         v                                                                               |
|  [ Upstream Provider Dispatch (OpenAI / Anthropic / Local API) ]                         |
|         |                                                                               |
|         +---------------------------------------+---------------------------------------+
|         |                                       |                                       |
|         v (Synchronous Fast Path)               |                                       |
|  [ Client Response Assembly ]                   |                                       |
|         |                                       v (Asynchronous Dual Path)              |
|         v                               +-----------------------------------------------+
|  [ Return Payload to App ]              |                                               |
|                                         v (Lossy Ring Buffer)   v (Durable Outbox)      |
|                                    [ Operational Metrics ]  [ Compliance Audit Store ]  |
|                                    (Drops on Congestion)    (Durable / Replayable)      |
|                                                                                         |
+-----------------------------------------------------------------------------------------+
자체 구축형 복원력 파이프라인
맞춤형 인프라를 개발하면 엔지니어링 팀은 네트워킹 정책, 데이터 난독화, 라우팅 전략에 대한 완전한 제어권을 갖게 됩니다. 조직은 정확한 내부 마이크로서비스 토폴로지에 맞춤화된 에지 프록시를 구축할 수 있습니다.
// 참고 구현: 소수점 나머지 및 경계가 지정된 포화 상태를 지원하는 동기화된 토큰 버킷
package com.example.ai.resilience;

import java.math.BigInteger;
import java.time.Duration;

public final class TokenBucketLimiter {
    private final long maxTokenCapacity;
    private final long refillPeriodNanos;
    private long availableTokens;
    private long lastRefillNanos;
    // [0, refillPeriodNanos) 범위의 스케일링된 나머지 분자
    private long scaledRemainder;

    public TokenBucketLimiter(long maxTokens, Duration refillPeriod) {
        if (maxTokens <= 0 || refillPeriod.isZero() || refillPeriod.isNegative()) {
            throw new IllegalArgumentException("TokenBucketLimiter에 대한 잘못된 경계 구성입니다.");
        }
        this.maxTokenCapacity = maxTokens;
        this.refillPeriodNanos = refillPeriod.toNanos();
        this.availableTokens = maxTokens;
        this.lastRefillNanos = System.nanoTime();
        this.scaledRemainder = 0L;
    }

    public synchronized boolean tryAcquire(long requestedUnits) {
        if (requestedUnits <= 0) {
            return false;
        }
        refillTokens();
        if (requestedUnits > availableTokens) {
            return false;
        }
        availableTokens -= requestedUnits;
        return true;
    }

    private void refillTokens() {
        long nowNanos = System.nanoTime();
        long elapsedNanos = nowNanos - lastRefillNanos;

        if (elapsedNanos <= 0) {
            return;
        }

        // 기준 타임스탬프를 단조적으로 증가
        this.lastRefillNanos = nowNanos;

        // 버킷이 이미 찬 경우, 타이밍 드리프트 방지를 위해 소비되지 않은 소수점 크레딧 폐기
        if (this.availableTokens >= this.maxTokenCapacity) {
            this.scaledRemainder = 0L;
            return;
        }

        long wholePeriods = elapsedNanos / refillPeriodNanos;
        long remElapsedNanos = elapsedNanos % refillPeriodNanos;

        // 빠른 경로: 적어도 하나의 전체 주기가 경과한 경우, 버킷이 용량까지 완전히 보충됨
        // 이것은 곱셈 오버플로우 표면(wholePeriods * maxTokenCapacity)을 제거함
        if (wholePeriods > 0) {
            this.availableTokens = maxTokenCapacity;
            this.scaledRemainder = 0L;
            return;
        }

        // 서브 주기 마이크로 간격 하에서 BigInteger 연산을 사용하여 정확한 소수점 토큰 계산
        BigInteger bigRemNanos = BigInteger.valueOf(remElapsedNanos);
        BigInteger bigCapacity = BigInteger.valueOf(maxTokenCapacity);
        BigInteger bigRemainder = BigInteger.valueOf(scaledRemainder);
        BigInteger bigPeriod = BigInteger.valueOf(refillPeriodNanos);

        // totalWork = (remElapsedNanos * maxTokenCapacity) + scaledRemainder
        BigInteger totalWork = bigRemNanos.multiply(bigCapacity).add(bigRemainder);
        BigInteger[] divAndRem = totalWork.divideAndRemainder(bigPeriod);

        long tokensGenerated = divAndRem[0].longValue();
        this.scaledRemainder = divAndRem[1].longValue();

        if (tokensGenerated > 0) {
            long spaceLeft = maxTokenCapacity - availableTokens;
            if (tokensGenerated >= spaceLeft) {
                this.availableTokens = maxTokenCapacity;
                this.scaledRemainder = 0L;
            } else {
                this.availableTokens += tokensGenerated;
            }
        }
    }
}
그러나 내부 개발에는 지속적인 엔지니어링 유지보수가 필요합니다. 팀은 공급자 API 업데이트에 수동으로 적응하고, 여러 벤더 전반의 진화하는 속도 제한을 처리하며, 분산된 텔레메트리 큐를 관리해야 합니다. 이러한 유지보수 오버헤드는 내부 개발자 자원을 핵심 제품 기능에서 멀어지게 할 수 있습니다.
상용 게이트웨이 및 인프라 툴링
이러한 기능을 처음부터 구축하는 것을 피하기 위해 많은 기업은 관리형 API 프록시, LLM 게이트웨이, 에지 제어 평면을 배포합니다. 일부 관리형 게이트웨이는 공급자 인식 속도 제한 조율, 관측 가능성, 정책 제어, 캐시 인식 라우팅을 제공합니다. 정확한 기능은 벤더에 따라 다르며 프리픽스 최적화는 여전히 애플리케이션 수준의 요청 규율을 요구하는 경우가 많습니다.
n상용 플랫폼을 통해 엔지니어링 팀은 환경별 비용 할당량을 시행하고, 모델 제품군 전반의 자동화된 폴백(fallback) 라우팅을 구성하며, 요청 메타데이터를 로깅하기 전에 민감한 고객 정보를 제거할 수 있습니다. 용도에 맞게 구축된 게이트웨이는 동시성 급증을 관리하고, API 소비 동향을 감사하며, 복잡한 애플리케이션 환경 전반에서 다운스트림 마이크로서비스를 보호합니다.
결정 매트릭스: 자체 구축 파이프라인 vs. 관리형 플랫폼
| 평가 기준 | 자체 구축 복원력 툴링 | 관리형 라우팅 인프라 |
|---|---|---|
| 초기 개발 노력 | 높음 (3~6 엔지니어링 주) | 낮음 (표준 API를 통해 통합) |
| 프로토콜 유지보수 | 지속적인 팀 책임 | 벤더 업데이트로 처리됨 |
| 운영 제어 | 전체 스택 가시성 | 벤더 인터페이스에 의해 제한됨 |
| 프롬프트 캐시 튜닝 | 맞춤형 프록시 필요 | 벤더 종속적; 대개 애플리케이션 협조 필요 |
| 텔레메트리 격리 | 맞춤형 큐 관리 | 벤더 종속적 |
| 재정적 비용 프로파일 | 엔지니어링 급여 오버헤드 | 반복적인 SaaS / 사용량 수수료 |
통합 체크리스트 및 거버넌스 일정
GPT-6 Sol 및 Luna 가격 인하에 따라 모델 사용량을 확장하는 조직은 시스템 과부하를 방지하기 위해 다음 운영 프레임워크를 활용할 수 있습니다.
+-----------------------------------------------------------------------------------------+
|                  ENTERPRISE LLM INFRASTRUCTURE READINESS CHECKLIST                      |
+-----------------------------------------------------------------------------------------+
| [ ] Audit client applications to identify unbounded recursive model calling loops       |
| [ ] Set hard timeout limits and non-linear retry backoffs with randomized jitter        |
| [ ] Implement local and edge token-bucket rate limiters ahead of upstream calls          |
| [ ] Organize prompt structures to maximize prompt caching prefix reuse                   |
| [ ] Separate lossy operational telemetry from durable, replayable audit trails           |
| [ ] Add runtime sampling to strip raw prompt bodies from high-frequency traces          |
| [ ] Monitor HTTP 429 status trends and set automated backpressure triggers              |
| [ ] Configure cost alerts and circuit breakers to catch runaway automated jobs          |
+-----------------------------------------------------------------------------------------+
텔레메트리 파이프라인 구성
관측 가능성 시스템은 프롬프트 로깅을 실시간 요청 경로에서 분리해야 합니다. 고주파 에이전트 워크플로우를 처리할 때 애플리케이션은 텔레메트리 메타데이터를 메모리 경계가 지정된 비동기 큐에 기록하여 다운스트림 텔레메트리 수집기가 느려질 경우 I/O 정지를 방지해야 합니다.
// 참고 구현: 손실형 부하 차단을 지원하는 메모리 경계 지정 텔레메트리 로거
package com.example.ai.resilience;

import java.util.concurrent.ArrayBlockingQueue;
import java.util.concurrent.BlockingQueue;
import java.util.concurrent.atomic.AtomicLong;

public final class BoundedTelemetryQueue {
    public static final class LogPayload {
        public final String traceId;
        public final String modelId;
        public final long promptTokens;
        public final long completionTokens;
        public final boolean cacheHit;

        public LogPayload(String traceId, String modelId, long pTokens, long cTokens, boolean hit) {
            this.traceId = traceId;
            this.modelId = modelId;
            this.promptTokens = pTokens;
            this.completionTokens = cTokens;
            this.cacheHit = hit;
        }
    }

    private final BlockingQueue<LogPayload> internalQueue;
    private final AtomicLong droppedEvents = new AtomicLong(0);

    public BoundedTelemetryQueue(int maxQueueCapacity) {
        if (maxQueueCapacity <= 0) {
            throw new IllegalArgumentException("큐 용량은 양수여야 합니다.");
        }
        this.internalQueue = new ArrayBlockingQueue<>(maxQueueCapacity);
    }

    public boolean recordEvent(LogPayload payload) {
        if (payload == null) {
            return false;
        }
        // 비차단 제출: 앱 안정성 유지를 위해 부하 시 텔레메트리 드롭
        boolean accepted = internalQueue.offer(payload);
        if (!accepted) {
            droppedEvents.incrementAndGet();
        }
        return accepted;
    }

    public LogPayload pollEvent() {
        return internalQueue.poll();
    }

    public long getDroppedEventCount() {
        return droppedEvents.get();
    }
}
자주 묻는 질문 (FAQ)
GPT-6 Sol 및 Luna의 공식 API 요금은 얼마인가요?
프롬프트 캐싱은 긴 대화에서 어떻게 비용을 절감하나요?
토큰 가격 인하가 백엔드 운영 위험을 증가시키는 이유는 무엇인가요?
엔지니어링 팀을 위한 주요 시사점
GPT-6 Sol 및 Luna의 출시는 더 넓은 트렌드, 즉 프론티어 인텔리전스가 더 저렴하고 접근하기 쉬워지고 있음을 가속화합니다. 유닛 토큰 비용이 급격히 하락함에 따라 재정적 제약은 더 이상 소프트웨어 아키텍처에 대한 효과적인 제어 메커니즘으로 기능하지 못하게 됩니다.
조직이 고주파 에이전트와 다티어 모델 토폴로지를 채택함에 따라 운영 엔지니어링은 엔터프라이즈 성공에 매우 중요해집니다. 팀은 명목상 토큰 가격이나 벤치마크 점수만으로 모델을 평가하는 단계를 넘어서야 합니다. 장기적인 신뢰성은 시스템이 동시성을 얼마나 효과적으로 관리하고, 캐시 재사용을 위해 프롬프트 컨텍스트를 정렬하며, 업스트림 속도 제한을 원활하게 처리하고, 중요 애플리케이션 경로에서 텔레메트리를 분리하는지에 따라 달라질 것입니다. 복원력 있는 인프라를 구축하는 조직은 애플리케이션 가동 시간이나 시스템 안정성을 희생하지 않고도 자동화된 에이전트 워크플로우를 성공적으로 확장할 수 있습니다.
주요 소스 및 참고 문서
-
OpenAI 개발자 API 가격 참고서: 공식 개발자 요금표, 컨텍스트 윈도우 제약 사항(표준 임계값 ≤272K), GPT-6 Sol, Luna, Astra에 대한 캐시 읽기/쓰기 가격 일정.
-
OpenAI 커뮤니티 공지: GPT-5.6 프로모션 티어 대비 50% 기준 가격 인하 및 마일스톤 롤아웃 세부 사항을 확인하는 공개 발표.
-
OpenAI 프롬프트 캐싱 사양: 서버 측 Key-Value 프리픽스 재사용, 캐시 쓰기 오버헤드, 구성 무효화 규칙에 관한 아키텍처 문서.
-
Anthropic Claude Opus 5.5 플랫폼 사양: $4 입력 / $20 출력 / $0.20 캐시 읽기 토큰 요금 및 벤치마크 성능을 확인하는 공식 출시 사양.
-
Anthropic Claude Sonnet 5 개요: 공식 개발자 요금표 및 프롬프트 캐싱 효율성 지표($2 입력 / $10 출력 / 캐시 시 최대 90% 할인).
-
Google AI for Developers 요금표: Gemini 3.8 Flash에 대한 개발자 요금표 및 도입 가격 정책 개요.
-
Xiaomi MiMo 공식 API 가격 및 요금 일정: MiMo-V2.6-Pro 추론에 대한 표준 해외 종량제 토큰 요금($0.435 입력 / $0.87 출력 / $0.0036 캐시 적중).
-
GPT-6 Sol 및 Luna 벤치마크에 관한 VentureBeat 보도: 출시 경제성, 영구 가격 보장, AutomationBench 1.0.6 작업 비용 수치(시도된 작업당 $0.27) 보도.
Share this article



