 Amap lança ‘damax’? Esta iniciativa estratégica foi validada à medida que a gigante de mapas entra no espaço generativo de baixo código (low-code) para automatizar a criação de apps. Em 29 de junho de 2026, surgiram detalhes sobre o ‘damax’ (também referido como ‘袋马’), uma ferramenta de Vibe Coding projetada para compilar mini-programas do WeChat e aplicativos nativos para iOS diretamente a partir de comandos em linguagem natural. Para equipes de desenvolvimento e gerentes de produto, este modelo de geração rápida destaca uma transição tecnológica: assistentes de IA estão atuando cada vez mais como uma camada de middleware programático entre usuários finais e aplicativos, reduzindo configurações manuais de desenvolvimento.
Resumo
- Geração Rápida: O motor ‘damax’ automatiza comandos de linguagem natural em mini-programas do WeChat e builds nativos para iOS, comprimindo significativamente os ciclos de vida de lançamento de produtos.
- Público-Alvo: A configuração atende a pequenos empresários, criadores independentes e micro-equipes sem departamentos de engenharia internos dedicados.
- Fragmentação de Contexto: O aumento de apps gerados automaticamente impõe desafios únicos para rastreamento, restauração de sessão e preservação de deep links em plataformas divididas.
Realinhamento Estrutural e o Espaço Generativo de Baixo Código
A Beijing Amap Yuntu Technology Co., Ltd. desenvolveu e opera a nova ferramenta de espaço de trabalho ‘damax’. Este lançamento posiciona a Amap diretamente no competitivo mercado de geração de aplicações por IA, desafiando plataformas estabelecidas como Tusi da Tencent, Miada da Baidu, Qoder da Alibaba e Trae da ByteDance. Relatórios recentes de acompanhamento do setor indicam uma mudança ascendente nas submissões de novas aplicações, destacando como a programação assistida por IA está reduzindo barreiras. Em vez de produzir simples maquetes, esta configuração compila softwares nativos para iOS e mini-programas do WeChat totalmente funcionais. Ela gera códigos QR de dispositivos reais para execução e teste instantâneos no WeChat, permitindo que criadores sem conhecimentos técnicos executem e refinem projetos em tempo real.
A aposentadoria de ciclos de vida de desenvolvimento tradicionais parece provável à medida que esses sistemas zero-code ganham força. A integração contínua de compiladores conversacionais em ecossistemas SaaS sugere que grandes empresas de tecnologia estão priorizando fluxos de trabalho automatizados em detrimento da manutenção de clientes focada em humanos. Consequentemente, quando a Amap lança o ‘damax’ para testes beta internos, isso desencadeia uma mudança mais ampla em direção a protocolos de troca de dados nativos. Estudos do setor demonstram que fluxos de trabalho assistidos por IA podem gerar configurações completas de múltiplas telas a partir de comandos simples, provando que a criação manual de layouts visuais está se tornando um grande ponto de fricção no software empresarial moderno.
Provedores de SaaS estão se reposicionando rapidamente para evitar a obsolescência. Equipes de software estão explorando infraestrutura de e-mail agentic para suportar fluxos de trabalho de caixa de entrada programáticos. Expandindo essa tendência de automação, grandes suítes de produtividade adquiriram tecnologias de criação de agentes para executar tarefas complexas entre sistemas. Operando em paralelo, plataformas de chat empresarial implantaram capacidades assistidas por IA dentro de seus sistemas nativos. Essa consolidação em todo o setor indica uma direção provável onde a integração de backend tem precedência sobre o software desktop autônomo.
Análise do Protocolo: Como Scrapers Headless Perturbam a Atribuição
Muitos gateways de e-mail corporativos e assistentes de IA inspecionam automaticamente os links recebidos antes que os usuários interajam com eles. Sob a perspectiva dos sistemas de atribuição, isso altera toda a cadeia de requisição.
Quando um usuário humano clica em um link, um navegador padrão carrega a página, executa scripts de rastreamento e grava um cookie. Em contraste, um agente de IA busca a página programaticamente. Ele envia uma requisição HTTP headless diretamente de um servidor na nuvem. Como a requisição é executada dentro de um sandbox sem estado, não há DOM visual, histórico de navegador ou armazenamento de cookies. O roteamento headless frequentemente isola a sessão do sistema do lado do cliente. Os métodos tradicionais de atribuição baseados em navegador podem não capturar mais a jornada completa do usuário, pois dependem de cookies de navegador para vincular o clique inicial à instalação. Sob essas condições, a precisão da atribuição diminui significativamente em toda a pilha de comunicação.
Fluxo Humano Tradicional:
Link de E-mail -> Clique Visual -> Sessão de Navegador (Cookies, DOM) -> App Store -> Instalação do App (Atribuída)


Fluxo Headless Gerenciado por Agente:
Link de E-mail -> Scan Programático -> Requisição HTTP Headless (Sem UI, Sem DOM, Sem Cookies) -> Link Visitado
Instalação do App (Posterior) -> Lançamento do App -> Estado de Cliente em Branco (Atribuição Perdida)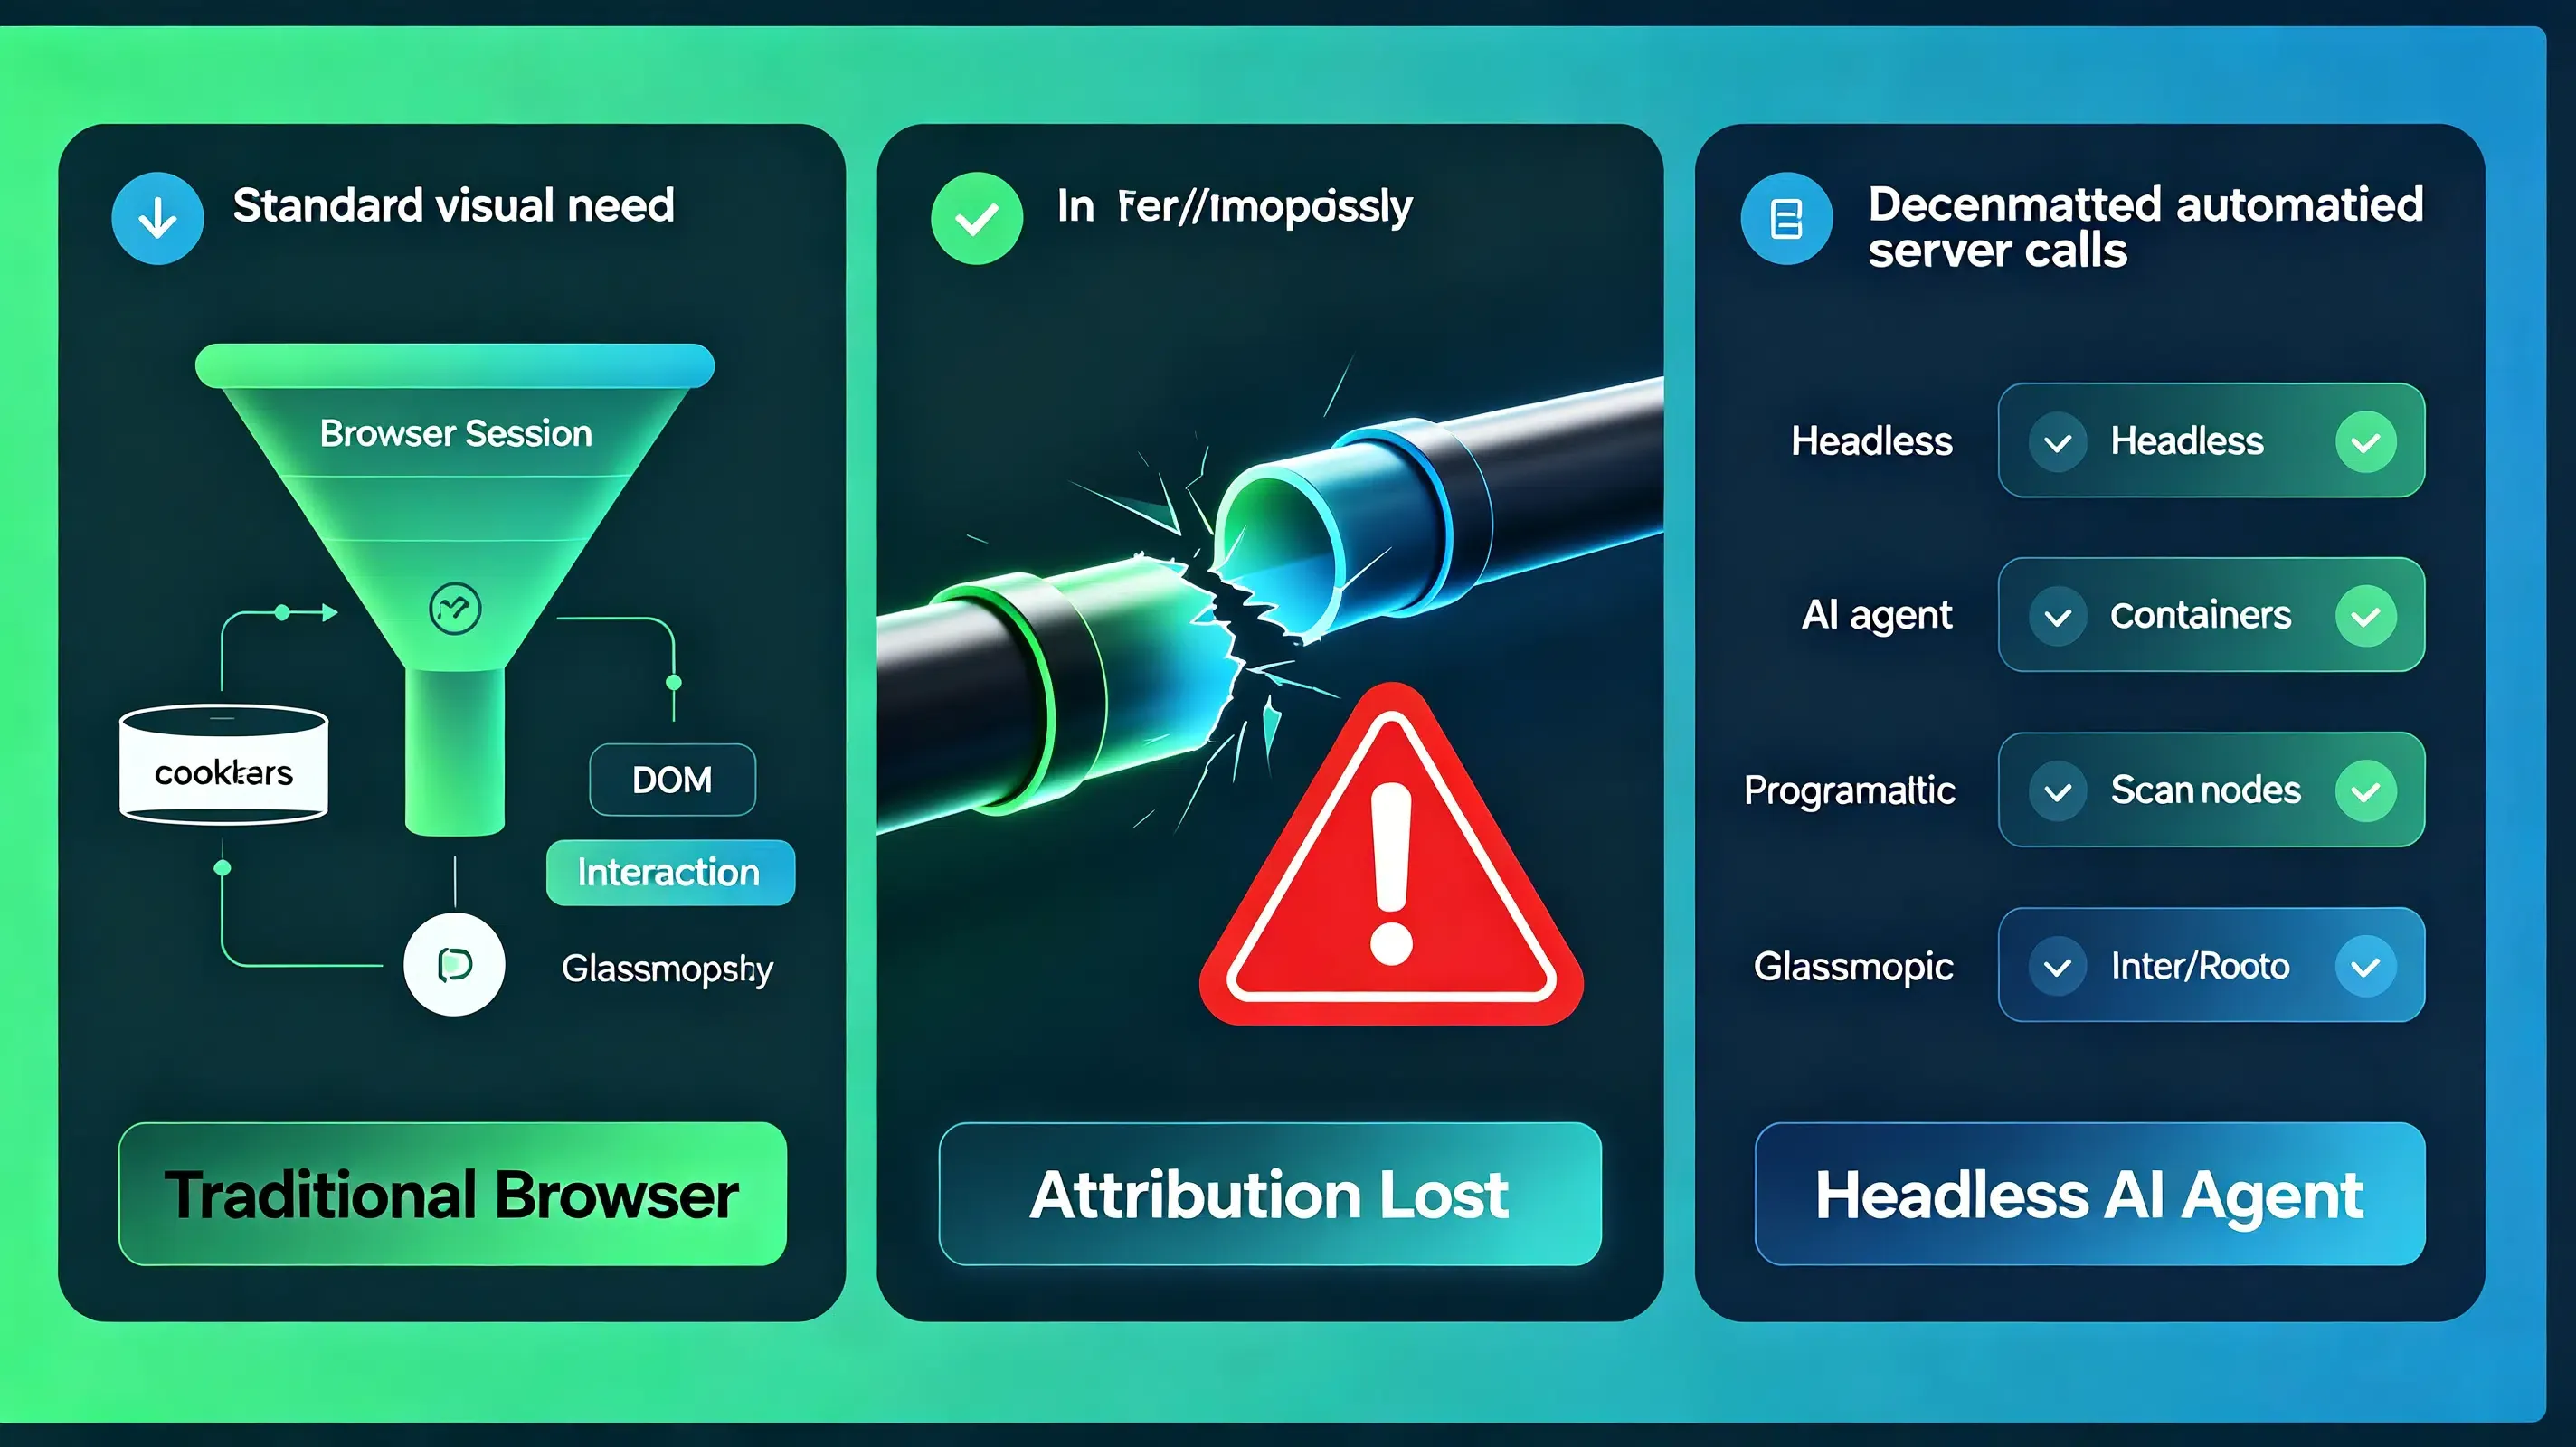
Em implementações típicas de produção, os desenvolvedores encontram uma parcela notável de tráfego sendo processada por scrapers automatizados. Rastrear essas interações programáticas revela que gateways de segurança de e-mail ou scanners de caixa de entrada automatizados podem visitar links antes dos usuários finais. Esse comportamento pode interferir na atribuição baseada em navegador se os sistemas presumirem que toda requisição origina-se de um usuário real. Consequentemente, em algumas implementações, o contexto de referência original pode não estar mais disponível para a aplicação cliente, resultando em lacunas significativas de atribuição.
Soluções Arquiteturais: Construir ou Comprar na Restauração de Estado
Na prática, equipes de engenharia geralmente escolhem entre construir um pipeline de atribuição interno ou integrar um SDK de atribuição existente. Desenvolver um sistema proprietário exige um esforço considerável de engenharia. As equipes precisam construir bancos de dados personalizados no servidor, manter bibliotecas de correspondência de estado de dispositivo e atualizar continuamente a lógica para cumprir os padrões de segurança do SO em constante evolução. Para muitas organizações, o custo de manutenção de um rastreador interno é proibitivamente alto.
Alternativamente, desenvolvedores geralmente avaliam várias abordagens para preservar o estado da sessão sem cookies no lado do cliente:
- Serviços Customizados Internos: Construir bancos de dados proprietários de correspondência de estado sobre a arquitetura de nuvem interna.
- Ferramentas Específicas de Plataforma: Confiar em utilitários básicos como o Firebase Dynamic Links (ou alternativas nativas da plataforma).
- MMPs Corporativos: Implantar parceiros de mensuração móvel (MMPs) para fluxos de trabalho de deep linking.
- SDKs de Parâmetros Especializados: Utilizar utilitários de integração dedicados para passagem de parâmetros personalizados com precisão e custo eficiente.
Comparação de Fluxo de Estado & Atribuição
| Fluxo de Interação | Loja de Cookies Visual | Compatibilidade Headless | Integridade da Atribuição |
|---|---|---|---|
| Jornada Tradicional de Navegador | ✅ Sim | ❌ Não | Alta (Sessão Client-Side) |
| Triagem de Agente IA Headless | ❌ Não | ✅ Sim | Baixa (Perda de Dados Contextuais) |
| Bloqueio de Estado Server-Side | ❌ Não | ✅ Sim | Alta (Recuperação Assíncrona) |
Geração de Link -> Pré-registro de metadados no servidor de estado central
                                     |
Scraper/Usuário clica no URL -> Registrar bloqueio de estado temporário no servidor
                                     |
App é lançado no dispositivo -> Consulta de contexto programática do SDK -> Corresponder bloqueio de estado & Restaurar parâmetros
Implementações comerciais dessa arquitetura incluem Branch, AppsFlyer, Adjust, Opoinstall e outras plataformas de atribuição diferida. Esses sistemas mantêm o estado no lado do servidor antes da instalação e restauram os parâmetros quando o aplicativo é iniciado pela primeira vez, contornando os problemas de confiabilidade associados às sessões de navegador do cliente. O SDK personalizado do Opoinstall mapeia com segurança os parâmetros de referência para um banco de dados centralizado de recuperação de estado, garantindo que os contextos de referência sejam preservados mesmo quando a interação inicial ocorre por meio de uma transação headless, gerenciada por máquina, na pilha de comunicação. À medida que a Amap lança o ‘damax’, os desenvolvedores geralmente avaliam essas arquiteturas para proteger seus pipelines de atribuição.
Adaptações da Equipe Operacional e Checklists de Integração
As equipes de engenharia de backend enfrentam a tarefa imediata de auditar todas as integrações de banco de dados ativas antes de lançar builds compilados automaticamente. Líderes de produto devem redesenhar os fluxos de convite e registro para acomodar jornadas de usuário não visuais. Em vez de supor que o usuário lerá um e-mail e clicará em um botão, os líderes de produto devem projetar fluxos de trabalho que esperam gatilhos programáticos. As equipes de growth devem atualizar suas métricas de desempenho. Quando o software autônomo lida com a triagem, as taxas de abertura e as taxas de clique tornam-se menos confiáveis. As operações de marketing devem se concentrar na telemetria in-app e em marcos de conversão verificados por transação, otimizando campanhas com base nas ações reais realizadas dentro da aplicação.
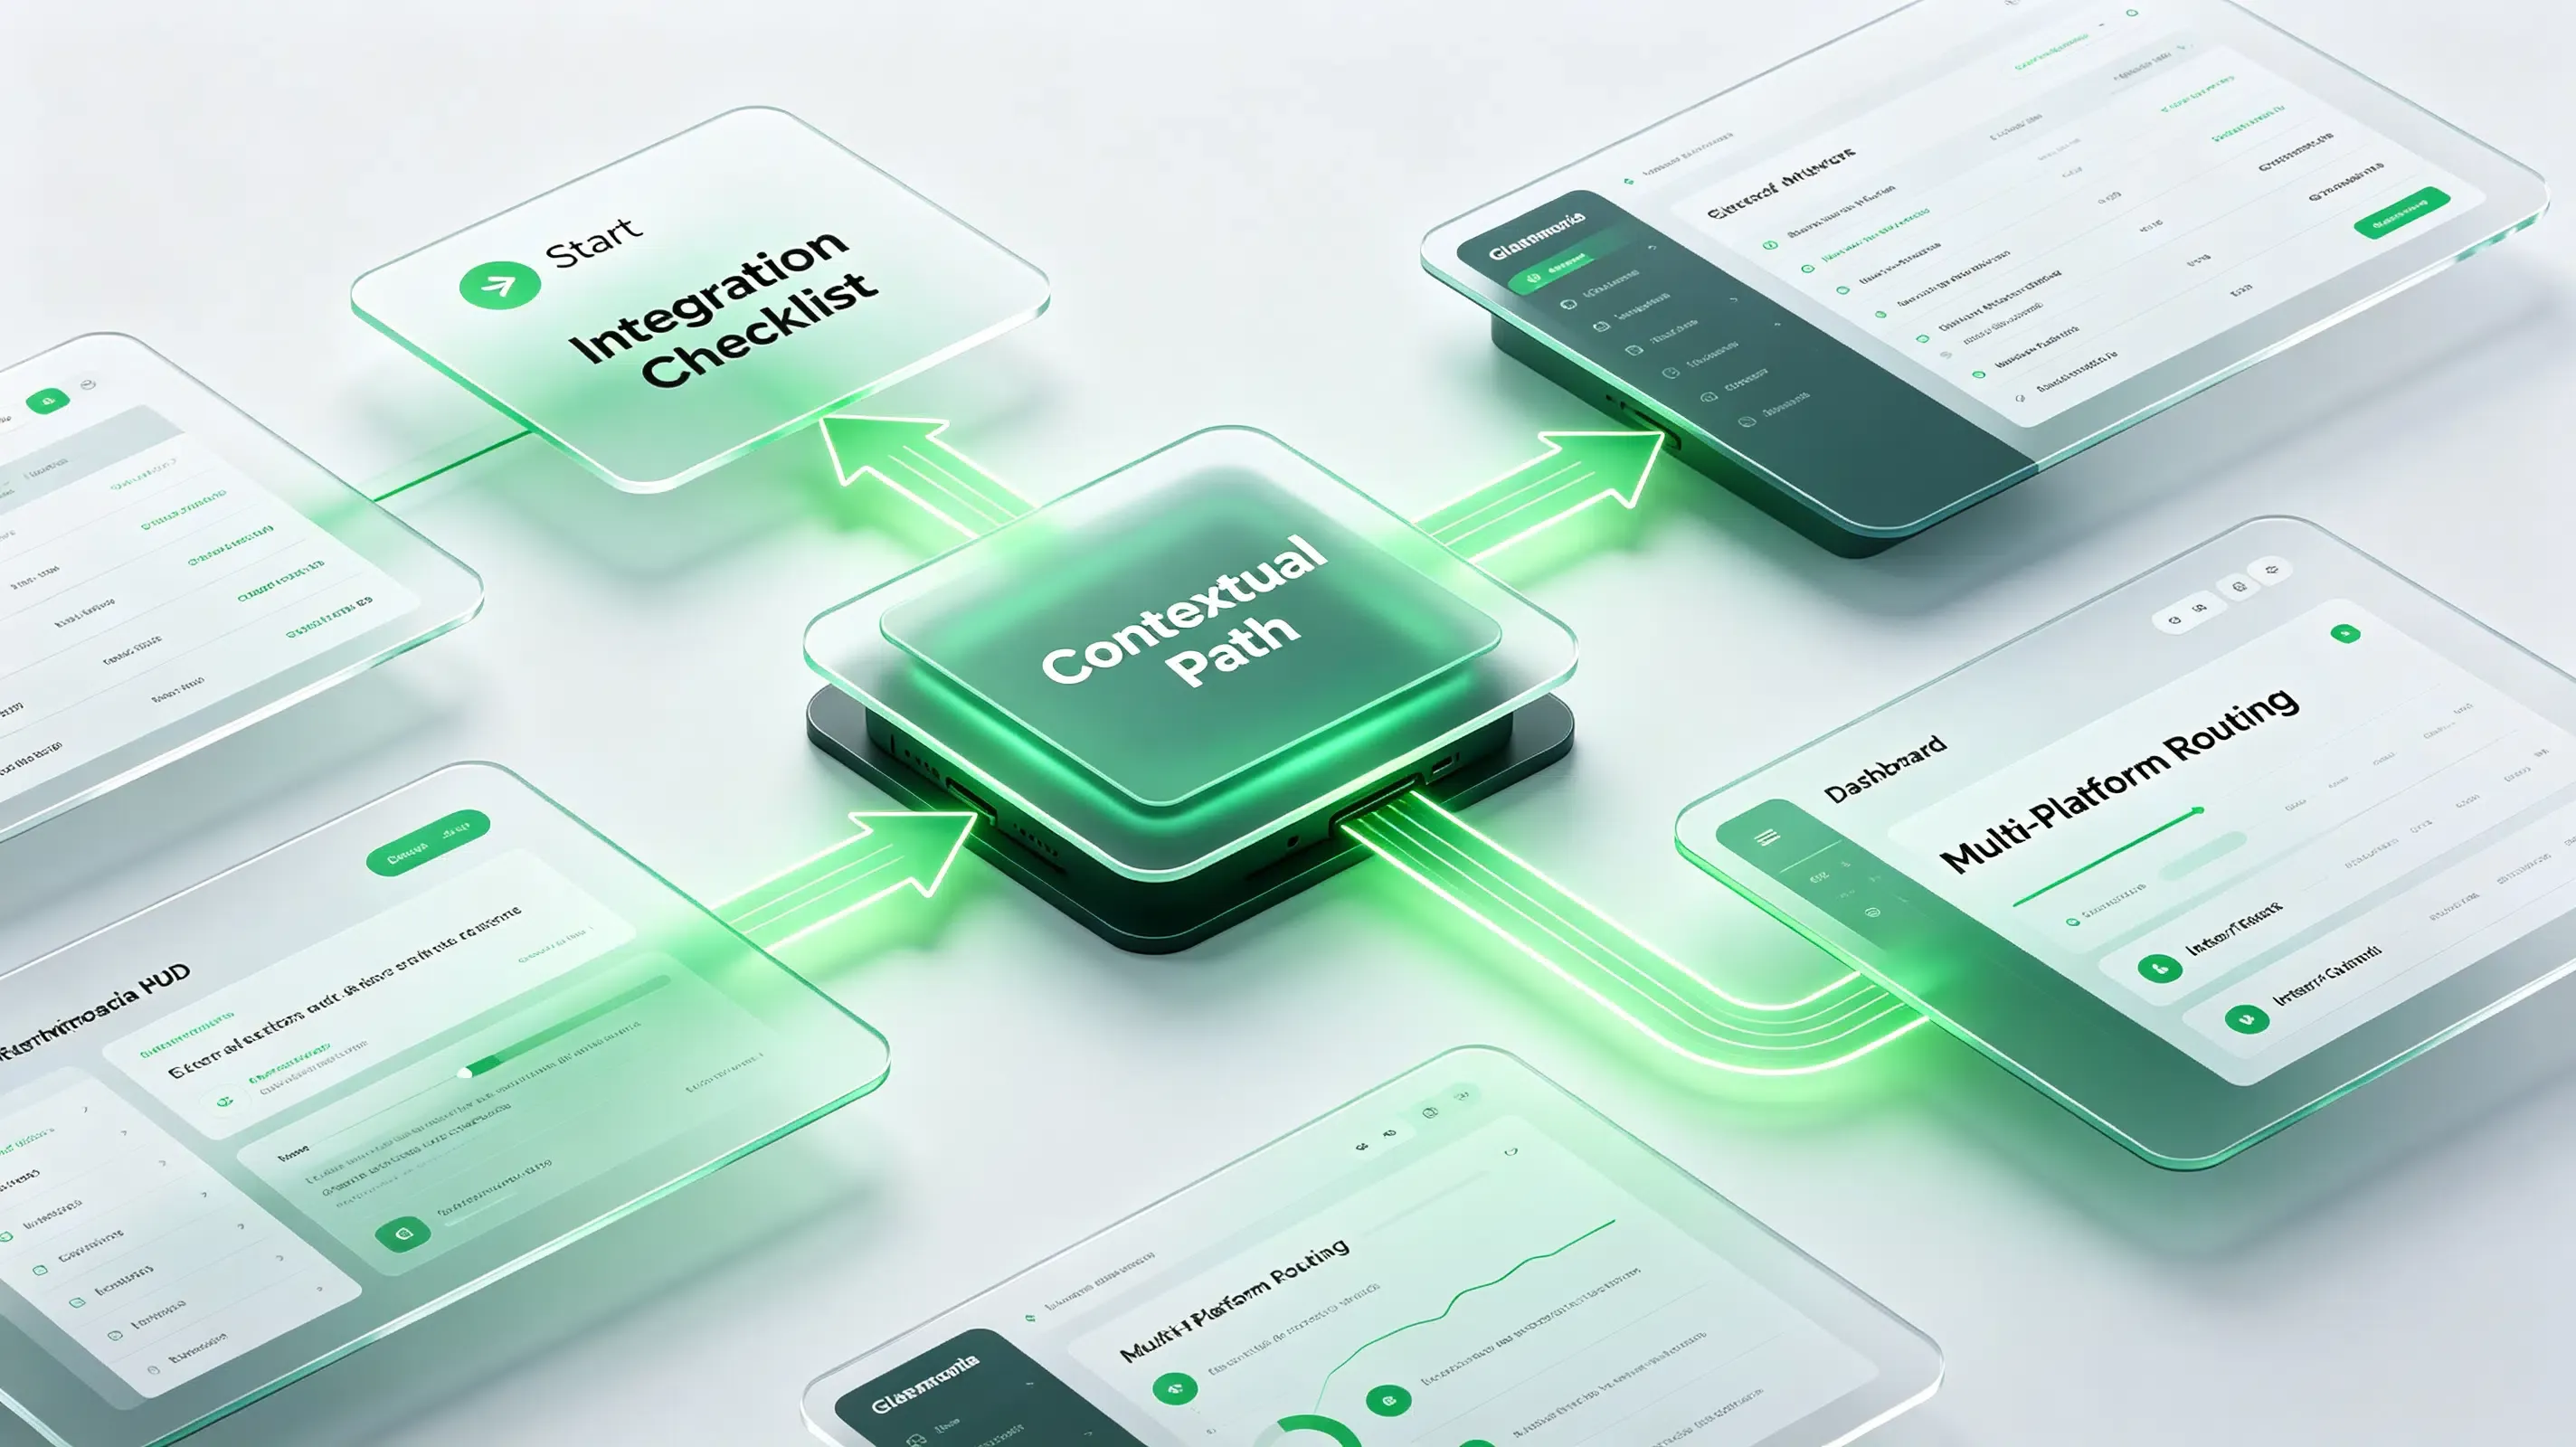
Checklist de Integração de Aplicação Generativa
Para garantir a continuidade dos dados antes de lançar suas novas aplicações, as equipes de engenharia devem executar os seguintes passos:
- Verificação de Caminho Contextual: Audite como o compilador de IA mapeia os parâmetros de URL personalizados para garantir a sobrevivência do deep-link.
- Preservação de Referência Headless: Mapeie cabeçalhos HTTP alternativos para capturar parâmetros de referência durante leituras de código QR e execuções de mini-programas.
- Testes de Sandbox de Telemetria: Garanta que o relatório de dados locais não dispare avisos de fraude em ambientes de teste sandbox.
- Verificações de Roteamento Multi-Plataforma: Alinhe Universal Links com esquemas de mini-programas do WeChat para evitar atrito do usuário durante Hand-Offs entre telas.
Em migrações de sistema típicas, desenvolvedores frequentemente encontram uma parcela notável de tráfego sendo processada por scrapers automatizados. Rastrear essas interações programáticas revela que os contextos de referência são frequentemente removidos, confirmando que os frameworks de rastreamento tradicionais são menos confiáveis em configurações automatizadas.
Perguntas Frequentes (FAQ)
O 'damax' da Amap afeta as lojas de aplicativos existentes?
Como apps automatizados sobrevivem sem ambientes locais de desenvolvimento?
Como a atribuição de referência pode sobreviver quando novos apps são lançados programaticamente?
A aposentadoria do ciclo de desenvolvimento de aplicações visual e orientado a humanos destaca uma mudança fundamental em direção a protocolos de comunicação baseados em backend e fluxos de trabalho assistidos por IA. À medida que as aplicações se comunicam cada vez mais através de trocas de dados automatizadas em vez de layouts renderizados por humanos, as equipes de engenharia devem reavaliar as estratégias de integração tradicionais. Plataformas que dependem fortemente de ações manuais e visuais do usuário podem enfrentar lacunas estruturais quando agentes automatizados gerenciam o pipeline de requisições. A transição para atribuição no lado do servidor e passagem segura de parâmetros representa uma direção altamente provável para manter rastreamento confiável e cobertura de segurança.
Essa transição sugere uma reescrita fundamental de nossos frameworks de mensuração e protocolos de segurança. Sistemas de atribuição futuros provavelmente dependerão mais fortemente de correspondência de identidade no lado do servidor e sincronização segura de estado. À medida que mais agentes de IA começam a atuar como o primeiro consumidor de comunicação digital, as arquiteturas de atribuição dependerão cada vez mais da identidade no servidor, recuperação de estado diferida e preservação de contexto em nível de protocolo, em vez de apenas sessões de navegador.
Share this article



