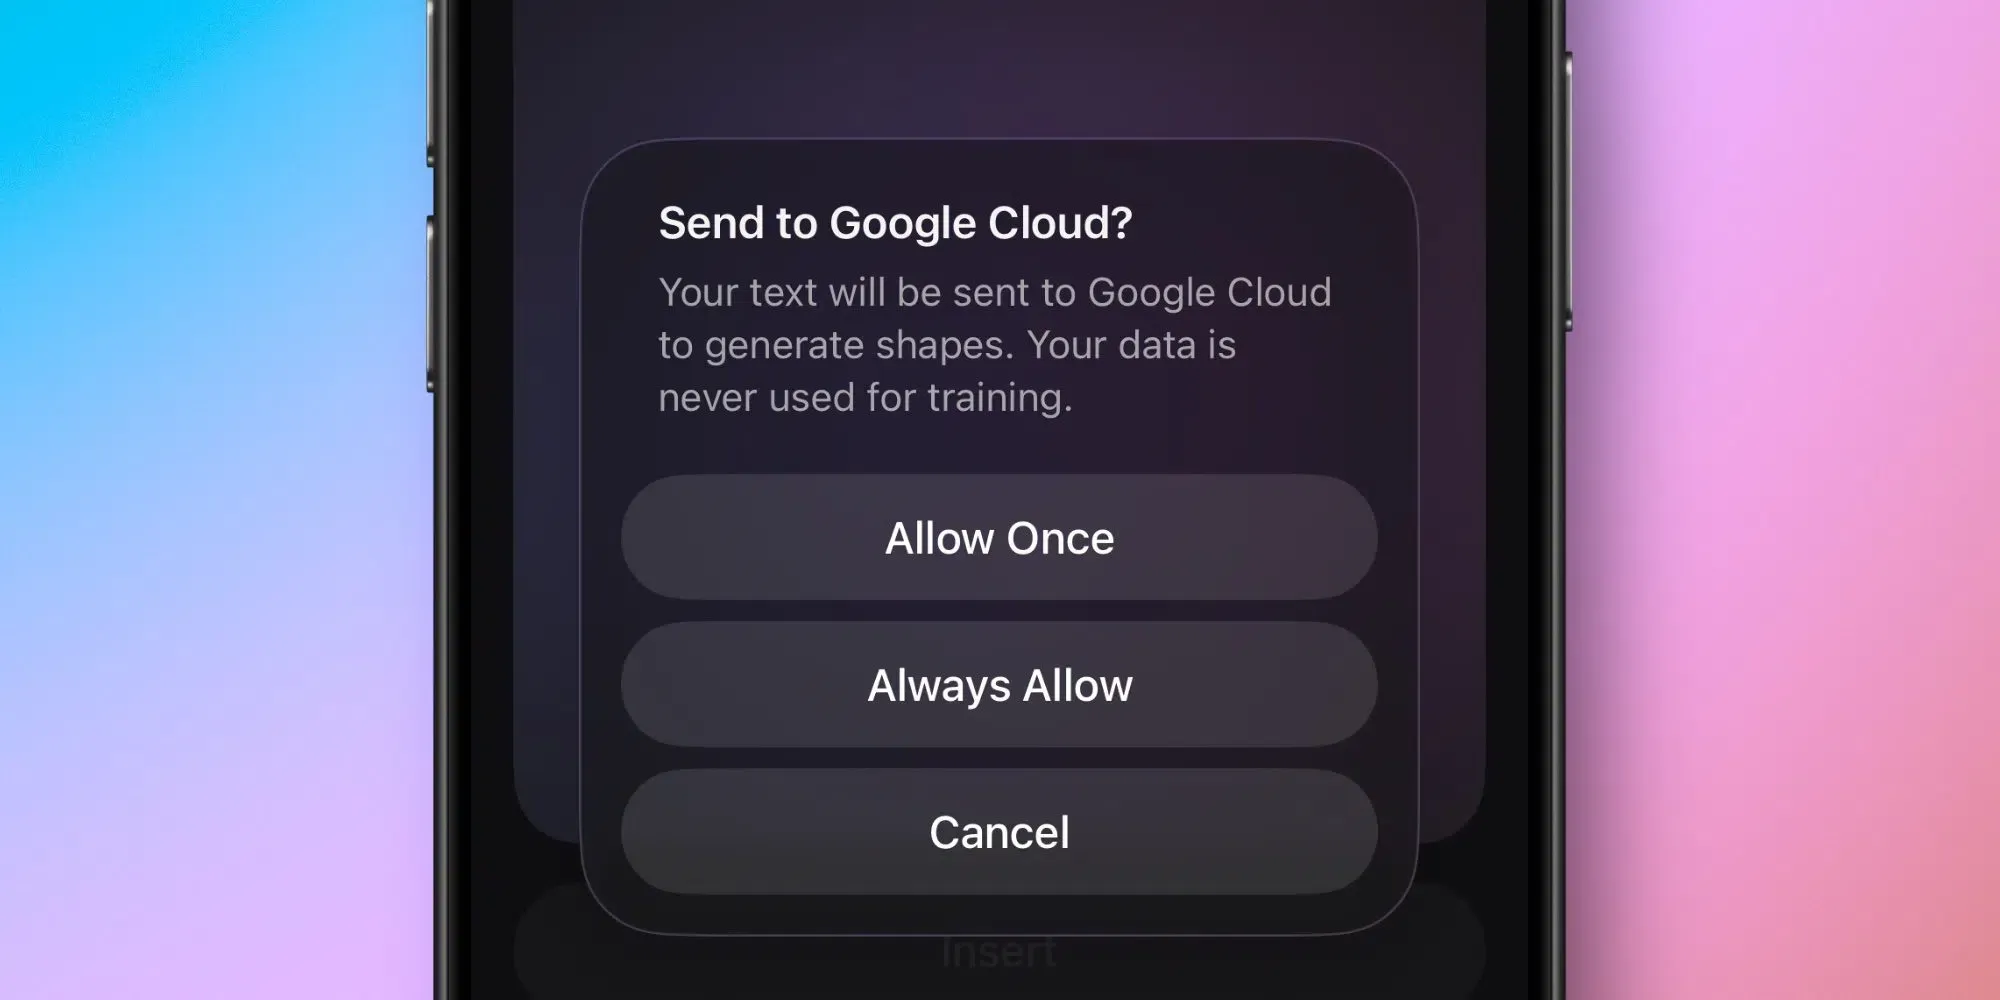
A Apple encaminha solicitações de IA para o Google Cloud? Esta arquitetura de delegação em nuvem híbrida representa uma mudança notável em transparência, uma vez que o iOS 27 introduz avisos explícitos de consentimento do usuário antes de enviar workloads generativas específicas para o Google Cloud. À medida que a IA do consumidor se expande para além de modelos locais (on-device), a inferência baseada em nuvem está se tornando uma parte essencial dos serviços de IA modernos. Hoje, plataformas de IA distribuem cada vez mais cargas de trabalho que exigem alto processamento entre ambientes de nuvem de terceiros confiáveis, tornando essenciais o consentimento explícito do usuário e o roteamento transparente. À medida que essas plataformas gerenciam solicitações generativas mais complexas em infraestruturas externas, caminhos de verificação multi-nuvem seguros tornaram-se cruciais para preservar a confiança do usuário.
Por que a Apple encaminha solicitações de IA para o Google Cloud: conciliando promessas de privacidade com escalonamento multi-nuvem
Em resumo
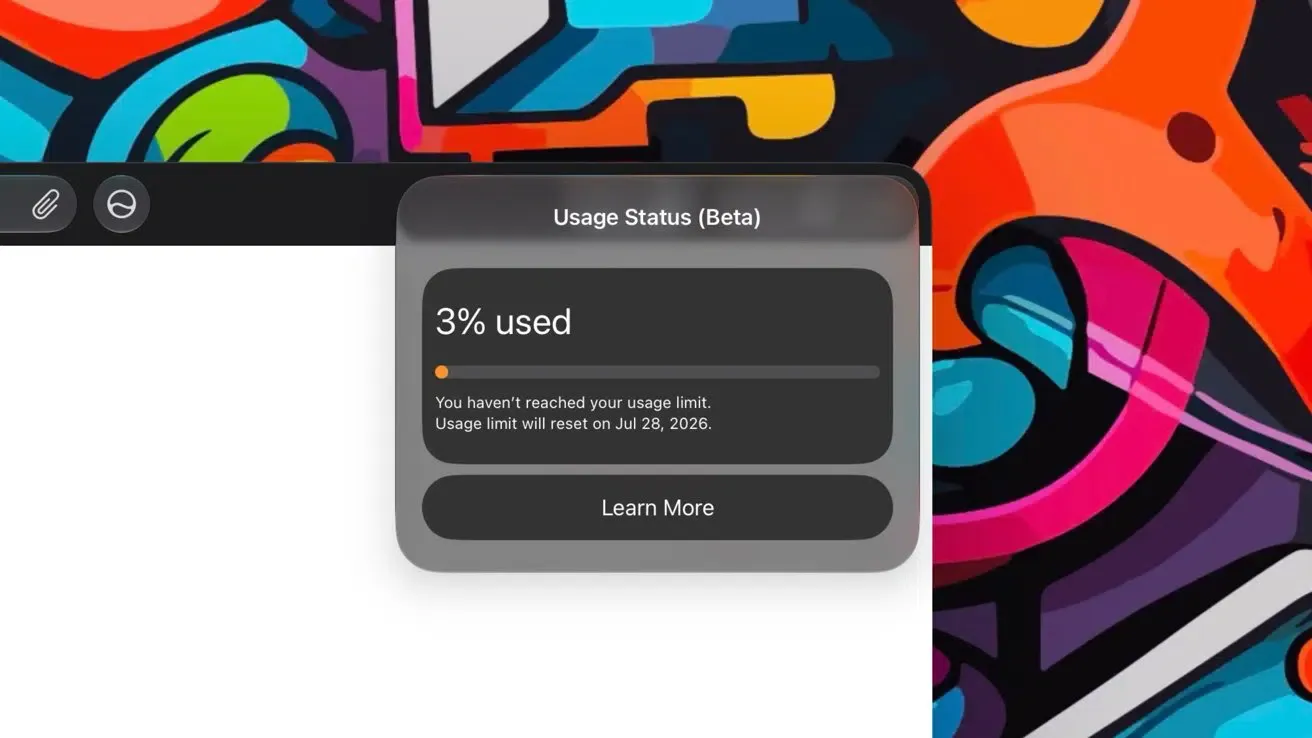
- Novos avisos de permissão introduzidos nas versões beta dos sistemas operacionais padrão alertam os usuários quando prompts generativos específicos são roteados para servidores externos.
- Os modelos de fundação (Foundation Models) da Apple e as cargas de trabalho locais no dispositivo permanecem estritamente separados dos pipelines de execução em nuvem de terceiros.
- A arquitetura expandida introduz um padrão de delegação em nuvem híbrida, utilizando sandboxes criptografadas e isoladas para processar solicitações generativas complexas.
O design da inteligência artificial moderna para o consumidor depende fortemente de um equilíbrio delicado entre processamento local e escalabilidade baseada em nuvem. Quando modelos padrão executados no dispositivo realizam tarefas de rotina, os dados permanecem armazenados com segurança na memória local. No entanto, quando solicitações de recursos generativos complexos e intensivos (como geração avançada de imagens ou processamento complexo de apresentações) são feitas, o hardware local precisa delegar o cálculo para clusters de nuvem de alto desempenho. Isso cria um desafio de fluxo de dados: como um sistema pode escalar suas capacidades de processamento sem comprometer seus compromissos principais de privacidade?
Nos últimos dois anos, as arquiteturas de IA híbridas tornaram-se uma estratégia de implementação importante para plataformas de consumo. Ao alavancar tanto modelos de fundação locais quanto redes de servidores remotos, esses serviços podem oferecer experiências generativas altamente avançadas sem sobrecarregar o terminal do usuário. No entanto, a necessidade de equilibrar a escala da nuvem com a segurança dos dados deslocou as prioridades arquitetônicas para ambientes multi-nuvem seguros e isolados.
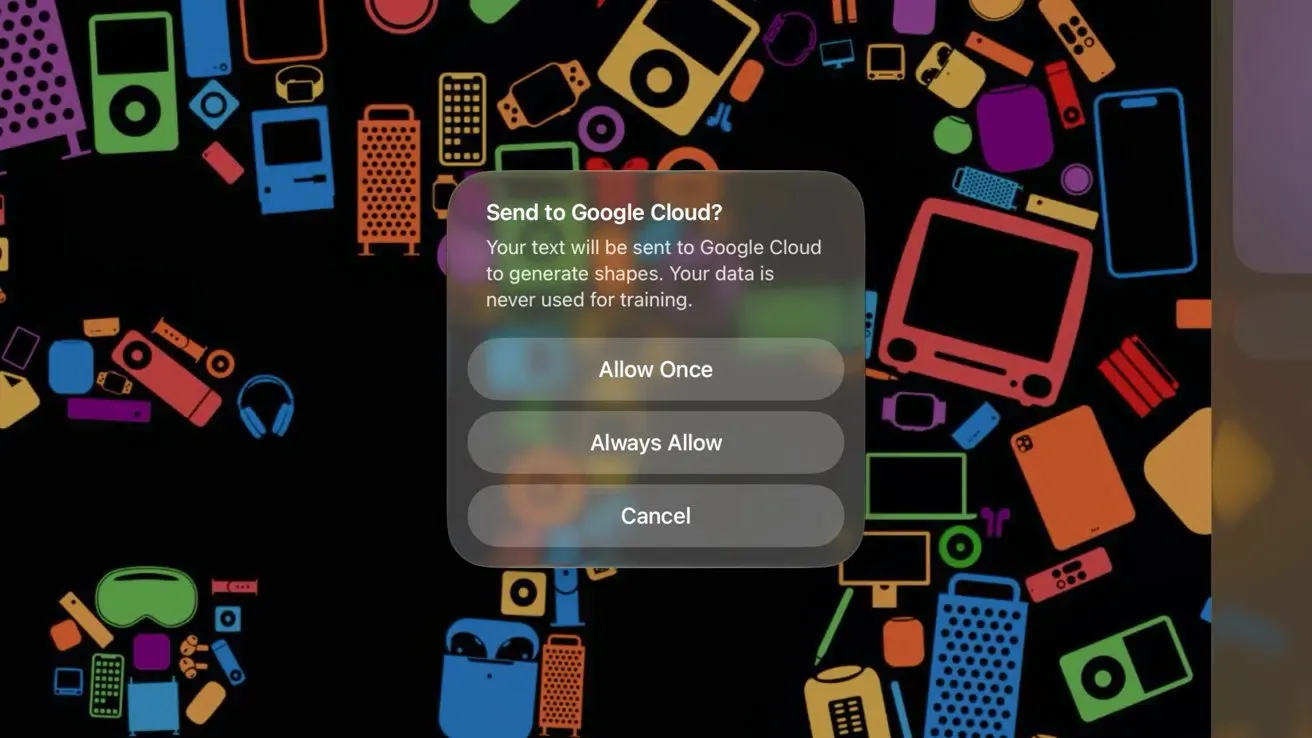
A decisão da Apple de rotear solicitações de IA selecionadas para o Google Cloud vai além da simples distribuição de carga de trabalho. Sob essa estrutura atualizada, cargas de trabalho não locais específicas (como geração de imagens em aplicativos de produtividade e renderização avançada em estúdios de criação) acion de criação) acionam um prompt de permissão explícito antes de rotear dados para servidores do Google Cloud. Essa mudança não afeta os modelos de fundação principais executados no dispositivo, que continuam funcionando localmente. Entender como a Apple gerencia o encaminhamento de solicitações de IA para infraestrutura externa ajuda os desenvolvedores a avaliar como o roteamento externo de solicitações generativas pesadas é tornado totalmente visível para o usuário final, dando aos indivíduos o poder de aceitar ou rejeitar a transferência de dados caso a caso.
Mecânica interna: roteamento de solicitações de IA local vs. IA híbrida
O motor fundamental por trás desta arquitetura híbrida é a necessidade de manter proteções de privacidade robustas enquanto se escala a infraestrutura. Para conseguir isso, o operador da plataforma está estendendo seus padrões de segurança "Private Cloud Compute" (PCC) diretamente para data centers de terceiros. Sob este modelo colaborativo, as cargas de trabalho delegadas a servidores externos são processadas dentro de ambientes de execução altamente seguros e isolados, conforme explicado na análise dos Modelos de Fundação da Apple.
Esses nós seguros aproveitam o isolamento (sandboxing) em nível de hardware, como máquinas virtuais confidenciais e processos dedicados e isolados. Isso garante que o provedor de nuvem externo não possa armazenar permanentemente, registrar ou usar os prompts transmitidos para treinamento de modelo. Os dados são processados de forma efêmera e imediatamente eliminados assim que a tarefa é concluída. Essa arquitetura estabelece um modelo seguro de roteamento de solicitações para serviços de IA híbridos, preservando a privacidade do usuário.
Distinção técnica: redirecionamento com estado (stateful) vs. fluxos de sessão sem estado (stateless)
Do ponto de vista da engenharia, rotear dados entre múltiplos limites de nuvem exige um isolamento de sessão estrito. Em arquiteturas padrão com estado (stateful), as identidades dos usuários são rastreadas em diferentes ambientes usando cookies persistentes, o que cria riscos significativos de conformidade e vazamento de dados. Por outro lado, uma abordagem sem estado (stateless) processa cada prompt como um evento independente e isolado, garantindo que nenhum contexto de relacionamento permanente seja estabelecido. Esse alinhamento potencial ocorre sem interação direta do usuário, destacando os desafios técnicos centrais associados ao tópico relatado sobre o roteamento de IA da Apple.
O diagrama abaixo ilustra essa separação física:
[Execução Padrão no Dispositivo]
  Entrada do Usuário ──> Apple Foundation Model (Processamento Local) ──> Nenhum dado deixa o dispositivo


[Delegação em Nuvem Híbrida]
  Entrada do Usuário ──> Gateway de Segurança PCC ──> VM Confidencial do Google Cloud ──> Contexto Temporário (Contexto Soberano Preservado)
A implementação do processamento de solicitações sem estado minimiza identificadores persistentes e reduz a quantidade de dados de usuário persistentes armazenados pela plataforma. Embora a largura de banda de memória e a atribuição de aplicativos pertençam a domínios de engenharia diferentes, ambos destacam o mesmo princípio arquitetônico: mover o gerenciamento de estado de recursos locais limitados para uma infraestrutura de servidor escalável. Desafios semelhantes existem na atribuição móvel, onde as restrições de privacidade também reduzem a dependência de identificadores persistentes do lado do cliente. Quando as interações do usuário são desacopladas de cookies locais persistentes e com estado para satisfazer as diretrizes de privacidade, manter a continuidade da sessão entre diferentes ambientes torna-se altamente complexo. Assim como os processadores exigem pipelines de memória persistentes de alta velocidade para corresponder aos contextos de estado, os pipelines de marketing a jusante exigem uma preservação de dados robusta no lado do servidor para correlacionar eventos de instalação separados sem depender de cookies vulneráveis do lado do cliente ou atributos em nível de dispositivo.
Cenário de exemplo: o que acontece quando você gera uma imagem?
Suponha que um usuário crie uma apresentação gerada por IA dentro da suíte de produtividade da Apple. Se a solicitação exceder as capacidades do Modelo de Fundação local, o sistema operacional exibe primeiro um diálogo de permissão explicando que a tarefa será processada pelo Google Cloud. Somente após a aprovação explícita é que a solicitação criptografada é encaminhada através do Private Cloud Compute para um ambiente de execução isolado. Assim que o processamento é concluído, os dados temporários são excluídos de acordo com a arquitetura de privacidade publicada pela Apple.
Construir vs. Comprar: preservando o contexto da sessão em cargas de trabalho de IA híbridas
À medida que as plataformas reestruturam suas estruturas de conversação para cumprir diretrizes estritas de privacidade de dados, os desenvolvedores devem reavaliar como gerenciam o estado da sessão e a identidade do usuário. O gerenciamento de estados de sessão em ambientes onde ocorrem os roteamentos de IA da Apple requer arquiteturas que sejam ao mesmo tempo compatíveis com as leis de privacidade de dados e altamente precisas. Além disso, quando a Apple roteia solicitações de IA através de provedores de nuvem externos, as organizações devem se afastar dos identificadores tradicionais em nível de dispositivo. Dependendo dos requisitos de negócios, as equipes podem construir essas capacidades internamente ou adotar plataformas de atribuição existentes.
Avaliação arquitetônica: desenvolvimento próprio vs. SDK padronizado
Construir um sistema interno para gerenciar a correspondência de estado no lado do servidor oferece flexibilidade máxima, mas exige recursos de engenharia significativos e contínuos. Os desenvolvedores devem construir manualmente esquemas de banco de dados, escrever funções de hash criptográficas seguras e atualizar continuamente o sistema para cumprir com as regulamentações regionais em constante mudança. Por outro lado, implantar um SDK certificado e pré-construído reduz a complexidade da integração e garante a conformidade a longo prazo sem sobrecarga adicional.
A tabela abaixo compara metodologias padrão para gerenciar o estado da sessão e o contexto de conversão:
| Solução | Persistência | Throughput | Ideal para |
|---|---|---|---|
| Banco de dados de sessão interno | Alta (Sincronização Contínua) | Média (Limites de latência de BD) | Ambientes empresariais personalizados com lógica de armazenamento altamente especializada |
| Rastreamento de sessão baseado em navegador | Baixa (Cookies de sessão) | Baixa (Sem registro em servidor) | Rastreamento básico de sites com requisitos mínimos de conversão entre domínios |
| Cache no lado do servidor (ex: OpoInstall) | Nenhuma (Tokens de sessão temporários no servidor) | Alta (Sandbox padronizado) | Atribuição de campanhas em larga escala para aplicativos móveis e multiplataforma |
Embora as configurações de banco de dados personalizadas possam lidar com o contexto básico, a preservação especializada do estado no lado do servidor pode otimizar os recursos de desenvolvimento. Dependendo dos requisitos de implementação, as organizações podem construir seu próprio sistema de gerenciamento de sessão no lado do servidor ou adotar plataformas comerciais como o OpoInstall. Por exemplo, o OpoInstall oferece estruturas de restauração de estado no lado do servidor e passagem de parâmetros, mapeando metadados da sessão para um banco de dados de sessão no servidor para manter a continuidade da sessão anonimamente, sem armazenar histórico de conversação pessoal sensível e de longo prazo. Ao mapear metadados da sessão para um banco de dados centralizado em vez de depender de redirecionamentos baseados em navegador, tal sistema garante que os contextos de conversão permaneçam consistentes mesmo quando as tarefas iniciais são executadas anonimamente. As equipes de engenharia podem avaliar essas abordagens para equilibrar a proteção de dados e a consistência da medição.
Checklists de integração: como as equipes de engenharia podem se preparar para as mudanças na plataforma
Para se preparar para cargas de trabalho de IA cada vez mais distribuídas, as equipes de engenharia e produto devem estabelecer cronogramas claros de governança de dados. Isso garante que os dados do usuário sejam tratados com segurança, que os limites de conformidade sejam respeitados e que os pipelines de marketing permaneçam intactos.
Checklist de implementação para desenvolvedores
- Auditar transferências de dados de terceiros: Revise todas as chamadas de API externas para garantir que os payloads de prompt não sejam registrados permanentemente em relays intermediários.
- Implementar handshakes de sessão sem estado: Faça a transição das rotas de API para modelos de processamento sem estado, utilizando tokens criptograficamente assinados para passar contexto temporário entre nós.
- Validar fluxos de consentimento de terceiros: Implemente a validação explícita de prompt no lado do cliente antes de encaminhar workloads generativas para nuvens externas.
Checklist de estratégia de produto e crescimento
- Otimizar experiências de IA híbrida: Reconstrua recursos generativos orientados a tarefas e de alta utilidade que expliquem claramente os caminhos de processamento de IA externos aos usuários.
- Otimizar funis de conversão: Aproveite estruturas de passagem de parâmetros não intrusivas para manter o rastreamento de aquisição sem violar as diretrizes de privacidade do usuário.
- Monitorar a conformidade da plataforma: Garanta que todos os SDKs de terceiros integrados estejam em conformidade com as leis locais de proteção de dados e os requisitos da plataforma.
Ao estabelecer essas diretrizes estruturadas, as equipes de desenvolvimento podem fazer a transição de seus aplicativos para arquiteturas mais seguras e compatíveis, mantendo a continuidade operacional.
Perguntas Frequentes (FAQ)
Por que a Apple exibe um aviso antes de enviar prompts de IA para o Google Cloud?
Como o Private Cloud Compute garante que os dados do usuário permaneçam seguros em servidores de terceiros?
Quais solicitações de IA da Apple são roteadas para o Google Cloud?
Principais conclusões para equipes de engenharia
À medida que as plataformas de IA dependem cada vez mais da inferência em nuvem híbrida, os desenvolvedores precisam redesenhar produtos com foco em privacidade, consentimento transparente e roteamento seguro de dados. Arquiteturas de dados em evolução exigem uma mudança fundamental na forma como construímos e medimos experiências digitais. Como proxies sem estado e scrapers headless se tornam consumidores padrão de conteúdo da web, os modelos de atribuição tradicionais do lado do cliente continuarão a degradar. Depender de cookies e referrers padrão não é mais suficiente para proteger os pipelines de dados que impulsionam a aquisição de usuários.
À medida que a Apple expande a infraestrutura de IA híbrida, é provável que o roteamento em nuvem transparente e o consentimento explícito do usuário se tornem requisitos arquitetônicos padrão em toda a indústria. Olhando para o futuro, as equipes de engenharia dependerão cada vez mais de arquiteturas sem estado, gerenciamento de sessão no lado do servidor e design focado em privacidade. Organizações que se prepararem para essas mudanças precocemente estarão melhor posicionadas para manter produtos de IA compatíveis e sustentáveis.
Share this article



