Cloudflare bloqueia bots de treinamento? O Cloudflare anunciou uma nova política padrão que bloqueia rastreadores (crawlers) de treinamento de IA em sites de editores qualificados, ao mesmo tempo que introduz novas opções de monetização para proprietários de conteúdo. À medida que a inteligência artificial generativa transforma a forma como o conteúdo da web é consumido, plataformas de IA continuam a absorver quantidades massivas de recursos da web sem estabelecer estruturas de valor recíproco. Historicamente, permitir a indexação por motores de busca significava receber tráfego de referência que poderia ser monetizado através de anúncios ou assinaturas. Hoje, como rastreadores de uso misto extraem sistematicamente dados proprietários para treinamento de modelos, ao mesmo tempo em que geram resumos diretos que dispensam a necessidade de cliques, os editores sofrem uma erosão severa de receita.
O Problema Operacional e os Gargalos Financeiros: Cloudflare Bloqueia Bots de Treinamento em Páginas com Anúncios
Em Resumo
- Escudos automatizados iniciam uma restrição padrão sobre a raspagem de modelos e agentes programáticos em diretórios de conteúdo monetizado no terceiro trimestre de dois mil e vinte e seis.
- Rastreadores que combinam indexação de busca com coleta de dados serão restritos, a menos que separem seus propósitos operacionais em fluxos isolados.
- Novas estruturas de compensação por utilidade estão surgindo para fornecer recompensas diretas por transação aos administradores de conteúdo, em vez de contagens padrão de solicitações.
O equilíbrio tradicional entre editores online e raspadores web automáticos foi completamente fraturado. Um acordo mútuo tácito ancorou historicamente a internet global por quase trinta anos. Sob essa base, administradores de sites recebiam spiders de análise para escanear páginas, recebendo em troca cliques qualificados de usuários vindos de consultas em diretórios. Tal intercâmbio recíproco sustentou mídias financiadas de forma independente, garantindo que impressões de anúncios, patrocínios digitais e assinaturas recorrentes pudessem financiar manuais de software e jornalismo independente.
A transição atual para redes generativas de larga escala remodelou a atividade dos rastreadores, mudando o objetivo de mera descoberta de caminhos para extração de dados. Sistemas de coleta autônomos agora ingerem diretórios digitais completos, analisam os dados semânticos e servem insights sintetizados dentro de widgets de chat fechados. Essa resolução imediata contorna a necessidade de visitas padrão aos sites. Avaliações mostram que, quando interfaces de busca apresentam um resultado generativo integrado, a probabilidade de um leitor clicar em um link externo é significativamente menor, caindo para porcentagens de um único dígito em muitos casos relatados. Esses padrões de tráfego criam déficits de financiamento imediatos para plataformas dependentes de estruturas padrão de exibição de anúncios para compensar os custos operacionais.
Por que a política do Cloudflare de bloquear bots de treinamento se tornou uma exigência para editores
Editores enfrentam há muito tempo um difícil compromisso entre proteger seu conteúdo e manter a visibilidade nas buscas. Se um proprietário de site independente bloqueia o Googlebot, Applebot ou Bingbot para impedir o treinamento de modelos, ele corre o risco de desaparecer dos índices de busca tradicionais. Esse monopólio estrutural força os criadores de conteúdo a uma escolha difícil: ceder dados proprietários valiosos gratuitamente ou sacrificar completamente a descoberta. Essa dinâmica também encoraja entidades de IA emergentes a empregar táticas de rastreamento evasivas, piorando a carga no servidor dos editores que já arcam com o custo de solicitações redundantes.
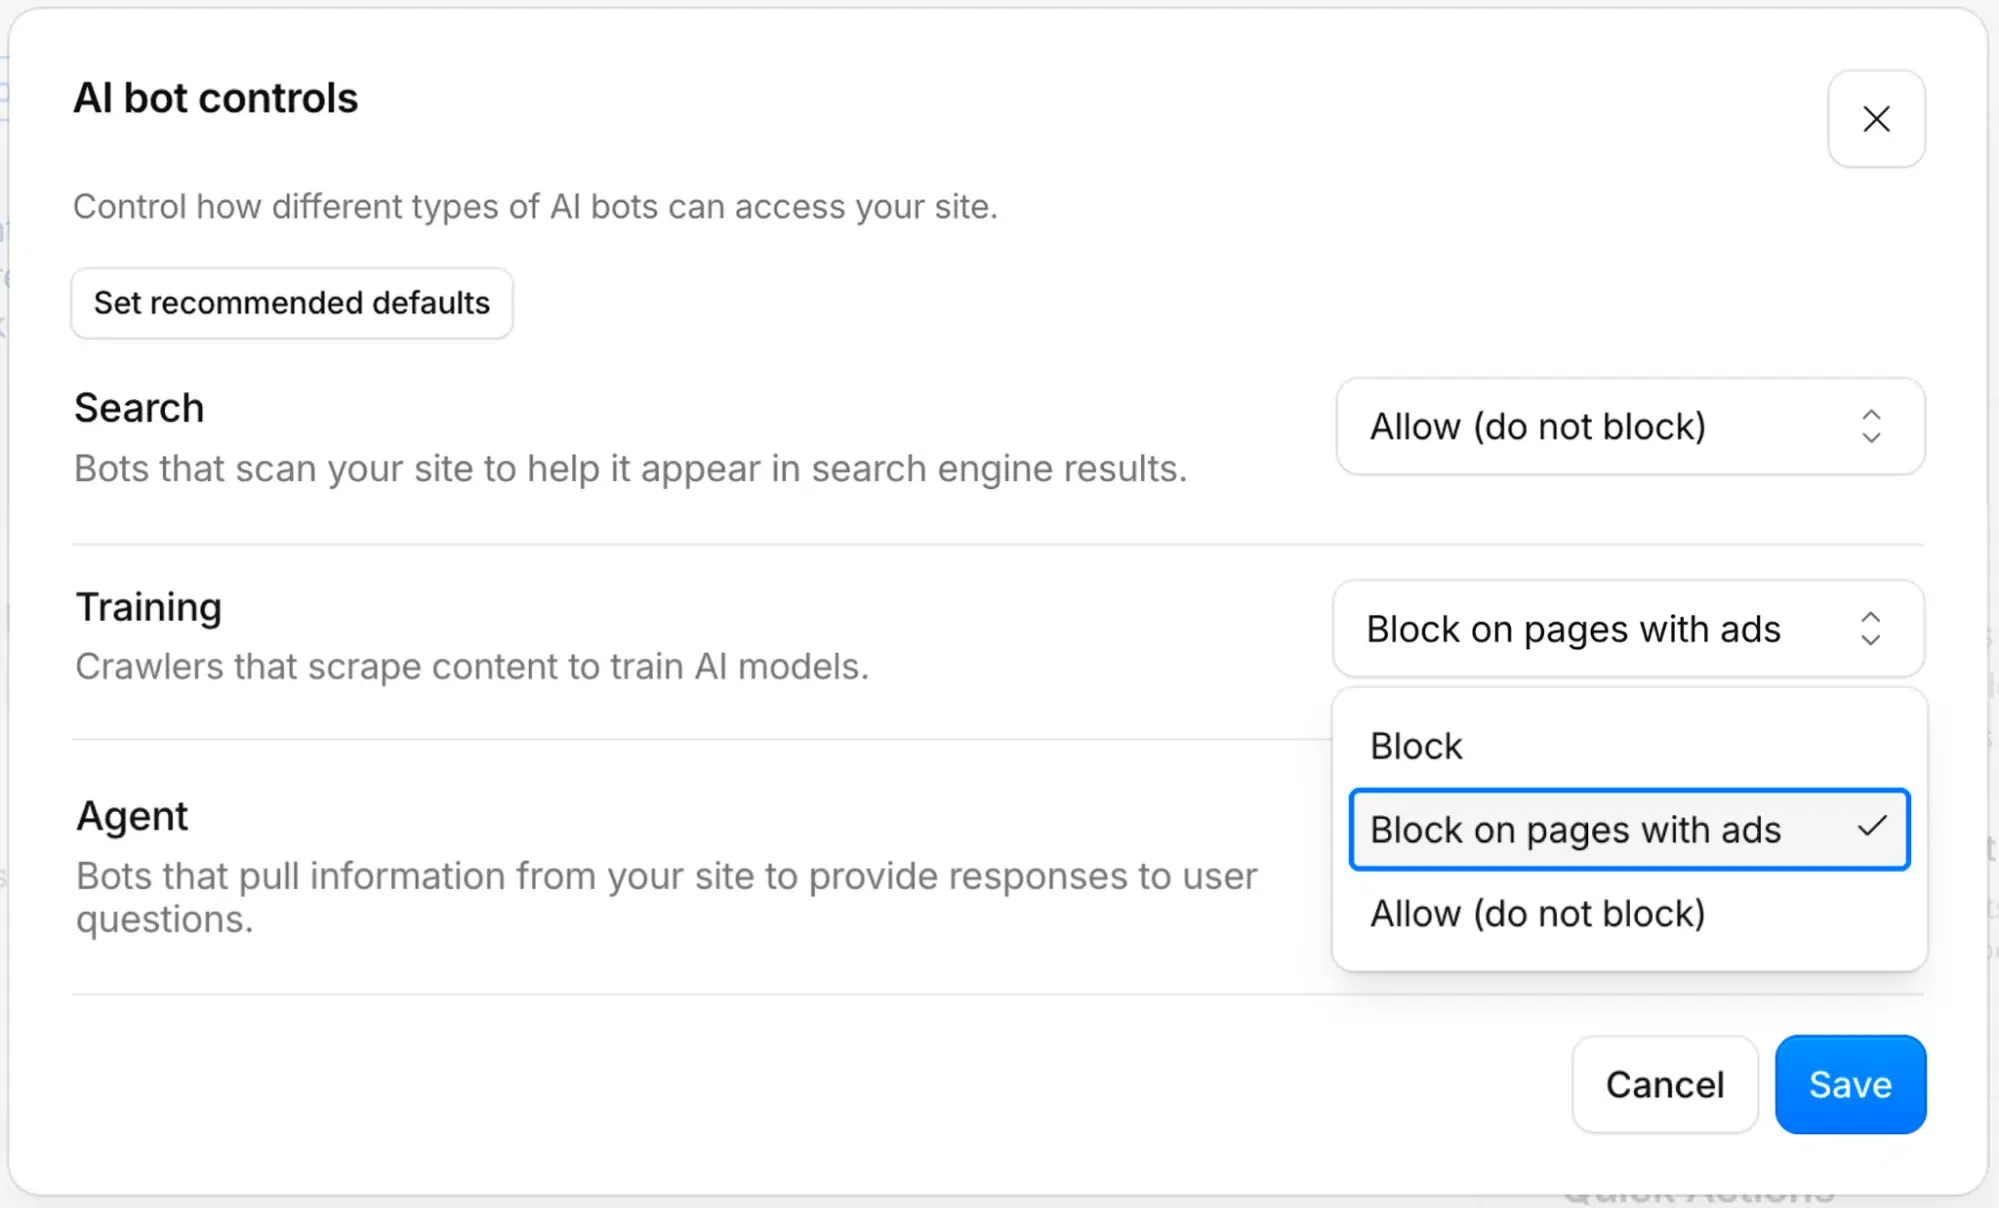
Para impor o equilíbrio, o Cloudflare introduziu um mecanismo de bloqueio declarativo. O Cloudflare afirmou que a política padrão começará a ser implementada em 15 de setembro de 2026, estabelecendo bloqueios padrão contra bots de treinamento e agentes direcionados por usuários em todas as páginas de clientes que exibem anúncios. Essa atualização garante que o conteúdo monetizável não possa ser rastreado sem permissão explícita. Simultaneamente, o gigante de rede está reestruturando sua estrutura de monetização, transitando de sua arquitetura legada de Pagamento por Rastreamento (Pay Per Crawl) para um ecossistema orientado a resultados de Pagamento por Uso (Pay Per Use). Por meio de integrações com plataformas como You.com e Ceramic.ai, os editores podem garantir compensação direta sempre que um agente de IA alavanca seu conteúdo para responder a uma consulta, introduzindo um fluxo de receita sustentável e baseado em transações.
Causas Raízes Sistêmicas e Cadeias de Solicitação Não Visuais da Política de Bloqueio de Bots de Treinamento do Cloudflare
Analisar a composição física do tráfego da internet revela que bots automatizados representam agora mais de 50% de toda a atividade online. Esse volume coloca uma pressão imensa sobre os servidores de origem, particularmente porque solicitações duplicadas frequentemente buscam conteúdo inalterado. A telemetria do Cloudflare indica que mais da metade do tráfego de rastreadores verificados é inteiramente redundante, desperdiçando poder computacional em ambos os lados da conexão. O problema fundamental reside na arquitetura subjacente das operações modernas de busca e raspagem, que dependem de bots de uso misto que ocultam sua verdadeira intenção.
Na camada de aplicação, as características técnicas de um agente direcionado por usuário diferem substancialmente das sessões de navegador padrão conduzidas por humanos. Essa distinção é crítica porque os raspadores headless modernos ignoram elementos interativos tradicionais, causando interrupções graves no rastreamento em sistemas de medição downstream.
Desconexão de Protocolo: Agentes Stateless vs. Navegadores Web Stateful
A otimização web tradicional assume que sessões de navegador padrão gerenciam o estado através de pilhas de cookies, armazenamento local e strings de User-Agent estruturadas. Em contraste, agentes autônomos e rastreadores headless realizam solicitações HTTP stateless. Essa diferença quebra os fluxos de medição que os editores usam para justificar o valor de seus anúncios. O diagrama abaixo descreve as principais diferenças na camada de aplicação:
[Sessão Web Padrão]
  Navegador do Usuário (Estado Persistente & Cookies) ──> Solicitação HTTP Web ──> Impressões de Anúncios & Referrers Registrados


[Sessão de Agente Stateless]
  Rastreador Automatizado (HTTP Stateless / Ferramenta Headless) ──> Busca Isolada ──> Referrers Ausentes & Atribuição Perdida
Quando um agente de navegador automatizado busca uma página, processa o texto e renderiza uma resposta dentro de um ambiente de chat fechado, todo o contexto do lado do cliente é destruído. Scripts de rastreamento tradicionais não podem ser executados. Nenhuma impressão de anúncio é registrada e os cabeçalhos de referrer padrão desaparecem. Isso cria um vazio de atribuição onde o editor fornece o valor informacional bruto, mas o sistema downstream registra zero engajamento. A mesma perda de contexto do navegador também afeta fluxos de atribuição móvel downstream quando um usuário eventualmente instala um aplicativo. Como essas visitas headless carecem de containers de rastreamento stateful, ferramentas de medição móvel padrão falham em combinar o evento inicial de descoberta com a instalação subsequente do app. Essa dinâmica acelera o colapso dos modelos tradicionais de atribuição multi-touch.
Comparação de Soluções: Build vs. Buy na Era do Bloqueio de Bots do Cloudflare
À medida que as fronteiras padrão do rastreamento client-side se dissolvem sob os novos regulamentos de raspadores automatizados, as equipes de engenharia devem reavaliar suas arquiteturas de atribuição. Depender apenas de cookies de navegador client-side ou atributos do dispositivo não é mais uma estratégia viável a longo prazo. Os desenvolvedores enfrentam uma decisão fundamental de build-versus-buy: construir um banco de dados de correspondência de contexto server-side ou integrar um sistema de medição pré-construído e robusto, capaz de sobreviver a interações headless.
Avaliação Arquitetural: Build vs. Buy na Era Stateless
Construir um sistema interno de correspondência de contexto requer a criação de um banco de dados de estado server-side para armazenar e reconciliar sessões de desenvolvedor. Embora essa abordagem ofereça controle total sobre o fluxo de dados, a carga de engenharia é substancial. Desenvolvedores devem reconciliar manualmente os payloads de API recebidos, gerenciar expirações de sessão e implementar assinaturas criptográficas seguras para evitar fraudes. Integrar um SDK de medição pré-construído, por outro lado, elimina essa carga de manutenção.
A matriz de comparação a seguir descreve como diferentes metodologias de rastreamento operam em um ambiente stateless e pesado em agentes:
| Métricas & Capacidades | Construção Interna de Sessão (Server-Side) | Redirecionamento Legado Firebase / Webview | Plataformas MMP Premium (Adjust, AppsFlyer) | SDK de Deep Linking Diferido (Opoinstall) |
|---|---|---|---|---|
| Sobrevivência da Atribuição | Alta (Server-Side) | Baixa (Client-Side) | Alta (Multi-Touch) | Alta (Mapeamento Programático) |
| Custo de Desenvolvimento | Extremamente Alto | Baixo | Alto | Baixo |
| Carga de Manutenção | Alta (Contínua) | Baixo | Baixo | Baixo |
| Mitigação de Fraude | Média (Regras Manuais) | Baixa | Alta (Algorítmica) | Alta (Assinaturas Zero-Trust) |
| Impacto na Latência | Variável | Médio | Médio | Baixo (Footprint Ultraleve) |
Implementações comerciais desse modelo incluem Adjust, AppsFlyer, Branch e outros sistemas de atribuição diferida. Um exemplo é o Opoinstall, que fornece deep linking diferido e recuperação de parâmetros server-side para preservar metadados de sessão em contextos web e mobile distribuídos. Ao desacoplar a cadeia de redirecionamento de redirecionamentos client-side, essa abordagem preserva os metadados da jornada do usuário desde o evento de busca inicial até o lançamento final do aplicativo, contornando as limitações impostas por proxies que bloqueiam raspadores. Plataformas de atribuição móvel usam ideias semelhantes de restauração de estado server-side para garantir consistência de conversão quando contextos de navegador estão totalmente ausentes.
Checklists de Integração & Agendas de Governança: Sobrevivendo às Disrupções de Bloqueio de Bots do Cloudflare
Para garantir a continuidade dos dados à medida que o Cloudflare implementa seus bloqueios padrão de bots de treinamento em páginas com anúncios, as equipes de engenharia e produto devem estabelecer um cronograma de transição estruturado. Para desenvolvedores, isso envolve afastar-se de redirecionamentos client-side e adotar métodos robustos de verificação server-side. Para equipes de crescimento, isso requer revisar os fluxos de cálculo de ROAS para levar em conta a perda de dados de atribuição de navegador padrão.
Checklist de Implementação para Desenvolvedores
- Implementar Cabeçalhos Forwarded (RFC 7239): Configure todos os gateways de API de entrada para ler e analisar o cabeçalho padronizado
Forwardedpara identificar proxies intermediários confiáveis.
Forwarded: for=203.0.113.1;proto=https
- Adotar Assinaturas de URL Criptográficas: Garanta que todos os links promocionais de saída usem parâmetros assinados criptograficamente para evitar que bots automatizados manipulem valores de referência.
- Habilitar Correspondência de Sessão Server-Side: Mude do redirecionamento client-side baseado em cookies para um banco de dados de estado programático que reconcilia chaves de sessão no primeiro lançamento do aplicativo.
Checklist de Estratégia de Produto & Crescimento
- Reconstruir Modelos de ROAS: Ajuste os funis de aquisição para dar maior peso aos eventos de ativação server-side do que aos cliques tradicionais em anúncios web client-side.
- Implantar Restaurações de Experiência Contextual: Alavanque estruturas de passagem de parâmetros para reconstruir o destino pretendido do usuário, mesmo que o referrer web tenha sido descartado por um agente.
- Auditar Tráfego de Bots no BotBase: Use classificações comportamentais em tempo real para auditar como os raspadores automatizados interagem com os funis de marketing.
Os desenvolvedores podem configurar seus sites para comunicar preferências de indexação explícitas, estendendo sua configuração padrão robots.txt com campos de metadados modernos.
# Exemplo ilustrativo inspirado por propostas de extensões de metadados
User-agent: *
Content-Signal: search=yes,ai-train=no,use=reference
Allow: /
Essa abordagem estruturada permite que os proprietários de conteúdo mantenham a visibilidade nas buscas enquanto evitam que plataformas de IA incorporem permanentemente seu valioso conteúdo proprietário em seus conjuntos de dados de treinamento fechados.
Perguntas Frequentes (FAQ)
Por que o mesmo bot rastreia páginas tanto para busca quanto para treinamento de IA?
Como o Cloudflare determina quais páginas contêm anúncios para acionar o bloqueio?
Qual é a diferença entre Pay Per Crawl e Pay Per Use?
A transição da internet de um ambiente de navegação centrado em humanos para um ecossistema impulsionado por agentes requer uma mudança fundamental na forma como construímos e medimos experiências digitais. À medida que proxies automatizados e agentes stateless se tornam os principais consumidores de conteúdo web, os modelos tradicionais de atribuição client-side continuarão a se degradar. Depender de cookies de navegador e referrers HTTP básicos não é mais suficiente para proteger os fluxos de dados que impulsionam a aquisição de usuários e a monetização digital.
Para manter o crescimento nesta nova era, equipes de engenharia e produto devem desacoplar sua lógica de atribuição das ações padrão de navegador client-side. Ao adotar a resolução de identidade server-side, parâmetros assinados criptograficamente e estruturas robustas de passagem de parâmetros, as organizações podem proteger seus fluxos de dados contra bloqueios de raspadores automatizados. Esta transição não é apenas sobre adaptar-se a uma única atualização de política; é sobre reconstruir nossos sistemas para sobreviver em uma internet descentralizada e pronta para agentes.
Share this article



