O Google Revela o Gemini 4 Hydrogen? O Google DeepMind introduziu oficialmente o Gemini 4 Hydrogen em 12 de novembro de 2026, posicionando o modelo como um sistema eficiente em termos de custo e de alto rendimento para engenharia de software cotidiana e fluxos de trabalho baseados em agentes em várias etapas, conforme detalhado no Anúncio Oficial do Google DeepMind. À medida que as equipes de software implantam cada vez mais agentes autônomos para navegar em repositórios e executar testes, confiar exclusivamente em grandes modelos de raciocínio de ponta cria latência perceptível e despesas de API crescentes. Embora o raciocínio arquitetônico profundo continue essencial para o design de sistemas complexos, tarefas rotineiras de engenharia, como escrever edições localizadas, executar conjuntos de testes e analisar logs de compilação, exigem execução rápida. O Hydrogen foi projetado para servir tanto como uma ferramenta autônoma para desenvolvimento de alto volume quanto como um motor de execução combinado com modelos de ponta em pipelines de roteamento de múltiplos modelos.
Realinhamento Central da Indústria: O Google Revela o Gemini 4 Hydrogen para Fluxos de Trabalho de Alto Rendimento
Em Resumo
- O Google DeepMind introduziu o Gemini 4 Hydrogen como um modelo de alto rendimento projetado para lidar com codificação rotineira, perguntas e respostas em repositórios e fluxos de trabalho baseados em agentes com menor latência do que as camadas de ponta.
- O modelo opera dentro de uma janela de contexto unificada de 1.048.576 tokens compartilhada entre entradas e saídas, com preços listados em $1,50 por milhão de tokens de entrada e $7,50 por milhão de tokens de saída.
- A disponibilidade abrange o Google AI Studio, a API do Gemini, o Android Studio, o Google Search e plataformas corporativas, com níveis de acesso que variam entre planos de consumo gratuitos e espaços de trabalho pagos para desenvolvedores.
As demandas operacionais dos fluxos de trabalho de engenharia de software evoluíram além da conclusão de código de um único prompt. Configurações de agentes modernas frequentemente acionam dezenas de etapas autônomas, incluindo a leitura de estruturas de diretórios, a inspeção de árvores de dependência, a proposta de patches e a execução de testes de regressão. Quando os desenvolvedores roteiam cada ação rotineira por meio de modelos de raciocínio de ponta, a execução da tarefa diminui significativamente. Em ambientes iterativos, até mesmo uma latência moderada em chamadas de ferramentas individuais pode se acumular em longos atrasos em ciclos de desenvolvimento automatizados.
As discussões da indústria em torno do lançamento refletem um reconhecimento crescente de que a especialização de modelos é crítica para a escalabilidade de produção. Em vez de tratar um único modelo de uso geral como a escolha padrão para todas as tarefas de desenvolvimento, as equipes estão avaliando arquiteturas em camadas. Nessas configurações, modelos de raciocínio de alta capacidade gerenciam o design do sistema e o enquadramento ambíguo de problemas, enquanto modelos de execução dedicados lidam com operações repetitivas na base de código. O Google projetou o Hydrogen para atender a essa camada operacional, oferecendo disponibilidade imediata para desenvolvedores por meio de endpoints de API padrão e ambientes programáticos.
Análise de Benchmark e Limites Técnicos do Gemini 4 Hydrogen
O Google descreve o Hydrogen como adaptado do Gemini 4 Carbon. No entanto, a documentação técnica publicada não divulga detalhes internos específicos sobre mecanismos de transferência de peso, arquitetura de tokenizador ou pipelines de destilação. As avaliações técnicas devem, portanto, concentrar-se em dados observáveis de benchmark, limites de contexto documentados e restrições operacionais relatadas, em vez de mecânicas internas inferidas.
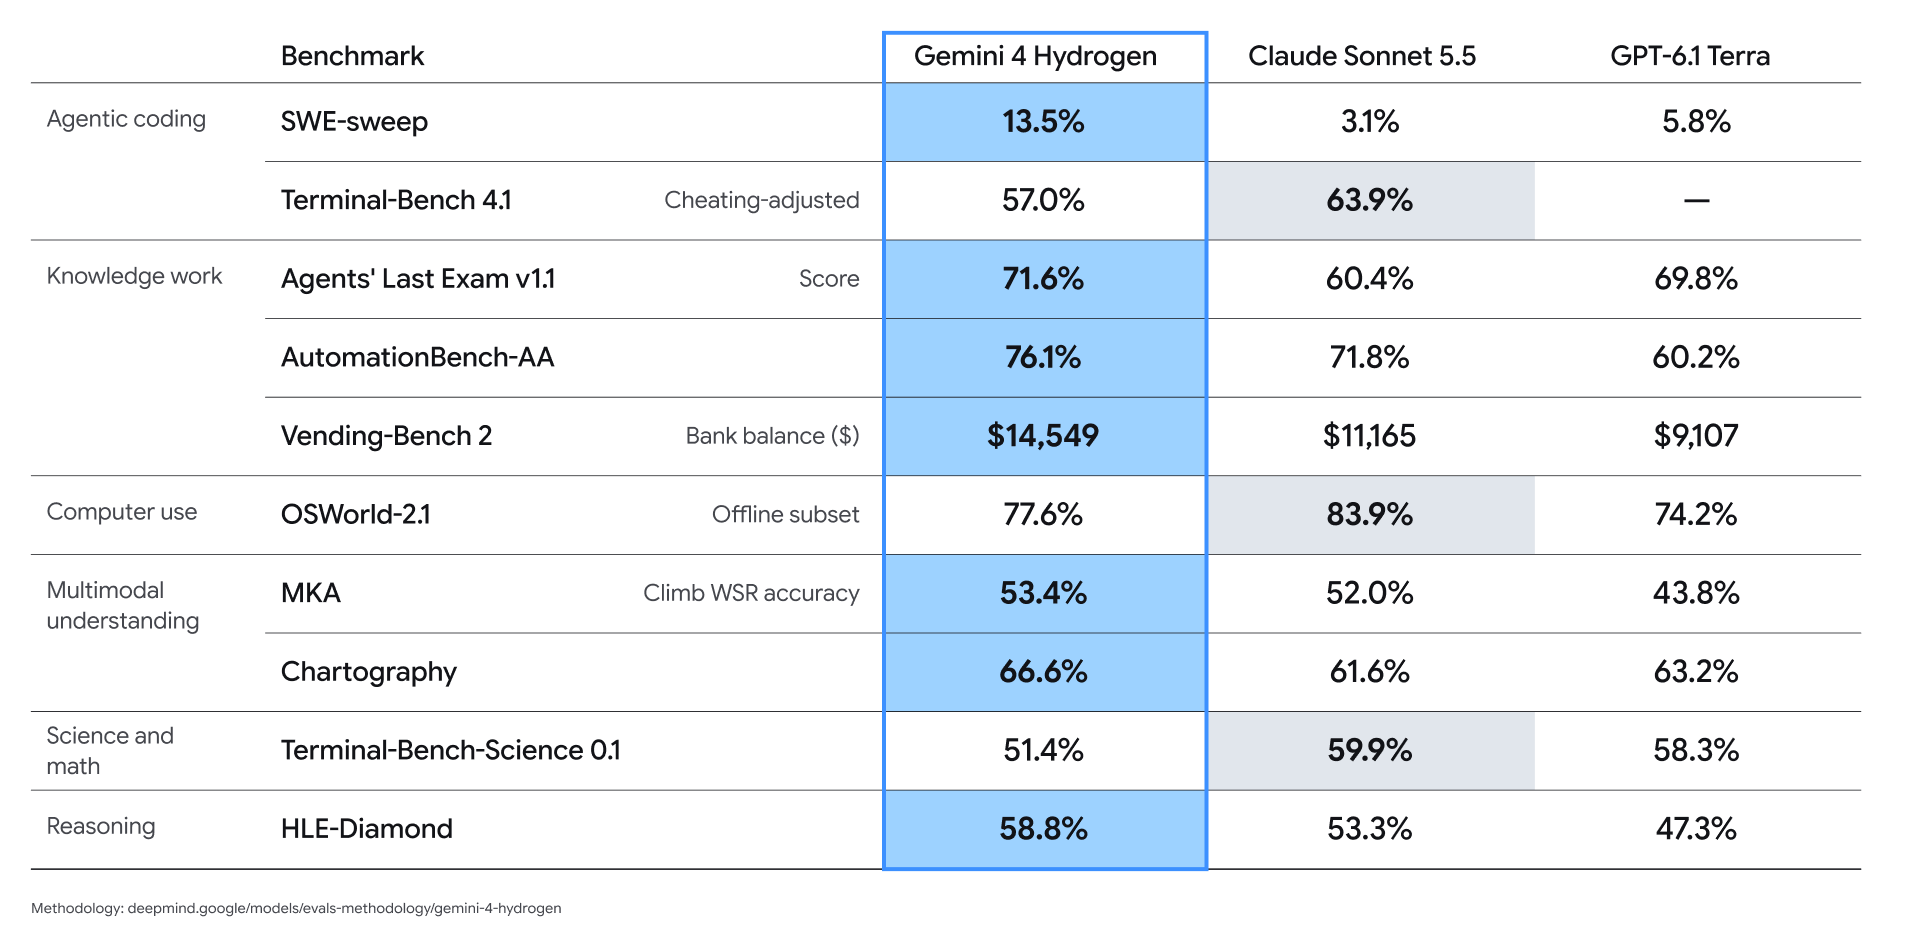
Em avaliações padrão relatadas no Cartão do Modelo Gemini 4 Hydrogen, o Hydrogen demonstra diferenças claras de desempenho entre as categorias de tarefas. No benchmark SWE-sweep para resolução de problemas, o Google relatou uma taxa de resolução de 13,5% para o Hydrogen, em comparação com 3,1% para o Claude Sonnet 5.5 e 5,8% para o GPT-6.1 Terra nas condições de avaliação especificadas. Por outro lado, no Terminal-Bench 4.1 sob parâmetros ajustados contra trapaça, o Hydrogen alcançou 57,0%, o que melhora substancialmente em relação ao Gemini 3.8 Flash (18,2%), mas fica atrás do Claude Sonnet 5.5, que registrou 63,9%. No Artificial Analysis Intelligence Index independente, o Hydrogen obteve pontuação de 51 em sua configuração padrão de pensamento alto e 54 em sua configuração xhigh, em comparação com 50 para o principal Gemini 4 Argon.
Uma consideração arquitetônica crítica é a capacidade de contexto do modelo, conforme documentado na Documentação do Modelo Google Cloud. O Hydrogen fornece um limite de contexto unificado de 1.048.576 tokens que é compartilhado entre todas as entradas e saídas. Isso significa que arquivos de entrada extensos reduzem a capacidade restante de tokens disponível para as saídas do modelo. Um único segmento de primeiro plano suporta até 65.536 tokens de saída. O uso de geração mais longa suporta mecanismos de continuação, incluindo continuação gerenciada por SDK, um loop personalizado de tokens de continuação ou execução em segundo plano gerenciada pelo servidor, quando disponível. Todos os segmentos permanecem sujeitos ao limite de contexto compartilhado. Os tokens de saída englobam tokens de raciocínio interno, solicitações de ferramentas geradas e texto visível.
[Multi-Model Orchestrator Architecture in Google Antigravity]
                         ┌────────────────────────┐
                         │  Gemini 4 Carbon/Argon │ (Planejamento Arquitetônico e Raciocínio Complexo)
                         └───────────┬────────────┘
                                     │ Delegação de Tarefas e Revisão de Plano
                                     ▼
                         ┌────────────────────────┐
                         │   Gemini 4 Hydrogen    │ (Geração de Código Paralela e Chamada de Ferramentas)
                         └───────────┬────────────┘
                                     │ Invocação de Ferramentas Estruturadas
                                     ▼
                [ Runtime Local / Conjuntos de Testes / Sistema de Arquivos ]
Para equilibrar a latência e a profundidade analítica, o Hydrogen incorpora quatro níveis de raciocínio configuráveis: baixo, médio, alto (padrão) e xhigh. Configurações mais baixas reduzem a latência de resposta para ajustes sintáticos simples, enquanto níveis mais altos alocam mais tokens de raciocínio interno para avaliar casos extremos. Os desenvolvedores devem observar que as limitações documentadas permanecem: o modelo tem um corte de conhecimento de março de 2026, pode sofrer timeouts ocasionais durante processamento pesado em segundo plano e pode produzir alucinações ou recusas excessivas em prompts ambíguos.
Sistemas Desacoplados e Concessões de Orquestração de Múltiplos Modelos
A orquestração de múltiplos modelos permite que as plataformas de desenvolvimento dividam os fluxos de trabalho de engenharia em camadas distintas de modelos. Nesse padrão, a modelagem de sistemas complexos e as avaliações de segurança são delegadas a modelos de raciocínio de ponta, enquanto edições de código concretas e asserções de teste são atribuídas a modelos de execução rápida.
O Google avaliou essa abordagem usando o Orquestrador experimental no Google Antigravity. Nos testes no Terminal-Bench 4.0, o Google relatou que a alternância dinâmica entre Carbon e Hydrogen alcançou taxas de sucesso de tarefas próximas às do Carbon, consumindo 24% menos cota e concluindo tarefas 19% mais rápido do que executar o Carbon sozinho. O Google também relatou testes iniciais com parceiros mostrando uma execução de 2× a 2,8× mais rápida e um uso de tokens de 12% a 23% menor do que o Gemini 3.8 Flash em fluxos de trabalho selecionados. Por exemplo, a Box relatou uma execução aproximadamente 2× mais rápida e 12% menos tokens em tarefas complexas de documentos e tabelas. Esses exemplos relatados por fornecedores refletem configurações de integração específicas e não representam estimativas controladas de economia em todas as implantações de produção.
| Componente do Sistema | Ferramentas Representativas | Responsabilidade Definida | Escopo Operacional e Limitações |
|---|---|---|---|
| Coordenador do Sistema | Gemini 4 Carbon / Argon | Design de arquitetura de alto nível, planejamento entre repositórios, avaliação de lógica complexa | Alta capacidade de raciocínio; incorre em custos mais altos por token e maior latência de geração |
| Motor de Execução | Gemini 4 Hydrogen | Geração de código localizada, edições de arquivos automatizadas, loops rápidos de chamada de ferramentas | Alto rendimento de geração; pode operar de forma autônoma ou sob um coordenador |
| Portão de Verificação | Conjuntos de Testes Unitários / Linters Estáticos | Verificação de regras determinísticas, validação de sintaxe, testes de regressão | Verifica asserções definidas e regras estáticas; a garantia depende da qualidade dos testes, cobertura e revisão independente |
A avaliação de uma arquitetura de múltiplos modelos exige que as equipes de engenharia equilibrem a complexidade do sistema com a eficiência de execução. Embora o roteamento dinâmico de modelos possa reduzir os gastos com tokens em tarefas repetitivas, ele introduz sobrecarga de orquestração, desafios de sincronização de estado entre subagentes e dependência de classificadores de roteamento. As equipes de engenharia devem medir essas concessões em relação às suas próprias distribuições de tarefas, estruturas de repositório e requisitos de latência de API.
Listas de Verificação de Implementação de Engenharia e Governança de Fluxo de Trabalho
A integração do Gemini 4 Hydrogen em cadeias de ferramentas automatizadas para desenvolvedores requer limites de execução claros, monitoramento de tokens e governança defensiva de agentes.
Lista de Verificação de Implementação para Desenvolvedores
- Alinhar Níveis de Pensamento às Tarefas Operacionais: Configure parâmetros de esforço de raciocínio de acordo com a complexidade da carga de trabalho. Reserve
xhighpara casos extremos algorítmicos complexos, mantenhahighcomo a linha de base padrão para navegação em repositórios e usemediumoulowpara tarefas sensíveis à latência, como reformatação de código ou consulta simples de documentação. - Estruturar Interfaces de Ferramentas Paralelas: Projete definições de ferramentas para aceitar argumentos em lote quando suportado pelo tempo de execução, permitindo que agentes de trabalhadores solicitem várias inspeções de arquivos ou verificações de sintaxe em solicitações consolidadas, em vez de idas e voltas sequenciais.
- Desacoplar a Geração do Modelo da Execução: Garanta que os modelos proponham invocações de ferramentas e modificações de código como dados estruturados, enquanto um tempo de execução de cliente isolado ou executor de teste em contêiner executa comandos e retorna resultados de execução e evidências reproduzíveis sempre que possível.
Lista de Verificação de Governança Corporativa
- Estabelecer Registro de Sessão: Registre solicitações de ferramentas, resultados de execução, decisões de permissão, alterações de código, resultados de testes e resumos de modelos disponíveis. Não trate resumos de raciocínio como rastreamentos de execução completos ou fiéis.
- Aplicar Controles de Segurança em Camadas: Trate documentação externa, rastreadores de problemas e comentários de pull requests como entradas não confiáveis. Embora o Hydrogen tenha demonstrado uma melhoria de resiliência de 2,3x no benchmark de injeção de prompt indireta Gray Swan, a sanitização automatizada de entradas e os portões de permissão de execução continuam necessários.
- Monitorar o Consumo Cumulativo de Tokens: Rastreie tokens de entrada e tokens de saída faturáveis, incluindo tokens de pensamento, usando os campos de uso da API selecionada. Não adicione tokens de pensamento novamente quando eles já estiverem incluídos no total de saída cobrado.
Perguntas Frequentes (FAQ)
Como o Gemini 4 Hydrogen se compara ao Carbon e ao Argon em cargas de trabalho de produção?
Quais são os quatro níveis de pensamento e quando os desenvolvedores devem usar o xhigh?
Como funciona o modelo de preços fixos na janela de contexto de um milhão de tokens?
Principais Conclusões para Equipes de Engenharia
Implantar ferramentas de codificação autônomas em ambientes de produção exige que as equipes de desenvolvimento olhem além das pontuações de benchmark de ponta e se concentrem na economia da execução iterativa de ferramentas. Rotear todas as modificações de rotina de código por meio de modelos de raciocínio de alta latência introduz atrasos operacionais desnecessários e inflação de orçamento. Ao mesmo tempo, gerenciar a latência de execução e as taxas de sucesso de tarefas requer expectativas realistas sobre pontuações de benchmark e comportamentos de recuperação de erros.
Ao estabelecer arquiteturas em camadas que combinam modelos de raciocínio de alta capacidade com motores de execução rápidos e previsíveis, as organizações de engenharia podem dimensionar fluxos de trabalho de desenvolvimento automatizados de forma sustentável. As equipes que implementam roteamento disciplinado de múltiplos modelos, limites de teste estruturados e validação rigorosa de entradas estarão mais bem posicionadas para construir pipelines de software assistidos por IA robustos e sustentáveis.
Referências
-
Google DeepMind. Introducing Gemini 4 Hydrogen. Anúncio Oficial.
-
Google DeepMind. Gemini 4 Hydrogen Model Card. Especificação Técnica e Relatório de Segurança.
-
Google Cloud. Gemini 4 Hydrogen Model Documentation. Referência Técnica.
-
Google Antigravity. Gemini 4 Hydrogen in Google Antigravity. Visão Geral de Orquestração de Múltiplos Modelos.
-
Artificial Analysis. Gemini 4 Hydrogen Intelligence and Latency Benchmark. Avaliação de IA Independente.
-
Ars Technica. Google Rolls Out Gemini 4 Hydrogen, Finally Replacing 3.8 Flash. Análise Técnica.
Share this article