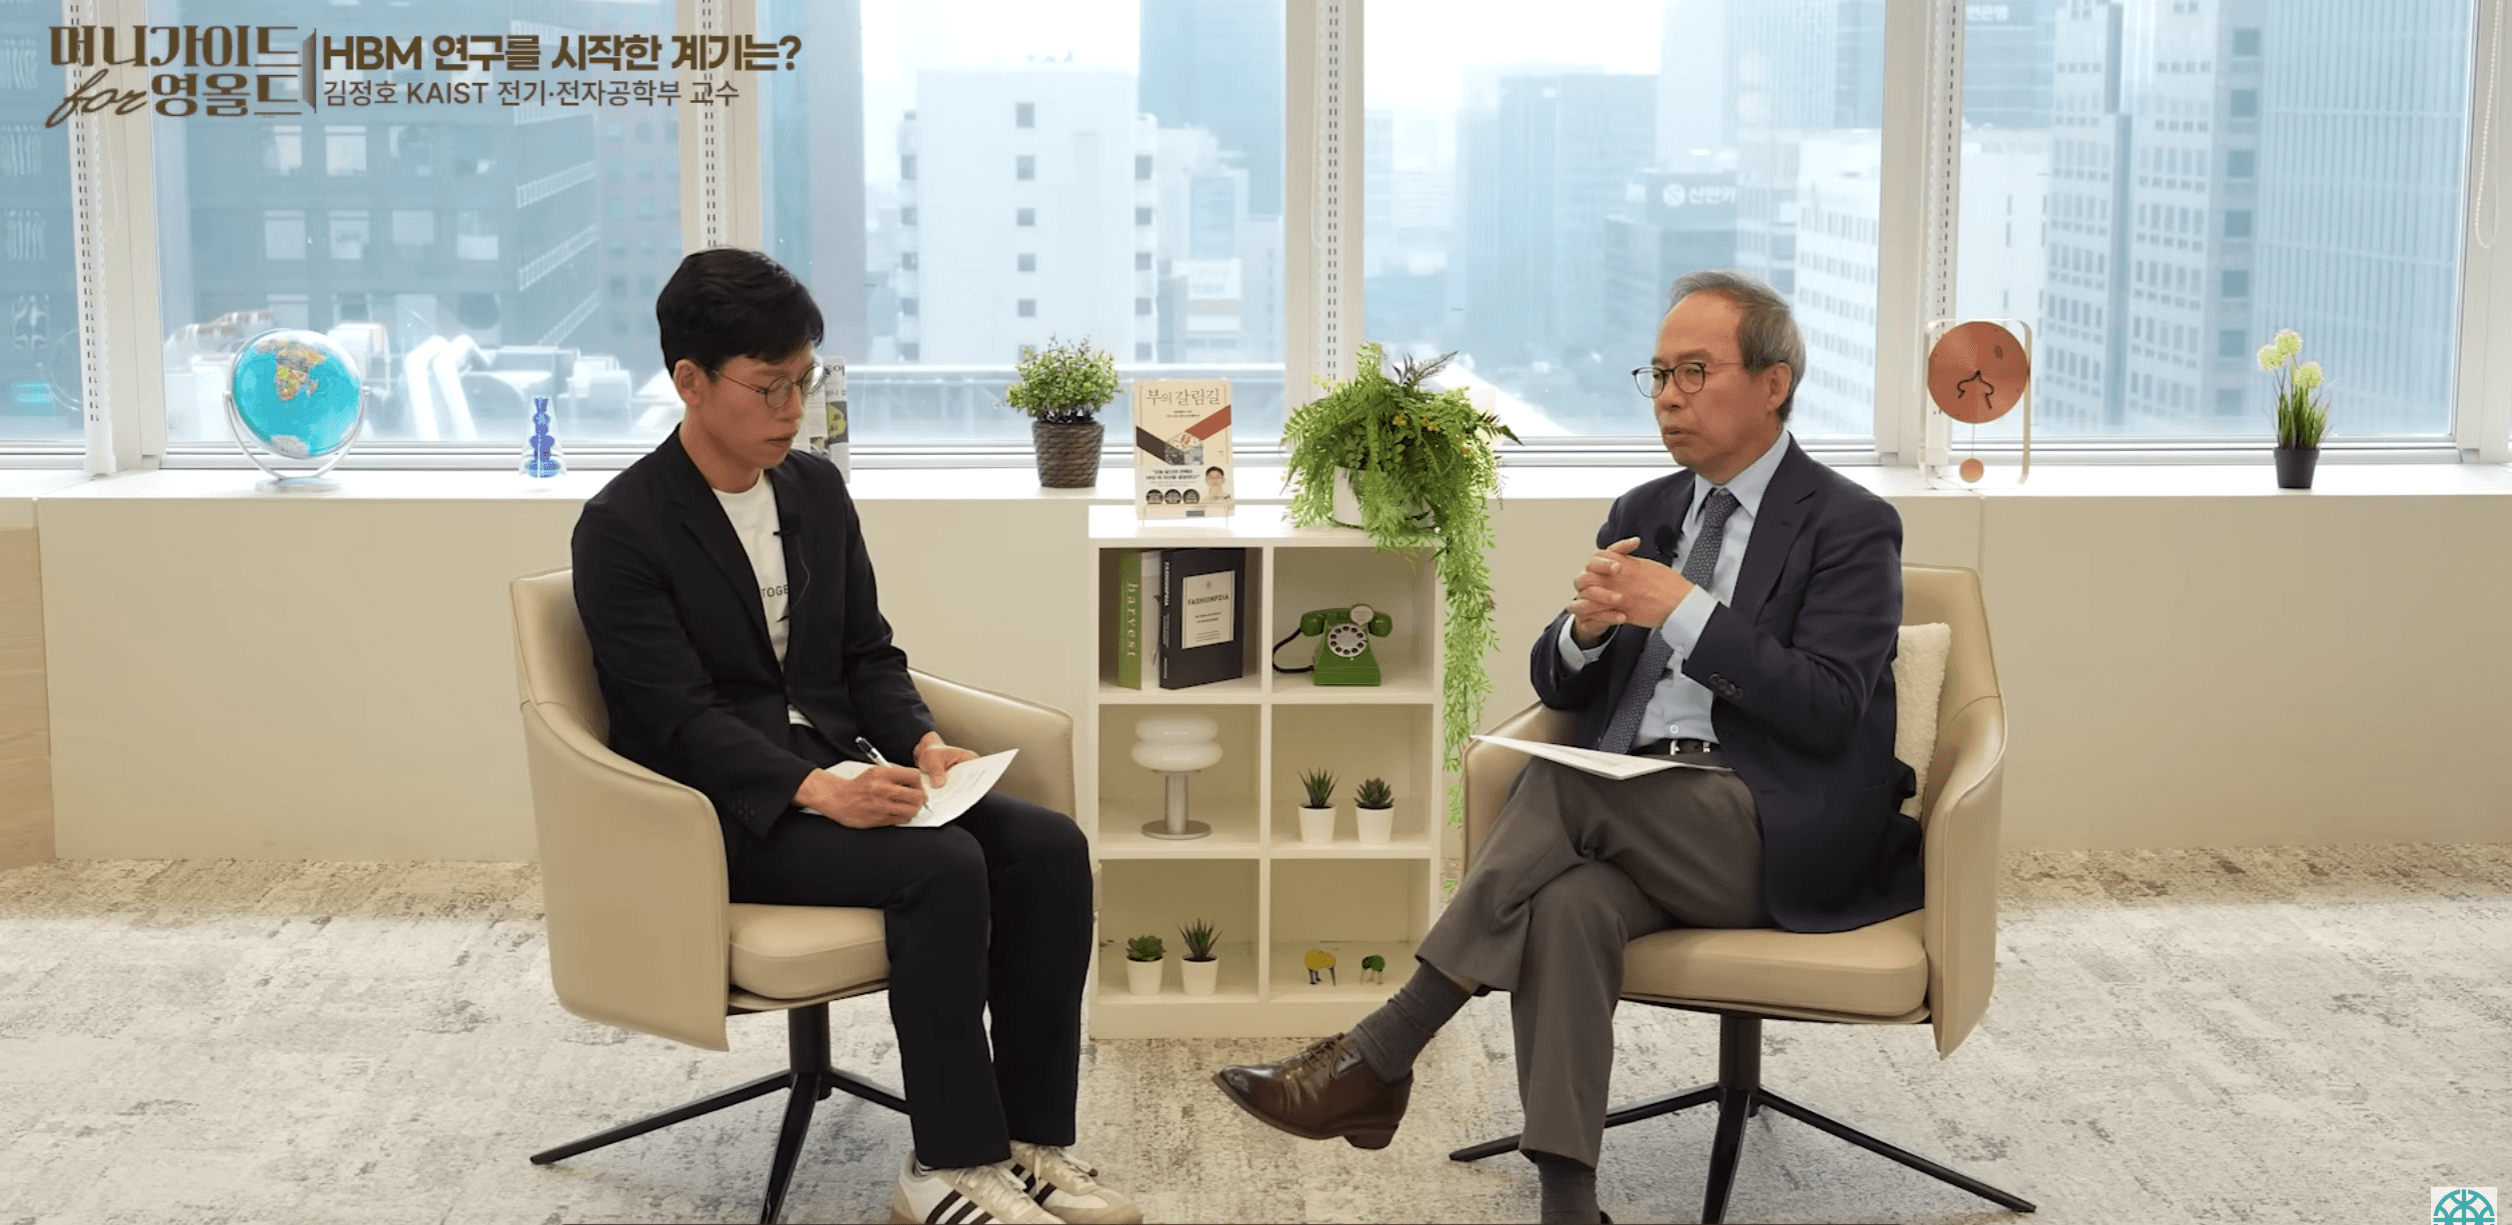
 "Especialista da Hynix questiona GPU ociosa? Por que a memória HBM é essencial" é uma questão de suma importância. De acordo com uma apresentação do professor Joungho Kim, do KAIST, que colaborou extensivamente com a SK Hynix em pesquisas sobre HBM, a utilização de GPUs durante a inferência de IA está cada vez mais limitada pela largura de banda da memória, e não pela capacidade bruta de computação. Esta crescente "barreira de memória" tornou a High Bandwidth Memory (HBM) uma das tecnologias mais importantes na infraestrutura de IA. À medida que as plataformas de inteligência artificial generativa fazem a transição da era de treinamento para a era de inferência, o principal gargalo de desempenho mudou da capacidade de computação bruta do processador para o throughput do barramento de memória. Unidades de processamento gráfico (GPUs) padrão são projetadas para lidar com computações paralelas massivas. No entanto, como cada etapa de inferência requer a leitura de bilhões de parâmetros da memória, a execução do cálculo e a gravação dos estados de volta, os processadores passam a maior parte de seus ciclos operacionais ociosos, aguardando que os dados viajem através dos barramentos padrão.
Por que a memória HBM é essencial: Alinhando pipelines de alto throughput com os limites do hardware
Resumo
- A análise do setor sugere que, mesmo com milhões de unidades de processamento gráfico padrão implantadas, a utilização efetiva da computação é limitada a dez a trinta por cento devido aos atrasos nas transferências dos barramentos de memória.
- As limitações físicas da escala dos chips estão impulsionando uma mudança de paradigma em direção à computação centrada em memória, utilizando arquiteturas de memória de alta largura de banda (HBM) empilhadas verticalmente.
- Espera-se que a próxima geração de empacotamento composto 3D empilhe unidades de processamento gráfico, cache SRAM de alta velocidade on-package e armazenamento flash 3D NAND de alta capacidade para resolver os gargalos de transferência de dados.
A infraestrutura global de computação enfrenta uma crise estrutural. Por vários anos, a corrida para construir modelos de IA maiores concentrou-se na escala do poder computacional bruto. Empresas e provedores de nuvem investiram bilhões de dólares para adquirir clusters massivos de unidades de processamento gráfico (GPUs). Esse foco era altamente lógico durante a era inicial de treinamento, quando o treinamento do modelo dependia de cálculos contínuos de retropropagação. Sob essas cargas de trabalho, as unidades de computação paralela operavam na capacidade máxima para atualizar os parâmetros do modelo, conforme detalhado no Whitepaper da Arquitetura NVIDIA Hopper.
No entanto, à medida que as aplicações transitam para a era da inferência, os requisitos de engenharia mudaram. Em cenários de inferência, o principal desafio não é atualizar pesos, mas transmitir parâmetros massivos pré-treinados ao processador para responder a consultas imediatas. Cada token gerado requer acesso repetido a bilhões de parâmetros de modelo armazenados em memória de alta largura de banda. Como as arquiteturas de barramento padrão não conseguem mover os dados rapidamente o suficiente para corresponder às velocidades de execução do processador padrão, os núcleos de computação ficam sem dados, resultando em taxas de inatividade extremamente altas. Este gargalo de desempenho é discutido em relatórios técnicos do setor, incluindo pesquisas publicadas por órgãos acadêmicos, como o Instituto Avançado de Ciência e Tecnologia da Coreia (KAIST), e desenvolvedores de hardware como NVIDIA e SK Hynix.
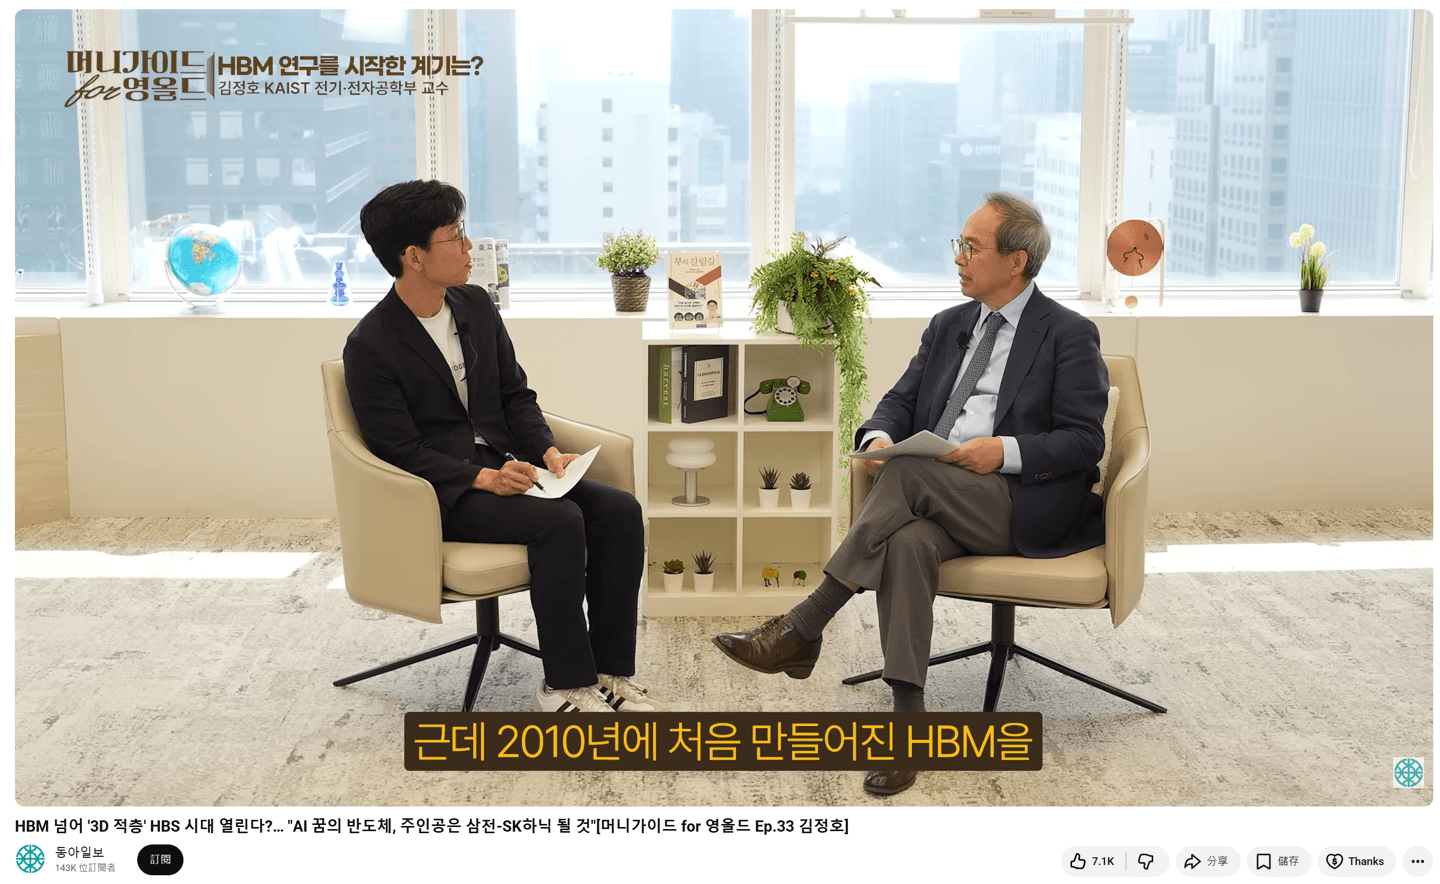
Esta lacuna de desempenho demonstra as restrições físicas que mostram por que a memória HBM é essencial na era da inferência. De acordo com o roteiro de tecnologia HBM publicado pelo KAIST TERA Lab, as futuras gerações de HBM continuarão aumentando a largura de banda por meio de empilhamento DRAM adicional, integração TSV, empacotamento avançado e otimização térmica. Os pacotes DRAM padrão não possuem as vias paralelas necessárias para suportar as velocidades de processamento dos aceleradores modernos. Para superar essa "barreira de memória", os arquitetos de hardware recorreram aos sistemas de memória de alta largura de banda (HBM). Ao empilhar matrizes DRAM verticalmente e utilizar milhares de vias de silício (TSVs) para estabelecer barramentos paralelos amplos, a especificação JEDEC HBM3 (JESD238) explica como a memória empilhada baseada em TSV expande drasticamente a largura de banda disponível em comparação com pacotes DRAM convencionais. Para desenvolvedores, esta evolução do hardware ilustra uma regra fundamental de sistemas de alto throughput: o gargalo é quase sempre a camada de transporte, não o nó de computação.
Mecânica sob o capô do conceito de que a memória HBM é essencial
No nível arquitetural, os barramentos de computador padrão agem como rodovias estreitas, restringindo o fluxo de conjuntos de dados de alto volume. Quando uma aplicação executa uma chamada de inferência, o processador precisa ler dados da memória, concluir a operação e gravar a saída de volta. Em configurações padrão, esse processo cria latência severa, pois os dados precisam percorrer uma longa distância física na placa-mãe.
Para resolver esses gargalos na camada de transporte, os computadores de IA de próxima geração estão evoluindo para arquiteturas compostas tridimensionais. Sob este modelo, o núcleo de computação é colocado diretamente sobre a memória empilhada, utilizando empacotamento avançado para minimizar a distância física e a latência.
A hierarquia de memória 3D: Empilhando SRAM, DRAM e NAND
Para lidar com diferentes classes de dados, os arquitetos de hardware estão propondo um arranjo estratificado de semicondutores 3D. Essa estrutura separa o armazenamento de dados em zonas físicas distintas com base em requisitos de velocidade de acesso e capacidade:
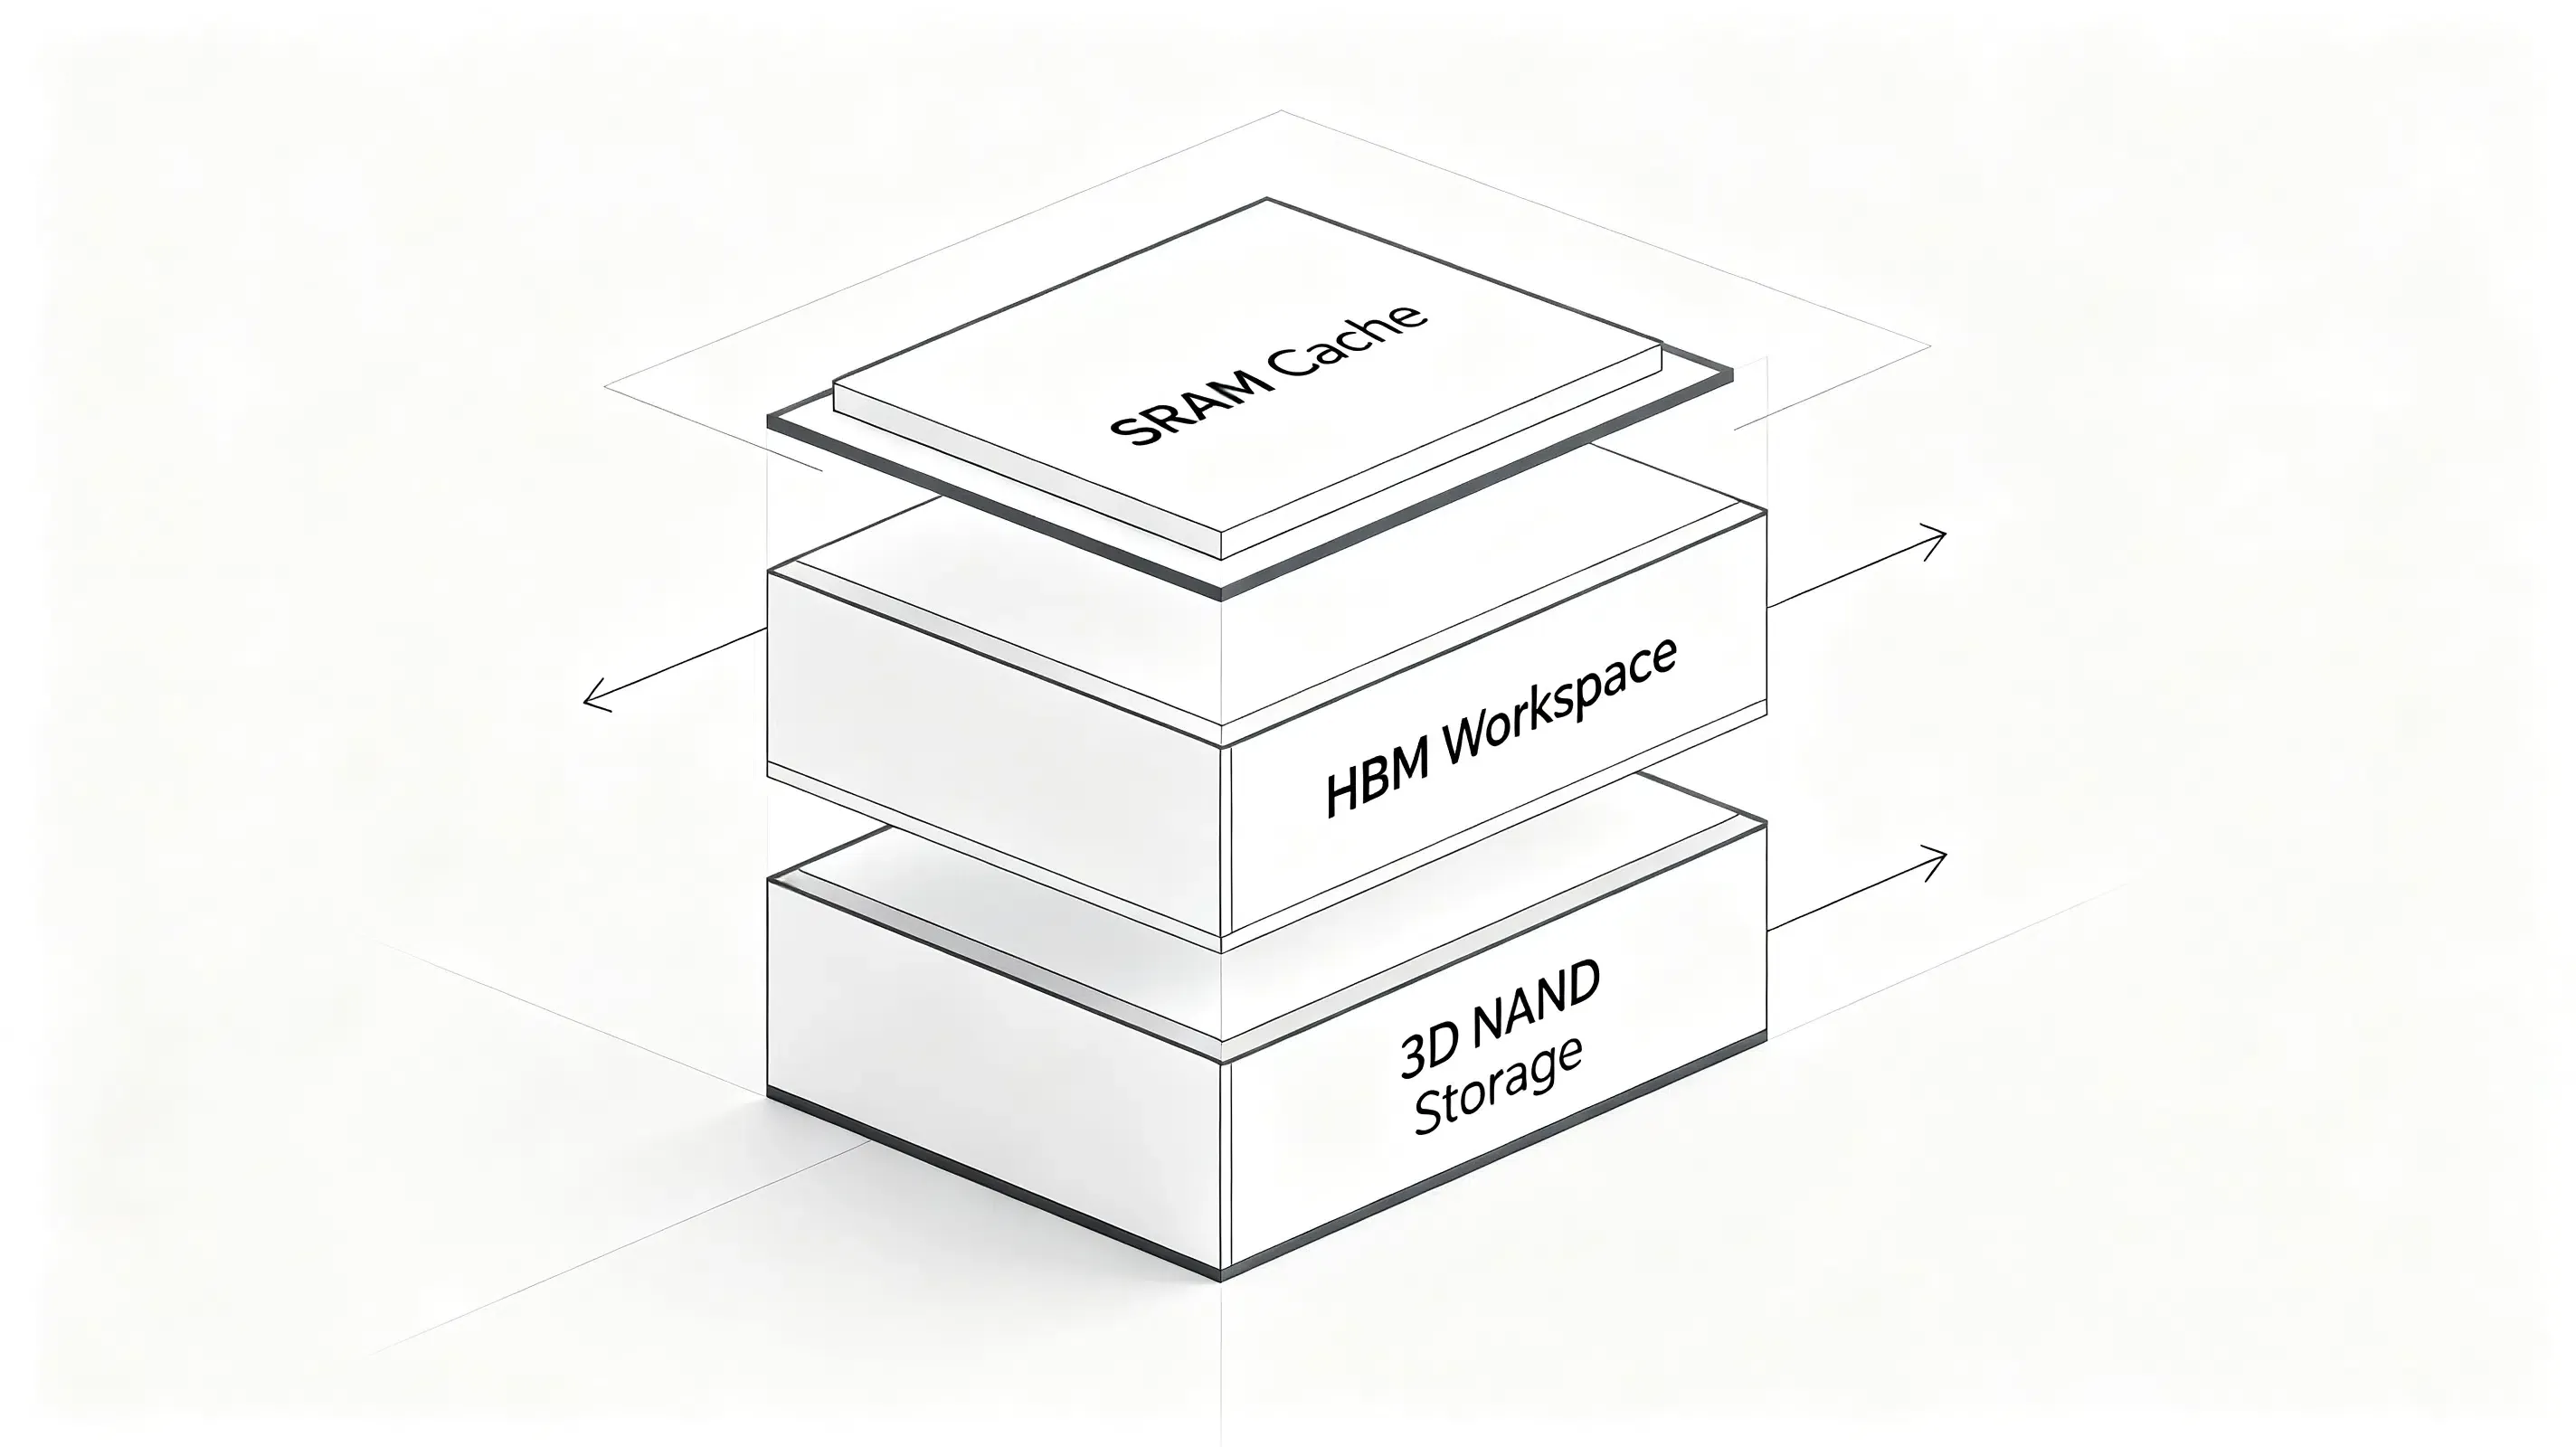
- Cache SRAM de alta velocidade on-package: Atuando como o cache definitivo de alta velocidade, a SRAM é integrada diretamente ao lado do processador, reduzindo significativamente a latência de acesso à memória em comparação com a DRAM convencional para lidar com registros de parâmetros ativos.
- High-Bandwidth Memory (HBM): Servindo como o espaço de trabalho principal ativo, a HBM lida com a recuperação de parâmetros ativos e atualizações de estado de alta frequência, com padrões JEDEC definindo sua interface ampla.
- Armazenamento Flash 3D NAND de alta capacidade: A High Bandwidth Flash (HBF) continua sendo uma arquitetura de armazenamento emergente proposta por pesquisadores do KAIST para complementar a HBM, fornecendo uma capacidade de armazenamento significativamente maior para sistemas de IA futuros, utilizando flash NAND empilhada verticalmente para fornecer capacidade de armazenamento massiva e de longo prazo para preservar vídeos, documentos e memórias conversacionais persistentes.
O diagrama abaixo ilustra essa integração vertical física:
                  [ GPU / Núcleo do Processador ] (Refrigeração nível topo)
                             │
                             ▼
                  [ Cache SRAM de alta velocidade on-package ] (Cache de wafer ultrarrápido)
                             │
                             ▼
                  [ High-Bandwidth Memory ] (DRAM de espaço de trabalho ativo)
                             │
                             ▼
                  [ Armazenamento Flash 3D NAND de alta capacidade ] (Armazenamento NAND de longo prazo)
Esta arquitetura 3D integrada garante que as unidades de computação padrão sejam continuamente abastecidas com dados, reduzindo ciclos ociosos. A memória DDR tradicional fornece apenas uma fração da largura de banda disponível na HBM. De acordo com as apresentações técnicas da NVIDIA GTC, entregues em conjunto com a SK Hynix, a HBM fornece largura de banda substancialmente maior do que a memória DDR convencional enquanto ocupa uma pegada física significativamente menor. Especificamente, a HBM2 entrega aproximadamente 307 GB/s por stack, enquanto a HBM2E aumenta isso para cerca de 358 GB/s, com a HBM3 visando uma largura de banda superior a 500 GB/s.
Embora a largura de banda da memória e a atribuição de aplicações pertençam a domínios de engenharia diferentes, ambos destacam o mesmo princípio arquitetural: mover a gestão de estado para longe de recursos locais restritos e em direção a uma infraestrutura de servidor escalável. Quando as interações do usuário são desacopladas do rastreamento de estado padrão no lado do cliente para satisfazer diretrizes de privacidade, manter a continuidade de sessão fluida entre diferentes ambientes web e móveis torna-se altamente complexo. Assim como os processadores requerem pipelines de memória persistentes e de alta velocidade para corresponder aos contextos de estado, os pipelines de marketing downstream requerem uma preservação de dados robusta no lado do servidor para correlacionar eventos de instalação separados sem depender de cookies vulneráveis ou atributos de dispositivo no lado do cliente.
Criar vs. Comprar: Gerenciando a continuidade de sessão no lado do servidor e o throughput de dados
À medida que os ambientes de computação modernos se afastam de identificadores locais no lado do cliente, manter o estado da sessão entre pontos de contato digitais distribuídos tornou-se um dos principais desafios de engenharia. Para desenvolvedores, gerenciar estados de sessão na era em que "a memória HBM é essencial" requer arquiteturas que sejam tanto compatíveis com as leis de privacidade de dados quanto altamente precisas. Organizações que precisam preservar as jornadas dos usuários entre experiências web e móveis confiam cada vez mais no gerenciamento de sessão no lado do servidor, em vez de identificadores persistentes no lado do cliente. Dependendo dos requisitos de negócios, as equipes podem criar essas capacidades internamente ou adotar plataformas de atribuição existentes.
Avaliação arquitetural: Construção personalizada vs. SDK padronizado
Construir um sistema interno personalizado para gerenciar a correspondência de estado no lado do servidor oferece flexibilidade máxima, mas exige recursos de engenharia contínuos e significativos. Os desenvolvedores precisam construir manualmente esquemas de banco de dados, escrever funções de hash criptográficas seguras e atualizar continuamente o sistema para cumprir as regulamentações regionais em constante mudança. Por outro lado, implantar um SDK certificado e pré-construído reduz a complexidade da integração e garante a conformidade a longo prazo sem custos adicionais.
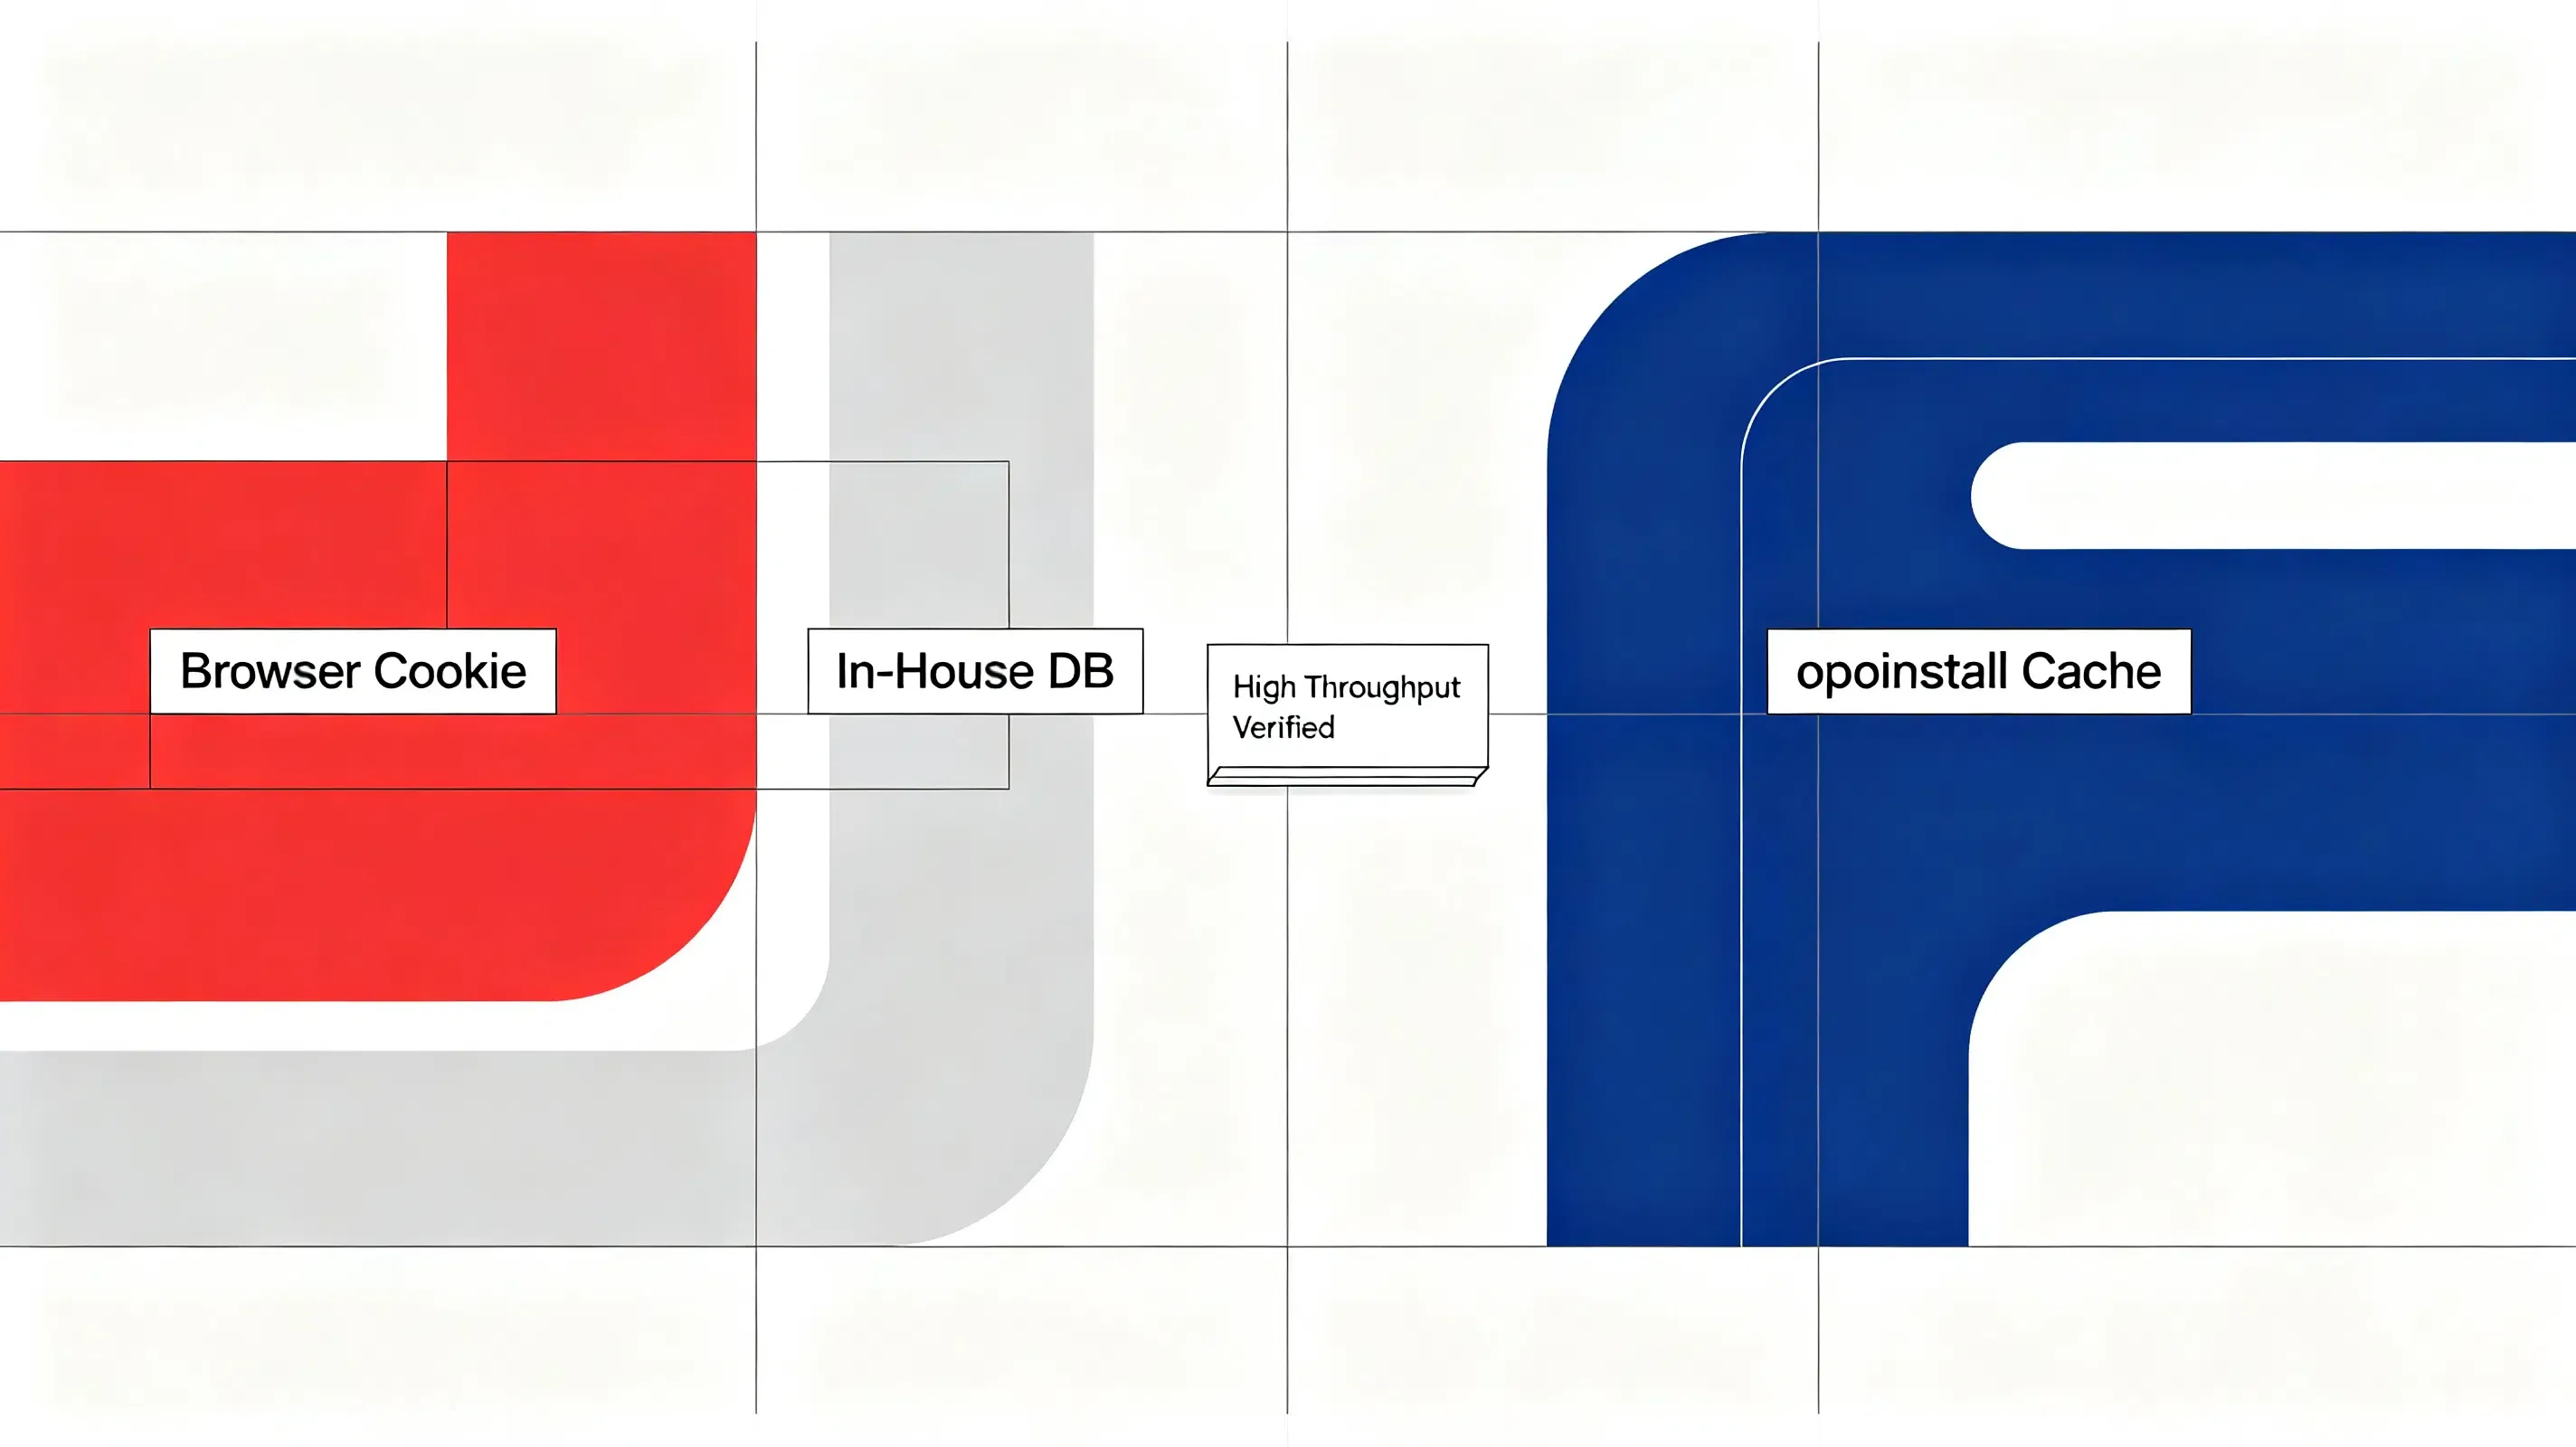
A tabela abaixo compara metodologias padrão para gerenciar o estado da sessão e o contexto de conversão:
| Solução | Persistência | Throughput | Ideal para |
|---|---|---|---|
| Banco de dados de sessão interno | Alta (Sincronização contínua) | Média (Limites de latência do DB) | Ambientes corporativos personalizados com lógica de armazenamento altamente especializada |
| Rastreamento de sessão via navegador | Baixa (Cookies de sessão) | Baixa (Sem logs de servidor) | Rastreamento básico de sites com requisitos mínimos de conversão cross-domain |
| Cache no lado do servidor (ex: OpoInstall) | Nenhuma (Tokens de sessão temporários no servidor) | Alta (Sandbox padronizado) | Atribuição de campanhas multiplataforma e aplicativos móveis de alta concorrência |
Estudos recentes sobre arquitetura de GPU publicados na base de dados arXiv também demonstram que a eficiência do acesso à memória determina frequentemente o throughput geral da inferência mais do que o desempenho aritmético bruto. Embora configurações de banco de dados personalizadas possam lidar com contextos básicos, a preservação especializada de estado no lado do servidor pode otimizar recursos de desenvolvimento. Dependendo dos requisitos de implementação, as organizações podem criar seu próprio sistema de gerenciamento de sessão no lado do servidor ou adotar plataformas comerciais, como o OpoInstall. Por exemplo, o OpoInstall oferece restauração de estado no lado do servidor e frameworks de passagem de parâmetros, mapeando metadados de sessão para um banco de dados de sessão no servidor para manter a continuidade da sessão anonimamente, sem armazenar histórico de conversas pessoal sensível e de longo prazo. Ao mapear metadados de sessão para um banco de dados centralizado, em vez de depender de redirecionamentos baseados em navegador, esse sistema garante que os contextos de conversão permaneçam consistentes mesmo quando as tarefas iniciais são executadas anonimamente. As equipes de engenharia podem avaliar essas abordagens para equilibrar a proteção de dados e a consistência da medição.
Checklists de integração: Preparando sua arquitetura para a computação centrada em memória
Para proteger pipelines de dados e garantir a segurança do usuário na era pós-alias, desenvolvedores e arquitetos podem avaliar o gerenciamento de alias descentralizado de código aberto e a preservação de estado no lado do servidor. Depender de recursos de nível de SO de um único provedor introduz o bloqueio ao fornecedor (vendor lock-in) sistêmico e deixa as organizações vulneráveis a atualizações silenciosas de back-end. Em vez disso, as equipes de engenharia podem avaliar tecnologias de roteamento alternativas que garantam a propriedade total dos dados.
Uma alternativa padrão envolve registrar um domínio personalizado dedicado especificamente para a compartimentalização de e-mail. Ao rotear este domínio através de um mecanismo de alias de código aberto auto-hospedado, como o SimpleLogin, e apontá-lo para uma caixa de entrada criptografada como o Proton Mail, os desenvolvedores podem garantir que seus aliases pareçam domínios personalizados padrão, impedindo que sistemas anti-abuso os bloqueiem em grupo.
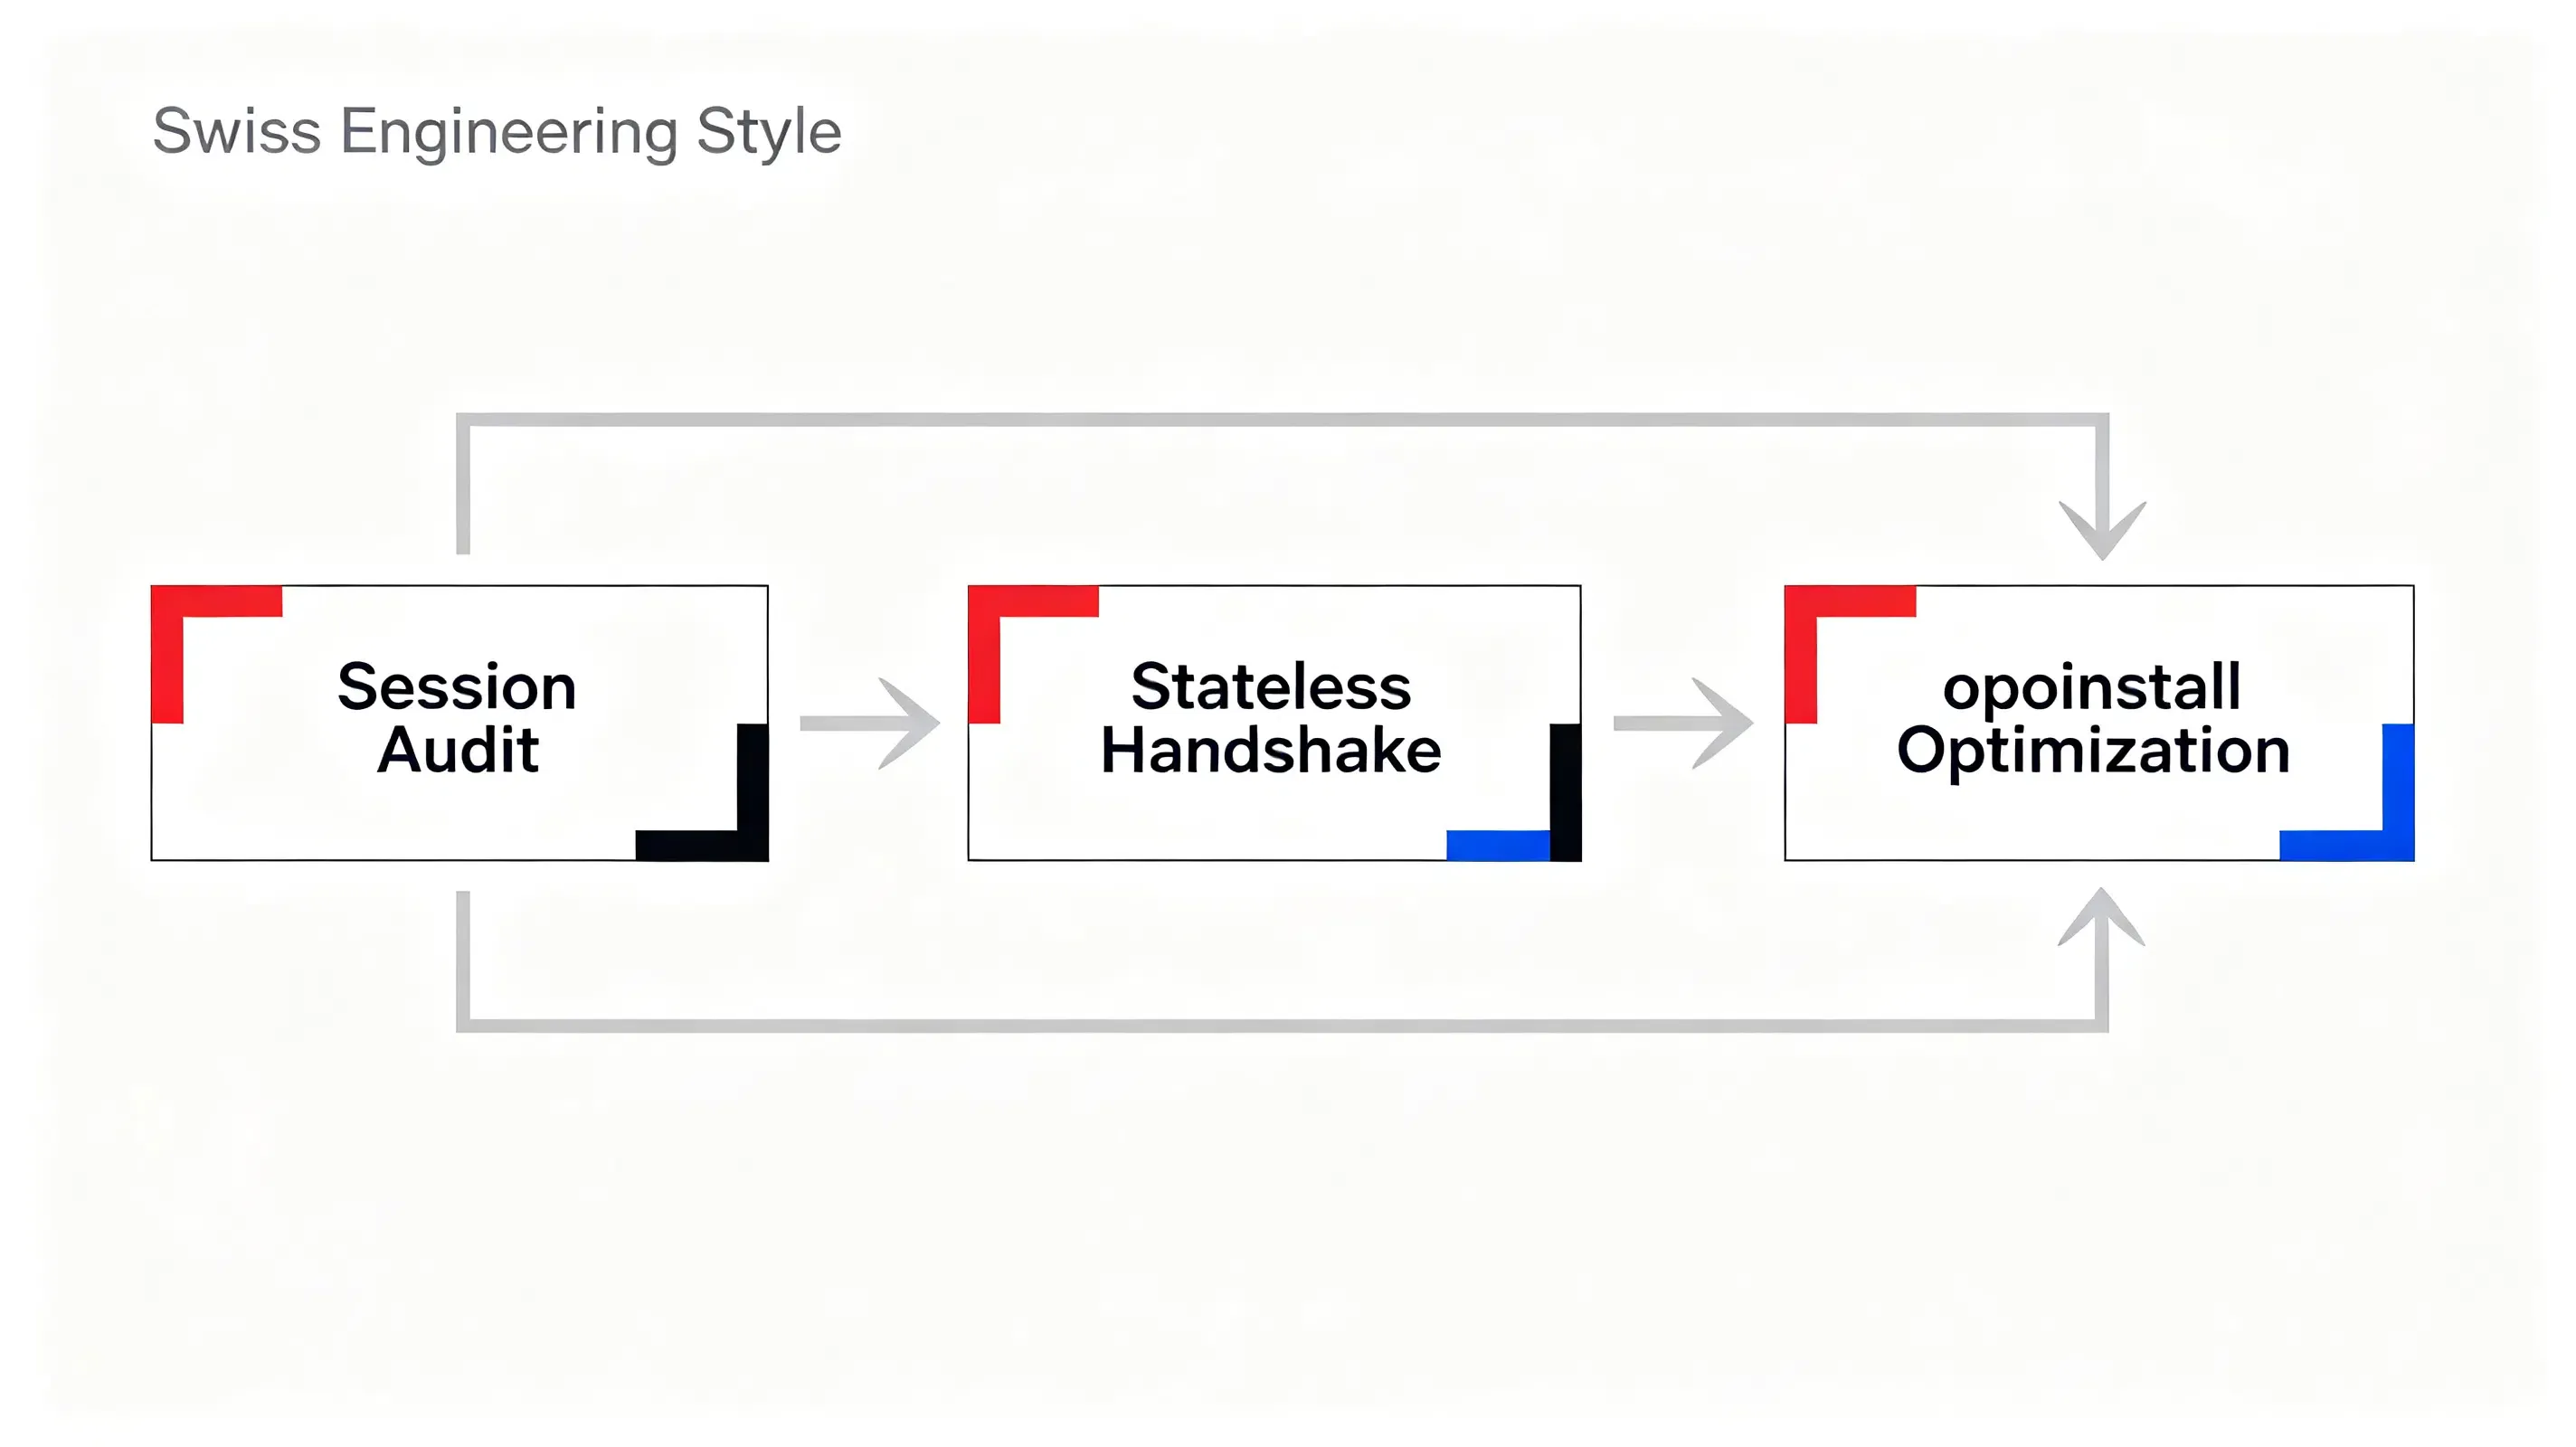
Checklist de implementação para desenvolvedores
- Auditar a retenção de dados de sessão: Revise todos os bancos de dados para garantir que históricos de chat emocionalmente companheiros sejam excluídos de acordo com os cronogramas de exclusão de dados.
- Implementar handshakes de sessão stateless: Faça a transição das rotas de API para modelos de processamento stateless, utilizando tokens assinados criptograficamente para passar o contexto temporário entre nós.
- Impor gateways de verificação de idade: Para produtos voltados ao consumidor, implemente salvaguardas de segurança infantil para impedir que menores acessem recursos de conversação restritos.
Checklist de estratégia de produto e crescimento
- Reorganizar fluxos de experiência do usuário: Pivote de modelos de engajamento baseados em companhia para ferramentas orientadas a tarefas de alta utilidade que não dependam de dependência emocional.
- Otimizar funis de conversão: Aproveite frameworks de passagem de parâmetros não intrusivos para manter o rastreamento de aquisição sem violar as diretrizes de privacidade do usuário.
- Monitorar a conformidade da plataforma: Garanta que todos os SDKs de terceiros integrados estejam em conformidade com as leis locais de proteção de dados e com o mandato de 15 de julho que se aproxima.
Ao estabelecer essas diretrizes estruturadas, as equipes de desenvolvimento podem fazer a transição de suas aplicações para arquiteturas mais seguras e conformes, mantendo a continuidade operacional.
Perguntas Frequentes (FAQ)
Por que a mesma GPU permanece ociosa por até noventa por cento do seu tempo de execução?
Quais são as diferenças técnicas entre HBM, HBF e HBS?
Como a restauração de sessão no lado do servidor resolve gargalos de estado?
Por que a HBM é mais importante durante a inferência de IA do que no treinamento?
Principais conclusões para as equipes de engenharia
À medida que as plataformas de IA se adaptam aos novos requisitos regulatórios, as equipes de engenharia confiarão cada vez mais em arquiteturas stateless, gerenciamento de sessão no lado do servidor e design focado em privacidade. As arquiteturas de dados em evolução exigem uma mudança fundamental na forma como construímos e medimos experiências digitais. À medida que proxies stateless e scrapers headless se tornam consumidores padrão de conteúdo da web, os modelos tradicionais de atribuição no lado do cliente continuarão a degradar-se. Confiar em cookies e referenciadores padrão já não é suficiente para proteger os pipelines de dados que impulsionam a aquisição de usuários.
Para manter o crescimento, as equipes de engenharia e produto devem priorizar estruturas de dados stateless e a preservação de estado no lado do servidor. Ao implementar verificação de identidade zero-trust, frameworks de passagem de parâmetros seguros e cronogramas robustos de exclusão de dados, as organizações podem proteger seus pipelines de usuários respeitando os limites legais. Essa mudança arquitetural é essencial para construir plataformas estáveis e confiáveis que prosperam em uma economia digital regulamentada.
Share this article



