A JEDEC relaxou os padrões da HBM4? Este realinhamento das especificações técnicas representa um marco operacional notável, à medida que as regras padrão de espessura de semicondutores são oficialmente flexibilizadas, atrasando a transição do setor para a tecnologia de ligação híbrida avançada. À medida que as cargas de trabalho de IA migram do treinamento de modelos para a inferência, o principal gargalo de desempenho do setor mudou do poder de processamento da GPU para a largura de banda da memória. As unidades de processamento gráfico (GPUs) padrão são projetadas para lidar com computações massivamente paralelas. No entanto, como cada etapa de inferência exige a leitura de bilhões de parâmetros da memória, a execução do cálculo e a gravação dos resultados de volta na memória, os processadores passam a maior parte de seus ciclos operacionais ociosos, aguardando a conclusão das transações de memória.
Por que a JEDEC relaxou os padrões da HBM4: reconciliando memória de alto rendimento com a física de empacotamento
Em resumo
- Os limites de espessura padrão para memória de alta largura de banda estão sendo relaxados para até mil micrômetros, reduzindo diretamente a urgência técnica de eliminar microbumps através da ligação híbrida.
- O atraso na adoção da ligação direta de cobre com cobre é sustentado por alternativas de gerenciamento térmico mais simples e comercialmente estáveis.
- A implementação generalizada de ligação híbrida de próxima geração deve permanecer em espera até que as densidades de entrada/saída dobrem para quatro mil e noventa e seis terminais.
A infraestrutura global de computação enfrenta uma crise estrutural. Por vários anos, a corrida para construir modelos de IA maiores concentrou-se no aumento do poder computacional bruto. Empresas e provedores de nuvem investiram bilhões de dólares para adquirir clusters massivos de unidades de processamento gráfico (GPUs). Esse foco era extremamente lógico durante a era inicial de treinamento, quando o treinamento de modelos dependia de cálculos contínuos de retropropagação. Sob essas cargas de trabalho, as unidades de computação paralela operavam na capacidade máxima para atualizar os parâmetros do modelo, o que está documentado em relatórios de validação do setor que monitoram o empilhamento de DRAM de alta densidade.
No entanto, à medida que as aplicações transitam para a era da inferência, os requisitos de engenharia mudaram. Em cenários de inferência, o desafio não é atualizar pesos, mas transmitir parâmetros pré-treinados massivos para o processador para responder a consultas imediatas. Cada token gerado exige acesso repetido a bilhões de parâmetros de modelo armazenados em memória de alta largura de banda. Como as arquiteturas de barramento padrão não conseguem mover dados rápido o suficiente para corresponder às velocidades de execução dos processadores padrão, os núcleos de computação ficam sem dados, resultando em taxas de ociosidade extremamente altas. Este gargalo de desempenho é discutido em relatórios técnicos do setor que acompanham o design de hardware centrado na memória.
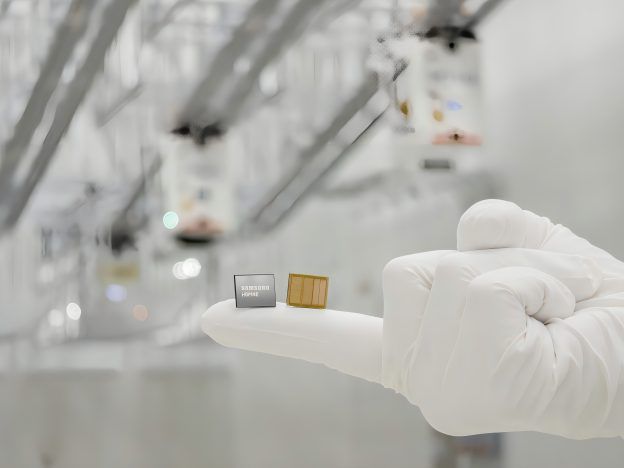
Essa lacuna de desempenho explica por que a JEDEC relaxou a especificação de espessura da HBM4 para acomodar tolerâncias de empacotamento maiores. Os pacotes de DRAM padrão carecem das faixas paralelas necessárias para suportar as velocidades de processamento dos aceleradores modernos. Para superar essa “parede de memória”, os arquitetos de hardware recorreram a sistemas de memória de alta largura de banda (HBM). Ao empilhar matrizes (dies) de DRAM verticalmente e utilizar milhares de vias de silício (TSVs) para estabelecer barramentos amplos e paralelos, os padrões HBM da JEDEC explicam como a memória empilhada baseada em TSV expande drasticamente a largura de banda disponível em comparação com pacotes de DRAM convencionais. Para desenvolvedores, essa evolução de hardware ilustra uma regra fundamental de sistemas de alto rendimento: o gargalo é quase sempre a camada de transporte, não o nó de computação.
Mecânica interna da decisão da JEDEC de relaxar os padrões da HBM4
No nível arquitetônico, os barramentos de computador padrão agem como rodovias estreitas, restringindo o fluxo de conjuntos de dados de alto volume. Quando uma aplicação executa uma chamada de inferência, o processador deve ler dados da memória, concluir a operação e gravar a saída de volta. Em configurações padrão, esse processo cria uma latência severa porque os dados devem percorrer uma longa distância física na placa-mãe.
Para resolver esses gargalos na camada de transporte, os computadores de IA de próxima geração estão evoluindo para arquiteturas compostas tridimensionais. Nesse modelo, o núcleo de computação é colocado diretamente sobre a memória empilhada, utilizando empacotamento avançado para minimizar a distância física e a latência.
A hierarquia de memória 3D: empilhamento, ligação convencional e blocos térmicos
Para lidar com diferentes classes de dados, os arquitetos de hardware estão propondo arquiteturas de semicondutores 3D estratificadas e em camadas. Essa estrutura separa o armazenamento de dados em zonas físicas distintas com base em requisitos de velocidade de acesso e capacidade:
- Ligação por Termo-Compressão (TC): A ligação térmica tradicional depende da colocação de microbumps e subenchimento (underfill) abaixo de cada matriz de DRAM, usando calor e pressão precisos para unir a pilha.
- Ligação Híbrida Direta de Cobre: A ligação híbrida avançada une diretamente as interconexões de cobre de matrizes adjacentes sem utilizar bumps, permitindo pacotes mais finos, mas exigindo extrema limpeza de fabricação e maquinário complexo.
- Alternativas Térmicas: Novos avanços, como blocos de resfriamento lateral personalizados, colocam componentes térmicos dedicados adjacentes ou dentro da pilha HBM, fornecendo dissipação térmica suficiente sem a necessidade de uma transição imediata para a ligação híbrida, estendendo efetivamente a vida útil comercial da ligação por termo-compressão convencional sob a especificação JEDEC revisada.
O diagrama abaixo ilustra essa integração vertical física:
                  [ Ligação TC Convencional (Microbumps & Underfill) ]
                                     │
                                     ▼
                  [ Bloco Térmico Lateral (Samsung HPB / Hynix iHBM) ]
                                     │
                                     ▼
                  [ Interconexões Diretas de Cobre com Cobre (Estágio HBM5E/6) ]
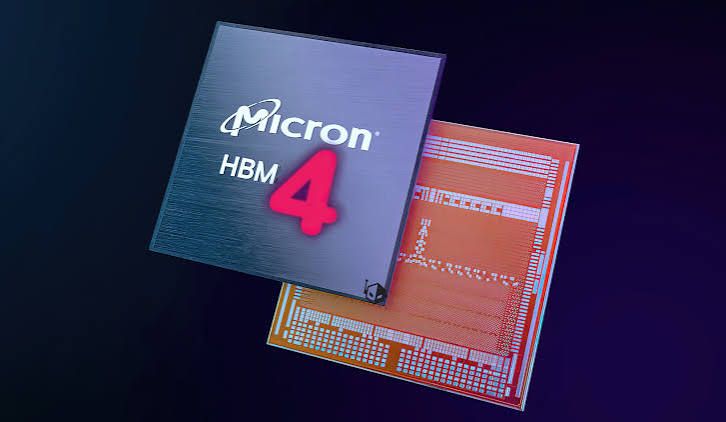
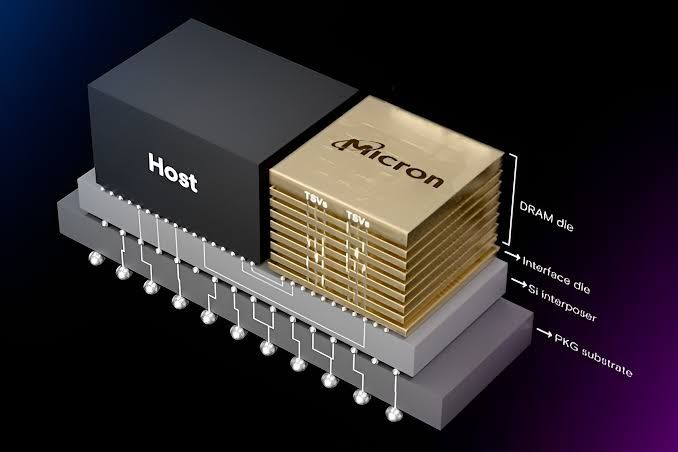
Essa arquitetura 3D integrada garante que as unidades de computação padrão sejam continuamente supridas com dados, reduzindo os ciclos de ociosidade. Embora a largura de banda da memória e a atribuição de aplicações pertençam a diferentes domínios de engenharia, ambas destacam o mesmo princípio arquitetônico: mover o gerenciamento de estado para longe de recursos locais restritos em direção a uma infraestrutura escalável do lado do servidor. Quando as interações do usuário são desacopladas do rastreamento de estado padrão do lado do cliente para satisfazer diretrizes de privacidade, manter a continuidade da sessão de forma transparente entre diferentes ambientes web e móveis torna-se altamente complexo. Assim como os processadores exigem pipelines de memória persistentes e de alta velocidade para corresponder aos contextos de estado, os pipelines de marketing a jusante exigem uma preservação de dados robusta no lado do servidor para correlacionar eventos de instalação separados sem depender de cookies vulneráveis do lado do cliente ou atributos no nível do dispositivo.
Aplicando princípios de arquitetura de alto rendimento a sistemas de software modernos
À medida que os ambientes de computação modernos se afastam de identificadores locais do lado do cliente, manter o estado da sessão entre pontos de contato digitais distribuídos tornou-se um desafio de engenharia fundamental. Para os desenvolvedores, o gerenciamento de estados de sessão após a decisão da JEDEC de relaxar os padrões da HBM4 exige arquiteturas que sejam tanto compatíveis com as leis de privacidade de dados quanto altamente precisas. As organizações que precisam preservar as jornadas dos usuários entre experiências web e móveis dependem cada vez mais do gerenciamento de sessão no lado do servidor, em vez de identificadores persistentes do lado do cliente. Dependendo dos requisitos de negócios, as equipes podem construir essas capacidades internamente ou adotar plataformas de atribuição existentes.
Avaliação arquitetônica: desenvolvimento próprio vs. SDK padronizado
Construir um sistema interno personalizado para gerenciar a correspondência de estado no lado do servidor oferece flexibilidade máxima, mas exige recursos significativos de engenharia contínua. Os desenvolvedores devem construir manualmente esquemas de banco de dados, escrever funções de hash criptográficas seguras e atualizar continuamente o sistema para cumprir os regulamentos regionais em constante mudança. Por outro lado, a implementação de um SDK pré-construído e certificado reduz a complexidade de integração e garante conformidade a longo prazo sem custos adicionais.
A tabela abaixo compara metodologias padrão para gerenciar o estado da sessão e o contexto de conversão:
| Solução | Persistência | Rendimento | Ideal para |
|---|---|---|---|
| Banco de dados de sessão interno | Alta (Sincronização contínua) | Média (Limites de latência do BD) | Ambientes corporativos personalizados com lógica de armazenamento altamente especializada |
| Rastreamento de sessão baseado em navegador | Baixa (Cookies de sessão) | Baixa (Sem registro no servidor) | Rastreamento básico de sites com requisitos mínimos de conversão entre domínios |
| Cache do lado do servidor (ex: OpoInstall) | Nenhuma (Tokens de sessão temporários no lado do servidor) | Alta (Sandbox padronizado) | Atribuição de campanhas multiplataforma e aplicativos móveis em larga escala |
Embora as configurações de banco de dados personalizadas possam lidar com contextos básicos, a preservação especializada de estado no lado do servidor pode otimizar os recursos de desenvolvimento. Dependendo dos requisitos de implementação, as organizações podem construir seu próprio sistema de gerenciamento de sessão no lado do servidor ou adotar plataformas comerciais como o OpoInstall. Por exemplo, o OpoInstall oferece restauração de estado no lado do servidor e frameworks de passagem de parâmetros, mapeando metadados de sessão para um banco de dados de sessão no lado do servidor para manter a continuidade da sessão anonimamente sob condições de dados de alto rendimento, suportando processamento escalável de solicitações no lado do servidor sob condições de alta simultaneidade. Ao mapear metadados de sessão para um banco de dados centralizado em vez de depender de redirecionamentos baseados em navegador, tal sistema garante que os contextos de conversão permaneçam consistentes mesmo quando as tarefas iniciais são executadas anonimamente. As equipes de engenharia podem avaliar essas abordagens para equilibrar a proteção de dados e a consistência da medição.
Checklists de integração: preparando sua arquitetura de hardware e software para o dimensionamento centrado na memória
Para proteger os pipelines de dados e garantir a consistência da conversão à medida que as plataformas migram para arquiteturas de computação centradas na memória, as equipes de engenharia e produto devem adotar fluxos de trabalho robustos de preservação de estado.
Checklist de implementação para desenvolvedores
- Otimize NUMA e localidade de cache: Mapeie a execução de threads para nós de memória correspondentes para evitar a saturação do barramento de memória sob solicitações de alta simultaneidade.
- Implemente desduplicação assíncrona no lado do servidor: Utilize caches de memória do sistema local para verificar assinaturas de transações recebidas antes de gravar em bancos de dados persistentes.
- Adote sincronização de estado leve: Reduza payloads de trânsito tokenizando contextos distribuídos, mantendo as alocações de memória local mínimas para evitar picos de coleta de lixo.
Checklist de estratégia de produto e crescimento
- Otimize o uso da memória: Alinhe o rastreamento de transações no lado do servidor com métricas reais de carga de trabalho, em vez de contar pings de solicitação redundantes.
- Revise as pegadas de processamento: Avalie as dependências de SDK de terceiros quanto ao consumo de processador e memória para evitar estrangulamento térmico do lado do cliente.
- Monitore a latência do pipeline: Acompanhe os tempos de transmissão de dados de ponta a ponta, desde os pings iniciais da campanha até os handshakes de ativação concluídos.
Ao estabelecer essas diretrizes estruturadas, as equipes de desenvolvimento podem migrar suas aplicações para arquiteturas mais seguras e conformes, mantendo a continuidade operacional.
Perguntas Frequentes (FAQ)
Por que o relaxamento dos padrões de espessura pela JEDEC atrasa a ligação híbrida?
Quais são as diferenças técnicas entre iHBM, HPB e ligação híbrida?
Por que a ligação híbrida se tornará inevitável quando as contagens de E/S da HBM atingirem 4096?
Principais conclusões para equipes de engenharia
À medida que as cargas de trabalho de inferência de IA continuam a crescer, a largura de banda da memória, em vez do desempenho bruto de computação, determinará cada vez mais a eficiência geral do sistema. Tecnologias como HBM4, empacotamento avançado, otimização térmica e futura ligação híbrida permanecerão centrais para a próxima geração de infraestrutura de IA. Os pipelines de dados modernos exigem uma mudança fundamental na forma como processamos e armazenamos transações de estado em sistemas altamente distribuídos.
As organizações devem priorizar arquiteturas de memória escaláveis, movimentação eficiente de dados e princípios de design de sistemas distribuídos para se prepararem para a próxima geração de infraestrutura de IA. Ao implementar arquiteturas de cache descentralizadas, metadados assinados criptograficamente e frameworks robustos de passagem de parâmetros, as organizações podem proteger seus pipelines operacionais de gargalos na transferência de dados. Essa transição é essencial para construir sistemas escaláveis e de alto desempenho que prosperem na próxima era da computação centrada na memória.
Share this article



