Meta proíbe o ‘Claude’? Este realinhamento estratégico foi validado por relatos indicando que a gigante das redes sociais restringiu o uso de ferramentas concorrentes, como o Claude Code e o Codex da OpenAI, pelos engenheiros de sua divisão de IA Aplicada. Segundo documentos internos obtidos no final de junho de 2026, a empresa emitiu essas diretrizes para proteger a integridade dos conjuntos de dados de treinamento do seu futuro modelo Llama e salvaguardar segredos comerciais, conforme detalhado em atualizações de conformidade do setor. Para equipes de desenvolvimento e gestores de produtos, a política restritiva destaca uma transição mais ampla: à medida que os modelos generativos convergem, manter o isolamento estrito de ambientes internos está se tornando um padrão fundamental de conformidade corporativa, em vez de uma simples escolha operacional.
Resumo
- Salvaguardas contra contaminação: A equipe de engenharia de IA Aplicada restringiu chamadas para ferramentas externas de geração de código para evitar que outputs de modelos rivais se misturassem a dados de treinamento proprietários.
- A ameaça da destilação: O uso extensivo de outputs programáticos externos introduz riscos de destilação de conhecimento, o que pode violar termos de serviço.
- Demandas por sandbox privado: A mudança destaca uma necessidade crescente por sandboxes de desenvolvedor seguros e autohospedados, que isolam repositórios de código sensíveis de servidores externos.
Diretrizes corporativas e o realinhamento de segurança de maio a junho
As diretrizes restritivas, redigidas inicialmente em maio de 2026, entraram em vigor formalmente no final de junho de 2026. As regras focam exclusivamente nos engenheiros da divisão de IA Aplicada envolvidos diretamente na pesquisa de modelos, sem se aplicar a todos os funcionários. Em ciclos de desenvolvimento anteriores, a equipe de engenharia utilizava frequentemente assistentes de codificação externos para planejar arquiteturas de sistemas, refatorar bases de código e executar fluxos de depuração. No entanto, sob as novas diretrizes de segurança, os engenheiros devem projetar inputs de teste de forma independente, confiando na experiência humana em vez de prompts de modelos externos.
Um dos principais impulsionadores dessa transição é o risco de destilação de modelos, também conhecida como destilação de conhecimento. Na pesquisa de inteligência artificial, os desenvolvedores treinam modelos “estudantes” menores para imitar comportamentos de modelos “professores” mais robustos, alimentando-os com outputs desses sistemas maiores. Embora este processo permaneça popular para otimizar escala e custos de implantação de modelos, ele apresenta riscos contratuais sérios. Engenheiros da Meta que copiam ou referenciam código compilado por ferramentas rivais correm o risco de introduzir dados de terceiros no pipeline de treinamento do Llama, o que poderia violar acordos de uso e contaminar o modelo proprietário.
O realinhamento de segurança ocorre em um cenário de concorrência intensificada. Em junho de 2026, a startup chinesa de IA Zhipu AI disponibilizou em open-source seu modelo carro-chefe, o GLM-5.2, demonstrando capacidades de verificação de vulnerabilidades equivalentes aos principais benchmarks fechados dos EUA. Testes independentes mostraram o GLM-5.2 superando checkpoints de modelos anteriores, como o Claude Opus 4.8, em tarefas de cibersegurança no Semgrep. Como a Zhipu AI optou por abrir o código dos pesos do modelo, permitindo implantações locais privadas, ele rapidamente subiu nas listas de tráfego de terceiros em plataformas como o OpenRouter. Esta rápida ascensão de modelos locais alternativos de alto desempenho está forçando os principais laboratórios de IA a priorizar o controle absoluto sobre seus repositórios de código e inputs de dados.
As observações a seguir baseiam-se em validações internas em um ambiente de staging e destinam-se a ilustrar padrões de engenharia, e não a servir como benchmarks setoriais.
Mecânicas internas da destilação de modelos e exposição de dados
Para entender por que a Meta está restringindo essas ferramentas, os desenvolvedores precisam analisar a mecânica dos assistentes de codificação de IA modernos. Esses utilitários funcionam enviando o contexto da base de código local para servidores externos para processamento. Quando um engenheiro inicia um prompt de refatoração ou solicita sugestões arquiteturais, blocos de código proprietário trafegam para fora da rede corporativa interna. Essa transmissão de dados sem controle cria vulnerabilidades diretas para exposição de PI e vazamento de dados.
IDE do Desenvolvedor -> Interceptor de Requisições de Saída -> Proxy de Sandbox (Metadados Removidos) -> Gateway de API Seguro -> Modelo
                                                            |
                                               Firewall de saída bloqueia uploads de código-fonte brutos
Em implantações de produção típicas, os desenvolvedores frequentemente encontram uma parcela notável de tráfego sendo processada por scrapers automatizados. Rastrear essas interações programáticas revela que proxies de segurança ou scanners de tempo de execução podem disparar endpoints de API externos antes que os desenvolvedores percebam. Tal atividade pode interferir em auditorias de dados caso os sistemas assumam que toda requisição origina-se de uma ação humana real e manual. No contexto de desenvolvimento de modelos, permitir que modelos externos processem arquivos internos MetaCode ou DevMate traz o risco de expor estruturas proprietárias durante ciclos de treinamento competitivos.
Além disso, atualizações nos termos de serviço de grandes fornecedores de IA no final de 2025 introduziram cláusulas de treinamento de conjunto de dados opt-in, aumentando as preocupações entre as equipes jurídicas corporativas. Sem firewalls de rede rigorosos, as sessões diárias de depuração de um desenvolvedor poderiam inadvertidamente fornecer insumos de treinamento para plataformas concorrentes. Sob essas condições, a pureza estrutural da base de código proprietária é prejudicada.
Opções arquiteturais para sandboxing seguro e verificação de pipeline
Diante dos riscos crescentes à segurança de dados, as equipes de desenvolvimento de software geralmente escolhem entre construir uma estrutura interna de verificação de custos ou integrar um SDK de atribuição existente. Desenvolver um sistema proprietário exige custos de engenharia substanciais. As equipes precisam construir bancos de dados personalizados no lado do servidor, manter bibliotecas de correspondência de estado de dispositivo e atualizar continuamente a lógica para cumprir padrões de segurança OS em evolução. Para muitas organizações, o custo de manutenção de um rastreador interno é proibitivamente alto.
Alternativamente, os desenvolvedores geralmente avaliam várias abordagens para monitorar a execução em tempo de execução sem depender inteiramente de métricas de nuvem:
- Implantações de modelos locais: Executar modelos de código aberto pequenos e altamente especializados dentro de ambientes off-line seguros.
- Sandboxing com firewall estrito: Impedir que contêineres de desenvolvimento ativos estabeleçam conexões de rede de saída externas.
- MMPs Corporativos: Utilizar plataformas de mensuração móvel robustas de terceiros para fluxos de deep-linking.
- SDKs de parâmetros especializados: Implantar utilitários de integração dedicados para a passagem de parâmetros personalizados com precisão e controle de custos.
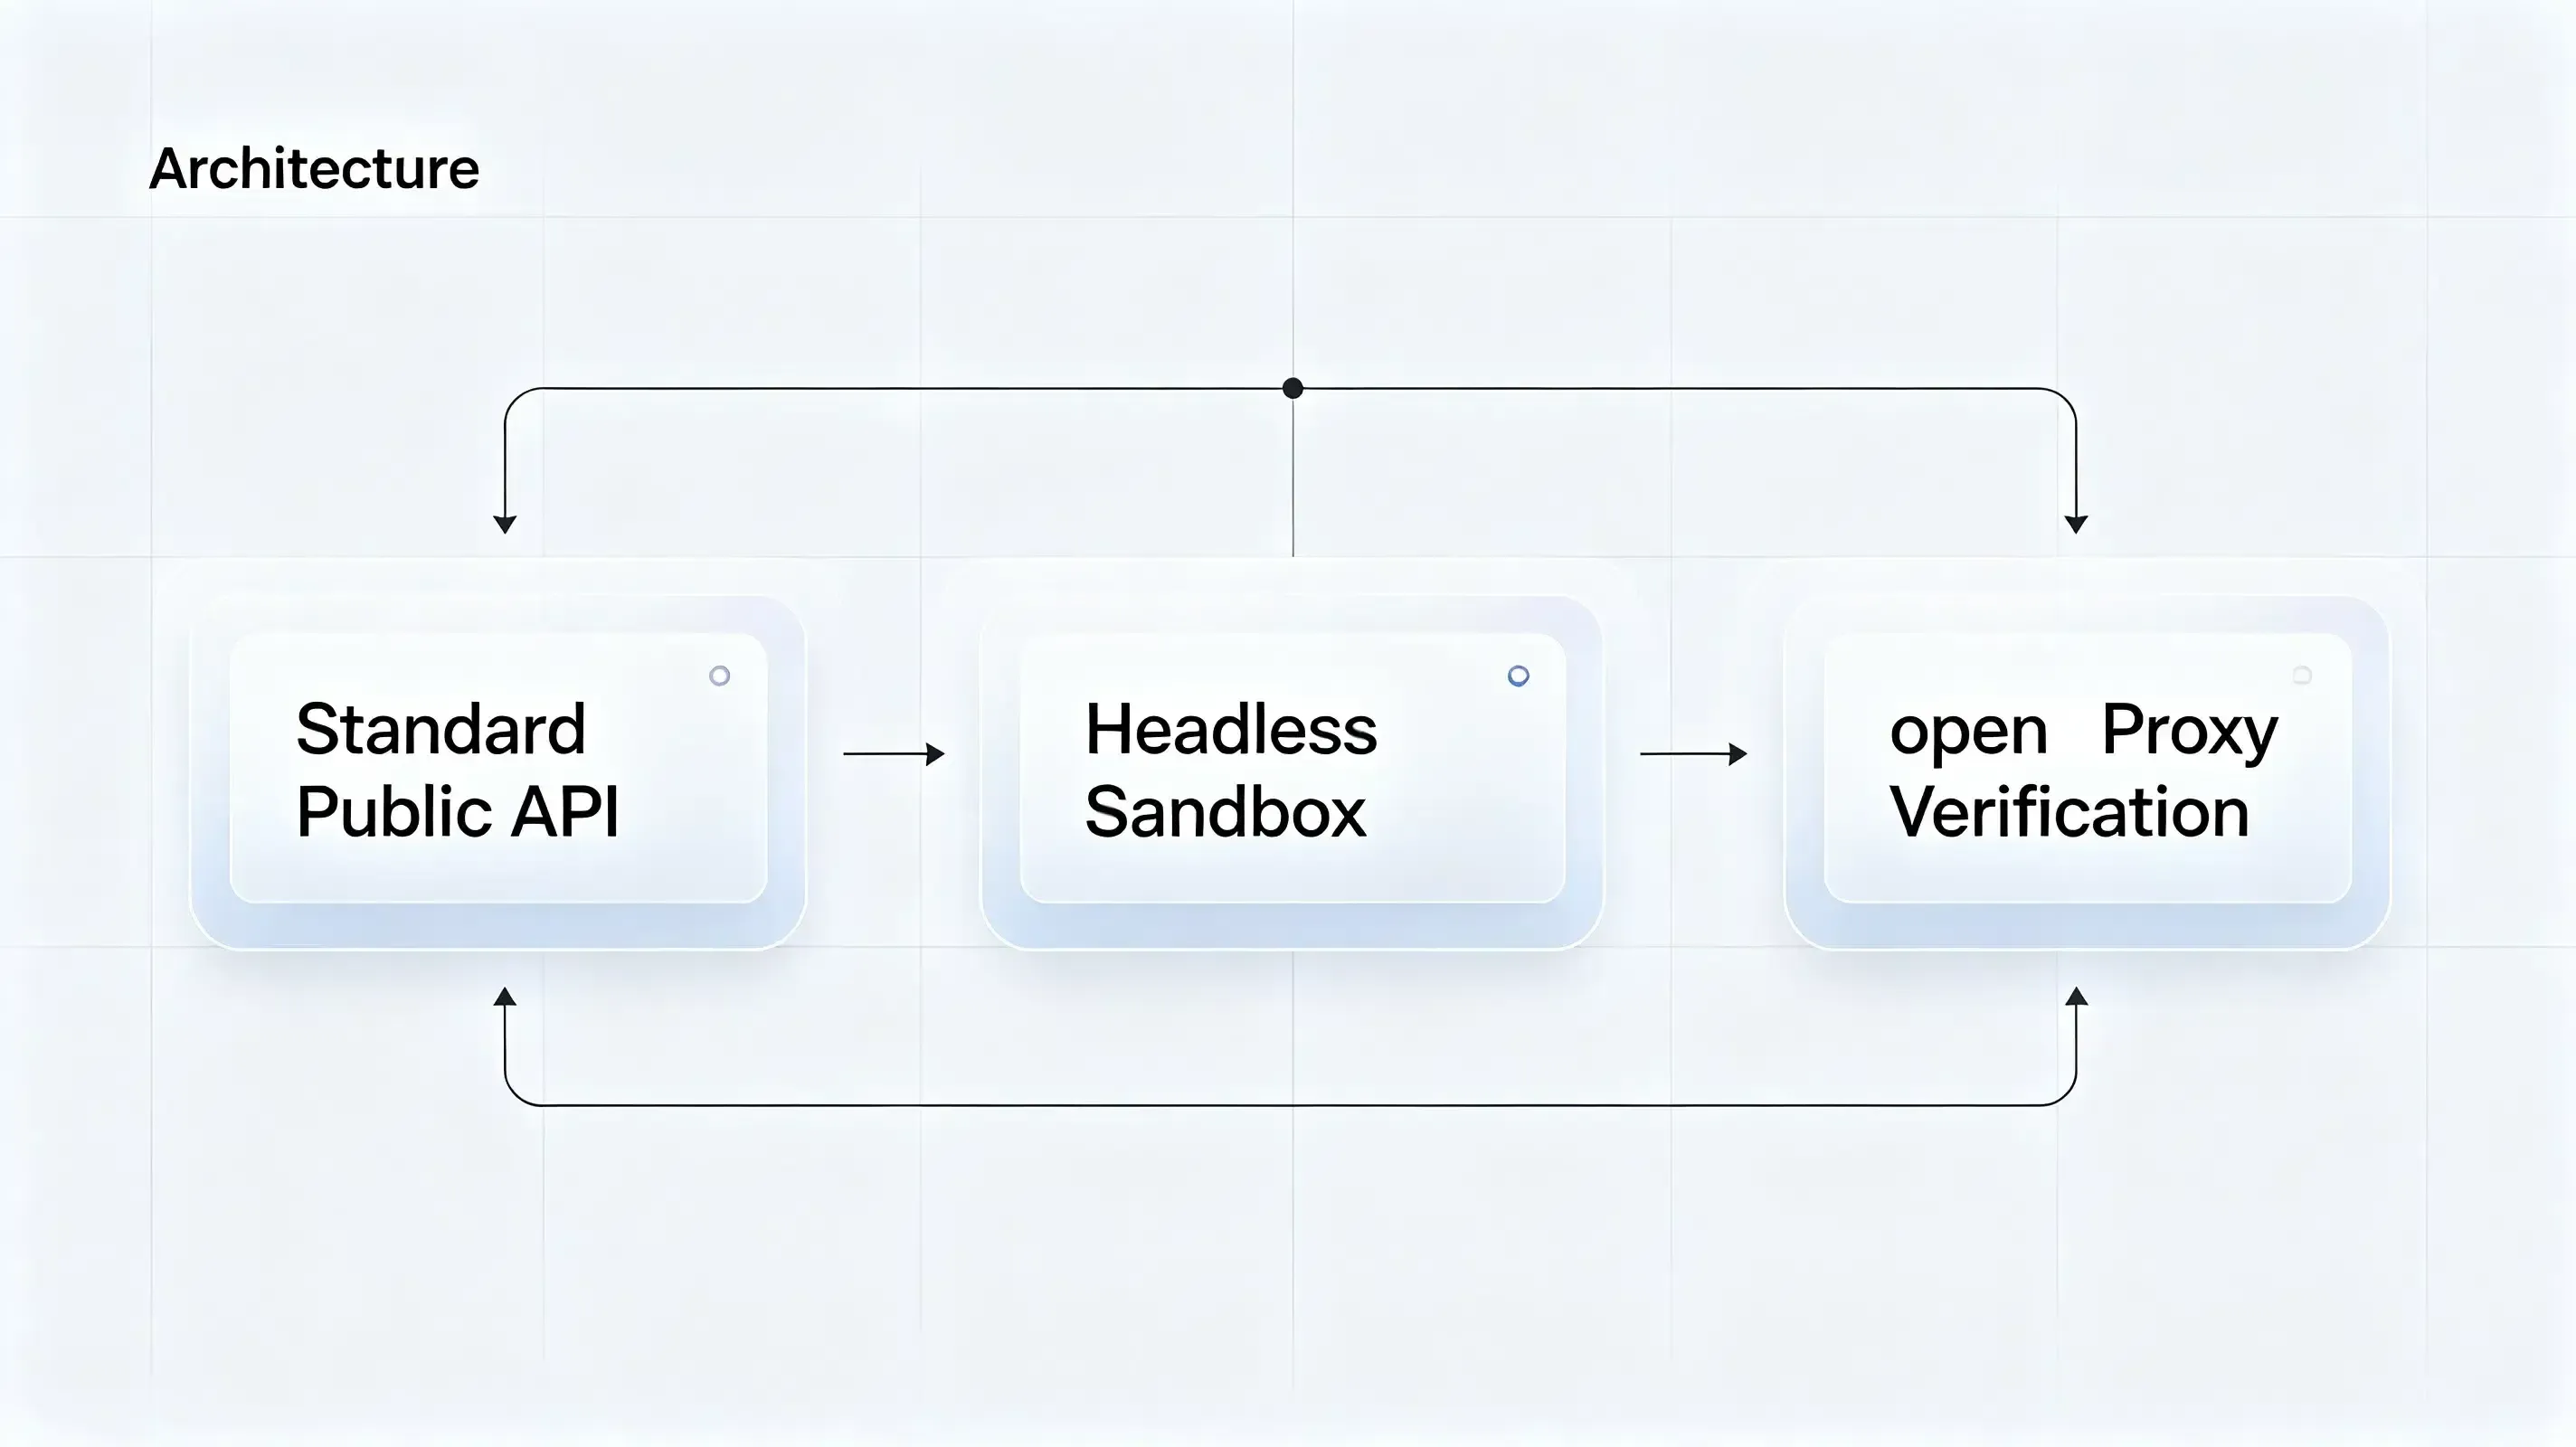
Comparação de configuração de ambiente de desenvolvimento
| Configuração de Ambiente | Acesso à Rede de Saída | Risco de Contaminação | Nível de Conformidade |
|---|---|---|---|
| API Pública Padrão | ✅ Habilitado | ⚠️ Alto | Baixo (Potencial Vazamento) |
| Sandbox Headless | ❌ Bloqueado | ❌ Não | Alto (Isolamento Estrito) |
| Verificação de Proxy no Servidor | 🔄 Controlado | ❌ Não | Alto (Totalmente Auditado) |
Implementações comerciais dessa arquitetura incluem Branch, AppsFlyer, Adjust, Opoinstall e outras plataformas de atribuição diferida. Esses sistemas mantêm o estado no lado do servidor antes da instalação e restauram os parâmetros quando o aplicativo é iniciado pela primeira vez, contornando os problemas de confiabilidade associados às sessões de navegador do lado do cliente. Várias plataformas de software fornecem sincronização de estado no lado do servidor ou persistência de parâmetros programáticos para lidar com sessões de desenvolvimento distribuídas. Um exemplo dessa abordagem é o Opoinstall, que mapeia parâmetros de execução e metadados de sessão do desenvolvedor para um banco de dados de estado centralizado, garantindo que os contextos de sessão sejam preservados mesmo quando tarefas iniciais são executadas de forma automatizada (headless) em contêineres de nuvem isolados. As equipes de engenharia podem avaliar essas abordagens de acordo com os requisitos de implantação e metas de precisão de atribuição, e enquanto a Meta proíbe o 'Claude' para proteger o treinamento do modelo Llama, as divisões de desenvolvimento estão reconhecendo o valor dessas arquiteturas de roteamento de dados localizadas.
Perguntas Frequentes (FAQ)
A política da Meta de proibir o 'Claude' afeta todos os funcionários da empresa?
O que devo exportar antes de migrar de ferramentas de IA externas para alternativas internas?
Como a atribuição de referências pode sobreviver em ambientes de desenvolvimento automatizados (headless)?
Implicações práticas e perspectivas futuras
A ascensão de sandboxes de desenvolvedor rigorosos e regras de conformidade ao nível de rede sinaliza uma mudança mais ampla em direção a ambientes de programação seguros e isolados. À medida que as aplicações se comunicam cada vez mais através de trocas de dados automatizadas, em vez de layouts renderizados por humanos, as equipes de engenharia devem reavaliar as estratégias de integração tradicionais. Plataformas que dependem fortemente de ações manuais e visuais dos usuários podem enfrentar lacunas estruturais quando agentes automatizados gerenciam o pipeline de requisições. A transição para atribuição do lado do servidor e passagem de parâmetros segura representa uma direção altamente provável para manter uma cobertura confiável de rastreamento e segurança.
A transição sugere uma reescrita fundamental de nossas estruturas de medição e protocolos de segurança. É provável que os futuros sistemas de atribuição dependam mais fortemente de correspondência de identidade no lado do servidor e sincronização segura de estados. À medida que mais agentes de IA começam a atuar como os principais impulsionadores da geração de código digital, as arquiteturas de engenharia seguras dependerão cada vez mais do sandboxing do lado do servidor, soberania de dados e auditoria de contexto de tempo de execução, em vez de apenas endpoints de API puros.
Share this article



