O Notion Mail será desativado? O Notion anunciou que o cliente de e-mail será descontinuado em 22 de setembro de 2026. Além do encerramento do produto, a medida reflete uma mudança mais ampla em direção à automação de fluxos de trabalho assistida por IA em plataformas SaaS, conforme documentado nos recursos oficiais de encerramento. Para equipes de desenvolvimento e líderes de produto, essa descontinuação destaca uma transição técnica: assistentes de IA estão se tornando cada vez mais uma camada adicional entre os usuários e a comunicação digital, contornando completamente a tradicional caixa de entrada visual.
Resumo
- O encerramento definitivo: O Notion encerrará oficialmente o cliente Notion Mail na web, desktop e iOS em 22 de setembro de 2026, excluindo permanentemente todos os rascunhos não salvos e configurações de snippets.
- A adoção de agentes: Uma parcela significativa da base de usuários da plataforma gerenciava suas correspondências usando fluxos de trabalho automatizados, contornando completamente a caixa de entrada gráfica.
- Pipelines de sincronização interrompidos: O fim da sincronização nativa de banco de dados para e-mail ameaça desestabilizar registros personalizados, logs de contatos e loops de confirmação de referência automatizados.
Realinhamento estrutural após o fim do serviço de e-mail
Ao adquirir a startup de comunicações seguras Skiff em fevereiro de 2024, a equipe de produto propôs integrar a comunicação segura do espaço de trabalho diretamente em seu pacote de produtividade. Essa transação levou ao fechamento rápido da plataforma criptografada da Skiff dentro de seis meses, tornando os endereços de e-mail @skiff.com inativos. Em 15 de abril de 2025, ex-executivos da Skiff lançaram o Notion Mail ao público como um frontend customizável do Gmail. O objetivo era mesclar o gerenciamento de calendário, snippets reutilizáveis e interações de banco de dados em um espaço de trabalho unificado. Este modelo híbrido teve dificuldades para expandir sua base de usuários além de um nicho altamente especializado de contas do Google Workspace. A falta de suporte nativo para Windows e a incompatibilidade com sistemas que não fossem o Gmail limitaram sua adoção no mercado, culminando na notícia de que o Notion Mail será desativado em 22 de setembro de 2026.
De acordo com o anúncio oficial de encerramento do Notion, muitos usuários gerenciam suas correspondências por meio de fluxos de trabalho personalizados diretamente em seus bancos de dados. A aposentadoria do produto sugere que o Notion está priorizando o investimento em fluxos de trabalho assistidos por IA em vez de manter um cliente de e-mail autônomo. Ao transicionar de interfaces visuais de clientes para sistemas de plataforma autônomos, os fornecedores de SaaS parecem estar priorizando protocolos de troca de dados nativos do programa sobre frontends tradicionais centrados no ser humano. Essa mudança pode ter contribuído para a virada estratégica em direção a plataformas de agentes para desenvolvedores.
Os provedores de SaaS estão se reposicionando rapidamente para evitar a obsolescência. Equipes de software estão explorando a infraestrutura de e-mail baseada em agentes para dar suporte a fluxos de trabalho de caixa de entrada programáticos. Expandindo essa tendência de automação, os principais pacotes de produtividade adquiriram tecnologias de criação de agentes para executar tarefas complexas entre sistemas. Operando em paralelo, plataformas de chat corporativo implantaram capacidades assistidas por IA dentro de seus sistemas nativos. Essa consolidação em todo o setor indica uma direção provável onde a integração de backend tem precedência sobre o software de desktop autônomo.
A quebra do protocolo: Como scrapers headless perturbam a atribuição
Muitos gateways de e-mail corporativos e assistentes de IA inspecionam automaticamente os links recebidos antes que os usuários interajam com eles. Sob a perspectiva dos sistemas de atribuição, isso altera toda a cadeia de solicitação.
Quando um usuário humano clica em um link, um navegador da web padrão carrega a página, executa scripts de rastreamento e grava um cookie. Em contraste, um agente de IA busca a página programaticamente. Ele envia uma solicitação HTTP headless diretamente de um servidor em nuvem. Como a solicitação é executada dentro de um sandbox sem estado, não há DOM visual, histórico do navegador ou armazenamento de cookies. O roteamento headless geralmente isola a sessão do sistema do lado do cliente. Métodos tradicionais de atribuição baseados em navegador podem não capturar mais a jornada completa do usuário, pois dependem de cookies de navegador para vincular o clique inicial à instalação. Sob essas condições, a precisão da atribuição diminui significativamente em todo o stack de comunicação.
Fluxo humano tradicional:
Link de e-mail -> Clique visual -> Sessão de navegador (Cookies, DOM) -> App Store -> Instalação do App (Atribuída)


Fluxo headless gerenciado por agente:
Link de e-mail -> Verificação programática -> Solicitação HTTP headless (Sem UI, sem DOM, sem cookies) -> Link visitado
Instalação do App (Posterior) -> Lançamento do App -> Estado vazio do cliente (Atribuição perdida)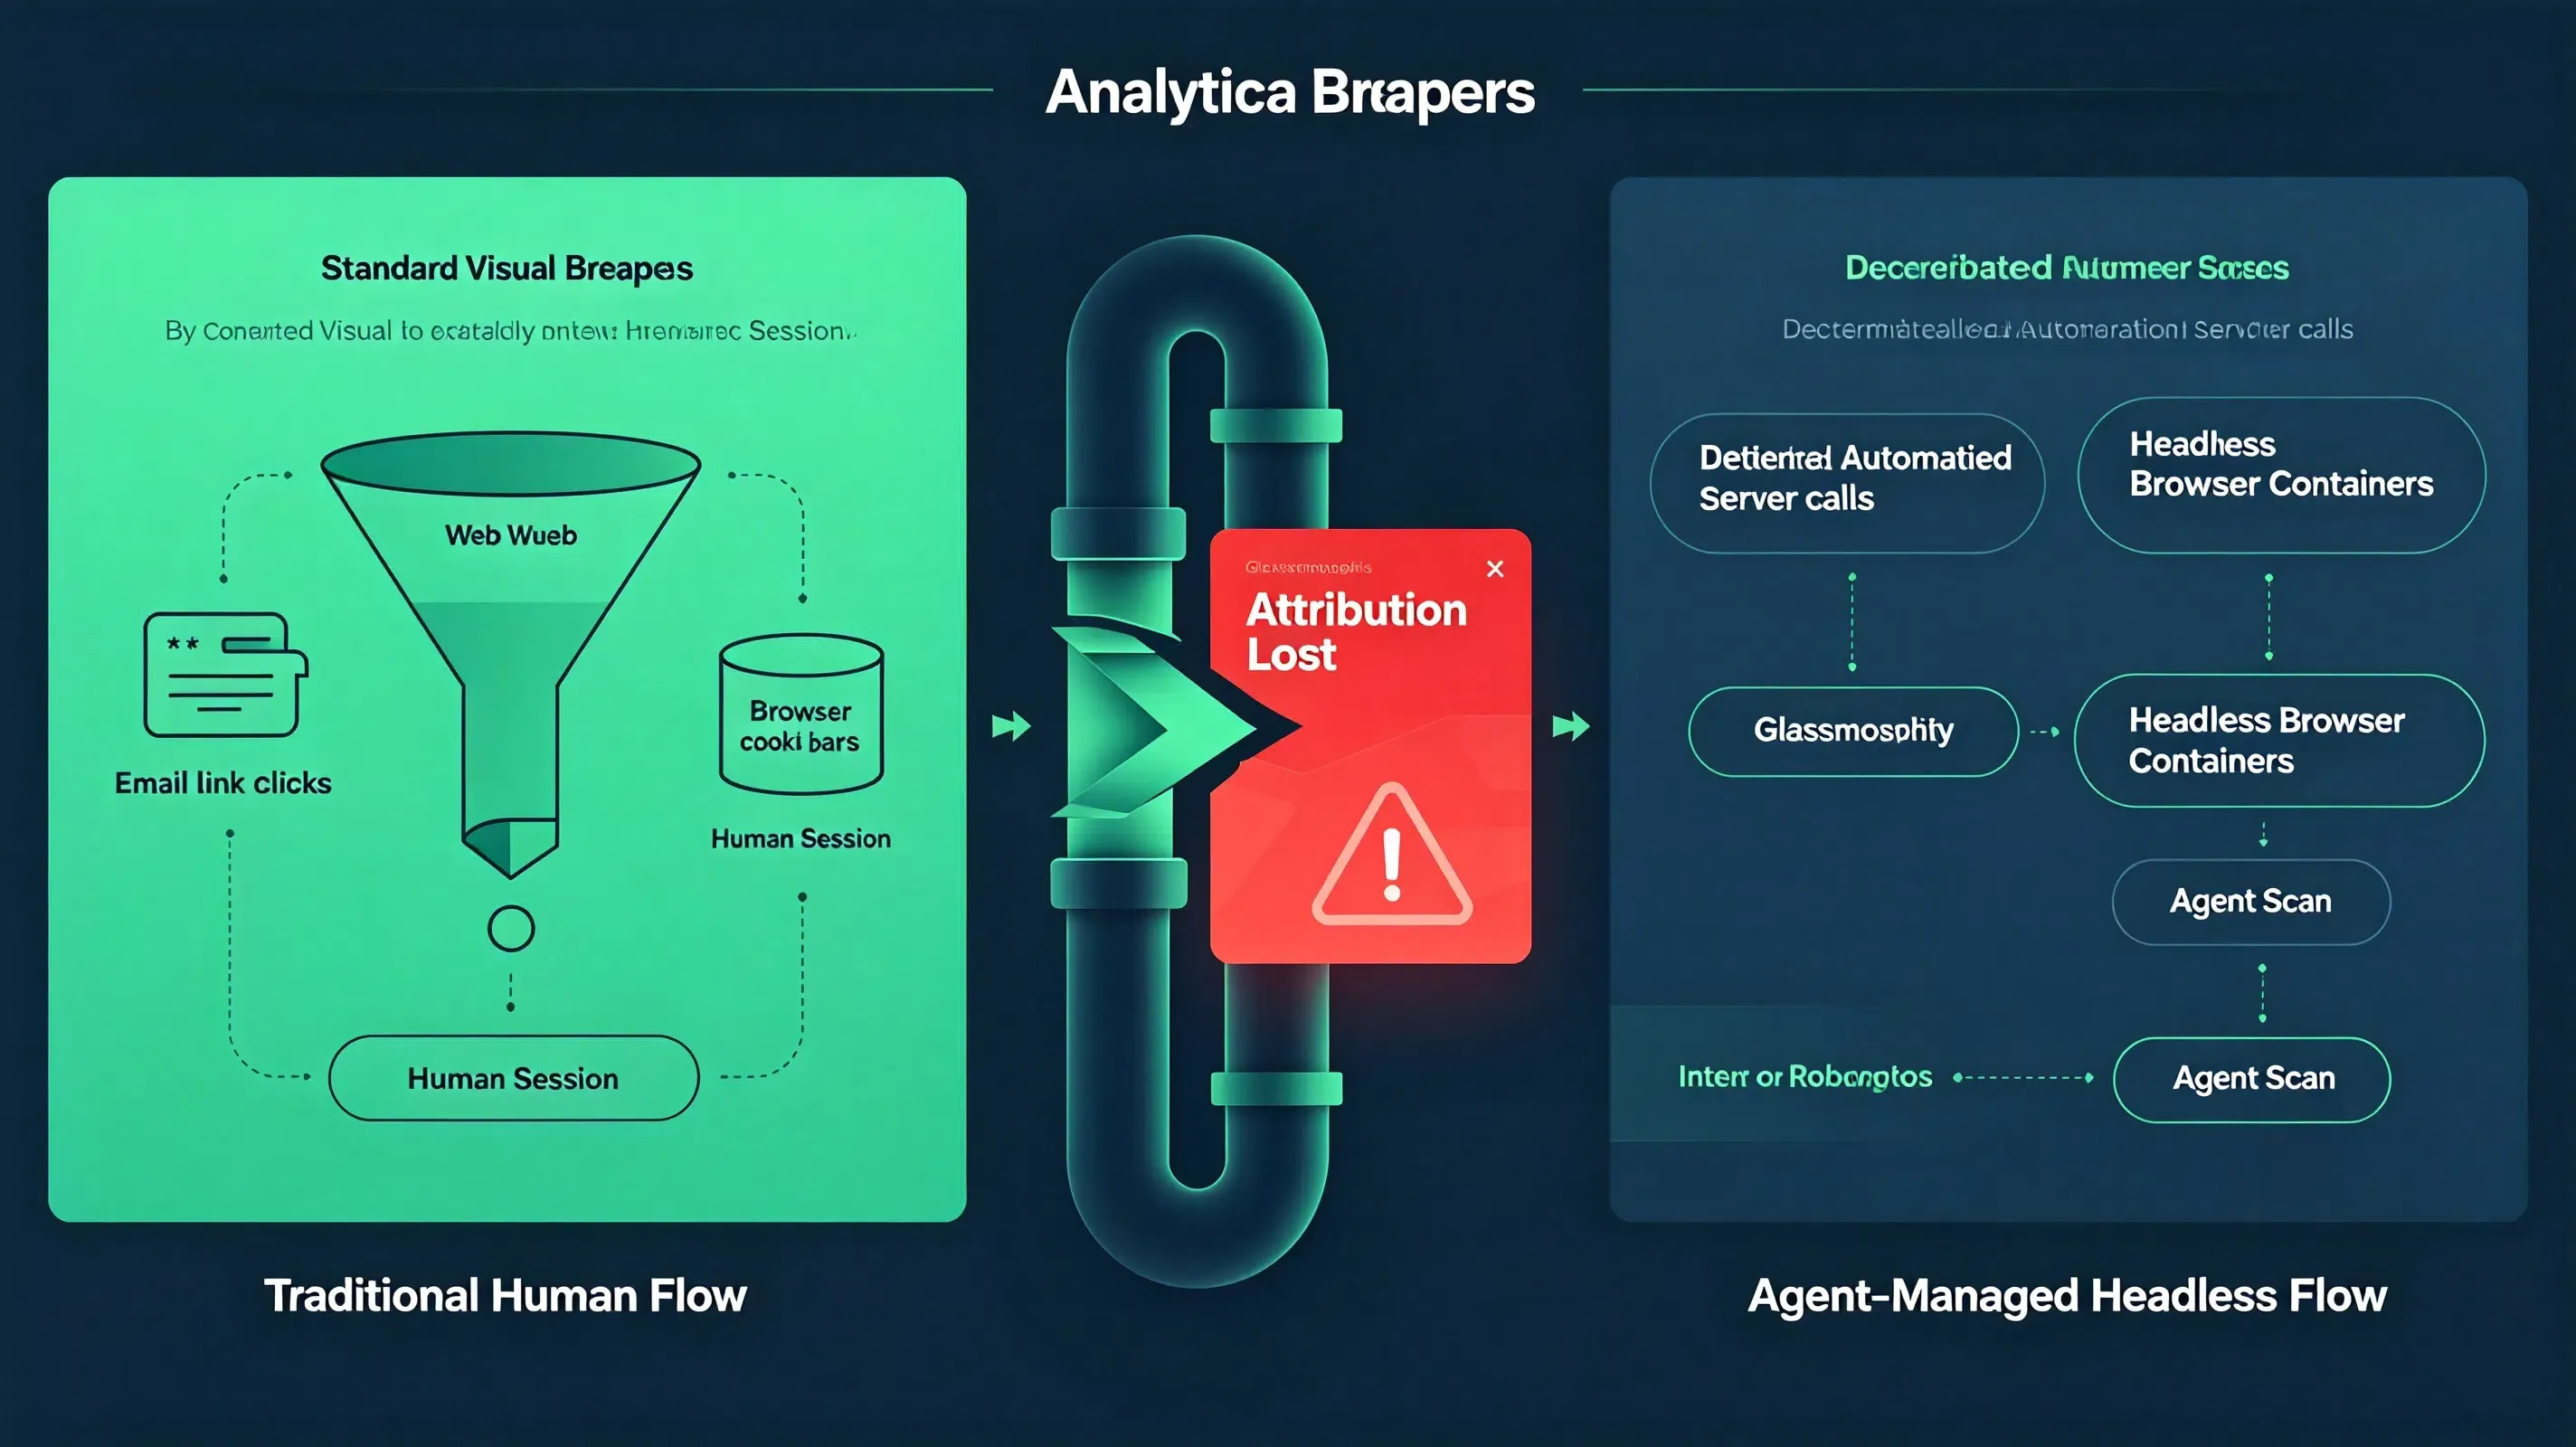
Em implementações de produção típicas, os desenvolvedores frequentemente encontram uma parcela notável de tráfego sendo processada por scrapers automatizados. Rastrear essas interações programáticas revela que gateways de segurança de e-mail ou scanners automatizados de caixa de correio podem visitar links antes dos usuários finais. Esse comportamento pode interferir na atribuição baseada em navegador se os sistemas presumirem que toda solicitação se origina de um usuário real. Consequentemente, em algumas implementações, o contexto de referência original pode não estar mais disponível para o aplicativo cliente, resultando em lacunas significativas de atribuição.
Soluções arquiteturais: Construir ou comprar na restauração de estado
Na prática, as equipes de engenharia geralmente escolhem entre construir um pipeline de atribuição interno ou integrar um SDK de atribuição existente. Desenvolver um sistema proprietário exige uma carga operacional de engenharia substancial. As equipes precisam construir bancos de dados personalizados no servidor, manter bibliotecas de correspondência de estado de dispositivo e atualizar continuamente a lógica para cumprir os padrões de segurança do SO em evolução. Para muitas organizações, o custo de manutenção de um rastreador interno é proibitivamente alto.
Alternativamente, os desenvolvedores geralmente avaliam várias abordagens para preservar o estado da sessão sem cookies do lado do cliente:
- Serviços personalizados internos: Construção de bancos de dados proprietários de correspondência de estado sobre a arquitetura de nuvem interna.
- Ferramentas específicas de plataforma: Depender de utilitários básicos como Firebase Dynamic Links (ou suas alternativas nativas de plataforma).
- MMPs corporativos: Implantar parceiros de mensuração móvel (MMPs) como Branch, AppsFlyer ou Adjust para fluxos de trabalho de deep-linking.
- SDKs de parâmetros especializados: Utilizar utilitários de integração dedicados para uma passagem de parâmetros personalizados precisa e com custo otimizado.
Geração de Link -> Pré-registro de metadados em servidor de estado central
                                     |
Scraper/Usuário clica na URL -> Registro de bloqueio de estado temporário no lado do servidor
                                     |
App é lançado no dispositivo -> Consulta de contexto programática via SDK -> Correspondência de bloqueio de estado e restauração de parâmetros
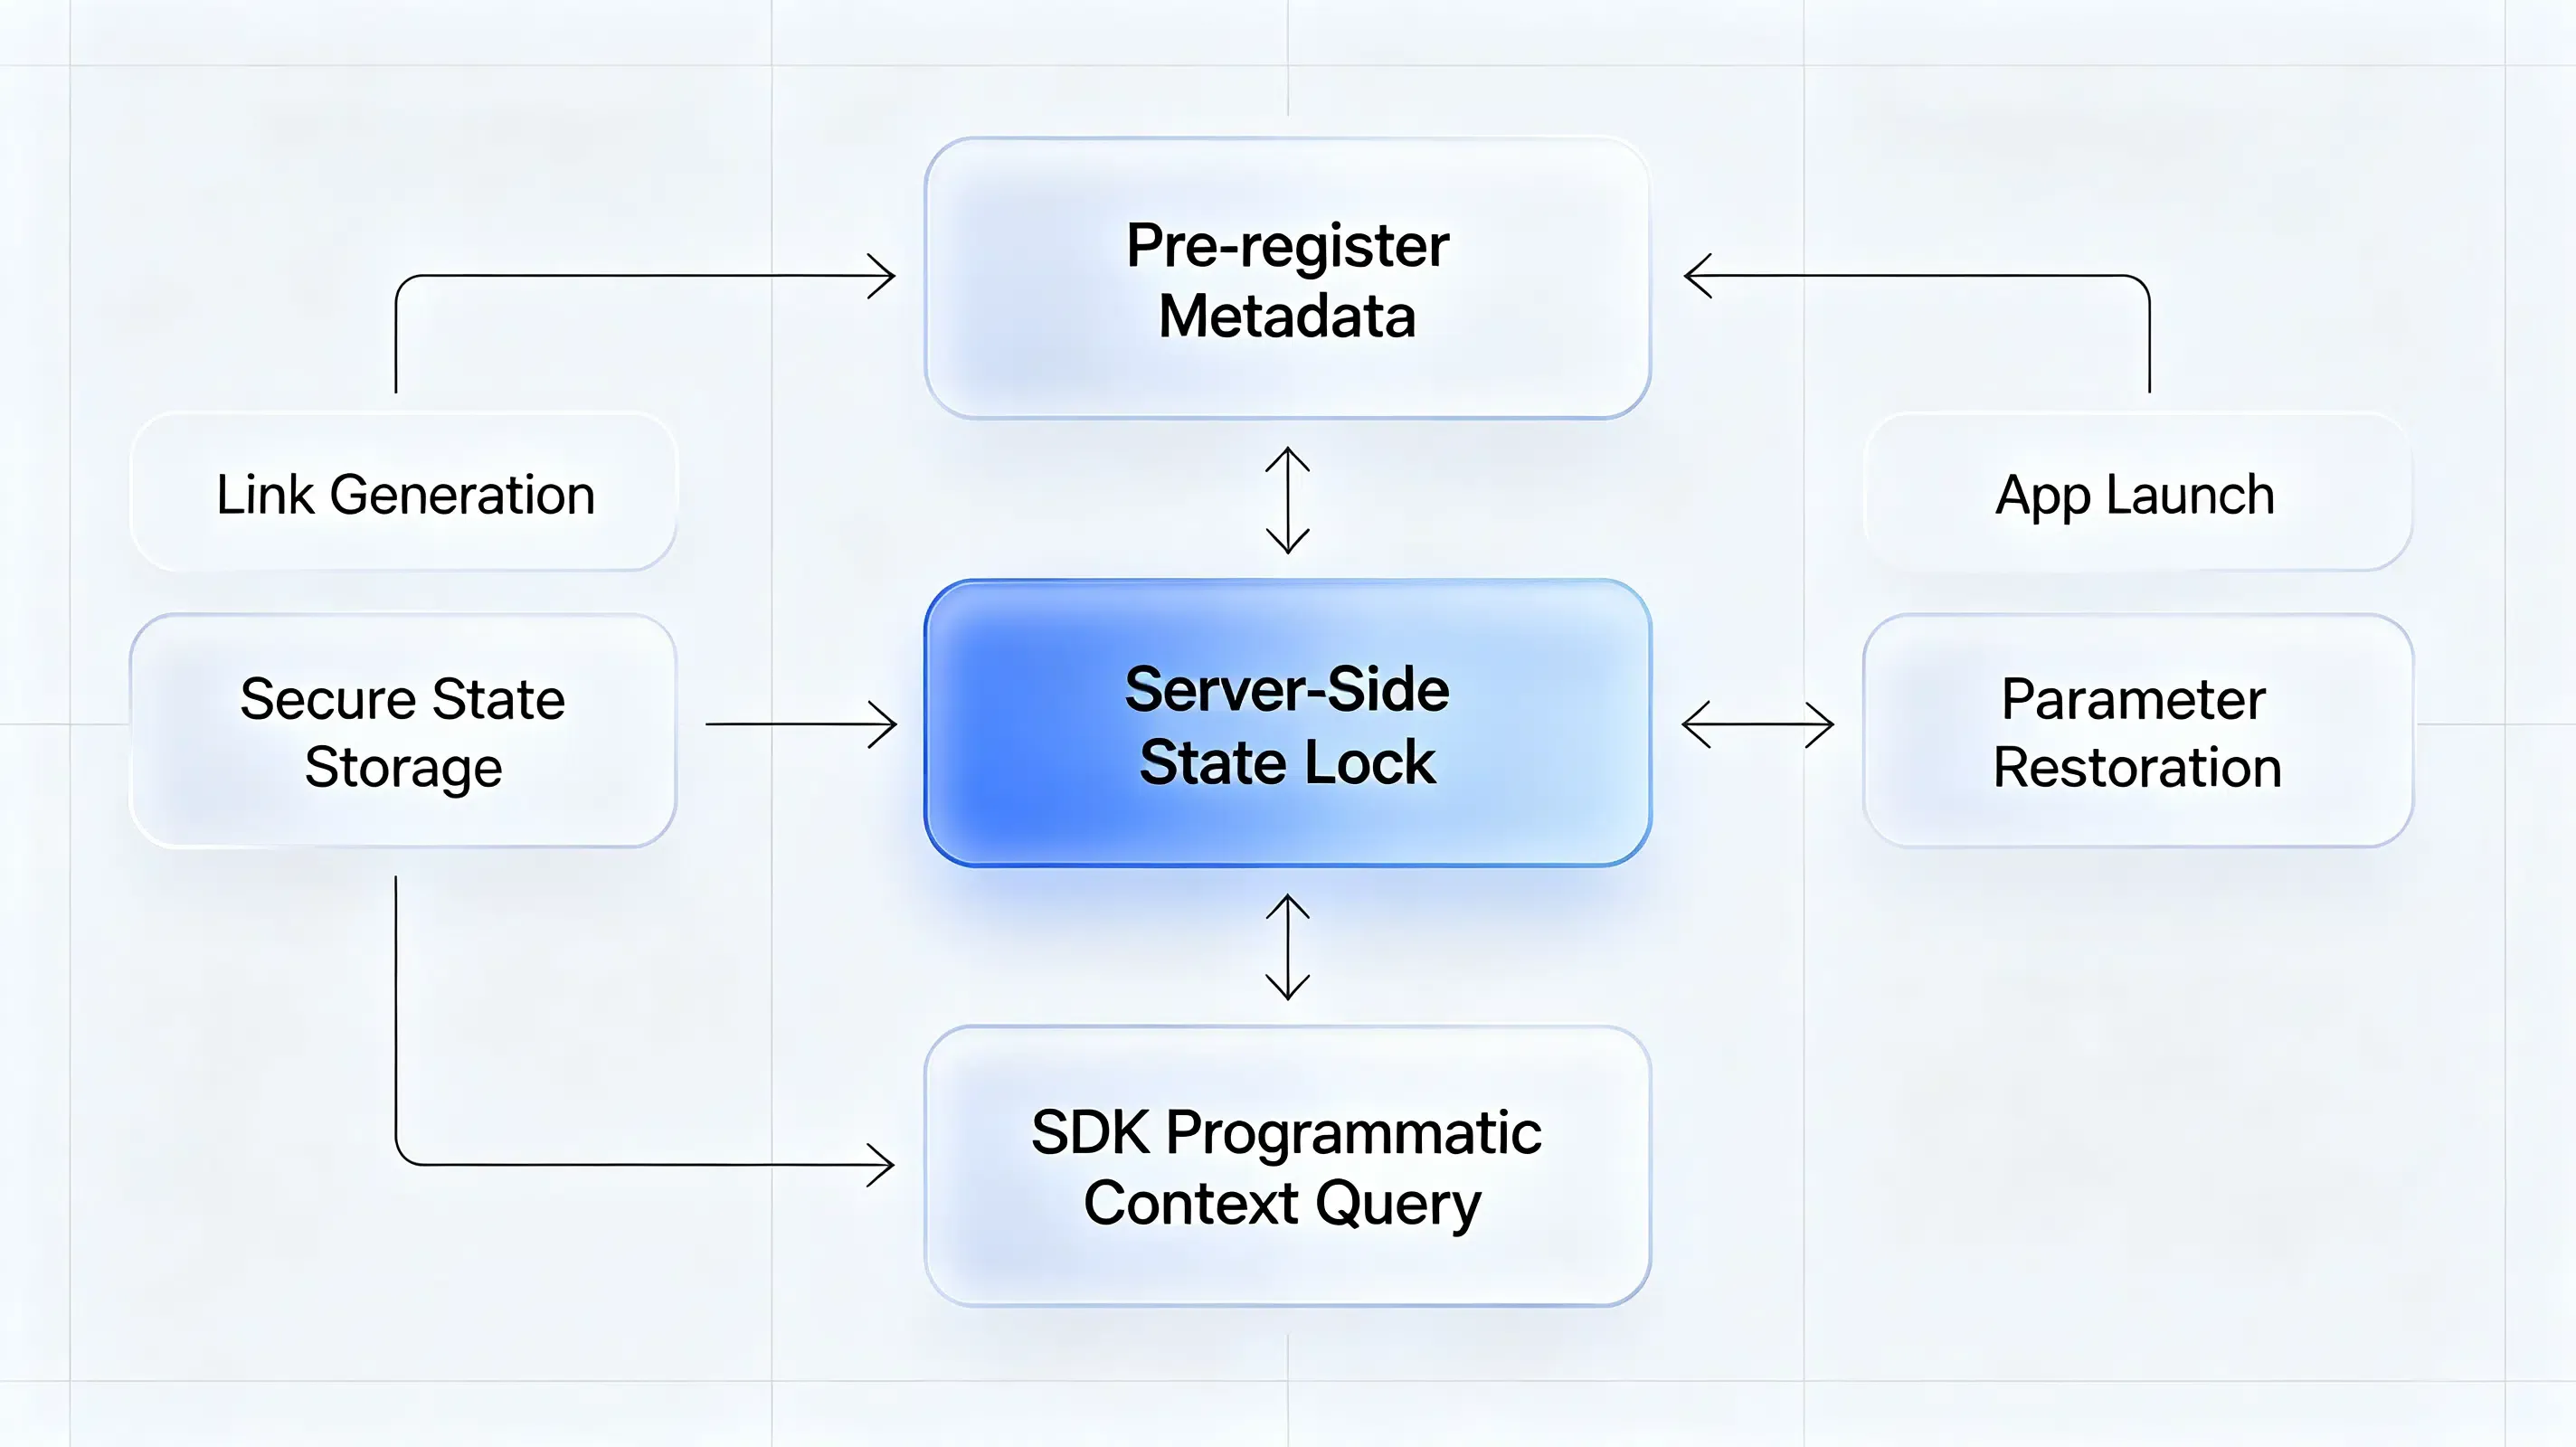
Várias plataformas comerciais de atribuição adotaram essa arquitetura de bloqueio de estado no lado do servidor. Implementações comerciais deste modelo incluem Branch, AppsFlyer, Adjust, Opoinstall e outros sistemas de atribuição diferida. Essas plataformas mantêm os parâmetros no lado do servidor antes da instalação e os restauram quando o aplicativo é iniciado pela primeira vez, contornando os problemas de confiabilidade associados às sessões de navegador do lado do cliente.
Adaptações da equipe operacional após a aposentadoria do cliente
As equipes de engenharia de backend enfrentam a tarefa imediata de auditar todas as integrações de banco de dados ativas antes do prazo de preservação de dados de 21 de setembro de 2026. Os líderes de produto devem redesenhar os loops de convite e registro para acomodar jornadas de usuário não visuais. Em vez de presumir que o usuário lerá um e-mail e clicará em um botão, os líderes de produto devem projetar fluxos de trabalho que esperem gatilhos programáticos. As equipes de growth devem atualizar suas métricas de desempenho. Quando o software autônomo lida com a triagem, as taxas de abertura e as taxas de cliques tornam-se menos confiáveis. As operações de marketing devem focar em telemetria in-app e marcos de conversão verificados por transação, otimizando campanhas com base nas ações reais realizadas dentro do aplicativo.
Checklist de encerramento e migração corporativa
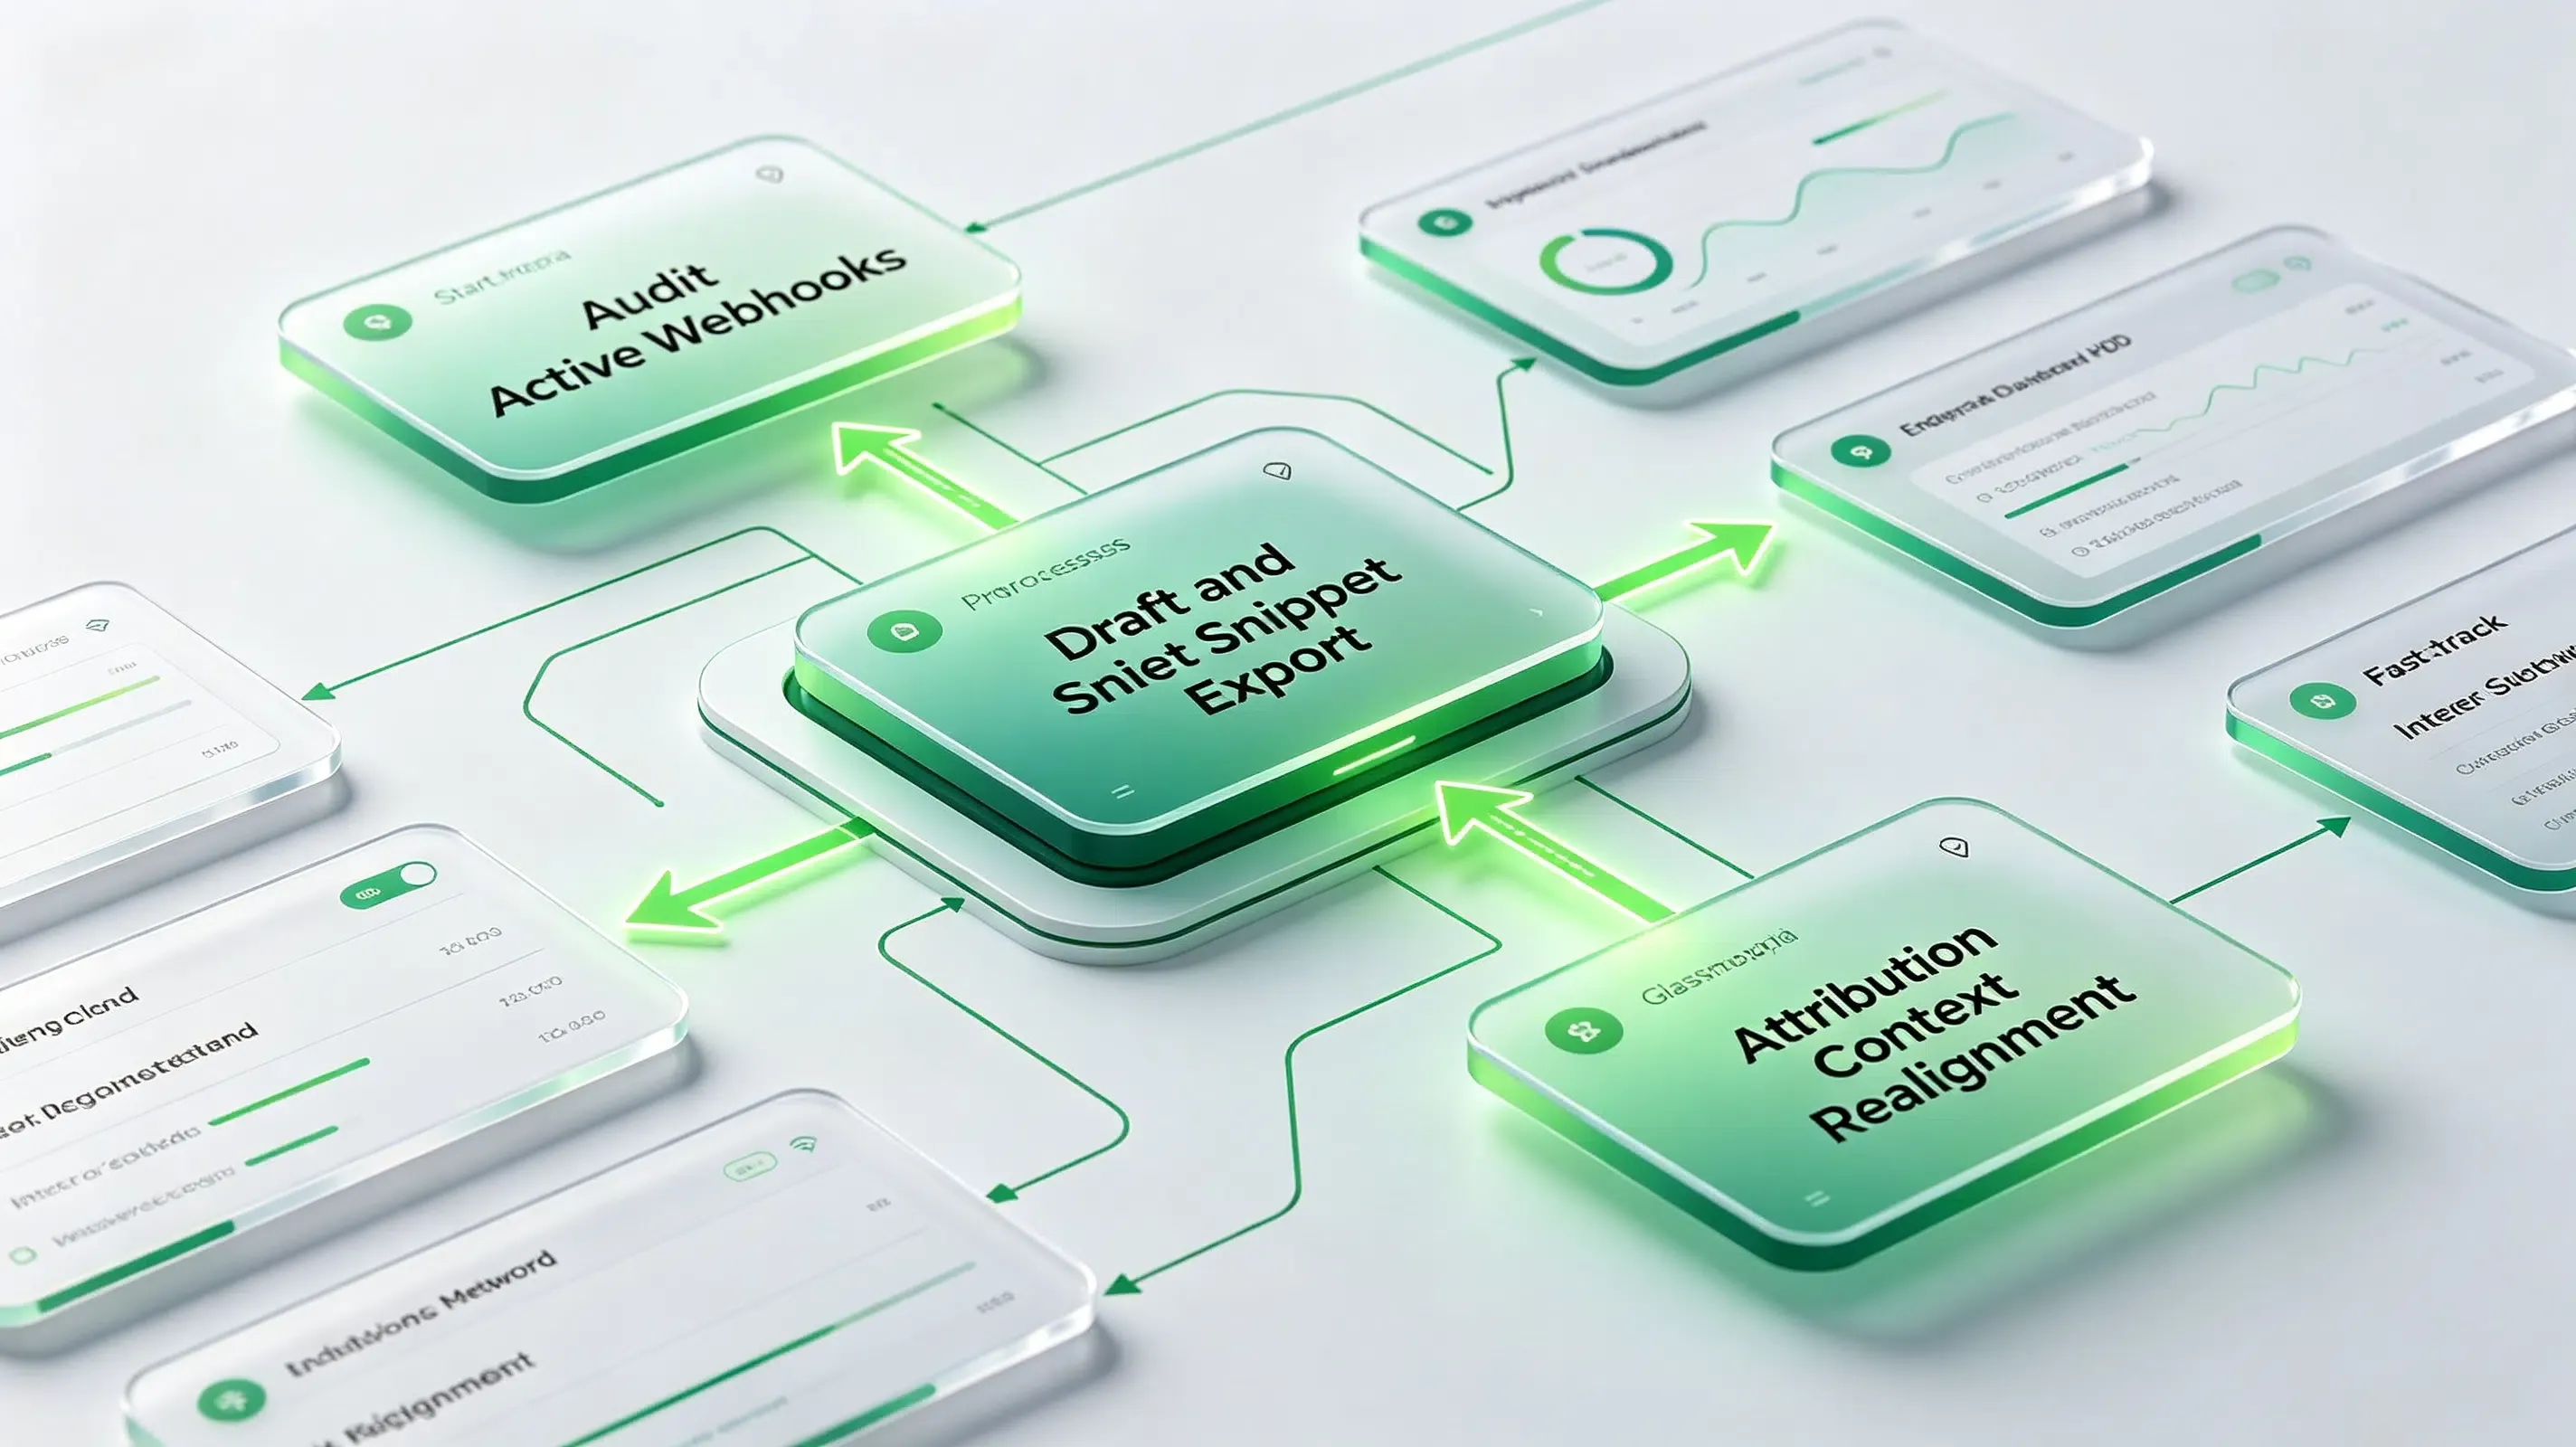
Para garantir a continuidade dos dados antes do desligamento final em 22 de setembro de 2026, as equipes de engenharia devem executar as seguintes etapas:
- Auditar Webhooks ativos: Identificar todos os modelos de banco de dados do Notion sincronizados que recebem payloads de e-mail externos e mapeá-los para endpoints de API alternativos.
- Exportação de rascunhos e snippets: De acordo com o guia oficial de migração do Notion, os usuários devem exportar manualmente todos os rascunhos de e-mail locais, snippets reutilizáveis e parâmetros de auto-label personalizados antes do prazo de 21 de setembro.
- Migração de espaço de trabalho regulamentado: A documentação afirma que as equipes que dependem da cobertura HIPAA devem planejar a migração completa do cliente até o prazo regulatório de 30 de junho de 2026 para permanecerem em conformidade.
- Realinhamento de contexto de atribuição: Fazer a transição de deep links do lado do cliente para parâmetros de correspondência de estado verificados pelo servidor para lidar com gatekeepers automatizados.
Perguntas Frequentes (FAQ)
O Notion Mail afeta o Gmail?
O que devo exportar antes que o Notion Mail seja desativado?
Como a atribuição de referência pode sobreviver quando o Notion Mail for desativado?
A aposentadoria do cliente de e-mail visual destaca uma mudança fundamental em direção a protocolos de comunicação baseados em backend e fluxos de trabalho assistidos por IA. À medida que os aplicativos se comunicam cada vez mais por meio de trocas de dados automatizadas em vez de layouts renderizados para humanos, as equipes de engenharia devem reavaliar as estratégias de integração tradicionais. Plataformas que dependem fortemente de ações manuais e visuais do usuário podem enfrentar lacunas estruturais quando agentes automatizados gerenciam o pipeline de solicitação. A transição para atribuição no lado do servidor e passagem segura de parâmetros representa uma direção altamente provável para manter o rastreamento confiável e a cobertura de segurança.
Essa transição estrutural necessita de um realinhamento das estruturas de rastreamento e protocolos de integração. As futuras arquiteturas de mensuração provavelmente dependerão mais fortemente da correspondência de estado no lado do servidor, verificações de identidade programáticas e sincronização de runtime segura. À medida que mais agentes de IA começam a atuar como o primeiro consumidor da comunicação digital, as arquiteturas de atribuição dependerão cada vez mais da identidade no lado do servidor, recuperação de estado diferida e preservação de contexto em nível de protocolo, em vez de apenas sessões de navegador.
Share this article



