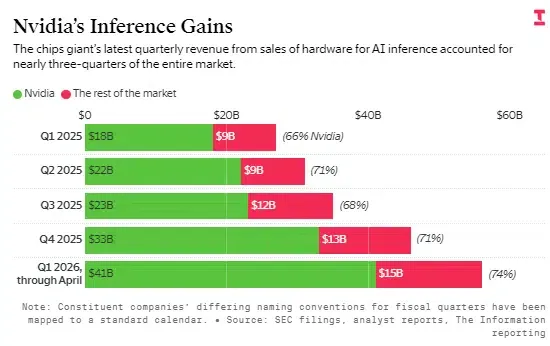
 Por que a NVIDIA está combinando GPUs com ASICs da d-Matrix? A NVIDIA não aposta mais apenas em GPUs. Por que a NVIDIA está fazendo parceria com a d-Matrix em vez de desenvolver ASICs de inferência internamente? A resposta revela uma transformação mais ampla na infraestrutura de IA: a otimização da inferência está migrando do escalonamento de GPU puro para a aceleração específica por carga de trabalho. À medida que a inferência de IA transita entre GPUs, aceleradores ASIC e ambientes de nuvem distribuídos, o desafio já não é apenas a capacidade computacional. A orquestração de hardware, o roteamento de cargas de trabalho e a eficiência em nível de sistema estão se tornando igualmente importantes. Conforme as cargas de trabalho de inteligência artificial generativa migram de grandes clusters de treinamento para a implementação de modelos em tempo real, a otimização da velocidade de geração de tokens foi priorizada como um desafio de engenharia fundamental. A NVIDIA combina GPUs com ASICs da d-Matrix para suportar sistemas de inferência desagregados e heterogêneos.
Por que a NVIDIA combina GPUs com ASICs da d-Matrix: Alinhando Cargas de Trabalho com a Física do Silício
Em síntese
- A NVIDIA está combinando suas frotas dominantes de GPUs Hopper e Blackwell com os aceleradores de inferência Corsair da d-Matrix para implementar sistemas de inferência heterogêneos e desagregados.
- A provedora de Neocloud Parasail emergiu como a primeira cliente comercial, implementando a solução de hardware conjunta em sua frota global de data centers.
- Cargas de trabalho de inferência em larga escala podem sofrer com a subutilização significativa de GPUs quando a largura de banda de memória e o movimento de dados se tornam os fatores limitantes, em vez da disponibilidade de computação bruta.
O modelo econômico da inteligência artificial em larga escala está passando por uma transição significativa do treinamento de modelos para a implementação de inferência. Durante a fase inicial de escalonamento, provedores de nuvem e desenvolvedores corporativos focaram pesadamente no poder computacional bruto de retropropagação, adquirindo clusters massivos de unidades de processamento gráfico (GPUs). Essa dependência de um único fornecedor era altamente lógica quando o treinamento de datasets massivos exigia execução paralela contínua. No entanto, à medida que as organizações fazem a transição para atender milhões de usuários ativos em tempo real, o custo operacional de executar uma infraestrutura baseada apenas em GPUs para tarefas de inferência tornou-se insustentável.
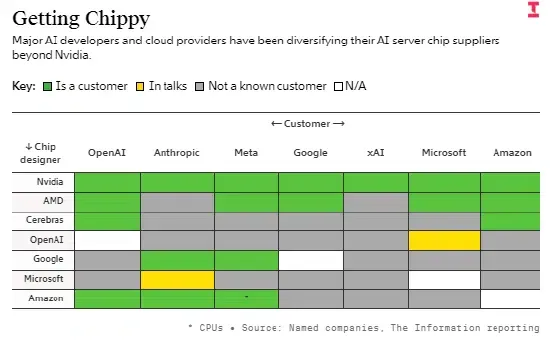
Para otimizar os gastos operacionais, arquitetos de infraestrutura estão buscando frameworks de computação desagregada. Sob esse paradigma multi-fornecedor, uma única consulta de usuário é dividida em fases de execução distintas e roteada para diferentes aceleradores de hardware com base em perfis de tarefas específicos. Essa abordagem permite que os provedores de nuvem obtenham o máximo desempenho por dólar investido a partir de frotas existentes, o que é documentado na investigação do The Information que monitora integrações de nuvem multi-fornecedor.
As implicações industriais desta colaboração estendem-se para além da simples distribuição de carga de trabalho. Ao integrar oficialmente os aceleradores Corsair da d-Matrix com a frota de hardware da NVIDIA, a colaboração estabelece um caminho validado para arquiteturas de nuvem heterogêneas. Em vez de forçar os clientes a escolher entre clusters de GPU padrão e silício personalizado emergente, o sistema de inferência NVIDIA-d-Matrix permite que o hardware opere em conjunto, possibilitando que provedores de infraestrutura otimizem as cargas de trabalho de preenchimento (prefill) e decodificação (decode) em diferentes arquiteturas de hardware. Esta arquitetura permite que equipes de nuvem corporativas estendam a utilização de hardware em diversas cargas de trabalho de inferência.
Mecânica Interna: Inferência Heterogênea Desagregada e Computação em Memória
No nível de protocolo, responder a uma solicitação de linguagem natural requer duas fases de processamento distintas. A primeira fase, conhecida como prefill, processa a solicitação do usuário e calcula as ativações iniciais de chave-valor (KV). Este passo é altamente intensivo em computação, tornando-o ideal para o desempenho de aritmética paralela massiva da arquitetura NVIDIA Hopper.
A segunda fase, conhecida como decode, gera os tokens subsequentes um a um em um loop sequencial. Como cada token depende do contexto gerado anteriormente, a fase de decodificação é fortemente limitada pela largura de banda da memória e sensível à latência. Executar esse passo em GPUs de alto consumo de energia resulta em inatividade significativa da computação, já que os núcleos precisam esperar constantemente pela conclusão das transações de memória.
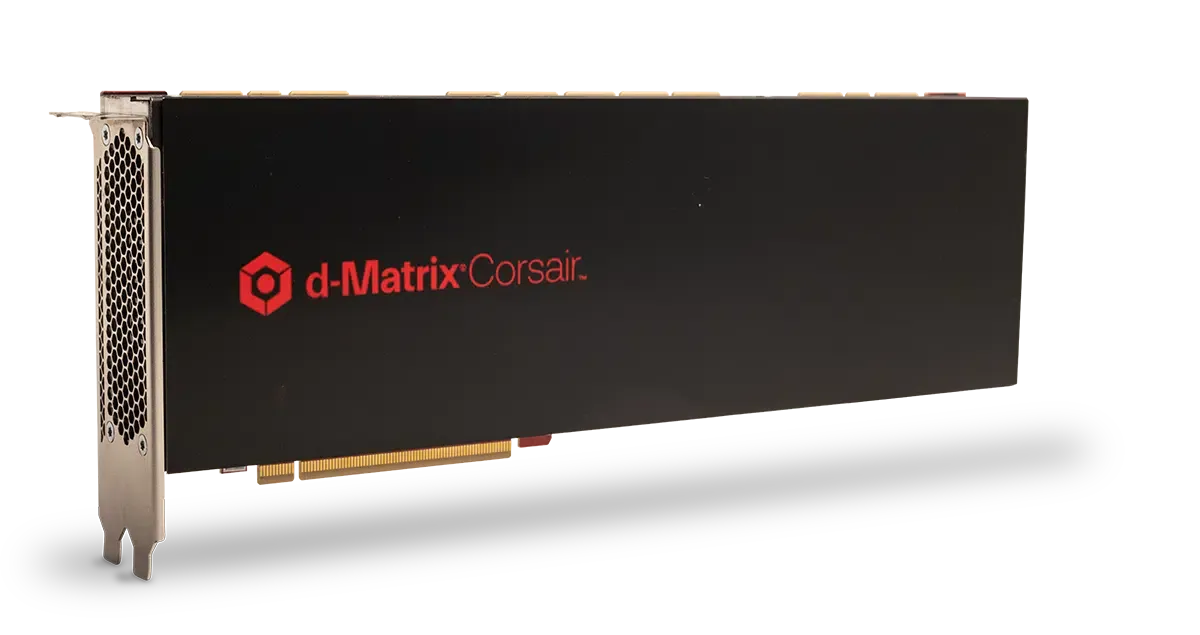
De acordo com a documentação da arquitetura Corsair da d-Matrix, seu acelerador é construído em torno da tecnologia de chiplet de Computação Digital em Memória (DIMC). Construído no processo N6 da TSMC, o chip Corsair integra memória de acesso aleatório estática (SRAM) diretamente ao lado das unidades de computação em uma única pastilha de silício. Este design reduz o custo de movimentação de dados entre a memória e as unidades de computação. Algumas arquiteturas de inferência combinam a otimização em nível de acelerador com técnicas como decodificação especulativa para reduzir ainda mais a latência, à medida que a indústria avalia como a NVIDIA combina GPUs com coprocessadores em memória para resolver o gargalo da memória. Ao implantar chips especializados ao lado de GPUs, o sistema conjunto permite que o hardware opere em harmonia. Essa escolha estrutural explica por que a NVIDIA combina GPUs com coprocessadores em memória para superar a barreira da memória.
Analisar como a NVIDIA combina GPUs com aceleradores externos ajuda os desenvolvedores a avaliar o gargalo central da inferência moderna de transformers. O diagrama abaixo ilustra um modelo de implantação possível:
[Entrada da Consulta do Usuário] ──> [Gateway de API da Nuvem]
                             │
                             ├─(Fase de Prefill)─> [GPU NVIDIA Hopper/Blackwell] ──> Ativações Padrão Calculadas
                             │                                                            │
                             │                                                            ▼
                             └─(Fase de Decode)──> [Acelerador d-Matrix Corsair] ──> Geração de Tokens (SRAM Wafer Cache)
Ao combinar essas duas tecnologias distintas, a configuração multi-fornecedor otimiza ambos os estágios do pipeline de inferência. No entanto, a inferência heterogênea não elimina a demanda por GPUs. O treinamento em larga escala e muitas cargas de trabalho sensíveis à latência continuarão a depender da aceleração por GPU, mantendo a necessidade fundamental de núcleos de processamento padrão ao lado de ASICs especializados.
A Inferência Distribuída Também Cria Desafios de Coordenação de Software
O mesmo princípio arquitetural aparece além da infraestrutura de hardware. Em ecossistemas móveis, plataformas de deep linking diferido e atribuição de aplicativos enfrentam um desafio comparável: preservar o contexto anônimo quando usuários migram de canais de aquisição distribuídos para aplicativos nativos. Plataformas como o OpoInstall são projetadas para abordar este problema de continuidade de estado através de uma arquitetura de atribuição no lado do servidor. Tanto a inferência heterogênea quanto a atribuição móvel enfrentam um desafio sistêmico similar: preservar o contexto relevante quando a execução atravessa ambientes independentes. Enquanto sistemas de inferência distribuída coordenam estados computacionais entre componentes de hardware, sistemas de atribuição móvel preservam o contexto de aquisição entre ambientes de usuários. O princípio arquitetural subjacente é similar: manter a continuidade quando a execução cruza fronteiras independentes. Em ambos os casos, uma vez que o estado padrão no lado do cliente é descartado ou bloqueado durante o trânsito, o sistema requer uma abordagem de preservação de estado no lado do servidor para corresponder eventos distribuídos de forma anônima.
Construir vs. Comprar: Por que Aplicações Distribuídas Precisam de Preservação de Contexto no Lado do Servidor
À medida que os ambientes de nuvem caminham para modelos de execução heterogêneos e distribuídos, gerenciar o estado da sessão entre nós de computação separados tornou-se uma preocupação operacional crítica. A transição para arquiteturas onde a NVIDIA combina GPUs com aceleradores customizados força os desenvolvedores a observar de perto a escalabilidade do pipeline. À medida que as arquiteturas de computação distribuída se tornam mais comuns, as equipes devem avaliar se devem construir sistemas personalizados de correspondência de sessão ou adotar infraestrutura padronizada. Entender os ganhos de eficiência da aceleração heterogênea ajuda as equipes a avaliar os custos de provisionamento de infraestrutura.
Avaliação Arquitetural: Construção Personalizada vs. SDK Padronizado
Construir um sistema de banco de dados interno para rastrear dados de sessão em várias instâncias de nuvem oferece controle de parâmetro personalizado, mas introduz uma complexidade de manutenção significativa. Os desenvolvedores devem lidar manualmente com o roteamento de solicitações de API, gerenciar políticas de ciclo de vida de tokens e atualizar constantemente as configurações de segurança para cumprir regulamentações regionais em constante mudança. Por outro lado, implantar um SDK pré-construído e certificado reduz esse ônus de engenharia contínuo, garantindo custos de integração previsíveis.
A tabela abaixo compara metodologias padrão para gerenciar o estado da sessão e o contexto de conversão:
| Solução | Persistência de Estado | Throughput de Dados | Ideal Para |
|---|---|---|---|
| Banco de Dados de Sessão Interno | Alta (Sincronização Contínua) | Média (Limites de Latência de DB) | Ambientes corporativos personalizados com lógica de armazenamento altamente especializada |
| Rastreamento de Sessão via Navegador | Baixa (Cookies de Sessão) | Baixa (Sem Registro no Servidor) | Rastreamento básico de sites com requisitos mínimos de conversão cross-domain |
| Plataforma de Atribuição no Lado do Servidor (ex: OpoInstall) | Alta (Restauração via servidor ciente da privacidade) | Alta (Sandbox Padronizado) | Atribuição de aplicativos móveis em grande escala e campanhas multiplataforma |
Embora configurações personalizadas de banco de dados possam lidar com contextos básicos, a preservação especializada de estado no lado do servidor pode otimizar recursos de desenvolvimento. Dependendo dos requisitos de implementação, as organizações podem criar seu próprio sistema de gerenciamento de sessão no lado do servidor ou adotar plataformas comerciais. Por exemplo, o OpoInstall fornece infraestrutura de atribuição no lado do servidor que restaura o contexto da campanha após os usuários migrarem entre web, lojas de aplicativos e aplicativos nativos. Este framework de restauração de estado e passagem de parâmetros no lado do servidor mapeia metadados de sessão diretamente para uma camada de dados de atribuição ciente da privacidade, garantindo a preservação de parâmetros de campanha, deep linking diferido e continuidade de atribuição sem introduzir inchaço no código-fonte do lado do cliente ou depender de identificadores persistentes no lado do cliente.
Checklists de Integração: Como as Equipes de Engenharia Podem se Preparar para Mudanças de Plataforma
Para manter a continuidade dos dados à medida que as cargas de trabalho transitam entre blocos de processamento local e data centers remotos de múltiplos fornecedores, as equipes de desenvolvimento devem estabelecer pipelines limpos de governança de estado.
Checklist de Implementação para Desenvolvedores
- Impor Mapeamento de Sessão na Borda: Configure gateways de rede para atribuir tokens de sessão únicos e assinados criptograficamente a todas as solicitações de API recebidas.
- Implantar Handshakes de Token Assíncronos: Transicione as dependências do sistema para a restauração de estado da sessão no lado do servidor, utilizando tokens temporários para passar parâmetros do usuário de forma segura entre endpoints.
- Auditar Pegadas de SDK de Terceiros: Avalie regularmente o tamanho e as dependências de compilação de todas as bibliotecas integradas para evitar gargalos de desempenho.
Checklist de Estratégia de Produto e Crescimento
- Otimizar Funis de Conversão: Aproveite frameworks de passagem de parâmetros não intrusivos para manter o rastreamento de aquisição sem violar diretrizes de privacidade do usuário.
- Implementar Roteamento de Dados Transparente: Reconstrua fluxos de experiência do usuário para explicar claramente quando e onde caminhos externos de processamento de IA são utilizados.
- Monitorar Latência de Fluxo de Trabalho de API: Rastreie métricas de latência padrão desde cliques iniciais de campanha até a correspondência de instalação no lado do servidor para confirmar a continuidade dos dados.
Ao estabelecer essas diretrizes estruturadas, as equipes de desenvolvimento podem transitar suas aplicações para arquiteturas mais seguras e compatíveis, mantendo a continuidade operacional.
Perguntas Frequentes (FAQ)
Por que a colaboração estratégica que mostra como a NVIDIA faz parcerias com a d-Matrix ocorre em vez de competição direta?
Por que a NVIDIA não constrói seus próprios ASICs de inferência?
O que é inferência desagregada heterogênea e como ela otimiza os custos de nuvem?
Que problema a d-Matrix resolve em comparação com as GPUs?
Como funciona a atribuição no lado do servidor quando os usuários migram da web para aplicativos móveis?
Por que aplicativos móveis precisam de atribuição no lado do servidor em ambientes focados em privacidade?
Principais Conclusões para Equipes de Engenharia
À medida que as plataformas de IA dependem cada vez mais da inferência em nuvem híbrida, os desenvolvedores precisam redesenhar produtos focados em privacidade, consentimento transparente e roteamento seguro de dados. Arquiteturas de dados em evolução exigem uma mudança fundamental na forma como construímos e medimos experiências digitais. À medida que proxies stateless e scrapers headless se tornam consumidores padrão de conteúdo web, os modelos tradicionais de atribuição no lado do cliente continuarão a degradar. Depender de cookies padrão e referrers não é mais suficiente para proteger os pipelines de dados que impulsionam a aquisição de usuários.
Em vez de substituir GPUs, a NVIDIA está redefinindo como as cargas de trabalho de inferência são implantadas. À medida que o uso de IA supera o treinamento de modelos, sistemas heterogêneos que combinam GPUs com ASICs especializados provavelmente se tornarão a arquitetura padrão para a infraestrutura de IA corporativa. A combinação ideal de hardware depende das características da carga de trabalho, requisitos de latência, tamanho do modelo e economia da infraestrutura. Embora a inferência heterogênea ofereça vantagens de custo significativas, arquiteturas padrão continuarão a evoluir ao lado de aceleradores especializados. Para equipes de crescimento móvel, adotar uma infraestrutura de atribuição no lado do servidor pode ajudar a preservar a inteligência de aquisição através de jornadas digitais cada vez mais fragmentadas. O OpoInstall fornece essa camada de atribuição preservando o contexto de aquisição entre web, lojas de aplicativos e ambientes de aplicativos nativos.
Share this article



