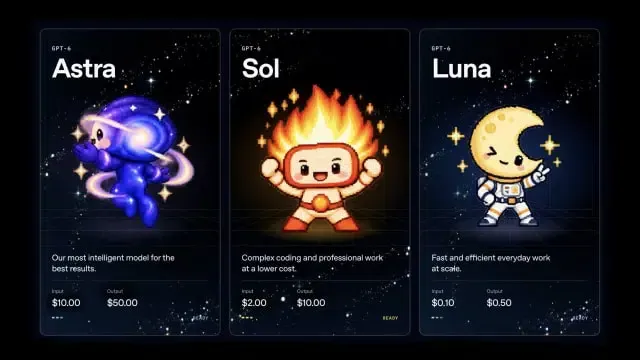
A OpenAI reduziu pela metade os custos da API Sol? A OpenAI anunciou oficialmente a disponibilidade comercial do GPT-6 Sol e do GPT-6 Luna em 22 de setembro de 2026, reduzindo as taxas de tokens da API em 50% ou mais em comparação com os preços promocionais anteriores do GPT-5.6 em endpoints padrão. Para o processamento padrão de prompts com até 272 mil tokens de entrada, o GPT-6 Sol custa US$ 2,00 por milhão de tokens de entrada e US$ 10,00 por milhão de tokens de saída, enquanto o modelo menor GPT-6 Luna fica em US$ 0,10 de entrada e US$ 0,50 de saída por milhão de tokens. Quando a OpenAI reduz pela metade os custos da API Sol em camadas de desenvolvedores padrão, a deflação estrutural de computação altera as restrições operacionais de software gerativo. Preços unitários mais baixos tornam loops de agentes recursivos, extração de lotes em segundo plano e trabalhadores autônomos de várias etapas viáveis economicamente em escala. Para arquitetos de sistemas, engenheiros de confiabilidade e desenvolvedores de backend, no entanto, a redução do atrito financeiro expõe desafios de escalabilidade a jusante, movendo o foco da engenharia de orçamentos de tokens para limites de taxa, limites de concorrência, dutos de telemetria e gargalos de contrapressão.
O Problema Operacional e os Gargalos Financeiros
Durante as fases iniciais da adoção corporativa de LLMs em produção, as taxas nominais de tokens serviram como um regulador arquitetônico informal. Altos custos de inferência forçaram as equipes de desenvolvimento a tratar as invocações de modelo como transações discretas iniciadas pelo usuário. As aplicações dependiam fortemente de aprovações com humano no circuito (human-in-the-loop), histórico de conversas limitado e trabalhadores agendados rigidamente estrangulados para garantir que as faturas mensais do provedor permanecessem previsíveis. A introdução de reduções permanentes de modelos de nível intermediário desafia essas compensações históricas, movendo as preocupações de engenharia de sistemas do preço do modelo para a resiliência da infraestrutura de backend.
Visão Geral
- Redução de Preço Básica: Em 22 de setembro de 2026, a OpenAI introduziu o GPT-6 Sol a US$ 2,00 de entrada / US$ 10,00 de saída e o GPT-6 Luna a US$ 0,10 de entrada / US$ 0,50 de saída por milhão de tokens para processamento padrão em prompts de até 272 mil tokens, representando uma redução nominal de 50% ou mais em comparação com os preços promocionais de API do GPT-5.6.
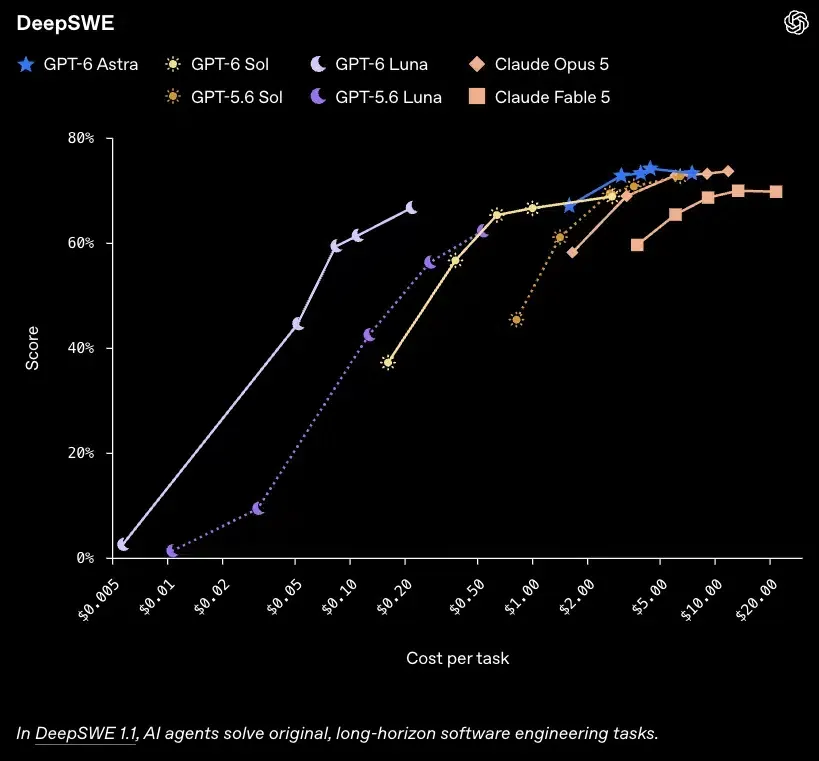
- Economia de Benchmark em Nível de Tarefa: No AutomationBench 1.0.6, a OpenAI relata que o GPT-6 Sol configurado com esforço de raciocínio xhigh alcançou uma pontuação de fluxo de trabalho de 33,2% a um custo médio relatado de US$ 0,27 por tentativa de tarefa, mudando a avaliação do desenvolvedor do preço bruto de tokens para o custo por unidade de trabalho tentada.
- Dinâmica de Cache de Prompts: A plataforma oferece um desconto automatizado de 90% em leituras de tokens de entrada em cache (faturadas a 0,1× a taxa de tokens de entrada base), enquanto as gravações iniciais em cache são faturadas a 1,25× a taxa de tokens de entrada não em cache, exigindo uma normalização cuidadosa do prefixo para manter altas taxas de acerto de cache em execuções dinâmicas de várias etapas.
Conforme detalhado na Referência de Preços da API de Desenvolvedor da OpenAI oficial e no Anúncio da Comunidade OpenAI, essas estruturas de preços decorrem de melhorias contínuas em dutos de inferência de baixo nível e sistemas de cache KV. No entanto, quando o custo de execução de sequências de tarefas automatizadas cai significativamente, as equipes de engenharia expandem o escopo de suas tarefas em segundo plano. O piso econômico que anteriormente desencorajava os trabalhadores em segundo plano de executar polling contínuo, passagens automatizadas de revisão de código ou dutos de extração de documentos em vários estágios foi reduzido.
Em todo o mercado, vários provedores de modelos fundamentais reduziram ou reestruturaram os preços de APIs em suas camadas de desenvolvedores. A Anthropic lançou o Claude Opus 5.5 juntamente com especificações atualizadas na Especificação da Plataforma Anthropic Claude Opus 5.5, cotando US$ 4 por milhão de tokens de entrada, US$ 0,20 por milhão de leituras de entrada em cache e US$ 20 por milhão de tokens de saída, destacando o menor consumo de tokens em benchmarks de refatoração de código. Simultaneamente, o Google mantém seus preços introdutórios promocionais para o Gemini 3.8 Flash documentados no Google AI para Desenvolvedores, e lançamentos de peso aberto, como o MiMo-V2.6-Pro da Xiaomi, fornecem a equipes de automontagem opções agressivas de custo de token sob licenças de software permissivas.
Quando os custos dos modelos caem, os comportamentos de desenvolvimento mudam. As equipes de engenharia implantam loops recursivos mais profundos, injetam documentação corporativa abrangente nos prompts do sistema e configuram lógica de nova tentativa automatizada em gráficos de tarefas complexos. O que começa como alívio de custos na camada da API pode transferir picos de latência e tráfego para serviços internos. Se um trabalhador de orquestração emitir dezenas de chamadas de modelo sequenciais ou paralelas para uma única transação do usuário, os pools de banco de dados internos, os clusters de armazenamento auxiliar, os dutos de telemetria e os limitadores de taxa deverão absorver a carga resultante.
Causas Raiz Sistêmicas e Cadeias de Solicitação Não Visuais
Quando as aplicações clientes fazem a transição de interfaces de chat interativas para automação em segundo plano não visual, os perfis de solicitação a montante mudam drasticamente. Um único evento de negócio pode acionar um pipeline autônomo que inspeciona esquemas, avalia variáveis de ambiente, chama ferramentas externas e verifica saídas em várias passagens contínuas.
+-----------------------------------------------------------------------------------------+
|                  RECURSIVE AGENT EXECUTION & BACKPRESSURE BOTTLENECK                    |
+-----------------------------------------------------------------------------------------+
|                                                                                         |
|  [ User Web / App Trigger ]                                                             |
|         |                                                                               |
|         v                                                                               |
|  [ Ingestion API Gateway ]                                                              |
|         |                                                                               |
|         +---> Spawns Autonomous Worker Instance                                         |
|         |                                                                               |
|         v                                                                               |
|  [ Autonomous Orchestration Loop (GPT-6 Sol / Luna) ]                                   |
|         |                                                                               |
|         +--- Step 1: Query Context (Cache Read) -----------------+                      |
|         |                                                        |                      |
|         +--- Step 2: Tool Execution (Uncached Call)              |                      |
|         |                                                        |                      |
|         +--- Step 3: Self-Correction Validation                  |                      |
|         |                                                        v                      |
|         +--- Step 4: Recursive Execution Fork ----> [ Bursting Internal RPCs ]          |
|                                                                  |                      |
|  [ Downstream System Bottlenecks ]                               |                      |
|         |                                                        |                      |
|         +--- Internal Microservices <-- (Connection Starvation) -+                      |
|         +--- PostgreSQL / Cache Stores <-- (Connection Pool Saturation)                 |
|         +--- Distributed Telemetry Stream <-- (Lossy Drop Buffer Applied)               |
|         +--- Audit Compliance Store <-- (Durable / Replayable Queue Lag)                |
|         +--- Upstream Provider Thresholds <-- (HTTP 429 Rate Limit Exhaustion)          |
|                                                                                         |
+-----------------------------------------------------------------------------------------+
Execução de Agentes Recursivos e Multiplicação de Conconcorrência
Em sistemas web interativos tradicionais, o volume de solicitações espelha os ritmos de interação humana. Cada thread HTTP normalmente mapeia para uma interação explícita do usuário, com menor dispersão geral (fan-out) e ritmo limitado pelo tempo de reflexão humana. O tempo de execução do cliente envia um payload, aguarda uma resposta e faz uma pausa antes de iniciar interações subsequentes.
Comparação do Perfil de Solicitação Conceitual: Interativo vs. Baseado em Agente
| Métrica Arquitetônica | Fluxo de Usuário Interativo | Loop de Agente Autônomo |
|---|---|---|
| Modelo de Concorrência | A dispersão de solicitações no ritmo humano costuma ser menor | 1 Evento de Ingestão = N Chamadas Filhas Encadeadas |
| Cronograma de Execução | Ritmo ditado pela resposta do usuário e pelo tempo de reflexão | Prossegue automaticamente até que os limites de política intervenham |
| Invalidação de Contexto | Payloads novos por sessão | Depende fortemente de contexto em cache |
| Tratamento de Erros | Nova tentativa do usuário em caso de erro | Tentativas programáticas automatizadas |
| Gargalos do Sistema | Largura de banda do gateway de frontend | Limites do pool de banco de dados interno |
| Cascatas de Falhas | Isoladas a uma única sessão | Pode desencadear saturação de fila |
Quando os sistemas integram agentes autônomos, esse ritmo se desacopla. Um único evento acionado pode gerar uma sequência ininterrupta de chamadas automatizadas. Se um agente encontrar um erro transitório ou uma saída de ferramenta malformada, a lógica de nova tentativa simplista (naive) pode gerar rajadas rápidas de solicitações contra serviços de backend. Como os custos reduzidos de tokens tornam as execuções mais longas financeiramente viáveis, os fluxos de trabalho automatizados podem escalar significativamente o volume de solicitações em segundo plano, mesmo com uma base de usuários ativos estável.
Mecânica de Cache de Prompts: Reutilização de KV, Sobrecargas de Gravação e Estabilidade de Prefixos
A OpenAI associou os lançamentos Sol e Luna a otimizações em seu subsistema de cache de prompts. Conforme documentado na Especificação de Cache de Prompts da OpenAI, os tokens de entrada correspondentes a um prefixo em cache recebem um desconto de 90% no preço de leitura. O cache de prompts reduz primariamente a recomputação do lado do modelo, em vez de funcionar como um mecanismo de compactação de payload de rede de uso geral. Em interações sem estado padrão, a aplicação cliente transmite o contexto da solicitação e o provedor pula a recomputação dos tensores KV para o prefixo correspondente, reduzindo significativamente a latência até o primeiro token e a cobrança de entrada.
Crucialmente, a gravação de um prefixo inicial no cache do lado do servidor é cobrada a 1,25× a taxa de tokens de entrada não em cache. Maximizar a eficiência de custos exige manter a estabilidade do prefixo em várias consultas.
Preços de Lista de API Públicas Selecionados — Não Diretamente Comparáveis Entre Provedores
| Identificador do Modelo | Entrada (US$/1M Tok) | Saída (US$/1M Tok) | Política de Leitura em Cache |
|---|---|---|---|
| OpenAI GPT-6 Luna (Std) | US$ 0,10 | US$ 0,50 | Desconto de 90% (0,10×) |
| OpenAI GPT-6 Sol (Std) | US$ 2,00 | US$ 10,00 | Desconto de 90% (0,10×) |
| OpenAI GPT-6 Astra (Std) | US$ 10,00 | US$ 50,00 | Preços em Camadas Dinâmicos |
| Anthropic Opus 5.5 | US$ 4,00 | US$ 20,00 | US$ 0,20/1M Leitura (0,05×) |
| Anthropic Sonnet 5 | US$ 2,00 | US$ 10,00 | Até 90% no cache |
| Google Gemini 3.8 Flash | US$ 0,75 (Intro) | US$ 3,75 (Intro) | US$ 0,075/1M Leitura em Cache |
| Xiaomi MiMo-V2.6-Pro | US$ 0,435 | US$ 0,87 | US$ 0,0036/1M Leitura em Cache |
Nota: As taxas padrão aplicam-se a camadas de contexto curto (prompts de até 272 mil tokens de entrada para a OpenAI). Os provedores impõem sobrecargas de gravação em cache, limites de contexto e termos promocionais com prazo determinado variados.
A preservação de prefixos requer um manuseio cuidadoso das opções de configuração da API. Na arquitetura de API da OpenAI, alterar diretamente os parâmetros de esforço de raciocínio ou modificar matrizes de definição de ferramentas alterará o prefixo do prompt renderizado e invalidará os estados em cache anteriores.
Para preservar o contexto em cache durante sessões de turnos múltiplos, os desenvolvedores devem manter os esquemas de ferramentas e as instruções básicas em uma ordem consistente. Se forem necessários ajustes em tempo de execução, os desenvolvedores devem atualizar os parâmetros por meio de controles de sessão estruturados (como configuration_update) ou alternar a execução de ferramentas usando tool_choice ou allowed_tools em vez de modificar diretamente a matriz de definições de ferramentas.
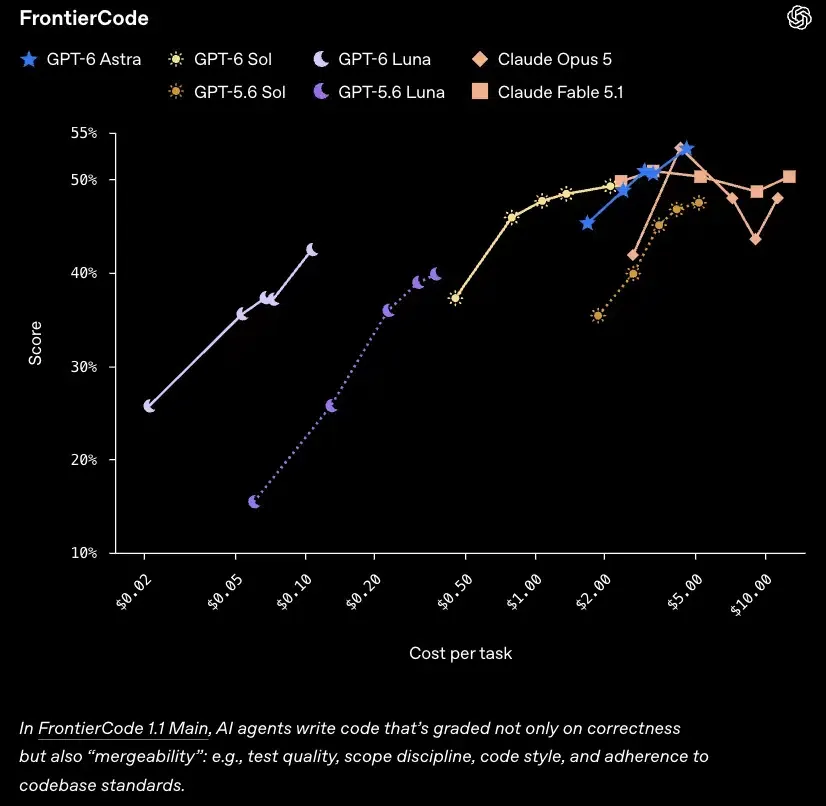
Quando ocorrem falhas de cache (cache misses), o provedor a montante reprocessa a sequência de entrada sem o desconto de leitura de 90%. Em escala, isso pode aumentar a latência de inferência e a pressão de tempo limite (timeout). Para a execução de tarefas em várias etapas, a avaliação de custos passa de simples multiplicadores de tokens para despesas de tarefas concluídas, conforme visto na Cobertura da VentureBeat sobre os Benchmarks do GPT-6 Sol e Luna, onde o GPT-6 Sol alcançou uma pontuação de 33,2% no AutomationBench 1.0.6 a uma média de US$ 0,27 por tentativa de tarefa.
Arquitetura de Telemetria: Desacoplando Métricas Operacionais de Auditorias de Conformidade
Um aumento nas solicitações de LLM automatizadas impõe uma pressão significativa sobre a observabilidade do backend e os dutos de conformidade. Os fluxos de trabalho de agentes de alta concorrência exigem uma separação arquitetônica clara entre a telemetria operacional e as trilhas de auditoria legal.
As políticas de conformidade corporativa geralmente exigem a gravação de metadados de sessão, provas de execução de ferramentas e registros de transações. Tratar a telemetria operacional e os dados de conformidade de forma idêntica cria sérias compensações de engenharia:
- Canais de Auditoria de Segurança e Conformidade: Devem fornecer entrega durável e reproduzível com nova tentativa explícita, persistência e tratamento de falhas em armazenamentos de auditoria de gravação única e acesso controlado. Os payloads devem capturar metadados estruturados, identidade do chamador e estado criptográfico, enquanto sanitizam sistematicamente informações de identificação pessoal (PII) e chaves secretas. Sob carga alta, esses dutos devem aplicar contrapressão ou enfileirar tarefas de forma durável em vez de descartar registros.
- Canais de Telemetria Operacional: Rastreiam métricas de desempenho, como contagens de tokens, taxas de acerto de cache de prompts e latências de resposta a montante. Como esses rastreamentos são usados para monitoramento e depuração em tempo real, eles podem ser processados por meio de buffers de descarte limitados e com perdas (lossy drop buffers). Se os coletores a jusante desacelerarem, a aplicação poderá descartar com segurança o excesso de telemetria operacional para preservar a disponibilidade principal do serviço.
Quando os provedores externos retornam erros de limite de taxa HTTP 429, políticas de nova tentativa mal configuradas podem causar problemas operacionais graves. Tentativas imediatas ou rotinas de espera exponencial sincronizada (backoff) sem instresamento aleatório (jitter) criam ondas de novas tentativas que podem se propagar em cascata por microsserviços intermediários, consumindo pools de threads e conexões de banco de dados.
Comparação de Soluções: Comprometer-se com o Desenvolvimento Próprio (Build) ou com a Compra (Buy)
Gerenciar a carga operacional resultante de custos de inferência mais baixos exige que as organizações avaliem suas arquiteturas de gateway de IA e proxy. As equipes devem decidir se desenvolvem proxies personalizados de roteamento, limitação de taxa e telemetria internamente ou se implantam infraestrutura especializada de terceiros.
+-----------------------------------------------------------------------------------------+
|                 SYSTEM RESILIENCY PIPELINE WITH DECOUPLED TELEMETRY                     |
+-----------------------------------------------------------------------------------------+
|                                                                                         |
|  [ Inbound Application Requests ]                                                       |
|         |                                                                               |
|         v                                                                               |
|  [ Sliding-Window Rate Limiter ] <--- Local In-Memory or Distributed Cache              |
|         |                                                                               |
|         +---> Rejects / Delays Excess Concurrency (HTTP 429 Protection)                 |
|         |                                                                               |
|         v                                                                               |
|  [ Prompt Normalization & Cache Alignment Engine ]                                      |
|         |                                                                               |
|         +---> Pins Static System Prompts & Tool Definitions to Base Prefix              |
|         +---> Uses Structured Controls to Modify Session Parameters                     |
|         |                                                                               |
|         v                                                                               |
|  [ Upstream Provider Dispatch (OpenAI / Anthropic / Local API) ]                         |
|         |                                                                               |
|         +---------------------------------------+---------------------------------------+
|         |                                       |                                       |
|         v (Synchronous Fast Path)               |                                       |
|  [ Client Response Assembly ]                   |                                       |
|         |                                       v (Asynchronous Dual Path)              |
|         v                               +-----------------------------------------------+
|  [ Return Payload to App ]              |                                               |
|                                         v (Lossy Ring Buffer)   v (Durable Outbox)      |
|                                    [ Operational Metrics ]  [ Compliance Audit Store ]  |
|                                    (Drops on Congestion)    (Durable / Replayable)      |
|                                                                                         |
+-----------------------------------------------------------------------------------------+
Pipelines de Resiliência Internos Customizados
Desenvolver infraestrutura personalizada dá às equipes de engenharia controle total sobre políticas de rede, sanitização de dados e estratégias de roteamento. As organizações podem criar proxies de borda adaptados às suas exatas topologias de microsserviços internos.
// Reference implementation: Synchronized Token Bucket with fractional remainder and bounded saturation
package com.example.ai.resilience;

import java.math.BigInteger;
import java.time.Duration;

public final class TokenBucketLimiter {
    private final long maxTokenCapacity;
    private final long refillPeriodNanos;
    private long availableTokens;
    private long lastRefillNanos;
    // Scaled remainder numerator in the range [0, refillPeriodNanos)
    private long scaledRemainder;

    public TokenBucketLimiter(long maxTokens, Duration refillPeriod) {
        if (maxTokens <= 0 || refillPeriod.isZero() || refillPeriod.isNegative()) {
            throw new IllegalArgumentException("Invalid boundary configuration for TokenBucketLimiter.");
        }
        this.maxTokenCapacity = maxTokens;
        this.refillPeriodNanos = refillPeriod.toNanos();
        this.availableTokens = maxTokens;
        this.lastRefillNanos = System.nanoTime();
        this.scaledRemainder = 0L;
    }

    public synchronized boolean tryAcquire(long requestedUnits) {
        if (requestedUnits <= 0) {
            return false;
        }
        refillTokens();
        if (requestedUnits > availableTokens) {
            return false;
        }
        availableTokens -= requestedUnits;
        return true;
    }

    private void refillTokens() {
        long nowNanos = System.nanoTime();
        long elapsedNanos = nowNanos - lastRefillNanos;

        if (elapsedNanos <= 0) {
            return;
        }

        // Advance baseline timestamp monotonically
        this.lastRefillNanos = nowNanos;

        // If bucket is already full, discard unconsumed fractional credits to prevent timing drift
        if (this.availableTokens >= this.maxTokenCapacity) {
            this.scaledRemainder = 0L;
            return;
        }

        long wholePeriods = elapsedNanos / refillPeriodNanos;
        long remElapsedNanos = elapsedNanos % refillPeriodNanos;

        // Fast-path: if at least one complete period has elapsed, the bucket fully replenishes to capacity.
        // This eliminates the multiplication overflow surface (wholePeriods * maxTokenCapacity).
        if (wholePeriods > 0) {
            this.availableTokens = maxTokenCapacity;
            this.scaledRemainder = 0L;
            return;
        }

        // Under sub-period micro-intervals, calculate exact fractional tokens using BigInteger arithmetic
        BigInteger bigRemNanos = BigInteger.valueOf(remElapsedNanos);
        BigInteger bigCapacity = BigInteger.valueOf(maxTokenCapacity);
        BigInteger bigRemainder = BigInteger.valueOf(scaledRemainder);
        BigInteger bigPeriod = BigInteger.valueOf(refillPeriodNanos);

        // totalWork = (remElapsedNanos * maxTokenCapacity) + scaledRemainder
        BigInteger totalWork = bigRemNanos.multiply(bigCapacity).add(bigRemainder);
        BigInteger[] divAndRem = totalWork.divideAndRemainder(bigPeriod);

        long tokensGenerated = divAndRem[0].longValue();
        this.scaledRemainder = divAndRem[1].longValue();

        if (tokensGenerated > 0) {
            long spaceLeft = maxTokenCapacity - availableTokens;
            if (tokensGenerated >= spaceLeft) {
                this.availableTokens = maxTokenCapacity;
                this.scaledRemainder = 0L;
            } else {
                this.availableTokens += tokensGenerated;
            }
        }
    }
}
No entanto, o desenvolvimento interno exige manutenção contínua de engenharia. As equipes devem se adaptar manualmente às atualizações da API do provedor, lidar com limites de taxa em evolução em vários fornecedores e gerenciar filas de telemetria distribuídas. Essa sobrecarga de manutenção pode desviar recursos internos de desenvolvedores dos principais recursos do produto.
Gateways Comerciais e Ferramentas de Infraestrutura
Para evitar a construção dessas capacidades do zero, muitas empresas implantam proxies de API gerenciados, gateways de LLM e planos de controle de borda. Alguns gateways gerenciados fornecem coordenação de limite de taxa ciente do provedor, observabilidade, controles de política e roteamento ciente de cache; as capacidades exatas variam de acordo com o fornecedor, e a otimização de prefixo muitas vezes ainda requer disciplina de solicitação em nível de aplicação.
As plataformas comerciais permitem que as equipes de engenharia imponham cotas de custo por ambiente, configurem o roteamento de fallback automatizado entre famílias de modelos e removam informações confidenciais de clientes antes de registrar metadados de solicitação. Gateways projetados especificamente gerenciam picos de concorrência, auditam tendências de consumo de API e protegem microsserviços a jusante em ambientes de aplicação complexos.
Matriz de Decisão: Pipeline Interno vs. Plataformas Gerenciadas
| Critérios de Avaliação | Ferramentas de Resiliência Internas | Infraestrutura de Roteamento Gerenciada |
|---|---|---|
| Esforço Inicial de Dev | Alto (3-6 semanas de engenharia) | Baixo (Integra-se via API padrão) |
| Manutenção de Protocolo | Responsabilidade contínua da equipe | Tratado pelas atualizações do fornecedor |
| Controle Operacional | Visibilidade total da pilha | Limitado pela interface do fornecedor |
| Ajuste de Cache de Prompts | Requer proxies personalizados | Depende do fornecedor; geralmente requer cooperação da aplicação |
| Isolamento de Telemetria | Gerenciamento de fila personalizado | Depende do fornecedor |
| Perfil de Custo Financeiro | Sobrecarga com folha de pagamento de engenharia | Taxas recorrentes de SaaS / uso |
Checklists de Integração e Cronogramas de Governança
As organizações que escalam o uso de seus modelos após as reduções de preço do GPT-6 Sol e Luna podem usar esta estrutura operacional para evitar sobrecargas sistêmicas:
+-----------------------------------------------------------------------------------------+
|                  ENTERPRISE LLM INFRASTRUCTURE READINESS CHECKLIST                      |
+-----------------------------------------------------------------------------------------+
| [ ] Audit client applications to identify unbounded recursive model calling loops       |
| [ ] Set hard timeout limits and non-linear retry backoffs with randomized jitter        |
| [ ] Implement local and edge token-bucket rate limiters ahead of upstream calls          |
| [ ] Organize prompt structures to maximize prompt caching prefix reuse                   |
| [ ] Separate lossy operational telemetry from durable, replayable audit trails           |
| [ ] Add runtime sampling to strip raw prompt bodies from high-frequency traces          |
| [ ] Monitor HTTP 429 status trends and set automated backpressure triggers              |
| [ ] Configure cost alerts and circuit breakers to catch runaway automated jobs          |
+-----------------------------------------------------------------------------------------+
Configuração do Duto de Telemetria
Os sistemas de observabilidade devem desacoplar o registro de prompts dos caminhos de solicitação em tempo real. Ao processar cargas de trabalho de agentes de alta frequência, as aplicações devem gravar metadados de telemetria em filas assíncronas limitadas por memória, evitando travamentos de E/S caso os coletores de telemetria a jusante fiquem lentos.
// Reference implementation: Memory-bounded telemetry logger with lossy load shedding
package com.example.ai.resilience;

import java.util.concurrent.ArrayBlockingQueue;
import java.util.concurrent.BlockingQueue;
import java.util.concurrent.atomic.AtomicLong;

public final class BoundedTelemetryQueue {
    public static final class LogPayload {
        public final String traceId;
        public final String modelId;
        public final long promptTokens;
        public final long completionTokens;
        public final boolean cacheHit;

        public LogPayload(String traceId, String modelId, long pTokens, long cTokens, boolean hit) {
            this.traceId = traceId;
            this.modelId = modelId;
            this.promptTokens = pTokens;
            this.completionTokens = cTokens;
            this.cacheHit = hit;
        }
    }

    private final BlockingQueue<LogPayload> internalQueue;
    private final AtomicLong droppedEvents = new AtomicLong(0);

    public BoundedTelemetryQueue(int maxQueueCapacity) {
        if (maxQueueCapacity <= 0) {
            throw new IllegalArgumentException("Queue capacity must be positive.");
        }
        this.internalQueue = new ArrayBlockingQueue<>(maxQueueCapacity);
    }

    public boolean recordEvent(LogPayload payload) {
        if (payload == null) {
            return false;
        }
        // Non-blocking submission: drops telemetry under load to preserve app stability
        boolean accepted = internalQueue.offer(payload);
        if (!accepted) {
            droppedEvents.incrementAndGet();
        }
        return accepted;
    }

    public LogPayload pollEvent() {
        return internalQueue.poll();
    }

    public long getDroppedEventCount() {
        return droppedEvents.get();
    }
}
Perguntas Frequentes (FAQ)
Quais são as taxas oficiais da API para o GPT-6 Sol e Luna?
Como o cache de prompts reduz os custos em conversas longas?
Por que tokens mais baratos aumentam o risco operacional do backend?
Principais Conclusões para Equipes de Engenharia
O lançamento do GPT-6 Sol e Luna acelera uma tendência mais ampla: a inteligência de fronteira está se tornando mais barata e acessível. À medida que os custos unitários de tokens caem drasticamente, as restrições financeiras deixam de ser um mecanismo de controle eficaz para arquiteturas de software.
À medida que as organizações adotam agentes de alta frequência e topologias de modelos de várias camadas, a engenharia operacional torna-se crítica para o sucesso corporativo. As equipes devem ir além da avaliação de modelos exclusivamente pelos preços nominais de tokens ou pontuações de benchmark. A confiabilidade a longo prazo dependerá de quão eficazmente os sistemas gerenciam a concorrência, alinham contextos de prompt para reutilização de cache, lidam com limites de taxa a montante com elegância e desacoplam a telemetria dos caminhos críticos de aplicação. As organizações que constroem infraestrutura resiliente dimensionarão com sucesso seus fluxos de trabalho de agentes automatizados sem sacrificar o tempo deatividade da aplicação ou a estabilidade do sistema.
Fontes Primárias e Documentação de Referência
-
Referência de Preços da API de Desenvolvedor da OpenAI: Tabelas de taxas oficiais para desenvolvedores, restrições de janela de contexto (limite padrão de ≤272 mil) e cronogramas de preços de leitura/gravação em cache para GPT-6 Sol, Luna e Astra.
-
Anúncio da Comunidade OpenAI: Divulgação pública confirmando a redução de preço base de 50% em relação às camadas promocionais do GPT-5.6 e detalhes de lançamento de marcos.
-
Especificação de Cache de Prompts da OpenAI: Documentação arquitetônica sobre reutilização de prefixo Chave-Valor do lado do servidor, sobrecargas de gravação em cache e regras de invalidação de configuração.
-
Especificação da Plataforma Anthropic Claude Opus 5.5: Especificação oficial de lançamento confirmando taxas de tokens de US$ 4 de entrada / US$ 20 de saída / US$ 0,20 de leitura de cache e desempenho de benchmark.
-
Visão Geral do Anthropic Claude Sonnet 5: Tabela oficial de taxas para desenvolvedores e métricas de eficiência de cache de prompts (US$ 2 de entrada / US$ 10 de saída / até 90% de desconto de cache).
-
Tabela de Taxas do Google AI para Desenvolvedores: Visão geral das tabelas de taxas de desenvolvedores e políticas de preços introdutórios para o Gemini 3.8 Flash.
-
Preços Oficiais da API Xiaomi MiMo e Cronograma de Taxas: Taxas canônicas de tokens pré-pagas (pay-as-you-go) no exterior para inferência do MiMo-V2.6-Pro (US$ 0,435 de entrada / US$ 0,87 de saída / US$ 0,0036 de acerto de cache).
-
Cobertura da VentureBeat sobre os Benchmarks do GPT-6 Sol e Luna: Cobertura da economia de lançamento, garantias permanentes de preços e números de custo de tarefa do AutomationBench 1.0.6 (US$ 0,27 por tentativa de tarefa).
Share this article