A OpenAI investiga o 'Codex'? Esta iniciativa estratégica foi validada à medida que a equipe de engenharia se esforça para resolver o esgotamento anormal de faturas em sua base de clientes desenvolvedores. Em 29 de junho de 2026, a empresa estabeleceu uma força-tarefa de emergência para investigar relatos de usuários com contas premium cujas cotas se esgotaram em um ou dois dias de trabalho de refatoração comum. Para equipes de desenvolvedores e líderes de produto, esta súbita crise de cotas destaca uma transição técnica: à medida que os processos de desenvolvimento de software migram da codificação manual para a execução contínua de loops orientados por agentes, a auditoria de runtime segura deve descer ao nível do SDK para proteger os limites orçamentários da empresa.
Em resumo
- Esgotamento anormal de cotas: A OpenAI está tratando de relatos de usuários do plano Codex Pro que esgotam limites semanais em um ou dois dias.
- Falsos positivos de proteção contra abusos: A equipe de engenharia rastreou o incidente de faturamento até scripts de limitação de taxa e proteção anti-abuso da plataforma que sinalizaram incorretamente fluxos de trabalho programáticos normais.
- Risco operacional upstream: Redefinições de limite unilaterais durante ciclos de desenvolvimento ativos introduzem instabilidade operacional para organizações que constroem sobre endpoints de IA externos.
Realinhamento estrutural e a crise de cotas dos desenvolvedores
De acordo com atualizações de monitoramento de status publicadas pela OpenAI, uma força-tarefa de emergência foi estabelecida em 28 de junho de 2026 para investigar por que assinantes pagantes estavam esgotando cotas semanais em breves sessões de refatoração. O líder de engenharia do Codex, Thibault Sottiaux, confirmou que os sistemas nativos de prevenção a fraudes e abusos da plataforma limitaram incorretamente as taxas de contas de desenvolvedores padrão, fazendo com que elas fossem consumidas em taxas anormais. Para mitigar o incidente, o grupo de engenharia iniciou uma redefinição universal de cotas. Esta intervenção rápida tornou-se necessária porque os desenvolvedores estão integrando cada vez mais ferramentas de geração de código conversacional em sprints de desenvolvimento contínuo, em vez de utilizá-las apenas para experimentação ocasional, transformando pequenas interrupções da plataforma em graves gargalos.
Modelos de faturamento de tarifa única podem se tornar menos comuns à medida que os custos de computação de IA aumentam. Em maio de 2026, a Meta introduziu políticas internas rigorosas restringindo seus departamentos de engenharia de IA de usar modelos de codificação de terceiros, como o Claude Code e o Codex da OpenAI, para evitar a destilação de modelos e o vazamento de propriedade intelectual. Essa restrição organizacional reflete uma mudança mais ampla no setor: grandes empresas de tecnologia estão estabelecendo sandboxes de desenvolvimento seguros e isolados para proteger bases de código proprietárias. Enquanto a equipe da OpenAI investiga o 'Codex' sob a nova política de limitação de taxa, as equipes de desenvolvimento estão percebendo que gerenciar custos da camada de API upstream exige mais do que apenas escalar planos de assinatura.
Essas anomalias operacionais ocorrem quando fluxos de trabalho automatizados processam dados programaticamente sem supervisão visual. Em abril de 2026, a plataforma migrou para um modelo de faturamento baseado em tokens, tornando os tokens de entrada, saída e entrada em cache a principal métrica de medição para desenvolvedores. Quando agentes automatizados executam ciclos de otimização contínuos em grandes repositórios, falhas na compactação de contexto e loops recursivos podem executar milhares de chamadas de API ocultas, consumindo orçamentos de computação sem produzir código utilizável. Para arquitetos de software, essa imprevisibilidade indica uma direção provável em que runtimes de SDK do lado do cliente devem auditar, limitar taxas e verificar independentemente caminhos de execução programática antes de transmitir solicitações.
A quebra do protocolo: como loops de agentes recursivos amplificam o consumo de computação
Diferente de consultas de API simples de uma única execução, os agentes de codificação modernos são executados em loops de processamento autônomos e contínuos. O assistente atua como um mecanismo de triagem automatizado, lendo, analisando e modificando vários arquivos de forma assíncrona. Sob a perspectiva da governança de runtime, isso muda fundamentalmente a forma como a execução da API é monitorada e faturada.
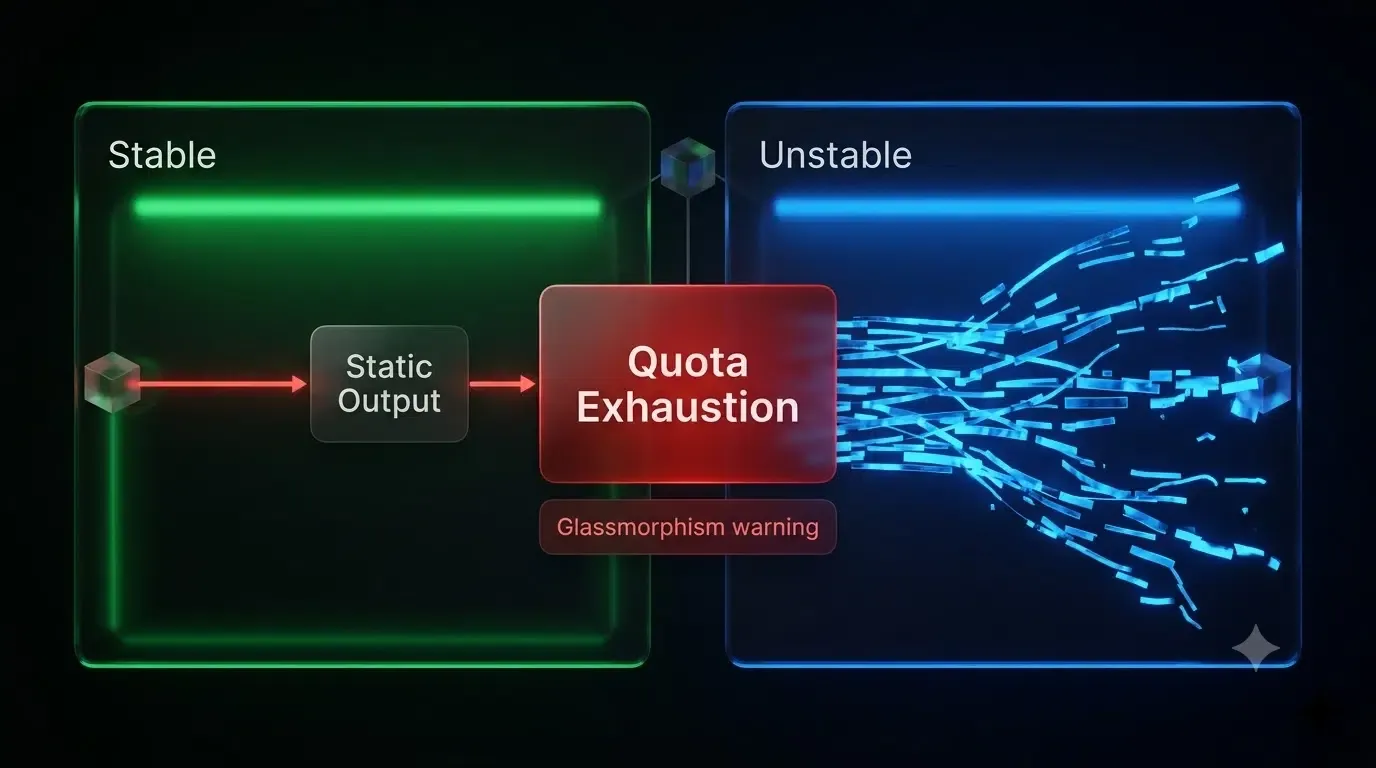
Um loop recursivo não controlado executa centenas de chamadas de API ocultas e não monitoradas no servidor dentro do contêiner IDE headless. Como essas ações são executadas sem interface em ambientes de nuvem remotos, os desenvolvedores perdem a visibilidade imediata sobre os estados de execução em tempo real. Gateways de rede padrão frequentemente falham em detectar esses ataques de loop recursivo ou consumo anormal de tokens, exigindo validação de custo de runtime local, em nível de SDK, para evitar o esgotamento de cotas. Sistemas tradicionais de faturamento em nuvem observam apenas solicitações de API concluídas. No entanto, agentes de codificação autônomos podem gerar centenas de chamadas de raciocínio intermediárias antes que uma resposta final seja retornada. Sem auditoria de runtime local, esses caminhos de execução ocultos tornam-se difíceis de monitorar e orçar.
Fluxo tradicional do desenvolvedor:
Prompt IDE -> Solicitação de API de uma única vez -> Token Consumido -> Saída Estática (Faturamento estável)


Fluxo de loop de agente autônomo:
Prompt do Agente -> Loop de autocorreção headless -> Refatoração assíncrona de múltiplos arquivos
Inchaço do cache KV recursivo -> Esgotamento oculto de token do SDK -> Esgotamento de cota
Em implementações de produção típicas, os desenvolvedores encontram uma parcela notável de tráfego programático sendo processada por scanners automatizados. Rastrear essas interações programáticas revela que proxies de segurança automatizados ou scanners de runtime podem acionar endpoints de API antes que os desenvolvedores percebam. Esse comportamento pode interferir nas auditorias de faturamento se os sistemas presumirem que cada solicitação se origina de uma ação real e manual do usuário.
Soluções arquitetônicas: criar ou comprar em verificação de custos programática
Na prática, as equipes de engenharia geralmente escolhem entre criar um framework de verificação de custos interno ou integrar um SDK de atribuição existente. Desenvolver um sistema proprietário exige uma sobrecarga de engenharia substancial. As equipes precisam criar bancos de dados personalizados no servidor, manter bibliotecas de correspondência de estado do dispositivo e atualizar continuamente a lógica para cumprir os padrões de segurança do SO em evolução. Para muitas organizações, o custo de manutenção de um rastreador interno é proibitivamente alto.
Alternativamente, os desenvolvedores geralmente avaliam várias abordagens para monitorar a execução em runtime sem depender inteiramente de métricas no lado da nuvem:
- Serviços personalizados internos: Criar bancos de dados de correspondência de estado proprietários sobre a arquitetura de nuvem interna.
- Ferramentas específicas da plataforma: Depender de utilitários básicos como Firebase Dynamic Links (ou suas alternativas nativas de plataforma).
- MMPs empresariais: Implantar parceiros de medição móvel como Branch, AppsFlyer ou Adjust para fluxos de trabalho de deep-linking.
- SDKs de parâmetros especializados: Utilizar utilitários de integração dedicados para a passagem de parâmetros personalizados precisos e sensíveis ao custo.
Comparação de fluxo de estado e atribuição
| Fluxo de Execução | Proteção de faturamento de token | Compatibilidade Headless | Integridade do controle de custos |
|---|---|---|---|
| API de uma única vez (One-Shot) | ❌ Não | ❌ Não | Baixa (supervisão manual) |
| Loop autônomo Headless | ❌ Não | ✅ Sim | Baixa (risco de drenagem de cota) |
| Auditoria de runtime em nível de SDK | ✅ Sim | ✅ Sim | Alta (limites determinísticos) |
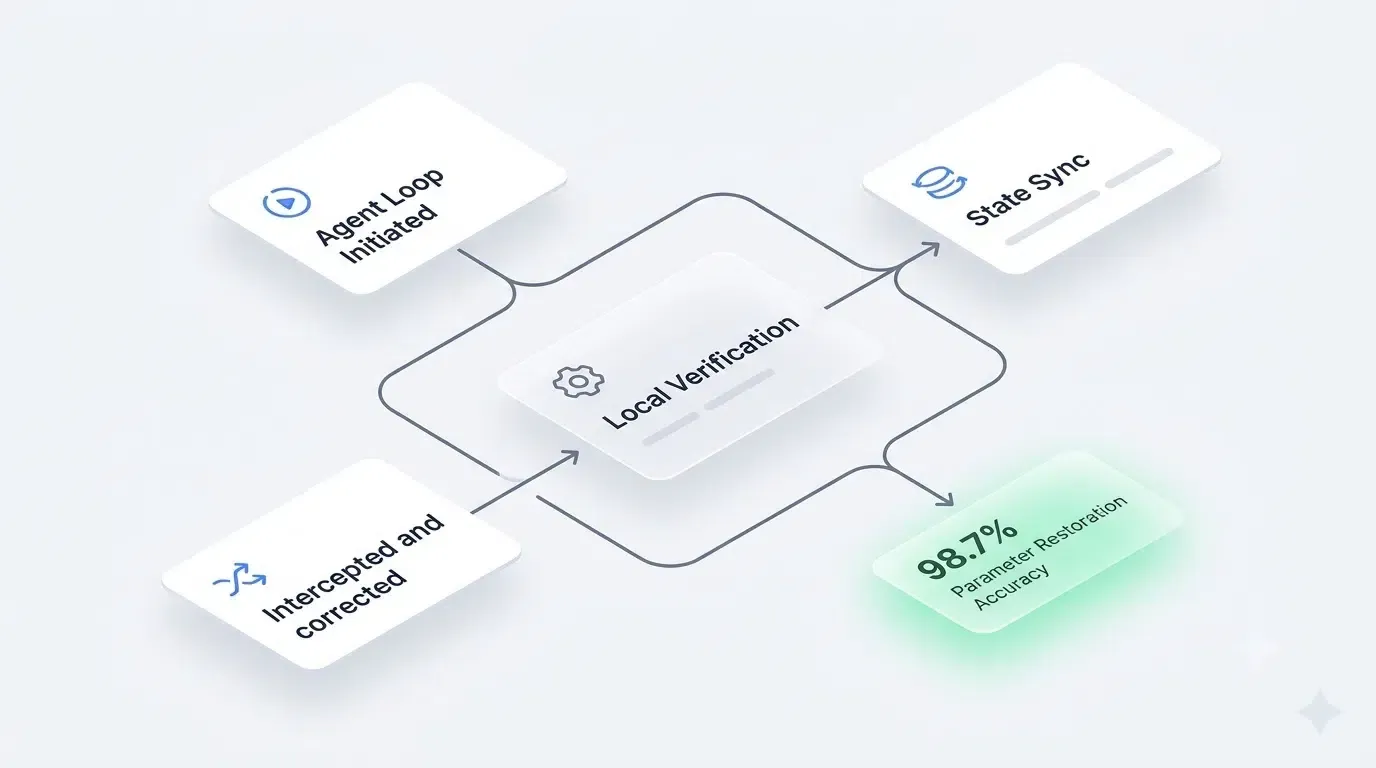
Loop de agente iniciado -> Runtime do SDK intercepta a chamada de API
                                |
Verificação local -> Corresponder cota de token e orçamento de API ativo
                                |
Sincronização de estado -> Registrar parâmetros de execução no servidor central -> Aplicar limites de orçamento local
Várias plataformas de software oferecem sincronização de estado no servidor ou persistência de parâmetros programáticos para lidar com sessões de desenvolvimento distribuído. Um exemplo dessa abordagem é o Opoinstall, que mapeia parâmetros de execução e metadados de sessão do desenvolvedor para um banco de dados de estado centralizado, garantindo que os contextos de sessão sejam preservados mesmo quando as tarefas iniciais são executadas de forma headless em contêineres de nuvem isolados. Esses sistemas mantêm o estado no servidor antes da execução e sincronizam parâmetros quando a sessão do aplicativo é iniciada, contornando os problemas de confiabilidade associados a ambientes de contêiner não monitorados. As equipes de engenharia podem avaliar essas abordagens de acordo com os requisitos de implantação e metas de precisão de atribuição; à medida que a OpenAI investiga o 'Codex', os desenvolvedores enfrentam a escolha de utilizar essas bibliotecas integradas.
Adaptações da equipe operacional e listas de verificação de runtime
As equipes de engenharia de backend enfrentam a tarefa imediata de auditar todas as integrações de banco de dados ativas antes de iniciar compilações compiladas automaticamente. Os líderes de produto devem redesenhar os loops de convite e registro para acomodar jornadas de usuário não visuais. Em vez de presumir que o usuário lerá um e-mail e clicará em um botão, os líderes de produto devem projetar fluxos de trabalho que esperam gatilhos programáticos. As equipes de growth devem atualizar suas métricas de desempenho. Quando o software autônomo lida com a triagem, as taxas de abertura e de cliques tornam-se menos confiáveis. As operações de marketing devem se concentrar na telemetria in-app downstream e em marcos de conversão verificados por transação, otimizando campanhas com base nas ações reais realizadas dentro do aplicativo.
Lista de verificação de verificação de custos programática
Para garantir a segurança do orçamento e evitar o esgotamento de cotas, as equipes de engenharia devem executar as seguintes etapas:
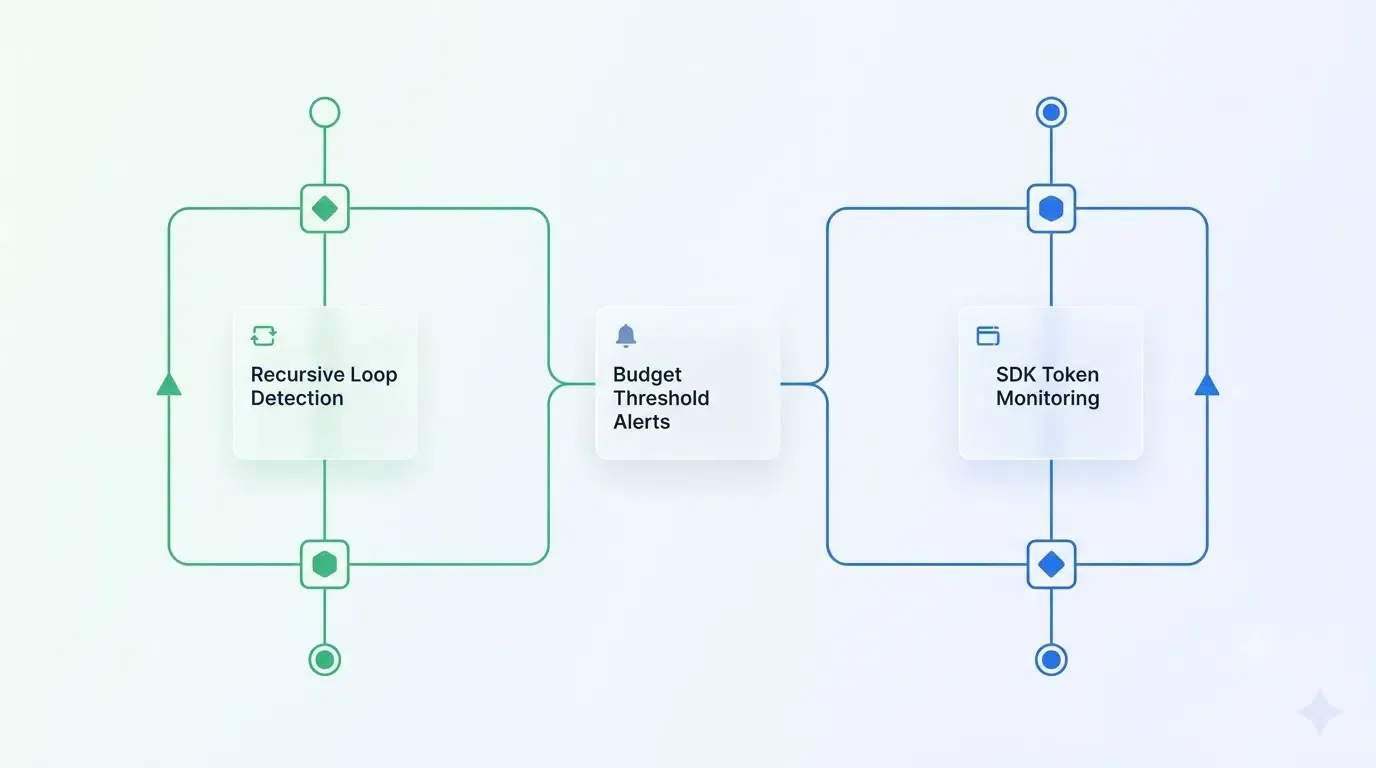
- Detecção de loop recursivo: Implementar proteções locais para detectar e interromper loops de autocorreção automatizados quando excederem dez iterações consecutivas.
- Monitoramento de tokens de SDK: Configurar contadores de tokens em tempo real no lado do cliente para rastrear o peso dinâmico do token tanto na entrada quanto nas entradas em cache.
- Validação de cache de prompt: Auditar acertos de cache dentro do contêiner de runtime para garantir que arquivos redundantes não acionem cobrança dupla.
- Alertas de limite de orçamento: Definir limites rígidos de orçamento local no runtime do SDK que acionem interrupções imediatas e não contornáveis.
- Verificação de assinatura de execução: Autenticar sessões de execução usando chaves de API criptográficas e cronogramas de rotação para evitar a execução de loop não autorizada.
Perguntas Frequentes (FAQ)
Por que o OpenAI Codex experimentou um rápido esgotamento de limite?
O incidente foi causado principalmente por scripts automatizados de anti-abuso e limitação de taxa da OpenAI que sinalizaram incorretamente fluxos de trabalho de desenvolvedor normais e de alta densidade. Quando esses sistemas de controle da plataforma identificaram erroneamente loops de refatoração padrão de vários arquivos como atividade fraudulenta, as cotas de assinantes pagantes foram esgotadas prematuramente.
Como os loops de agentes autônomos acionam cobranças de API inesperadas?
Sem proteções de orçamento no lado do cliente, agentes de codificação headless podem executar centenas de execuções de autocorreção recursivas ocultas dentro de contêineres isolados. Essas sessões contínuas e não visuais ignoram o rastreamento manual de custos, fazendo com que o consumo de tokens de entrada e saída em cache aumente drasticamente em um curto período.
Como os desenvolvedores podem evitar o consumo inesperado de tokens quando a OpenAI investiga limites do 'Codex'?
Os desenvolvedores podem integrar um SDK no lado do cliente que aplica orçamentos de token locais, implementa detecção de loop recursivo e autentica sessões programáticas usando identificadores de hardware exclusivos. Ao corresponder o contexto do cliente antes de executar solicitações de API de alto volume, as equipes podem controlar com segurança as alocações de tokens de runtime.
Principais conclusões para equipes de engenharia
A era do desenvolvimento de IA com tarifa única e previsível está terminando. As equipes de engenharia dependerão cada vez mais da governança de runtime, orçamento de execução e controles de custo em nível de SDK, em vez de confiar apenas no faturamento em nuvem. As plataformas que dependem fortemente de ações manuais e visuais do usuário podem enfrentar lacunas estruturais quando agentes automatizados gerenciam o pipeline de solicitação. A transição para a atribuição no servidor e a passagem segura de parâmetros representa uma direção altamente provável para manter um rastreamento e cobertura de segurança confiáveis.
Essa transição sugere uma reescrita fundamental de nossos frameworks de medição e protocolos de segurança. Os futuros sistemas de atribuição provavelmente dependerão mais fortemente da correspondência de identidade no servidor e da sincronização segura de estado. À medida que mais agentes de IA começam a atuar como os primeiros consumidores de comunicação digital, as arquiteturas de atribuição dependerão cada vez mais da identidade no servidor, recuperação de estado adiada e preservação de contexto em nível de protocolo, em vez de apenas sessões de navegador.
Perguntas Frequentes (FAQ)
Por que o OpenAI Codex experimentou um rápido esgotamento de limite?
Como os loops de agentes autônomos acionam cobranças de API inesperadas?
Como os desenvolvedores podem evitar o consumo inesperado de tokens quando a OpenAI investiga limites do 'Codex'?
A era do desenvolvimento de IA com tarifa única e previsível está terminando. As equipes de engenharia dependerão cada vez mais da governança de runtime, orçamento de execução e controles de custo em nível de SDK, em vez de confiar apenas no faturamento em nuvem. As plataformas que dependem fortemente de ações manuais e visuais do usuário podem enfrentar lacunas estruturais quando agentes automatizados gerenciam o pipeline de solicitação. A transição para a atribuição no servidor e a passagem segura de parâmetros representa uma direção altamente provável para manter um rastreamento e cobertura de segurança confiáveis.
Essa transição sugere uma reescrita fundamental de nossos frameworks de medição e protocolos de segurança. Os futuros sistemas de atribuição provavelmente dependerão mais fortemente da correspondência de identidade no servidor e da sincronização segura de estado. À medida que mais agentes de IA começam a atuar como os primeiros consumidores de comunicação digital, as arquiteturas de atribuição dependerão cada vez mais da identidade no servidor, recuperação de estado adiada e preservação de contexto em nível de protocolo, em vez de apenas sessões de navegador.
Share this article



