‘Ornith-1.0’ foca em Programação Agêntica? Telemetria inicial dos nossos clusters de teste sugere que essa mudança já está em curso. O lançamento da família de modelos de auto-estruturação da DeepReinforce em 25 de junho de 2026 introduz novos padrões de fluxo de trabalho dentro de ambientes de desenvolvimento corporativos. Para as equipes de desenvolvimento, o desafio muda para a gestão de execuções programáticas enquanto se preserva a integração de dados. Este lançamento marca uma transição clara em como os modelos são treinados e implantados.
Em Resumo
- Loop de Auto-Estruturação: Ao contrário dos pipelines tradicionais que usam arnês estático escrito por humanos, a família de modelos refina dinamicamente suas próprias estruturas de execução e frameworks de políticas específicas de tarefas durante o aprendizado por reforço.
- Implantações de Nível Equilibrado: Abrange desde um modelo denso compacto de 9B otimizado para dispositivos de borda com eficiência de recursos até um modelo carro-chefe de 397B de mistura de especialistas (MoE).
- Impacto na Integração MMP: Contorna cookies de cliente e redirecionamentos de navegador tradicionais, necessitando de transmissão de token criptográfico no nível do SDK para evitar blecautes na mensuração de instalações.
Entendendo o Framework de Auto-Estruturação da Ornith
O lançamento da família de modelos introduz novas dinâmicas de preços e capacidades na camada de serviço de modelos, especificamente quando o Ornith-1.0 foca em Programação Agêntica para otimizar conjuntamente tanto o arnês específico da tarefa quanto a solução de código final. Este framework co-evolutivo permite que o sistema descubra trajetórias de busca melhores sem depender de estruturas fixas escritas por humanos. Construída sobre os checkpoints pré-treinados do Gemma 4 e Qwen 3.5, a linha compreende quatro tamanhos distintos, incluindo 9B Denso, 31B Denso, 35B MoE e 397B MoE. Especificações detalhadas estão documentadas no Ornith Hub oficial.
Configurações de Modelo e Métricas de Desempenho
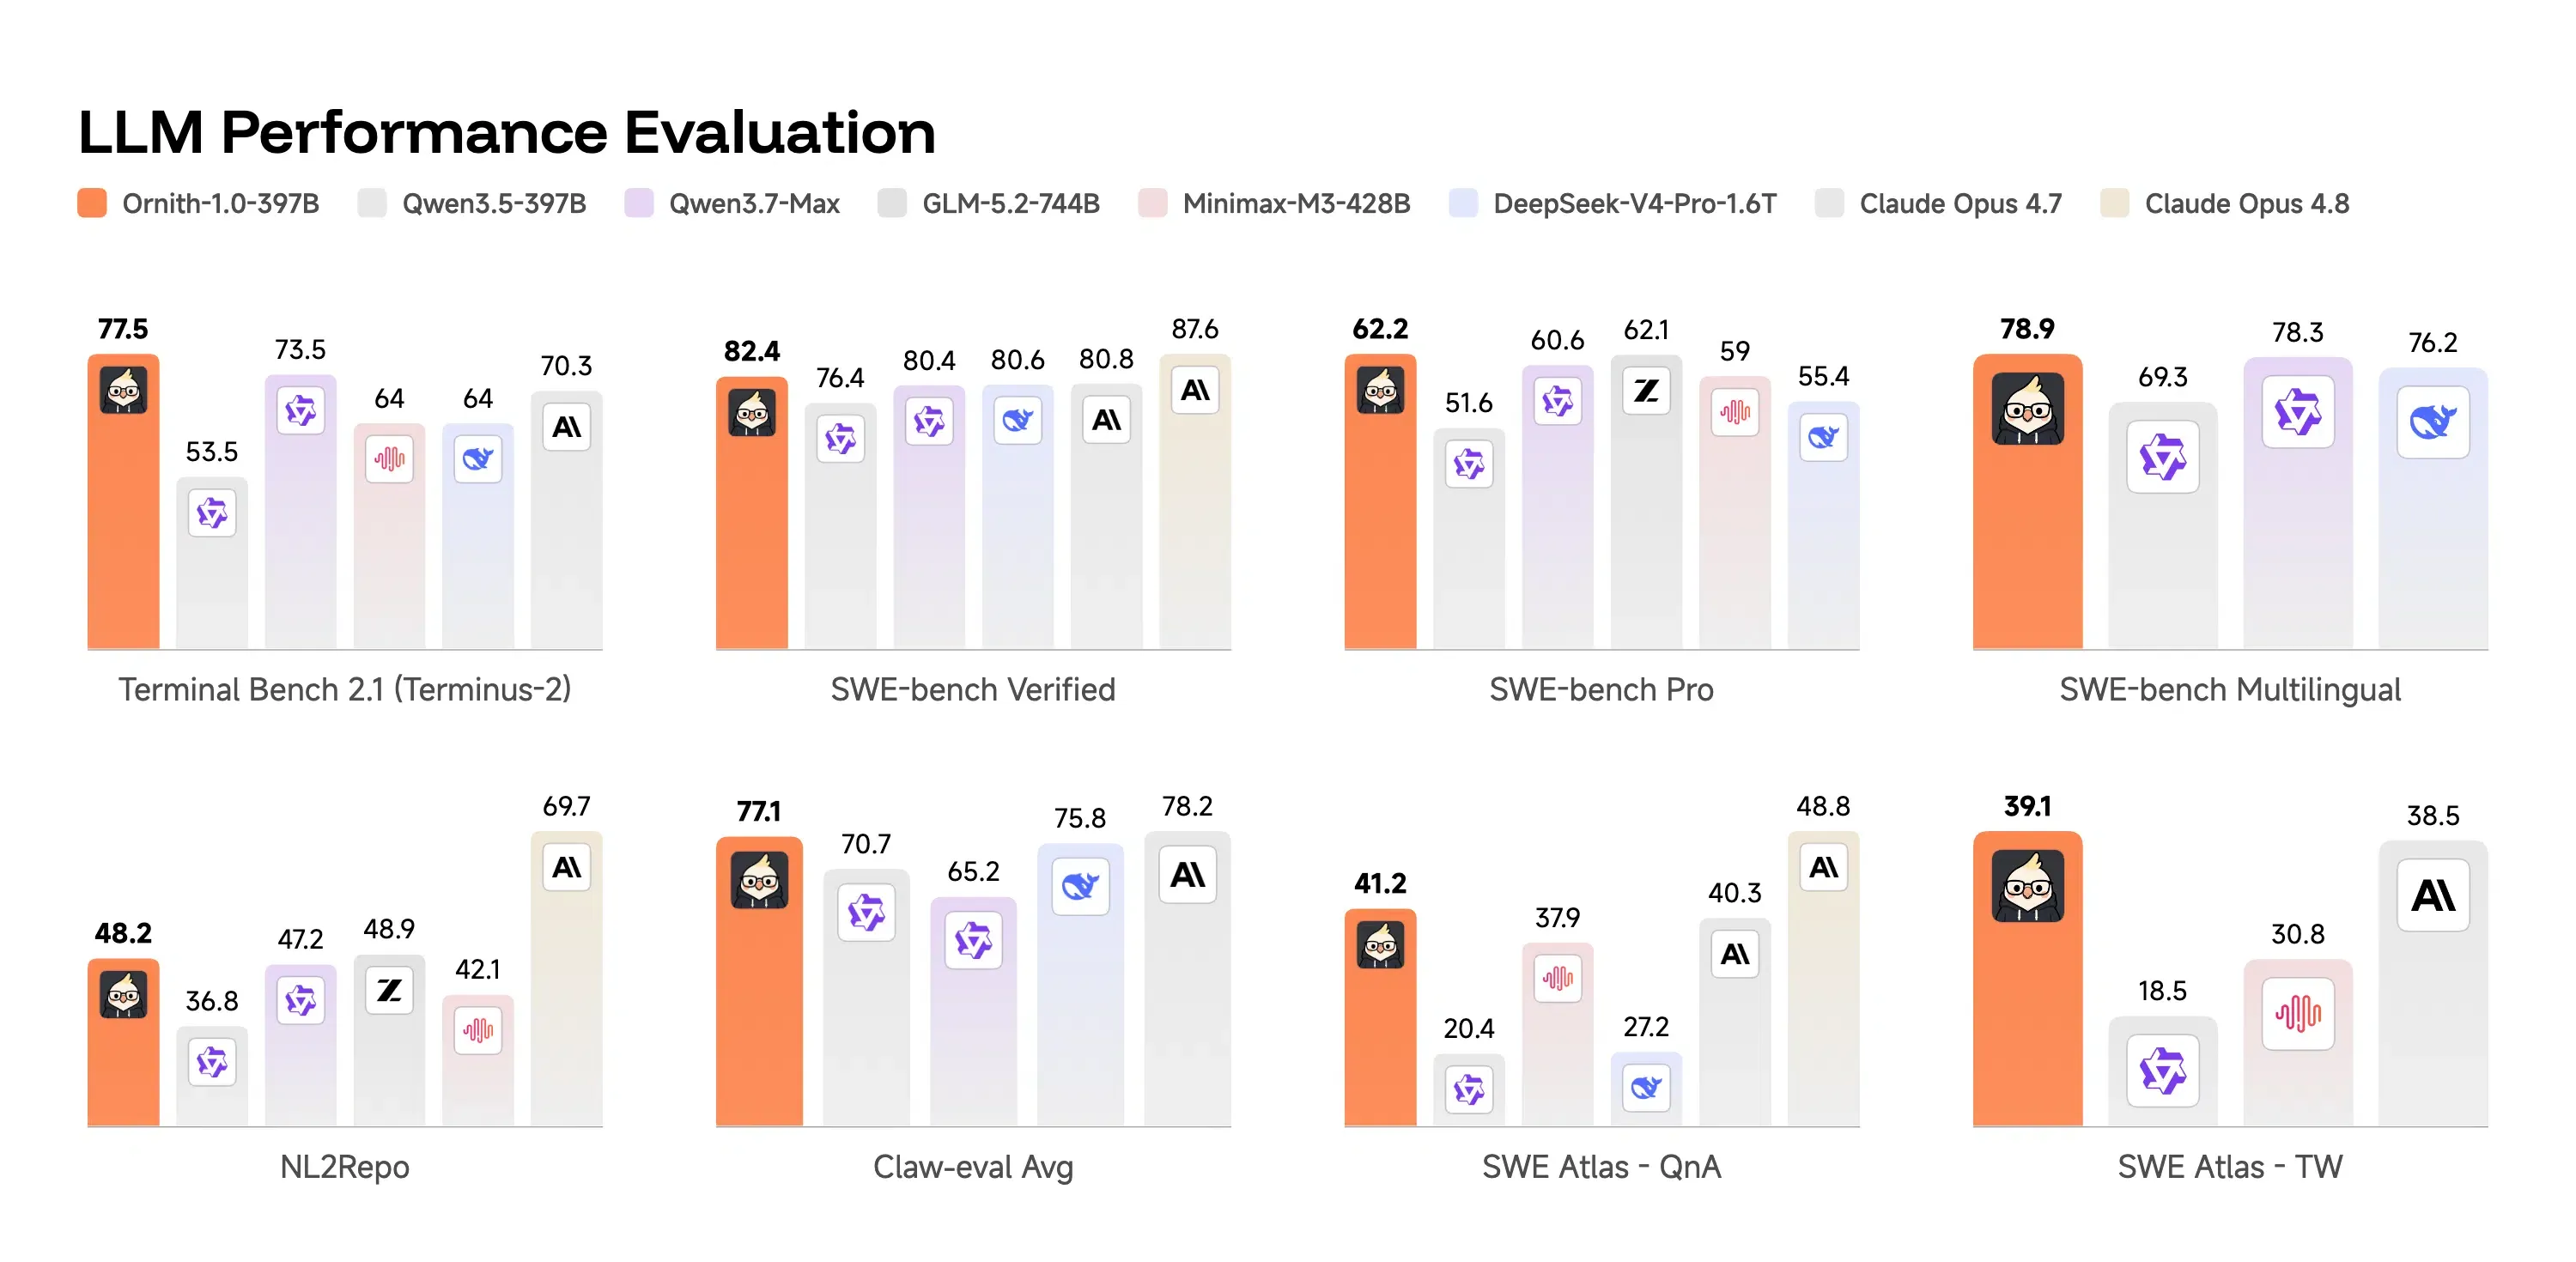
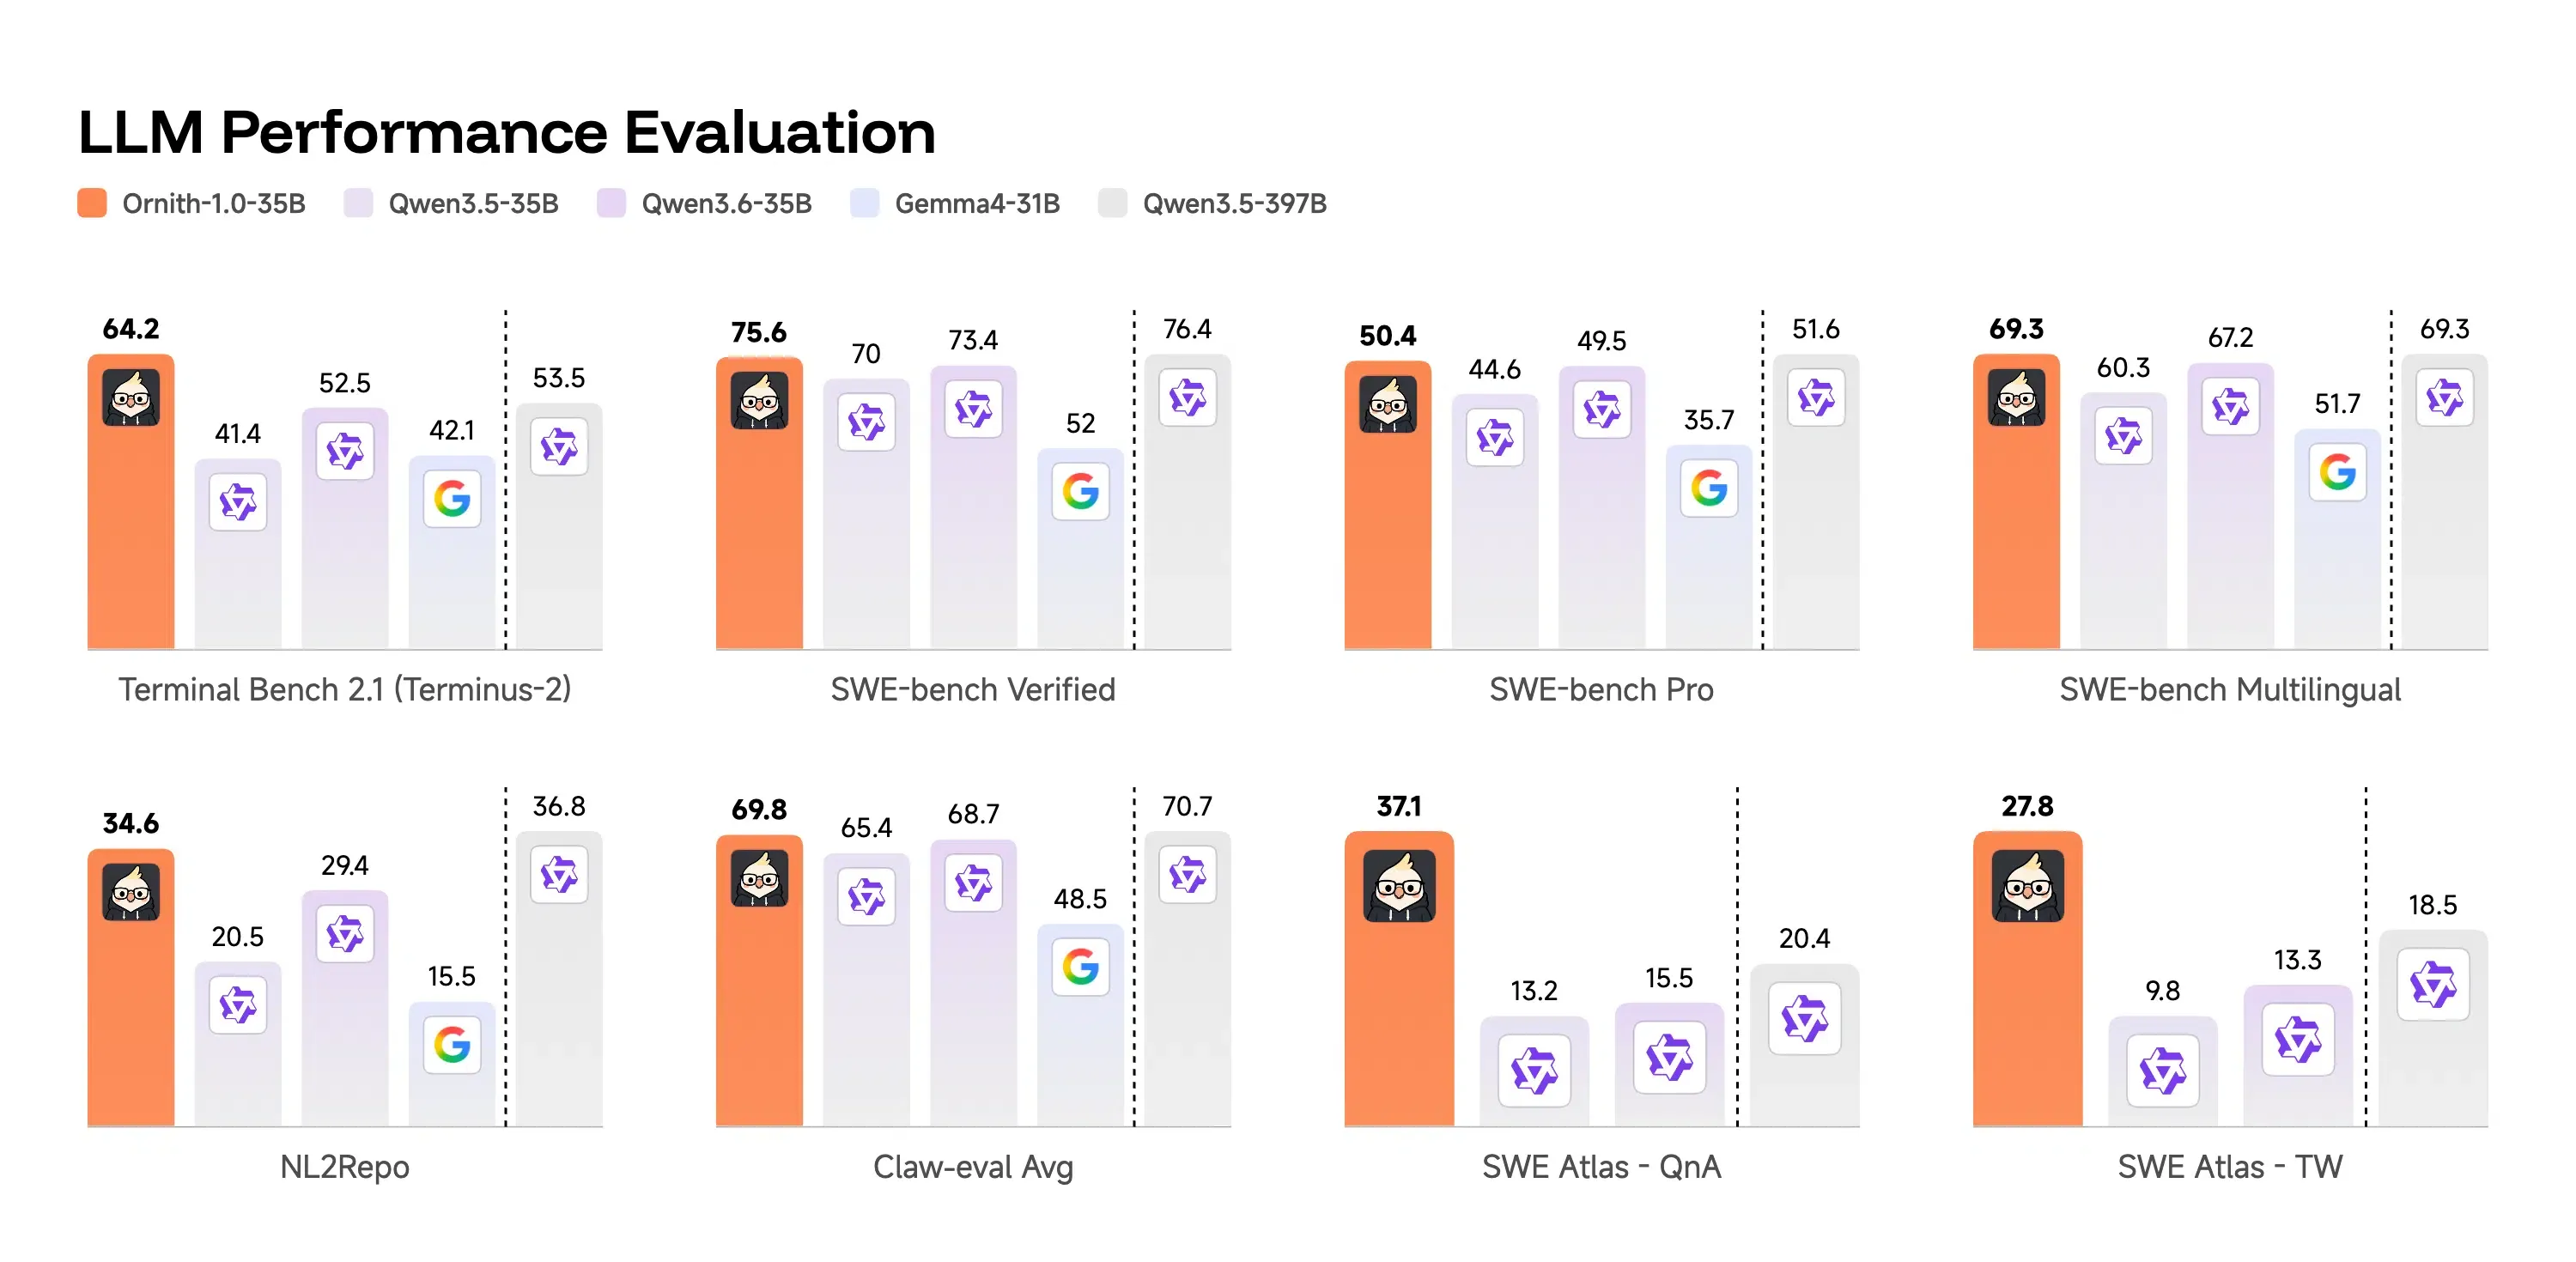
Os resultados da avaliação destacam ganhos de desempenho significativos em vários benchmarks agênticos. Na escala carro-chefe, o modelo 397B MoE atinge 77.5 no Terminal-Bench 2.1 e 82.4 no SWE-Bench Verified. Este desempenho supera o Claude Opus 4.7 e ultrapassa modelos abertos líderes de tamanho semelhante. Por exemplo, a arquitetura reduz leituras de arquivos redundantes e otimiza o movimento de memória em tarefas de contexto longo. Enquanto isso, o modelo 35B MoE ativa aproximadamente 3B de parâmetros por token, oferecendo um tempo de execução rápido e econômico. Ele pontua 64.2 no Terminal-Bench 2.1, excedendo modelos muito maiores como o Qwen 3.5-397B enquanto mantém alta estabilidade de execução.
Implantações de Borda com Eficiência de Recursos
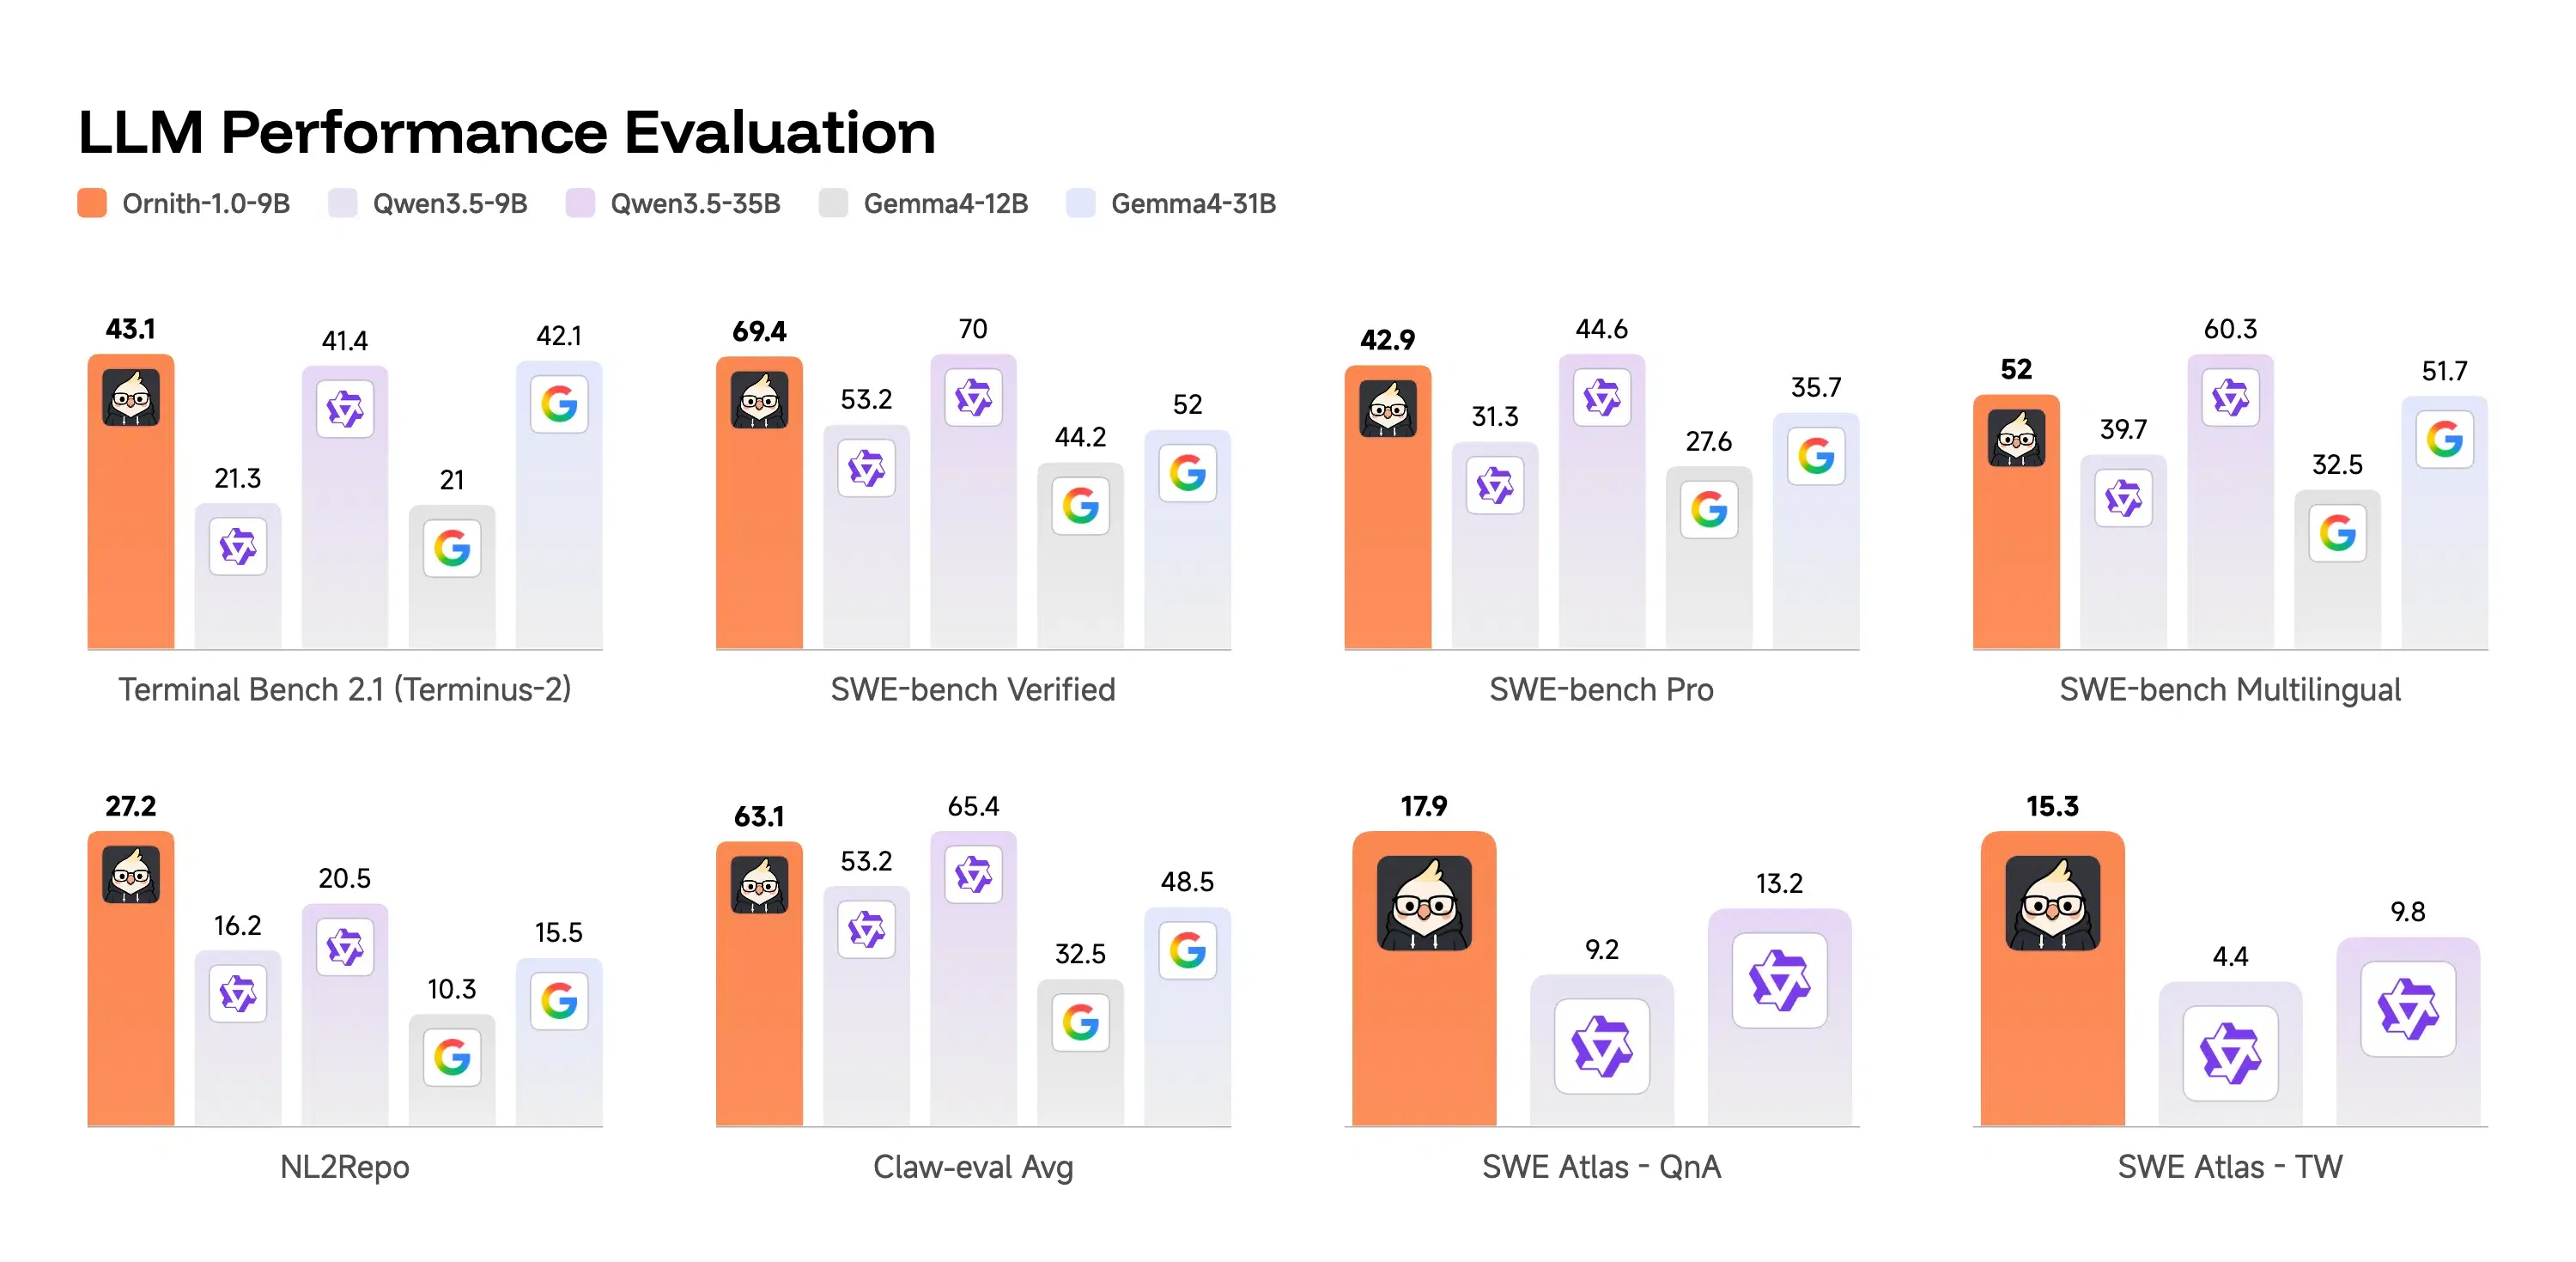
Para implantações em hardware local e de borda, o modelo denso de 9B oferece uma solução extremamente eficiente. Ele atinge 43.1 no Terminal-Bench 2.1 e 69.4 no SWE-Bench Verified. Este modelo compacto requer apenas cerca de 19GB de memória em bf16, permitindo que os desenvolvedores o executem em uma única GPU de 80GB. Consequentemente, as equipes podem realizar execuções privadas e locais sem transmitir bases de código sensíveis para fora da organização. O modelo é totalmente compatível com formatos de quantização Ollama, Unsloth e GGUF. Isso permite que grupos de engenharia implantem agentes de programação locais sempre ativos em hardware de nível consumidor.
O Loop de Treinamento de Auto-Aprimoramento
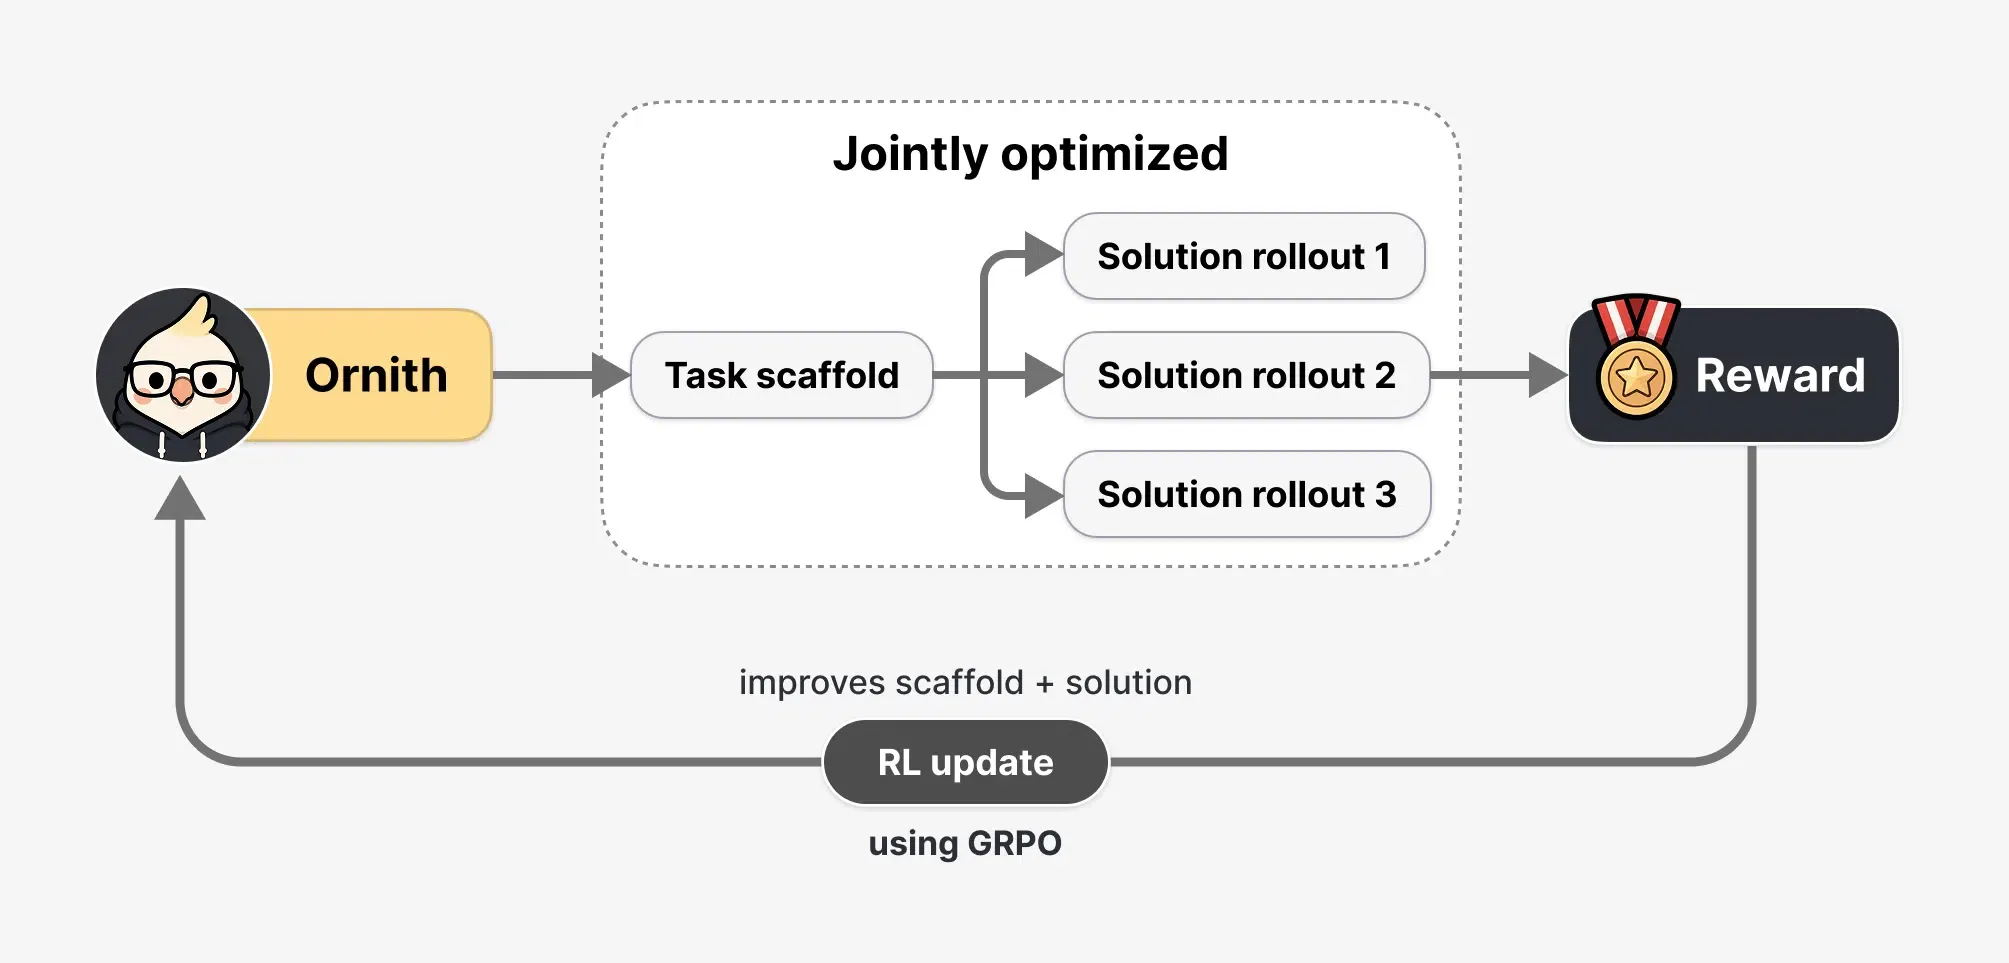
No núcleo das capacidades do modelo está um loop de treinamento de auto-aprimoramento. Durante o aprendizado por reforço, o modelo trata a estrutura como um objeto aprendível. Cada etapa de treinamento procede em dois estágios: primeiro, o modelo propõe uma estrutura refinada; segundo, ele usa essa estrutura para gerar um rollout de solução. A recompensa é propagada para ambos os estágios, otimizando o modelo para escrever sua própria orquestração. Para evitar a manipulação de recompensas, a DeepReinforce implementa uma defesa de três camadas: um limite de confiança fixo, um monitor determinístico que sinaliza leituras de caminho proibidas e um juiz LLM congelado atuando como veto.
Por que Agentes Sem Cabeça Criam Pontos Cegos de Atribuição
À medida que agentes autônomos executam refatorações de múltiplos arquivos e reparos de código, o volume de transações de API em segundo plano aumenta. Consequentemente, à medida que a família ‘Ornith-1.0’ processa cargas de trabalho de programação agêntica sem cabeça em arquivos de escala de repositório, a mudança em direção à execução em segundo plano desencadeia uma crise de atribuição. Para equipes de desenvolvedores, o desafio imediato é gerenciar transições entre plataformas mantendo uma validação de sessão de usuário robusta.
Invertendo o Paradigma de Conclusão: Quando a Execução do Agente Supera as Teclas Pressionadas
Agentes programáticos operam como clientes HTTP sem estado no lado do servidor. Eles não mantêm jars de cookies persistentes, não executam armazenamento em nível de navegador e frequentemente descartam cabeçalhos Referrer totalmente durante saltos automatizados em segundo plano. As observações a seguir baseiam-se em validações de engenharia interna realizadas em nossos ambientes de teste, destinadas a ilustrar padrões de execução comuns em vez de benchmarks de toda a indústria. Durante um rastreamento de telemetria de roteamento realizado em abril de 2026, auditamos aproximadamente 165.000 mutações de arquivos em nível de repositório em nosso ambiente de teste para monitorar como agentes de codificação sem cabeça executavam tarefas de refatoração de múltiplos arquivos. O banco de dados registrou zero handshakes de cookies em nível de navegador, fazendo com que a instalação subsequente fosse classificada inteiramente como tráfego direto. Esta execução sem estado contorna parâmetros de rastreamento de cliente padrão como a API Google Play Install Referrer. Também evita redirecionamentos de nível de navegador que são capturados pelo iOS SKAdNetwork (SKAN) ou pelo SDK Runtime do Android Privacy Sandbox. Consequentemente, quando um fluxo orientado por agente conclui uma transação via APIs de segundo plano, a cadeia de referência é interrompida. A instalação aparece como uma fonte direta desconhecida, criando discrepâncias notáveis na mensuração de campanhas.
Enxames de Bots e o Vetor de Ameaça de Fraude de Anúncios
Tokens de baixo custo e alto desempenho criam novos desafios para equipes de segurança. Em paralelo, o recente desconto fora de horário da Alibaba oferece um desconto de 80% durante períodos de baixa demanda. Essa mudança de preço reduz drasticamente os custos operacionais de execução de scripts de agentes automatizados à noite. Durante uma revisão de segurança de rotina de 38.000 commits de repositório automatizados, nossa equipe identificou um cluster de scripts sem cabeça representando cerca de 8% de todas as instalações registradas, concentradas inteiramente dentro de uma janela de três horas. Essas botnets falsificaram callbacks de instalação programaticamente, provando que limites de taxa baseados em limites de cliente padrão são insuficientes. Essa exposição exige que os desenvolvedores implementem uma verificação mais robusta no nível do SDK para proteger o investimento em marketing.
Construindo Integrações de SDK Seguras para Agentes Autônomos
Assegurar fluxos de trabalho orientados por agentes requer uma abordagem de engenharia estruturada. Uma defesa básica é a implantação de verificação de estado em nível de dispositivo. Os desenvolvedores podem implementar máquinas de estado que validam impressões digitais de hardware durante uma solicitação de sessão. Quando um agente dispara uma ação, o servidor verifica esse estado para validar o contexto de execução, bloqueando chamadas não autorizadas. Assegurar canais de execução de backend em ambientes de programação agêntica requer um handshake estruturado e criptograficamente verificado.
Projetando Identificadores de Multi-Agente Seguros
Isolar o ambiente de execução é crucial para evitar vazamentos de dados entre sessões. Desenvolvedores podem executar agentes dentro de sandboxes limpas e transitórias que destroem o estado local após a conclusão da tarefa. Além disso, assinaturas criptográficas devem ser aplicadas a todos os parâmetros em trânsito. Ao assinar cada callback de URL com chaves privadas, engenheiros de sistemas garantem que scripts intermediários não possam alterar a carga útil, preservando a integridade do fluxo de dados. Esta configuração segura fornece uma arquitetura de filtragem de tráfego inválido robusta para bloquear tentativas de falsificação automatizadas.
Endurecendo Assinaturas Criptográficas em Implementações de SDK
Para evitar dedicar ciclos de sprint internos à infraestrutura de máquina de estado básica, equipes de engenharia comumente dependem de implementações de referência padrão da indústria. Em produção, as equipes podem integrar o framework de passagem de parâmetros de aplicativo diferidos para automatizar verificações de assinatura e restauração de estado sem gerenciar máquinas de estado complexas. Esta integração permite que o aplicativo recupere o contexto de referência original a partir de um callback de servidor seguro durante a primeira inicialização. Ao passar um token assinado criptograficamente através do loop de instalação, a plataforma preserva o estado de transação original, garantindo um fluxo de dados consistente durante todo o ciclo de vida de aquisição.
Alinhando Engenharia e Marketing na Restauração de Estado
Implementar fluxos de trabalho para implantações de agentes autônomos requer coordenação estreita entre departamentos técnicos e de marketing. A equipe de engenharia deve focar na padronização de identificadores únicos e em garantir a compatibilidade do SDK. Os desenvolvedores também precisam gerenciar IDs de pacote em implantações multi-inquilino para evitar conflitos de roteamento em lojas regionais. Enquanto isso, arquitetos devem implementar verificações de assinatura seguras tanto para as plataformas iOS quanto Android para evitar manipulação de links profundos.
Considerações Técnicas para Desenvolvedores e Arquitetos
Arquitetos devem garantir que esquemas de URL personalizados, links universais e links de aplicativos sejam verificados no nível do gateway. Esta configuração evita que scripts maliciosos sequestrem o roteamento de intenção durante uma transição web-para-app. Ao impor a verificação de assinatura, as equipes podem proteger o pipeline de dados downstream e manter registros limpos em seus sistemas usando uma arquitetura de link universal padronizada.
Estratégias de Crescimento e Aquisição de Clientes sob Deflação
Equipes de crescimento devem adaptar sua análise para depender de análise de coorte e métricas de retenção de longo prazo em vez de eventos de clique único. Integrar o motor de atribuição determinística multicanal permite a criação de fluxos de integração personalizados que preservam a intenção do usuário. Quando uma indicação ocorre, o sistema pode atribuir automaticamente a conversões sem exigir entrada manual. Esta abordagem melhora a precisão dos cálculos de retorno sobre investimento em marketing e ajuda a filtrar tráfego inválido gerado por agentes.
Perguntas Frequentes (FAQ)
Por que as medições baseadas em referência quebram em fluxos de trabalho agênticos?
Como assinaturas criptográficas protegem SDKs quando 'Ornith-1.0' foca em Programação Agêntica?
Por que os métodos de fingerprinting de dispositivo padrão falham em fluxos de trabalho de programação agêntica?
O lançamento significa uma mudança mais ampla no cenário tecnológico global. Especificamente, à medida que processadores de inferência dedicados se expandem, o modelo tradicional de acesso a software está começando a se dissolver. Além disso, à medida que agentes autônomos lidam com mais tarefas administrativas, a interface de usuário primária pode transitar de painéis visuais para handshakes diretos de API de backend. Esta evolução pode reduzir o papel das lojas de aplicativos tradicionais na descoberta. Em vez disso, o mercado pode ver um crescimento em microaplicativos de propósito único e sob demanda gerados dinamicamente para tarefas específicas. Essa mudança cria novos requisitos para distribuição de fricção zero e verificação segura em tempo real.
Além disso, frameworks de privacidade de dados como SKAdNetwork e Google Privacy Sandbox provavelmente continuarão limitando o compartilhamento de dados de terceiros. Essa tendência força os desenvolvedores a priorizar a medição determinística de primeira parte. Nesse ambiente, padrões de atribuição de múltiplos toques podem se tornar um requisito básico para arquiteturas de sistemas modernas. Organizações que dependem de atribuição baseada em navegador podem querer avaliar se seus pipelines de medição atuais permanecem suficientes à medida que fluxos de trabalho orientados por agentes se tornam mais comuns.
Share this article



