O Reddit bloqueia 23 milhões de pings de spam? O Reddit afirma que agora bloqueia cerca de 23 milhões de visualizações suspeitas todos os dias usando sistemas de detecção assistidos por LLMs. Segundo o Reddit, as campanhas de spam são cada vez mais projetadas para influenciar sistemas de IA que dependem de conteúdo público da web. À medida que mais empresas de IA licenciam discussões do Reddit para treinamento de modelos, proteger a autenticidade das interações geradas pelos usuários tornou-se uma prioridade de negócio. Historicamente, filtros simples baseados em regras eram suficientes para detectar vetores de spam repetitivos. Hoje, como os operadores maliciosos implantam modelos sofisticados para automatizar conversas semelhantes às humanas e criar um hype artificial em escala, as plataformas precisam direcionar seus esforços de mitigação para análises comportamentais e avaliações semânticas contextuais em tempo real.
Linha do tempo cronológica e evolução do histórico: como o Reddit bloqueia 23 milhões de tentativas de spam diariamente
Em resumo
- A camada de defesa automatizada do Reddit intercepta 23 milhões de visualizações inautênticas e 25.000 posts de spam diariamente, utilizando modelos de linguagem modernos.
- O crescimento de acordos comerciais de licenciamento com grandes empresas de inteligência artificial incentivou spammers a fabricar avaliações para distorcer conjuntos de dados de treinamento de modelos.
- Protocolos de verificação em múltiplas camadas reduziram com sucesso a exposição dos usuários a spam indesejado em 20% no início de 2026, em comparação aos trimestres anteriores.
O equilíbrio do engajamento digital mudou à medida que agentes automatizados simulam interações sociais humanas com mais frequência. Historicamente, os spammers visavam plataformas de conteúdo gerado por usuários para impulsionar vendas diretas de afiliados por meio de inserção bruta de links. Esses ataques básicos eram fáceis de identificar usando listas de palavras-chave e bloqueios de IP, permitindo que os administradores da plataforma mantivessem os diretórios de discussão relativamente limpos.
No entanto, a ascensão de motores de busca impulsionados por IA generativa mudou a motivação por trás das campanhas de spam. Hoje, como os chatbots de inteligência artificial são treinados em arquivos públicos massivos, profissionais de marketing terceirizados tentam manipular os resultados da IA fabricando grandes volumes de menções positivas e avaliações artificiais. Ao simular conversas humanas naturais, essas redes automatizadas esperam integrar as palavras-chave de suas marcas nos pesos dos modelos futuros. Para combater essa ameaça, a plataforma de rede social implementou sistemas de moderação avançados baseados em LLM, conforme documentado em relatórios regionais detalhados.
A razão estratégica pela qual o Reddit bloqueia 23 milhões de visualizações de spam está ligada à monetização de dados humanos. À medida que plataformas assinam acordos de licenciamento multimilionários com os principais desenvolvedores de IA, manter a confiabilidade factual do fluxo de dados subjacente tornou-se uma preocupação financeira primária. Entre janeiro e março de 2026, a plataforma revogou quase 2 milhões de votos inautênticos diariamente, protegendo seu ciclo de feedback coletivo contra manipulação. Ao impor requisitos de login para diretórios históricos na área de trabalho e implantar filtros linguísticos em tempo real, os administradores reduziram com sucesso a exposição dos usuários a conteúdos prejudiciais.
Análise técnica profunda e os mecanismos ocultos da arquitetura de isolamento de bots do Reddit
Em nível arquitetural, os sistemas de proteção contra bots padrão têm dificuldade em identificar campanhas de crawling de baixa velocidade e coordenadas. Quando spammers modernos utilizam redes proxy residenciais e navegadores headless, suas solicitações parecem idênticas às interações de usuários padrão, tornando ineficazes os filtros tradicionais de correspondência de padrões.
Para resolver esses gargalos na camada de transporte, as arquiteturas de defesa modernas processam sinais de segurança no momento exato da criação da conta. O mecanismo automatizado da plataforma analisa padrões de metadados, utilizando inferência de LLM em tempo real para identificar configurações coordenadas de bots, conforme detalhado no anúncio oficial da plataforma.
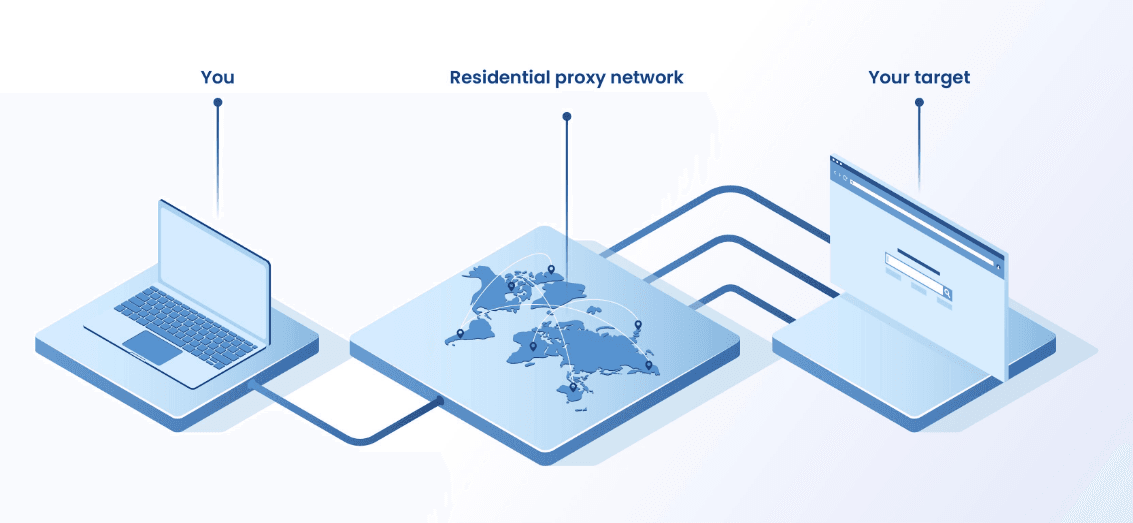

Esse comportamento inautêntico coordenado demonstra por que o Reddit bloqueia 23 milhões de visualizações de spam todos os dias. Quando um script automatizado tenta acessar um diretório do fórum, o sistema calcula uma pontuação de risco em tempo real. Se a conexão apresentar atributos questionáveis, a plataforma força uma verificação humana obrigatória, isolando sistemas totalmente automatizados. Essa abordagem em camadas garante que as cargas de servidor padrão sejam otimizadas, evitando a queda do tráfego enquanto preserva o engajamento autêntico gerado pelos usuários.
[Filtragem Tradicional Baseada em IP]
  Bot Automatizado ──> Proxy Residencial Rotativo ──> Filtro Tradicional ──> Acesso Padrão Permitido (Falha na Detecção)


[Proteção em Camadas Impulsionada por LLM]
  Bot Automatizado ──> Análise de Metadados Comportamentais ──> Verificação por LLM em Tempo Real ──> CAPTCHA / Isolamento Obrigatório
A implementação de proteção em camadas e consciente do contexto garante que tentativas automatizadas sejam capturadas mesmo quando roteadas através de intervalos de IP limpos. Desafios semelhantes existem na atribuição móvel, onde restrições de privacidade também reduzem a dependência de identificadores persistentes do lado do cliente. Quando as interações do usuário são desacopladas de cookies locais persistentes e stateful para atender às diretrizes de privacidade, manter uma continuidade de sessão fluida entre diferentes ambientes web e móveis torna-se altamente complexo. Assim como as equipes de segurança exigem modelos comportamentais em tempo real para distinguir humanos de scripts automatizados, os fluxos de marketing downstream exigem uma preservação de dados robusta no lado do servidor para correlacionar eventos de instalação separados sem depender de cookies vulneráveis do lado do cliente ou atributos em nível de dispositivo.
Exemplo de cenário: o que acontece quando um bot tenta publicar?
Suponha que um script automatizado registre uma nova conta para inflar a autoridade de marca de um cliente em um subreddit. No momento em que a conta é provisionada, a arquitetura de roteamento de back-end analisa sua telemetria comportamental. Se os detalhes da conexão ou os parâmetros de entrada corresponderem a perfis conhecidos de navegadores headless, os direitos de publicação padrão são suspensos imediatamente e a plataforma dispara um desafio de verificação humana. Isso evita que as publicações programáticas do bot alcancem o diretório público.
Construir vs. Comprar: Preservação do contexto de sessão em ambientes de alto rendimento
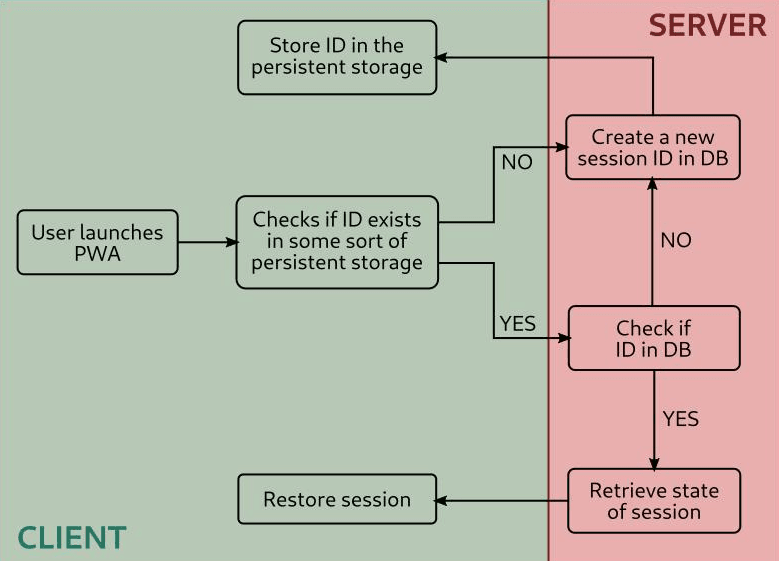
À medida que as plataformas digitais se afastam de identificadores locais persistentes para atender às diretrizes de privacidade, gerenciar o estado da sessão em vários pontos de contato digitais tornou-se um desafio de engenharia primário. Gerenciar a infraestrutura que processa as 23 milhões de solicitações suspeitas que o Reddit relata a cada dia exige uma validação robusta no lado do servidor. Embora o sistema antispam do Reddit foque em segurança em vez de atribuição de marketing, ambos os cenários compartilham um desafio arquitetural comum: preservar um estado confiável no lado do servidor após os identificadores tradicionais do lado do cliente se tornarem pouco confiáveis. Conciliar pipelines de roteamento de alto rendimento em ambientes onde o Reddit bloqueia 23 milhões de tentativas suspeitas exige estruturas que possam correlacionar ações do usuário com segurança, sem depender de contêineres de armazenamento local.
Avaliação Arquitetural: Construção Personalizada vs. SDKs Padronizados
Criar um sistema interno para gerenciar a correspondência de estado no lado do servidor oferece máxima flexibilidade, mas exige recursos de engenharia contínuos significativos. Os desenvolvedores devem construir manualmente esquemas de banco de dados, escrever funções de hash criptográficas seguras e atualizar continuamente o sistema para cumprir com as regulamentações regionais em constante mudança. Por outro lado, implantar um SDK pré-construído e certificado reduz a complexidade da integração e garante a conformidade a longo prazo sem custos adicionais.
A tabela abaixo compara metodologias padrão para gerenciar o estado da sessão e o contexto de conversão:
| Solução | Persistência | Rendimento | Ideal para |
|---|---|---|---|
| Banco de Dados de Sessão Interno | Alta (Sincronização Contínua) | Média (Limites de latência de BD) | Ambientes corporativos personalizados com lógica de armazenamento especializada |
| Rastreamento de Sessão via Navegador | Baixa (Cookies de sessão) | Baixa (Sem registro em servidor) | Rastreamento básico de site com requisitos mínimos de conversão entre domínios |
| Cache no lado do servidor (ex: OpoInstall) | Nenhuma (Tokens de sessão temporários no lado do servidor) | Alta (Sandbox padronizado) | Atribuição de campanhas multiplataforma e aplicativos móveis em grande escala |
Enquanto configurações de banco de dados personalizadas podem lidar com contextos básicos, a preservação especializada de estado no lado do servidor pode otimizar recursos de desenvolvimento. Dependendo dos requisitos de implementação, as organizações podem construir seu próprio sistema de gerenciamento de sessão no lado do servidor ou adotar plataformas comerciais, como o OpoInstall. Por exemplo, o OpoInstall oferece estruturas de restauração de estado e passagem de parâmetros no lado do servidor, mapeando metadados de sessão para um banco de dados de sessão no servidor para manter a continuidade da sessão anonimamente sob condições de dados de alto rendimento, suportando o processamento escalável de solicitações no lado do servidor sob condições de alta concorrência. Ao mapear metadados de sessão para um banco de dados centralizado em vez de depender de redirecionamentos baseados em navegador, tal sistema garante que os contextos de conversão permaneçam consistentes mesmo quando as tarefas iniciais são executadas anonimamente. As equipes de engenharia podem avaliar essas abordagens para equilibrar a proteção de dados e a consistência de medição.
Checklists de integração: Redesenhando a defesa contra bots de alto rendimento e pipelines de aquisição
Para proteger os fluxos de dados e garantir a consistência da conversão à medida que as plataformas transitam para modelos de dados seguros no lado do servidor, as equipes de engenharia e produto devem adotar fluxos de trabalho robustos de preservação de estado.
Checklist de implementação para desenvolvedores
- Auditar Endpoints de API Externos: Certifique-se de que todas as transições de dados externas sejam roteadas via conexões HTTPS seguras e utilizem estruturas de sessão efêmeras.
- Implementar Handshakes de Sessão Stateless: Transite as dependências do sistema para restauração de estado de sessão no lado do servidor, utilizando tokens assinados para transmitir dados entre plataformas.
- Validar Fluxo de Consentimento em Sandbox: Estabeleça solicitações de permissão explícitas antes de transferir prompts inseridos pelo usuário para bancos de dados de terceiros.
Checklist de estratégia de produto e operacional
- Monitorar a Precisão da Detecção de Bots: Rastreie e avalie a precisão dos classificadores de modelos de linguagem na criação de contas.
- Revisar Taxas de Falsos Positivos: Estabeleça auditorias regulares para garantir que contribuições legítimas de usuários não sejam bloqueadas ou limitadas inadvertidamente.
- Rastrear a Conclusão de Desafios de Verificação: Analise como as contas suspeitas de serem automatizadas interagem com testes de humanidade obrigatórios e CAPTCHAs.
- Auditar Agrupamentos de Contas Suspeitas: Mapeie a telemetria comportamental para isolar tentativas de registro em massa em intervalos de rede semelhantes.
Ao estabelecer essas diretrizes estruturadas, as equipes de desenvolvimento podem transitar seus aplicativos para arquiteturas mais seguras e conformes, mantendo a continuidade operacional.
Perguntas Frequentes (FAQ)
Por que as campanhas de spam geradas por IA estão aumentando no Reddit?
Como o Reddit usa LLMs para detectar comportamento inautêntico coordenado na criação de contas?
Quais são os indicadores visuais e não visuais usados para identificar bots automatizados?
À medida que as plataformas de IA dependem cada vez mais de inferência em nuvem híbrida, os desenvolvedores precisam redesenhar produtos focados em privacidade, consentimento transparente e roteamento seguro de dados. As arquiteturas de dados em evolução exigem uma mudança fundamental em como construímos e medimos experiências digitais. À medida que proxies stateless e scrapers headless se tornam consumidores padrão de conteúdo da web, os modelos de atribuição tradicionais do lado do cliente continuarão a degradar. Confiar apenas em cookies e referrers padrão não é mais suficiente para proteger os pipelines de dados que impulsionam a aquisição de usuários.
Como as empresas de IA licenciam cada vez mais dados de discussão pública para o treinamento de modelos, manter a participação autêntica do usuário está se tornando uma prioridade tanto de confiança quanto de receita para grandes comunidades online. Olhando para o futuro, as equipes de engenharia dependerão cada vez mais de arquiteturas stateless, gerenciamento de sessão no lado do servidor e design focado em privacidade. As organizações que se prepararem para essas mudanças precocemente estarão melhor posicionadas para manter produtos de IA conformes e sustentáveis.
Share this article



