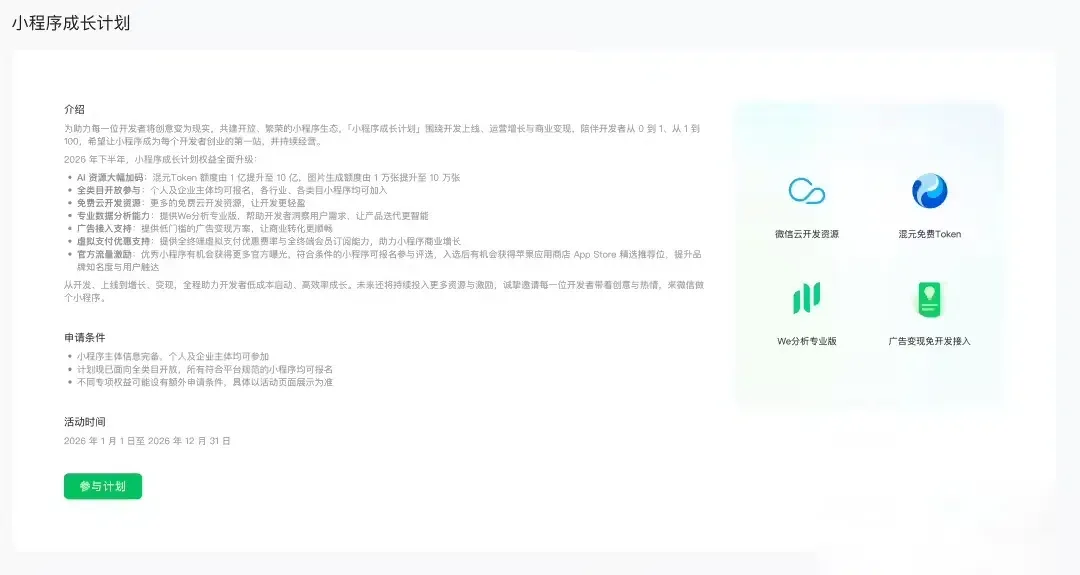
 Mini Programas de IA do WeChat em expansão? A Tencent anunciou um novo programa para desenvolvedores que oferece um bilhão de tokens de texto Hunyuan gratuitos, além de cem mil créditos para geração de imagens, visando reduzir a barreira de entrada para aplicações inteligentes no lado do cliente. Ao diminuir os custos de API e simplificar o acesso a modelos de fundação, a Tencent pretende acelerar a adoção de recursos de IA em Mini Programas do WeChat, ao mesmo tempo que reduz a carga de infraestrutura para os desenvolvedores. Atualmente, as plataformas de IA distribuem cargas de trabalho intensivas em processamento por ambientes de nuvem de terceiros confiáveis, tornando o consentimento explícito do usuário e o roteamento transparente essenciais. À medida que essas plataformas gerenciam solicitações generativas mais complexas em infraestruturas externas, caminhos de verificação multinuvem seguros tornaram-se cruciais para preservar a confiança do usuário.
Por que os Mini Programas de IA do WeChat estão entrando em uma fase de adoção em massa
Em resumo
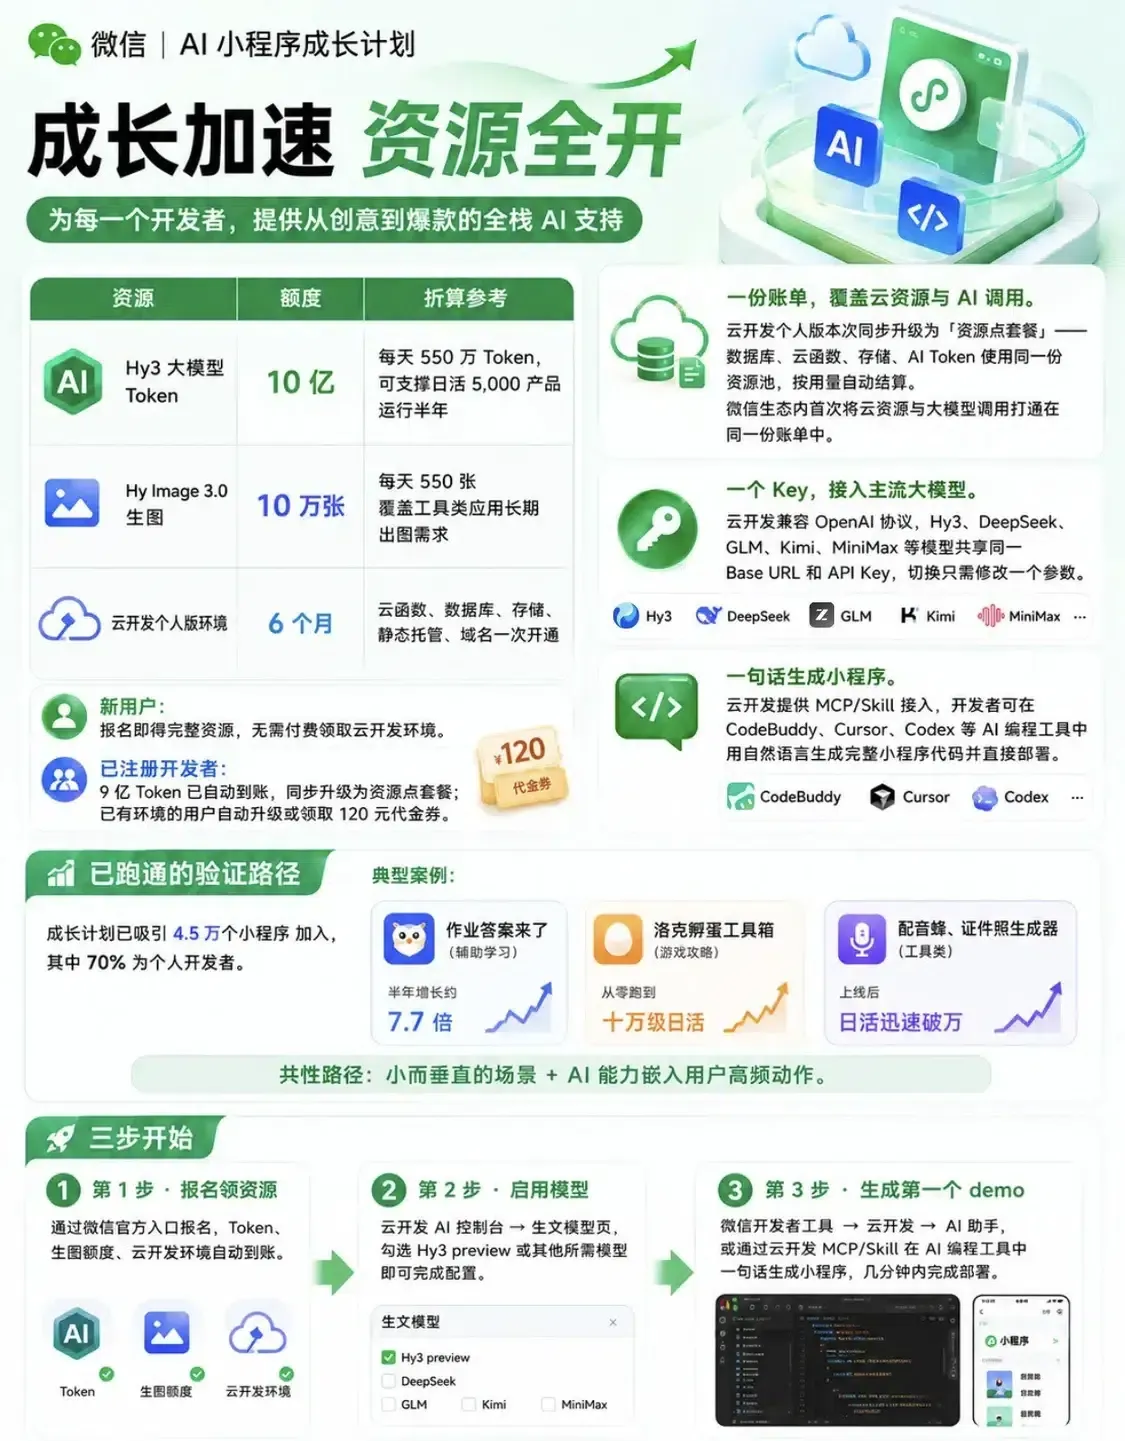
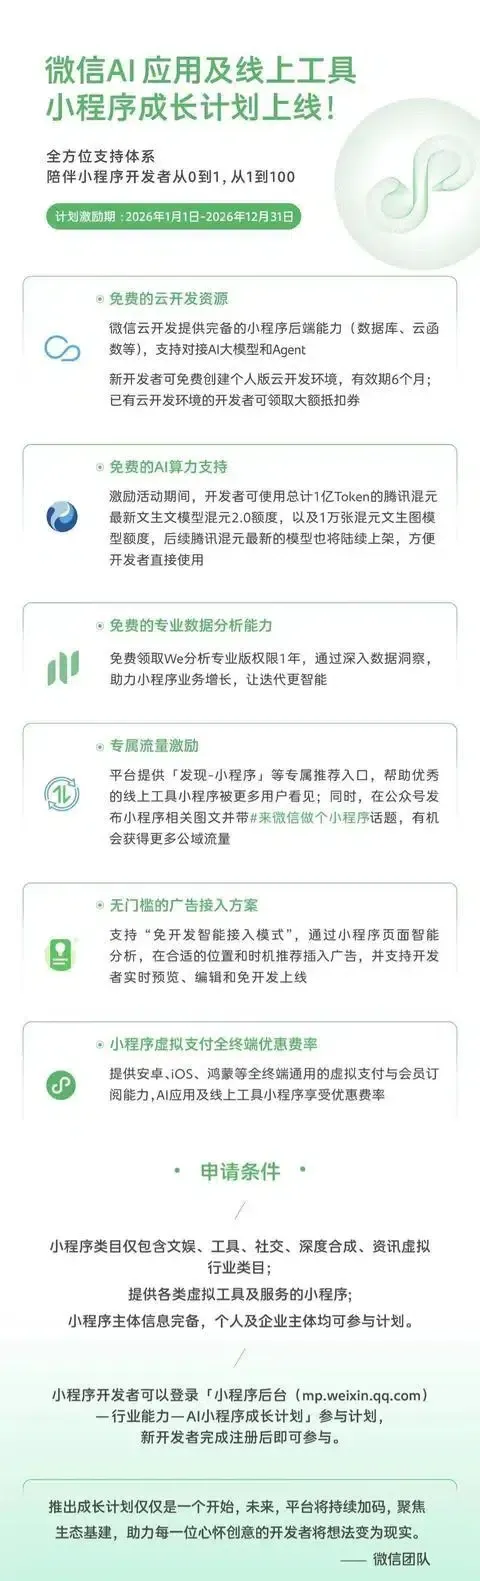
- O programa para desenvolvedores da Tencent amplia a cota básica para dez vezes o nível anterior, oferecendo um bilhão de tokens de texto e cem mil criações de imagem em um período de seis meses.
- Todos os setores podem se candidatar sem restrições de categorias, permitindo que contas pessoais de desenvolvedores solicitem recursos juntamente com entidades empresariais verificadas.
- Endpoints atualizados fazem a transição automática de projetos existentes para modelos de raciocínio modernos, simplificando a manutenção de código em nós serverless.
O cenário de microaplicações descentralizadas está passando por uma mudança operacional importante. Historicamente, integrar capacidades de redes neurais em larga escala em aplicações leves no lado do cliente exigia capital inicial e infraestrutura técnica significativos. Pequenas equipes e desenvolvedores individuais precisavam negociar gateways de API complexos, gerenciar faturamentos pesados e configurar chaves complicadas. Essas barreiras técnicas frequentemente desencorajavam a criação de recursos generativos avançados, resultando em produtos simples baseados em regras.
Desenvolvedores que criam Mini Programas de IA do WeChat agora podem registrar contas pessoais sem necessidade de autenticação empresarial formal. Ao introduzir recursos substanciais de tokens gratuitos, a operadora da plataforma está removendo esses gargalos financeiros. Desenvolvedores que estabelecem um ambiente serverless seguindo os guias oficiais da plataforma podem configurar modelos imediatamente usando o SDK de nuvem padrão. O pacote de recursos inclui uma atualização automática para o recém-lançado modelo generativo Tencent Hunyuan, permitindo que aplicações produzam imagens personalizadas e realizem interações profundas de texto sem middleware externo.
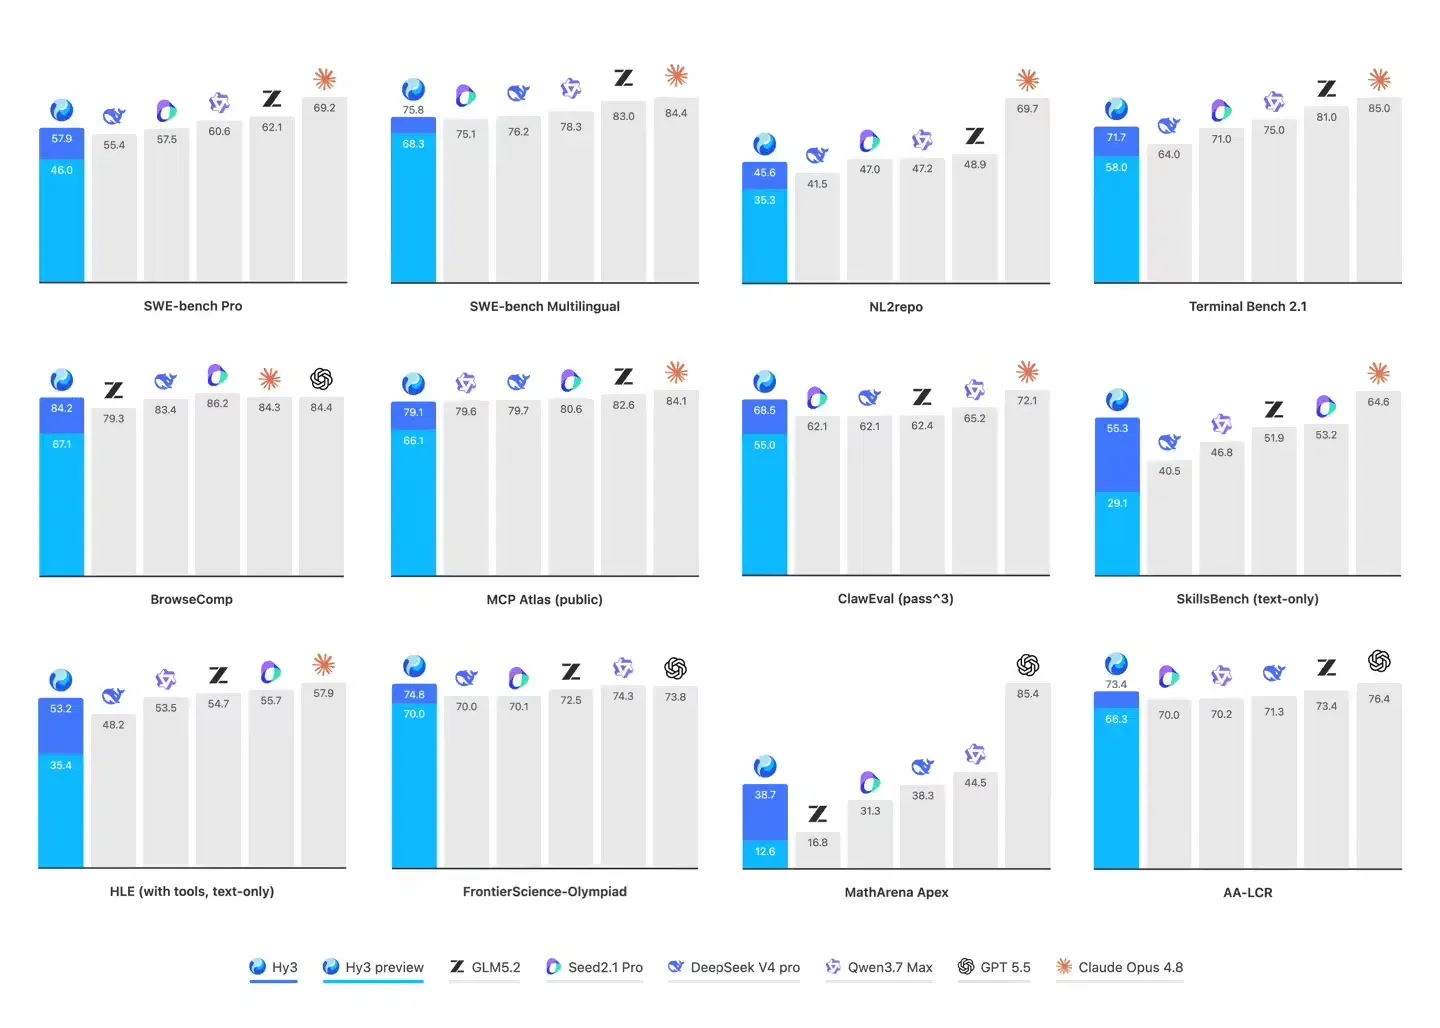
A iniciativa dos Mini Programas de IA do WeChat estabelece um caminho confiável para integrar recursos de nuvem com aplicações no lado do cliente. Sob esta estrutura atualizada, a plataforma oferece compatibilidade retroativa automática para aplicações legadas, migrando conexões ativas para os endpoints atualizados. Nenhuma configuração manual de ambiente é necessária para acessar os recursos modernos. Ao oferecer essas alocações substanciais, o programa garante que os desenvolvedores possam focar na experiência do produto e nos funis de conversão, em vez de monitorar medidores de uso em tempo real.
Análise Técnica: Deconstruindo o CloudBase MCP e Fluxos de Trabalho de IA Serverless
No nível do sistema, implementar o processamento de modelos no lado do servidor dentro de ambientes de mensagens isolados exige conexões altamente seguras e compatíveis com normas. Implantar Mini Programas de IA do WeChat usando o Protocolo de Contexto de Modelo (MCP) permite que desenvolvedores se comuniquem com segurança com backends serverless. Ao utilizar o MCP, desenvolvedores podem conectar com segurança ambientes de desenvolvimento integrados padrão à plataforma de nuvem, permitindo a implantação automatizada de código e a configuração de recursos diretamente por meio de prompts em linguagem natural.
Essas integrações são configuradas via wrappers de API padrão, permitindo transições de dados seguras entre ambientes locais e redes de nuvem, conforme detalhado na documentação de acesso à API oficial. Nesse modelo, o sistema executa chamadas no lado do servidor dentro de sandboxes isoladas para proteger credenciais voltadas ao usuário contra interceptação externa, estabelecendo efetivamente um protocolo seguro para implantações de Mini Programas de IA do WeChat.
Distinção Técnica: Endpoints Serverless vs. Processamento de Contexto Local
Sob a perspectiva de arquitetura, a execução de API serverless difere significativamente do processamento local padrão. Quando uma aplicação utiliza funções em nuvem para executar consultas de modelo, ela descarrega cálculos neurais pesados do CPU do terminal para contêineres elásticos remotos. No entanto, essa abordagem híbrida requer um tratamento cuidadoso de solicitações para evitar excesso de prompts e picos de latência.
O diagrama abaixo ilustra o fluxo típico de um loop de execução em nuvem integrado:
[IDE do Desenvolvedor] ──(Prompt em Linguagem Natural)──> [Servidor CloudBase MCP]
                                                     │
                                                     ▼
[Mini Programa WeChat] ──(Chamada de API: SDK de Servidor) ──> [Função Cloud Serverless] ──> [Motor Hunyuan Hy3]
Quando uma função em nuvem aciona uma solicitação de inferência, ela transmite o prompt do usuário juntamente com conjuntos de instruções do sistema para o cluster do modelo Tencent Hunyuan. Para evitar o consumo desnecessário de recursos, a camada serverless deve processar dados de forma efêmera, garantindo que a memória seja otimizada para solicitações de alta concorrência. Desafios semelhantes na otimização de economia de tokens e gerenciamento de recursos de runtime existem na análise móvel, onde estruturas de passagem de parâmetros leves também eliminam consultas redundantes na camada de rede. Ao otimizar os caminhos de transição de dados na camada de API, as equipes de desenvolvimento podem escalar recursos interativos sem atingir os limites de tempo limite do servidor.
Construir vs. Comprar: Gerenciando a Integração no Lado do Servidor e Alocação de Computação
À medida que plataformas incentivam o desenvolvimento rápido de aplicações de IA no lado do cliente, o gerenciamento de estruturas de computação em ambientes de nuvem distribuídos tornou-se uma decisão de engenharia primordial. Suportar pipelines de roteamento de alto rendimento para Mini Programas de IA do WeChat exige arquiteturas que possam correlacionar com segurança as ações do usuário sem depender de contêineres de armazenamento local. Desenvolvedores devem decidir entre construir ambientes de hospedagem personalizados para modelos de código aberto ou adquirir serviços em nuvem padronizados e pré-configurados.
Avaliação Arquitetônica: Modelos Personalizados Auto-hospedados vs. SDKs Padronizados
Construir um sistema de hospedagem de modelos interno em infraestrutura de servidor privada oferece personalização total, mas exige recursos contínuos massivos de capital e manutenção. Desenvolvedores devem gerenciar manualmente o provisionamento de GPU, implementar regras de escala e configurar certificados de segurança complexos. Por outro lado, utilizar um serviço de API em nuvem gerenciado, alimentado por endpoints de raciocínio Hunyuan, elimina essa complexidade de backend, garantindo custos de execução previsíveis e escalabilidade automática.
A tabela abaixo avalia estratégias de implantação padrão para pipelines de dados de alto desempenho:
| Solução | Gerenciamento de Contexto | Escalabilidade | Ideal para |
|---|---|---|---|
| Infraestrutura de IA Auto-hospedada | Controle Total de Memória | Requer Balanceamento de Carga Manual | Grandes projetos empresariais que necessitam de isolamento extremo de parâmetros e dados |
| Modelos de Código Aberto Auto-gerenciados | Persistência Efêmera/Local | Limitada pelo Hardware do Host | Prototipagem em pequena escala e avaliação em ambiente de sandbox offline |
| IA Gerenciada Tencent CloudBase | Continuidade de Sessão (via OpoInstall) | Contêineres Elásticos Automáticos | Aplicações móveis de alta concorrência e atribuição de campanhas multiplataforma |
Embora configurações de banco de dados personalizadas possam lidar com o contexto básico, a preservação de estado especializada no lado do servidor pode otimizar os recursos de desenvolvimento. Dependendo dos requisitos de implementação, organizações podem construir seu próprio sistema de gerenciamento de sessão no lado do servidor ou adotar plataformas comerciais como o OpoInstall. Por exemplo, o OpoInstall oferece restauração de estado no lado do servidor e frameworks de passagem de parâmetros, mapeando metadados de sessão para um banco de dados de sessão no servidor para manter a continuidade de sessão anonimamente sob condições de dados de alto rendimento, suportando o processamento de solicitações no lado do servidor escalável sob condições de alta concorrência. Ao mapear metadados de sessão para um banco de dados centralizado em vez de depender de redirecionamentos baseados em navegador, tal sistema garante que os contextos de conversão permaneçam consistentes mesmo quando as tarefas iniciais são executadas anonimamente. As equipes de engenharia podem avaliar essas abordagens para equilibrar a proteção de dados e a consistência da medição.
Checklists de Integração: Otimizando Implantações de IA Serverless
Para garantir a continuidade dos dados à medida que os usuários transitam entre ferramentas hospedadas na plataforma e ambientes de aplicação nativos, as equipes de desenvolvimento devem implementar fluxos de trabalho robustos de preservação de estado. Implantar e manter Mini Programas de IA do WeChat exige uma abordagem estruturada para gerenciar as métricas de uso da API.
[Estágio de Alocação]
  Console do Desenvolvedor ──> Distribuição de Tokens ──> Verificação de Limite (Avisos de 80% / 90%)
                                                     │
                                                     ▼
[Estágio de Roteamento]
  Solicitação Recebida ──> Validação de Assinatura ──> Cache de Sessão Ativa ──> Execução do Modelo
Checklist de Implementação para Desenvolvedores
- Auditar Perfis de Uso de Token: Configure telemetria local para registrar tamanhos de prompts e métricas de tokens de resposta.
- Implementar Handshakes de Sessão Stateless: Transicione as dependências do sistema para a restauração do estado de sessão no lado do servidor, utilizando tokens assinados para transmitir dados entre plataformas.
- Adotar Estratégias de Redução de Prompts: Otimize os prompts do sistema e restrinja as mensagens históricas para evitar o esgotamento do orçamento de tokens.
Checklist de Estratégia de Produto e Crescimento
- Monitorar Cotas Consumidas: Estabeleça alertas automatizados quando o uso de tokens cruzar limites específicos (ex: 80% ou 90%).
- Atualizar Endpoints de Modelos Legados: Faça a transição das configurações de cliente existentes para endpoints de raciocínio atualizados (como o
hy3) antes da descontinuação. - Otimizar Loops de Referência Móvel: Implemente a passagem de parâmetros unificada no lado do servidor para vincular ações de micro-programas com experiências de aplicações nativas.
Ao estabelecer essas diretrizes estruturadas, as equipes de desenvolvimento podem migrar suas aplicações para arquiteturas mais seguras e compatíveis, mantendo a continuidade operacional.
Perguntas Frequentes (FAQ)
Como os desenvolvedores podem solicitar o 1 bilhão de tokens de texto Hunyuan gratuitos?
Quais são as principais atualizações técnicas incluídas na transição Hy3?
Como o CloudBase MCP conecta ferramentas de IA às funções serverless do WeChat?
Principais Conclusões para Equipes de Engenharia
À medida que as plataformas de IA dependem cada vez mais da inferência em nuvem híbrida, os desenvolvedores precisam redesenhar produtos com foco em privacidade, consentimento transparente e roteamento seguro de dados. Arquiteturas de dados em evolução exigem uma mudança fundamental na forma como construímos e medimos experiências digitais. Como proxies stateless e scrapers headless tornam-se consumidores padrão de conteúdo web, os modelos tradicionais de atribuição no lado do cliente continuarão a degradar. Confiar apenas em cookies padrão e referrers não é mais suficiente para proteger os pipelines de dados que impulsionam a aquisição de usuários.
À medida que a Tencent expande o acesso aos modelos Hunyuan por meio do CloudBase e Mini Programas do WeChat, os desenvolvedores que otimizarem o uso de tokens, adotarem implantação serverless e projetarem fluxos de trabalho de IA eficientes estarão melhor posicionados para criar aplicações de IA escaláveis com custos operacionais menores.
Share this article



