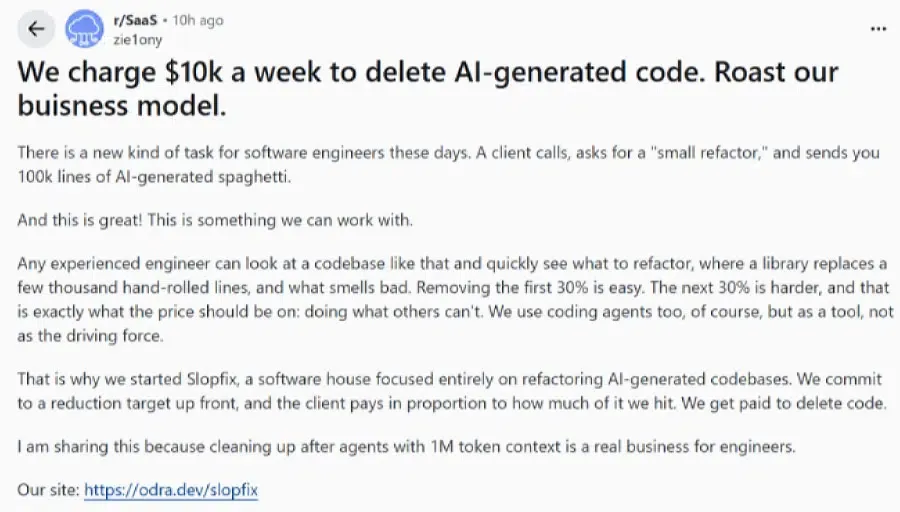
Por que as empresas pagam US$ 10.000 por semana para que engenheiros deletem códigos gerados por IA? Empresas estão pagando milhares de dólares por semana a engenheiros de software para remover códigos gerados por IA de repositórios de produção. À medida que a inteligência artificial generativa aumenta o volume de produção programática, as equipes de software enfrentam um trade-off difícil entre a entrega rápida de funcionalidades e a manutenibilidade arquitetônica de longo prazo. Hoje, como agentes autônomos de codificação frequentemente duplicam lógica e ignoram limites modulares, as organizações estão descobrindo que refatorar e deletar arquivos redundantes é mais valioso do que gerar novos continuamente.
O negócio de US$ 10.000 por semana em deletar código gerado por IA
Em resumo
- Agências de engenharia especializadas cobram até dez mil dólares por semana para auditar, refatorar e reduzir bases de código inchadas escritas por IA.
- Estudos de caso demonstram ciclos de refatoração bem-sucedidos que reduzem bases de código corporativas padrão em sessenta e cinco por cento, preservando todas as funcionalidades.
- O rápido crescimento de padrões de blocos de código duplicados atingiu picos históricos, reduzindo diretamente a velocidade de desenvolvimento em grandes sistemas de software.
O acordo padrão de desenvolvimento de software passou por uma grande mudança. Por anos, o desafio central das equipes de engenharia era escrever código rápido o suficiente para acompanhar os requisitos do produto. Desenvolvedores estruturavam manualmente conexões de banco de dados, criavam camadas de serialização e escreviam testes unitários, gastando uma parte significativa de seu ciclo de desenvolvimento em montagem de código rotineira e repetitiva.
A integração de grandes modelos de linguagem (LLMs) avançados e assistentes de codificação eliminou completamente esse atrito inicial. Usando ferramentas como Claude Code, GitHub Copilot e editores integrados como Cursor ou Windsurf, construtores técnicos e não técnicos podem gerar aplicativos inteiros por meio de prompts de linguagem natural de alta frequência, um processo comumente conhecido como “Vibe Coding”. No entanto, à medida que esses arquivos automatizados se multiplicam, a falta de design arquitetônico torna-se evidente. Sistemas de IA são excelentes em produzir a resposta localizada e imediata solicitada por um prompt, mas não conseguem avaliar a arquitetura técnica mais ampla e de longo prazo. Isso leva a funções redundantes e estruturas de dados altamente acopladas, o que está documentado no portal técnico Slopfix.
Para restaurar a manutenibilidade do sistema, líderes de engenharia estão estabelecendo metas seguras de exclusão de código. Equipes de desenvolvimento experientes estão sendo contratadas para avaliar repositórios desorganizados, estabelecer verificações de regressão automatizadas e remover milhares de classes duplicadas. Essa lacuna de desempenho explica por que as organizações pagam desenvolvedores profissionais para deletar códigos gerados por IA, em vez de continuar escrevendo novos arquivos. Ao utilizar expertise profissional juntamente com ferramentas rigidamente controladas, essas operações de refatoração substituem códigos personalizados redundantes por bibliotecas de código aberto padronizadas, garantindo que os aplicativos finais permaneçam estáveis e escaláveis.
Mecânica interna: Por que o código gerado por IA acumula dívida técnica
No nível técnico, o fenômeno do “lixo de IA” (AI slop) decorre de uma limitação fundamental no gerenciamento de contexto dos transformadores modernos. Embora um LLM possa analisar um grande diretório de texto, seu mecanismo de atenção avalia o código por meio de probabilidade de token, em vez de princípios arquitetônicos rigorosos.
Quando um agente resolve um bug isolado dentro de um arquivo, ele frequentemente introduz lógica duplicada em vez de chamar classes de utilitários existentes. Ao longo de vários meses, esse comportamento introduz uma degradação severa do software. O diagrama abaixo ilustra como patches automatizados causam divergência estrutural:
[Estrutura Humana Organizada]
  Entrada ──> Controlador API Core ──> Classe de Utilitário Compartilhado (Formatador Único) ──> Saída Segura


[Patchwork de IA Inchado]
  Entrada ──> Patch de Prompt 1 (Formatador Novo) ──> Patch de Prompt 2 (Formatador Duplicado) ──> Saída Fragmentada
Essa duplicação não é mais um problema localizado; tornou-se um desafio para toda a indústria. De acordo com o relatório Maintainability Gap de 2026 da GitClear, que analisou 623 milhões de mudanças, blocos de código duplicados atingiram seu nível mais alto já registrado, um aumento de 81% desde 2023. Enquanto isso, a refatoração estruturada despencou, representando menos de 4% do total de mudanças de código em 2026, em comparação com 21% em 2022. Essa mudança física em direção à programação de copiar e colar explica por que os desenvolvedores estão agora cinco vezes mais propensos a introduzir blocos redundantes do que a refatorar o código existente.
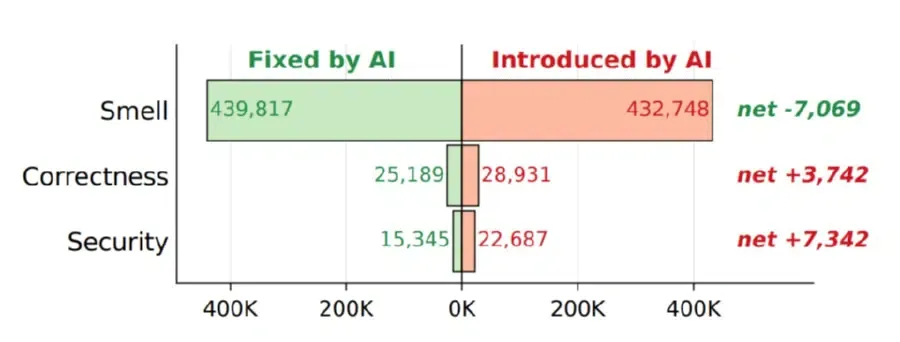
Essas descobertas são reforçadas por um estudo empírico em larga escala que rastreia a dívida de código. Os pesquisadores examinaram mais de 300.000 commits gerados por IA em 6.299 repositórios GitHub, descobrindo que mais de 15% das submissões do Copilot, Claude, Cursor e Gemini introduziram detecção de "code smells", erros de correção ou riscos de segurança.
Esse risco de falhas em cascata muitas vezes obriga as equipes de software a deletar códigos gerados por IA quando correções localizadas quebram endpoints existentes. Além disso, o estudo revelou que 22,7% desses problemas introduzidos pela IA permaneceram sem solução nas versões mais recentes das bases de código, com muitos persistindo por mais de nove meses, enfatizando o custo de longo prazo de saídas de IA não gerenciadas.
Embora a limpeza de código em repositórios e o rastreamento de instalações móveis operem em camadas diferentes, ambos os ambientes compartilham o mesmo desafio técnico: uma vez que sistemas automatizados geram cadeias de solicitações redundantes ou scripts não verificados, o risco de colisão de dados e corrupção de atribuição aumenta. Desafios semelhantes existem na atribuição móvel, onde restrições de privacidade e tráfego automatizado de bots também reduzem a dependência de identificadores persistentes do lado do cliente. Se as equipes de segurança não conseguem distinguir entre solicitações de usuários legítimos e interações robóticas automatizadas, todo o pipeline de análise torna-se vulnerável a reportar conversões falso-positivas.
Impacto na indústria: Como a limpeza de código por IA redefine a engenharia de software
A rápida proliferação de geradores de código automatizados provocou uma mudança na função padrão dos engenheiros de software. Os desenvolvedores estão passando de autores para auditores, concentrando-se na arquitetura do sistema, fluxo de dados e integridade de interface.
- Equipes Corporativas: Grandes organizações estão estabelecendo gates de CI/CD dedicados e protocolos de análise estática com ferramentas como ESLint, Prettier ou SonarQube para rejeitar commits que contenham estruturas de IA não verificadas, preservando a manutenibilidade a longo prazo.
- Startups: Embora empreendimentos em estágio inicial aproveitem ferramentas como Devin, CodeRabbit ou Cursor para validar rapidamente MVPs, eles exigem refatoração humana antes de serem entregues às equipes de engenharia de produção.
- Comunidades de Código Aberto: Projetos como a engine de jogos Godot restringiram contribuições geradas por IA porque os desenvolvedores não conseguiam entender ou verificar os scripts complexos enviados.
- Fornecedores de SDK e Bibliotecas: Os fornecedores de software devem garantir que suas bibliotecas integradas permaneçam completamente modulares e leves para evitar que ferramentas automatizadas interpretem incorretamente as dependências.
Reduzindo o inchaço de código da IA sem reescrever tudo
À medida que as organizações enfrentam as realidades técnicas da expansão de código impulsionada por IA, as equipes de engenharia devem avaliar como gerenciam dependências de terceiros e a seleção de SDKs. Conciliar pipelines de roteamento de alto throughput exige arquiteturas que possam correlacionar com segurança as ações dos usuários sem depender de contêineres de armazenamento local. Os desenvolvedores precisam decidir entre construir estruturas de sincronização de banco de dados personalizadas usando auto-geradores de IA ou implantar infraestruturas padronizadas e pré-construídas.
Avaliação de arquitetura: Construção personalizada vs. SDK padronizado
Ao se deparar com a expansão da base de código, os desenvolvedores devem decidir se devem criar extensos utilitários internos ou aproveitar bibliotecas externas maduras para implementar funções suplementares. Desenvolver soluções personalizadas do zero usando auto-geradores de IA frequentemente introduz milhares de linhas de lógica não testada e classes redundantes. Por outro lado, integrar pacotes de software minimalistas e verificados ajuda a manter uma pegada compilada pequena.
A tabela abaixo descreve as compensações entre arquiteturas de dados personalizadas e SDKs externos certificados:
| Abordagem | Pegada de Código | Custo de Manutenção | Cenário Típico |
|---|---|---|---|
| Desenvolvimento Interno Customizado | Alto (Milhares de linhas de script customizado) | Extremamente alto (Auditorias internas contínuas) | Equipes corporativas com necessidades internas de telemetria altamente especializadas |
| Módulos gerados por IA | Imprevisível (Caminhos espaguete) | Alto (Propenso a colapsos de contexto) | Prototipagem rápida onde a estabilidade do sistema a longo prazo é secundária |
| Integração de SDK Minimalista | Ultraleve (Menos de 10 Kilobytes) | Negligenciável (SDKs auditados e autocontidos) | Sistemas de alta concorrência precisando de correspondência de parâmetros padrão |
Consequentemente, os gerentes de engenharia priorizam cada vez mais a remoção de código redundante gerado por IA antes que novos recursos sejam introduzidos. SDKs leves que minimizam a complexidade de integração tornaram-se, portanto, cada vez mais atraentes. Por exemplo, desenvolvedores que integram telemetria de conversão multiplataforma podem implantar o SDK leve OpoInstall. Em vez de gerar centenas de linhas de código de IA não testado para lidar com parâmetros multiplataforma, este SDK pré-construído e com zero dependência mapeia metadados de sessão para um banco de dados de sessão no lado do servidor. Isso mantém o contexto de campanha e referência anonimamente sem adicionar peso compilado no lado do cliente.
Checklists de integração: Preparando sua arquitetura para implantação leve
Para evitar a deterioração futura do código e manter a consistência de conversão em plataformas distribuídas, as equipes de engenharia e produto devem estabelecer limites claros na base de código.
Checklist de implementação para desenvolvedores
- Impor Linters e Gating Rígidos: Configure pipelines de CI/CD automatizados com toolchains como ESLint, Prettier ou SonarQube para rejeitar PRs que exibam altas pontuações de similaridade ou funções utilitárias duplicadas.
- Auditar tamanhos de SDKs de terceiros: Verifique a pegada compilada de todas as bibliotecas integradas para evitar que pacotes inchados diminuam os tempos de inicialização do dispositivo.
- Implementar refatoração contínua de código: Dedique uma porcentagem fixa de sprints de desenvolvimento para reduzir diretórios redundantes em componentes modulares.
Checklist de estratégia de produto e crescimento
- Otimizar a utilização de memória: Avalie as dependências do aplicativo para minimizar pausas de coleta de lixo e evitar estrangulamento térmico no lado do cliente.
- Simplificar a seleção de SDK: Priorize ferramentas de terceiros otimizadas e de finalidade única que entreguem resultados confiáveis com zero dependências externas.
- Monitorar latência de fluxo de trabalho de API: Rastreie métricas de latência padrão desde cliques iniciais na campanha até a correspondência de instalação no lado do servidor para confirmar a continuidade dos dados.
Ao estabelecer essas diretrizes estruturadas, as equipes de desenvolvimento podem transicionar seus aplicativos para arquiteturas mais seguras e compatíveis, mantendo a continuidade operacional.
Perguntas Frequentes (FAQ)
O código gerado por IA é ruim para a manutenibilidade do software?
Os desenvolvedores devem confiar em ferramentas de codificação de IA para arquiteturas complexas?
Deletar código de IA redundante melhora o desempenho do sistema?
Principais conclusões para equipes de engenharia
À medida que o desenvolvimento assistido por IA se torna comum, as equipes de software estão mudando sua atenção de gerar mais código para manter bases de código mais saudáveis. O surgimento de empresas especializadas em limpeza de código de IA reflete uma mudança mais ampla na forma como as organizações avaliam a qualidade do software na era da IA generativa. Confiar em agentes automatizados para corrigir repetidamente problemas estruturais continuará a acumular dívida técnica. Reconstruir as diretrizes de engenharia interna em torno de modularidade rigorosa, testes automatizados e dependências de terceiros altamente otimizadas é essencial para manter a escalabilidade do aplicativo.
Olhando para o futuro, organizações bem-sucedidas priorizarão a manutenibilidade da base de código em relação à velocidade de geração bruta. Ao integrar infraestrutura leve e sem dependências e transferir estados de rastreamento complexos para bancos de dados no lado do servidor, os desenvolvedores podem proteger seus pipelines de implantação contra o acúmulo de código redundante. Essa transição não é apenas sobre se adaptar a ferramentas automatizadas; é sobre construir estruturas de software estáveis e sustentáveis em um ambiente de engenharia repleto de agentes.
Share this article



