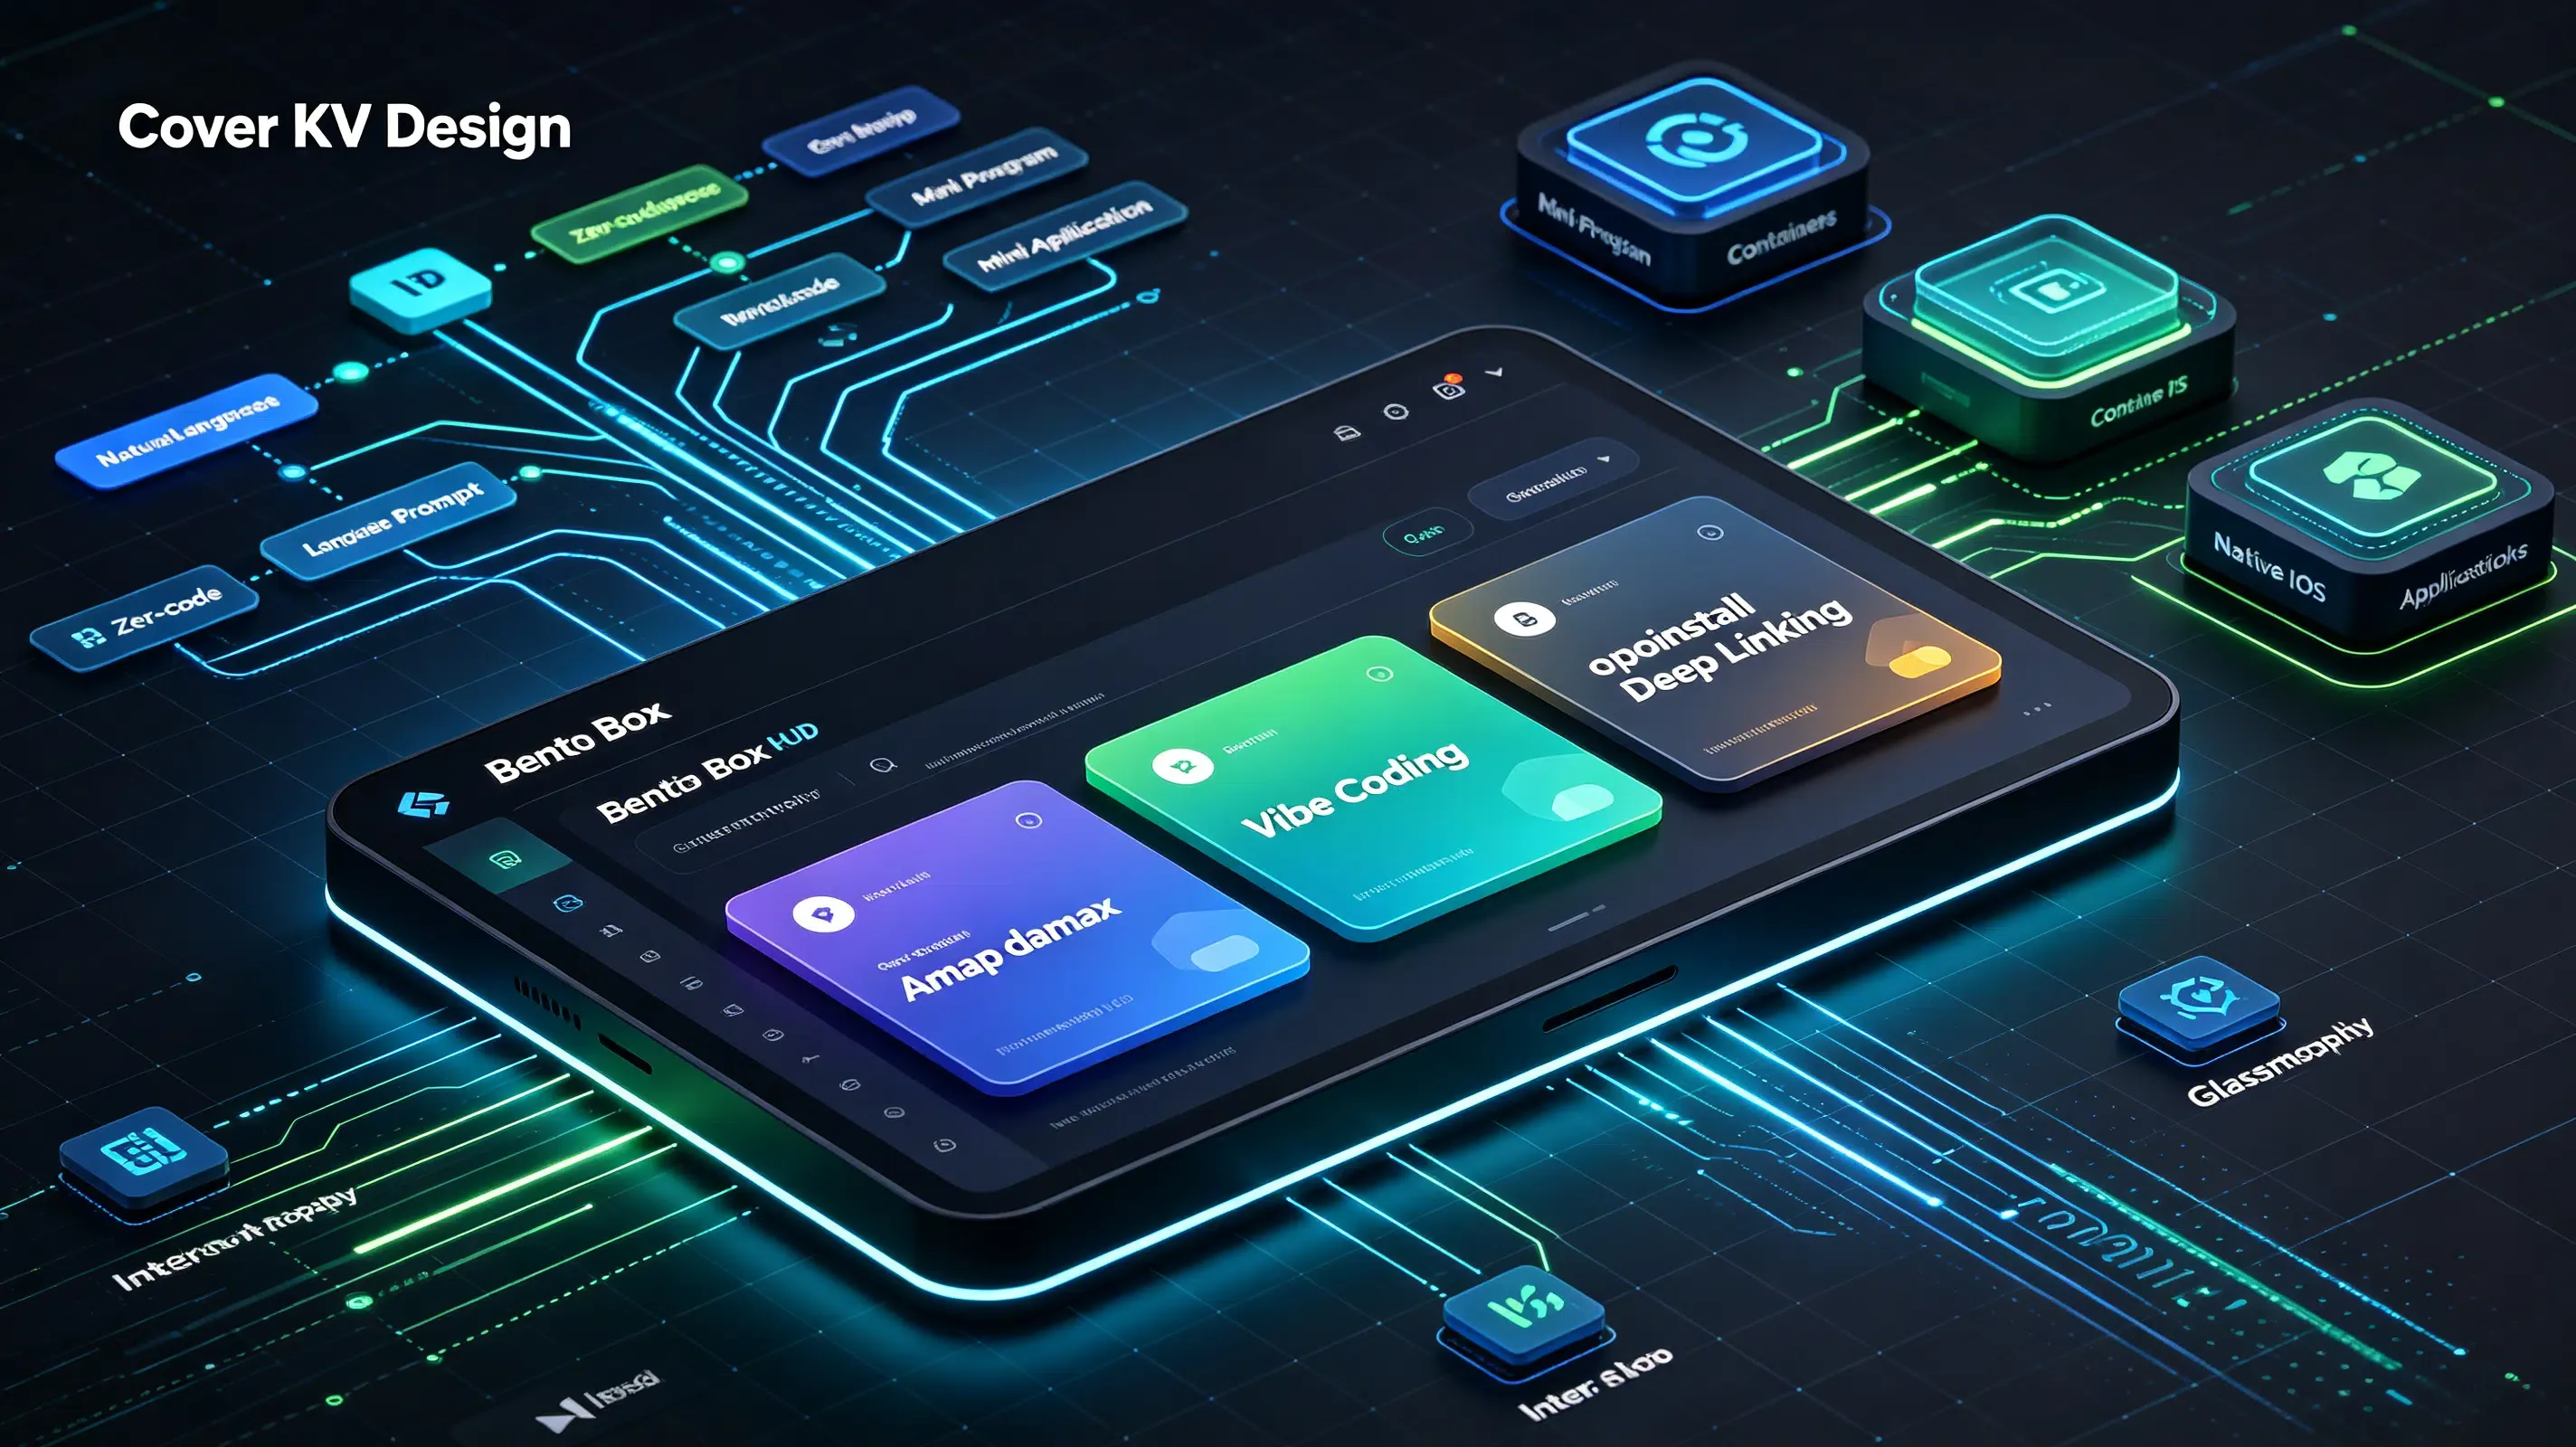
 Amap выпускает «damax»? Эта стратегическая инициатива была подтверждена, поскольку гигант картографических сервисов выходит в сферу low-code генерации, чтобы автоматизировать процесс создания приложений. 29 июня 2026 года появились подробности о «damax» (также известном как «袋马»), инструменте Vibe Coding, предназначенном для сборки мини-программ WeChat и нативных iOS-приложений напрямую из текстовых запросов на естественном языке. Для команд разработки и продакт-менеджеров эта модель быстрой генерации подчеркивает технологический переход: ИИ-ассистенты все чаще выступают в качестве программного промежуточного слоя между конечными пользователями и приложениями, сокращая необходимость в ручной настройке разработки.
Краткий обзор
- Быстрая генерация: Движок «damax» автоматизирует преобразование текстовых запросов в мини-программы WeChat и нативные сборки iOS, значительно сокращая жизненный цикл запуска продукта.
- Целевая аудитория: Решение ориентировано на владельцев малого бизнеса, независимых разработчиков и небольшие команды, не имеющие собственного инженерного департамента.
- Фрагментация контекста: Рост числа автоматически созданных приложений создает уникальные проблемы для отслеживания, восстановления сессий и сохранения глубоких ссылок (deep links) в различных платформах.
Структурная перестройка и Low-Code генерация
Инструмент для рабочего пространства «damax» был разработан и запущен компанией Beijing Amap Yuntu Technology Co., Ltd. Этот релиз выводит Amap на конкурентный рынок генерации ИИ-приложений, бросая вызов таким платформам, как Tusi от Tencent, Miada от Baidu, Qoder от Alibaba и Trae от ByteDance. Отчеты об отслеживании индустрии указывают на рост числа заявок на новые приложения, демонстрируя, как ИИ-программирование снижает барьеры для входа. Вместо вывода простых макетов система компилирует полноценное нативное ПО для iOS и мини-программы WeChat. Она генерирует QR-коды для реальных устройств, позволяя нетехническим создателям запускать и дорабатывать проекты в режиме реального времени.
Вероятно, традиционные циклы разработки уходят в прошлое по мере того, как системы без кода (zero-code) набирают обороты. Интеграция диалоговых компиляторов в экосистемы SaaS говорит о том, что крупные технологические компании отдают предпочтение автоматизированным рабочим процессам, а не поддержке клиентов вручную. Следовательно, когда Amap запускает «damax» для внутреннего бета-тестирования, это провоцирует более широкий сдвиг в сторону протоколов обмена данными, нативных для приложений. Отраслевые исследования показывают, что ИИ-рабочие процессы могут генерировать сложные многоэкранные конфигурации из простых запросов, доказывая, что ручная верстка интерфейсов становится значительным препятствием в современном корпоративном ПО.
SaaS-провайдеры быстро перестраиваются, чтобы избежать устаревания. Команды разработчиков исследуют инфраструктуру агентских почтовых сервисов для поддержки программной обработки входящих сообщений. Развивая этот тренд автоматизации, крупные пакеты офисных приложений приобретают технологии создания агентов для выполнения сложных кросс-системных задач. Параллельно с этим корпоративные чат-платформы внедряют ИИ-ассистентов в свои нативные системы. Эта консолидация индустрии указывает на направление, где серверная интеграция становится важнее автономного настольного ПО.
Разбор протокола: как headless-скрейперы нарушают атрибуцию
Многие корпоративные почтовые шлюзы и ИИ-ассистенты автоматически проверяют входящие ссылки перед тем, как пользователь с ними взаимодействует. С точки зрения систем атрибуции это меняет всю цепочку запросов.
Когда человек нажимает на ссылку, стандартный веб-браузер загружает страницу, выполняет скрипты отслеживания и записывает cookie. Напротив, ИИ-агент переходит по ссылке программно. Он отправляет headless HTTP-запрос напрямую с облачного сервера. Поскольку запрос выполняется внутри изолированной «песочницы», здесь нет визуального DOM-дерева, истории браузера и хранилища cookie. Headless-маршрутизация часто изолирует сессию от клиентской системы. Традиционные методы атрибуции на основе браузера могут больше не захватывать весь путь пользователя, так как они полагаются на cookie для связки клика с установкой. В таких условиях точность атрибуции значительно снижается.
Традиционный путь пользователя:
Email-ссылка -> Клик -> Сессия в браузере (Cookies, DOM) -> App Store -> Установка приложения (Атрибуция прошла успешно)


Путь с использованием Headless-агента:
Email-ссылка -> Программное сканирование -> Headless HTTP-запрос (Без интерфейса, DOM и Cookies) -> Ссылка посещена
Установка (позже) -> Запуск приложения -> Пустое состояние клиента (Атрибуция потеряна)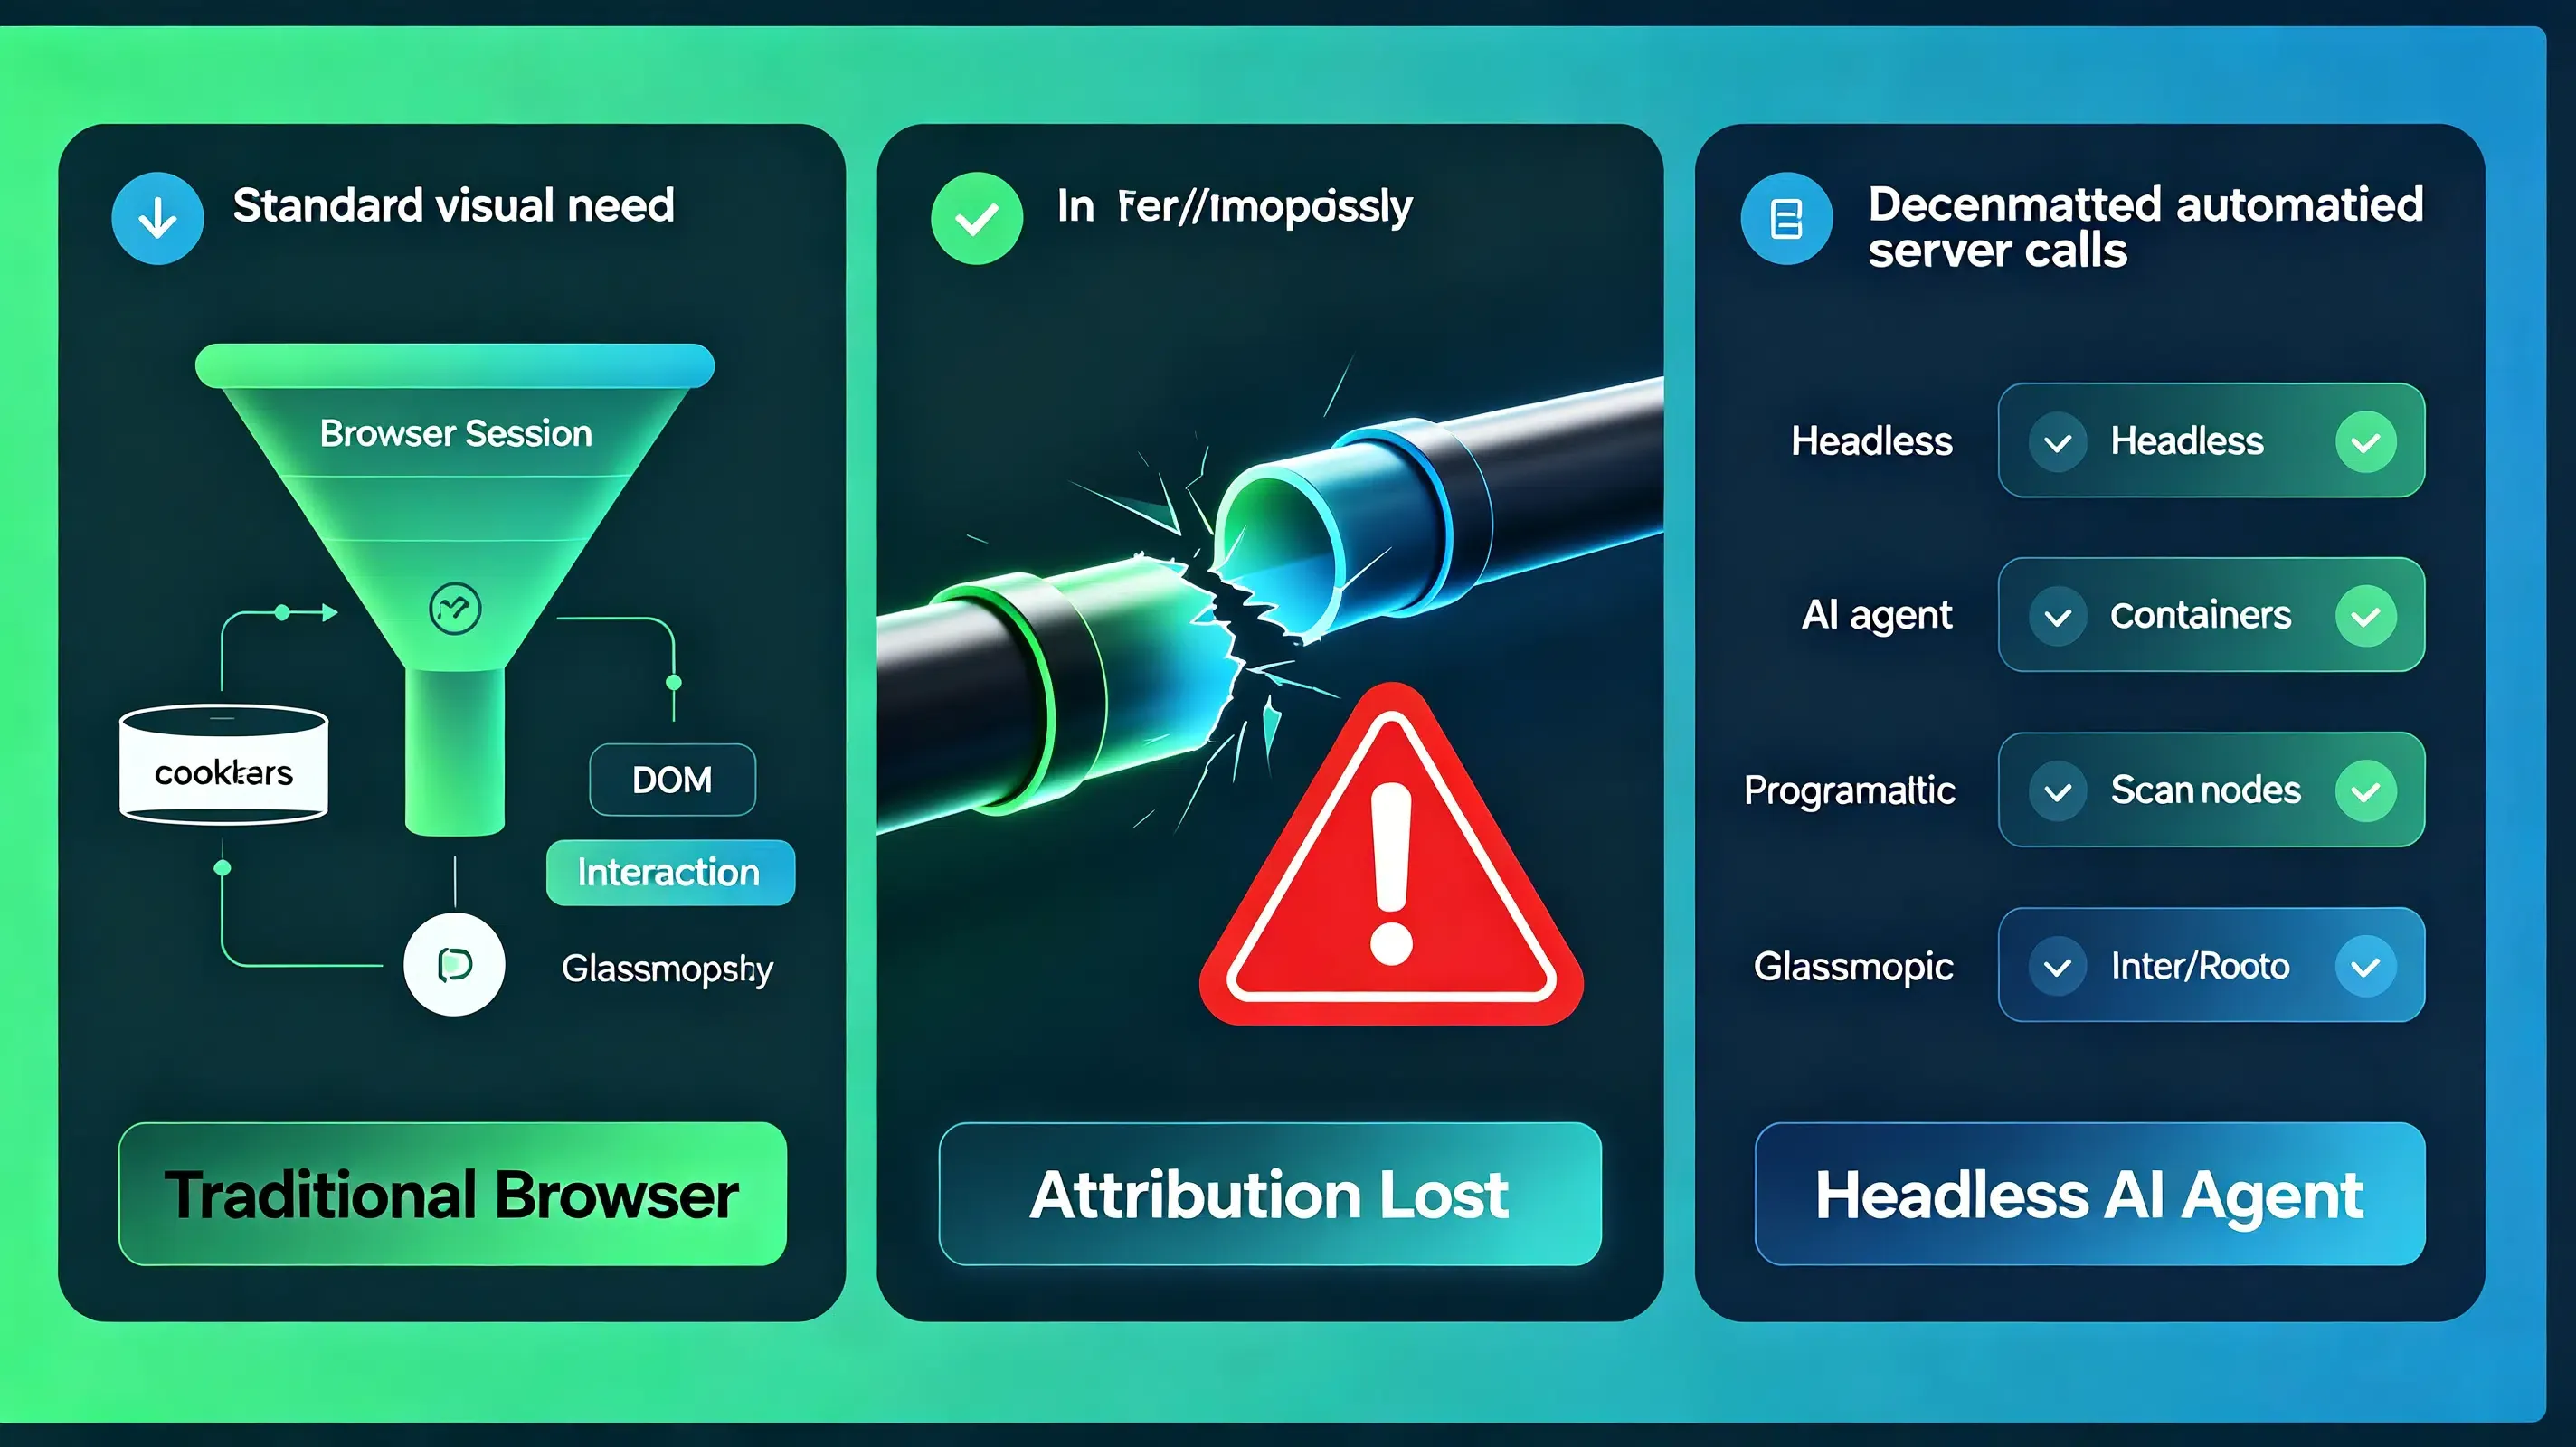
В типичной продакшн-среде разработчики часто сталкиваются с тем, что значительная часть трафика обрабатывается автоматизированными срейперами. Анализ показывает, что почтовые шлюзы безопасности или сканеры могут посещать ссылки раньше конечных пользователей. Это поведение может мешать атрибуции, если системы предполагают, что каждый запрос исходит от реального человека. В результате в некоторых случаях исходный контекст перехода может быть потерян для клиентского приложения.
Архитектурные решения: разработка или покупка готового решения для восстановления состояния
На практике инженерные команды обычно выбирают между созданием собственного контура атрибуции или интеграцией готового SDK. Создание проприетарной системы требует значительных затрат. Командам приходится создавать собственные серверные базы данных, поддерживать библиотеки сопоставления состояний устройств и постоянно обновлять логику в соответствии с меняющимися стандартами безопасности ОС. Для многих организаций стоимость обслуживания такой системы оказывается неоправданно высокой.
В качестве альтернативы разработчики обычно рассматривают несколько способов сохранения состояния сессии без использования файлов cookie:
- Собственные кастомные сервисы: Создание баз данных для сопоставления состояний на базе собственной облачной инфраструктуры.
- Платформенные инструменты: Использование базовых утилит вроде Firebase Dynamic Links (или их нативных альтернатив).
- Корпоративные MMP: Использование мобильных измерительных партнеров (Branch, AppsFlyer или Adjust) для работы с глубокими ссылками.
- Специализированные SDK для параметров: Использование узкоспециализированных инструментов для точной передачи кастомных параметров.
Сравнение потоков атрибуции
| Поток взаимодействия | Хранилище cookies | Headless-совместимость | Целостность атрибуции |
|---|---|---|---|
| Традиционный браузер | ✅ Да | ❌ Нет | Высокая (сессия на клиенте) |
| Headless ИИ-агент | ❌ Нет | ✅ Да | Низкая (потеря данных) |
| Серверная фиксация состояния | ❌ Нет | ✅ Да | Высокая (асинхронное получение) |
Генерация ссылки -> Регистрация метаданных на центральном сервере
                                     |
Скрейпер/Пользователь кликает -> Регистрация временной серверной блокировки состояния
                                     |
Запуск приложения -> Программный запрос контекста через SDK -> Сопоставление и восстановление параметров
Коммерческие реализации этой архитектуры включают Branch, AppsFlyer, Adjust, Opoinstall и другие платформы отложенной атрибуции. Эти системы поддерживают серверное состояние до установки и восстанавливают параметры при первом запуске приложения, обходя ограничения клиентских сессий. SDK Opoinstall надежно привязывает параметры перехода к централизованной базе данных, гарантируя сохранение контекста даже при первичной обработке ссылки headless-скрейпером. По мере того как Amap запускает «damax», разработчики чаще прибегают к подобным архитектурам для защиты своих пайплайнов атрибуции.
Адаптация операционных команд и чек-лист интеграции
Инженерным командам необходимо провести аудит всех активных интеграций баз данных перед запуском приложений, сгенерированных автоматически. Продакт-менеджерам следует переработать сценарии приглашений и регистрации с учетом невизуального пути пользователя. Вместо предположения, что пользователь прочитает письмо и нажмет кнопку, следует проектировать процессы, ожидающие программных триггеров. Маркетинговым командам нужно обновить метрики: когда автономный софт занимается «разогревом» трафика, показатели CTR становятся менее надежными. Операционным отделам стоит сфокусироваться на внутриприловых событиях и подтвержденных конверсиях, оптимизируя кампании на основе реальных действий внутри продукта.
Чек-лист интеграции генеративных приложений
Для обеспечения надежности данных перед запуском приложений, созданных ИИ, командам разработки следует выполнить следующие шаги:
- Проверка контекстных путей: Проверьте, как ИИ-компилятор сопоставляет кастомные URL-параметры, чтобы гарантировать сохранение deep links.
- Сохранение headless-переходов: Настройте захват реферальных параметров из HTTP-заголовков при сканировании QR-кодов или запуске мини-программ.
- Тестирование в песочнице: Убедитесь, что отчеты о данных не вызывают срабатывание антифрод-систем в тестовой среде.
- Проверка кросс-платформенной маршрутизации: Согласуйте Universal Links со схемами мини-программ WeChat, чтобы избежать трудностей при переходе между экранами.
При миграции систем разработчики часто сталкиваются с тем, что значительная часть трафика обрабатывается ботами. Анализ таких взаимодействий подтверждает, что реферальный контекст часто удаляется, что делает традиционные методы отслеживания менее эффективными в автоматизированных средах.
Часто задаваемые вопросы (FAQ)
Влияет ли «damax» от Amap на существующие магазины приложений?
Как работают автоматизированные приложения без локальных сред разработки?
Как сохранить реферальную атрибуцию, если приложения запускаются программно?
Отказ от визуального, ориентированного на человека цикла разработки подчеркивает фундаментальный сдвиг в сторону серверных протоколов связи и ИИ-рабочих процессов. Поскольку приложения все чаще общаются через автоматизированный обмен данными, а не через визуальные интерфейсы, инженерным командам необходимо пересмотреть свои стратегии интеграции. Платформы, сильно зависящие от ручных действий пользователей, могут столкнуться со структурными пробелами, когда управление запросами переходит к автоматизированным агентам. Переход к серверной атрибуции и безопасной передаче параметров является наиболее вероятным направлением для обеспечения надежного отслеживания и безопасности.
Этот переход предполагает фундаментальный пересмотр наших метрик и протоколов безопасности. Будущие системы атрибуции, скорее всего, будут в большей степени полагаться на сопоставление личности на сервере и безопасную синхронизацию состояний. По мере того как все больше ИИ-агентов начинают выступать в роли первичных потребителей цифровых коммуникаций, архитектуры атрибуции будут все чаще зависеть от идентификации на сервере, отложенного восстановления состояния и сохранения контекста на уровне протоколов, а не только от сессий браузера.
Share this article



