Apple перенаправляет AI-запросы в Google Cloud? Эта архитектура гибридного облачного делегирования знаменует собой важный сдвиг в сторону прозрачности: в iOS 27 перед отправкой определенных генеративных задач в Google Cloud система запрашивает явное согласие пользователя. Поскольку потребительские ИИ-технологии выходят за рамки моделей, работающих исключительно на устройстве, облачные вычисления становятся неотъемлемой частью современных сервисов. Сегодня ИИ-платформы все чаще распределяют ресурсоемкие задачи между доверенными сторонними облачными средами, что делает прозрачность маршрутизации и получение согласия пользователя обязательными. По мере того как эти платформы обрабатывают все более сложные генеративные запросы с использованием внешней инфраструктуры, безопасные многооблачные пути верификации становятся критически важными для сохранения доверия пользователей.
Почему Apple перенаправляет AI-запросы в Google Cloud: сочетание обязательств по конфиденциальности и масштабирования
Краткий обзор
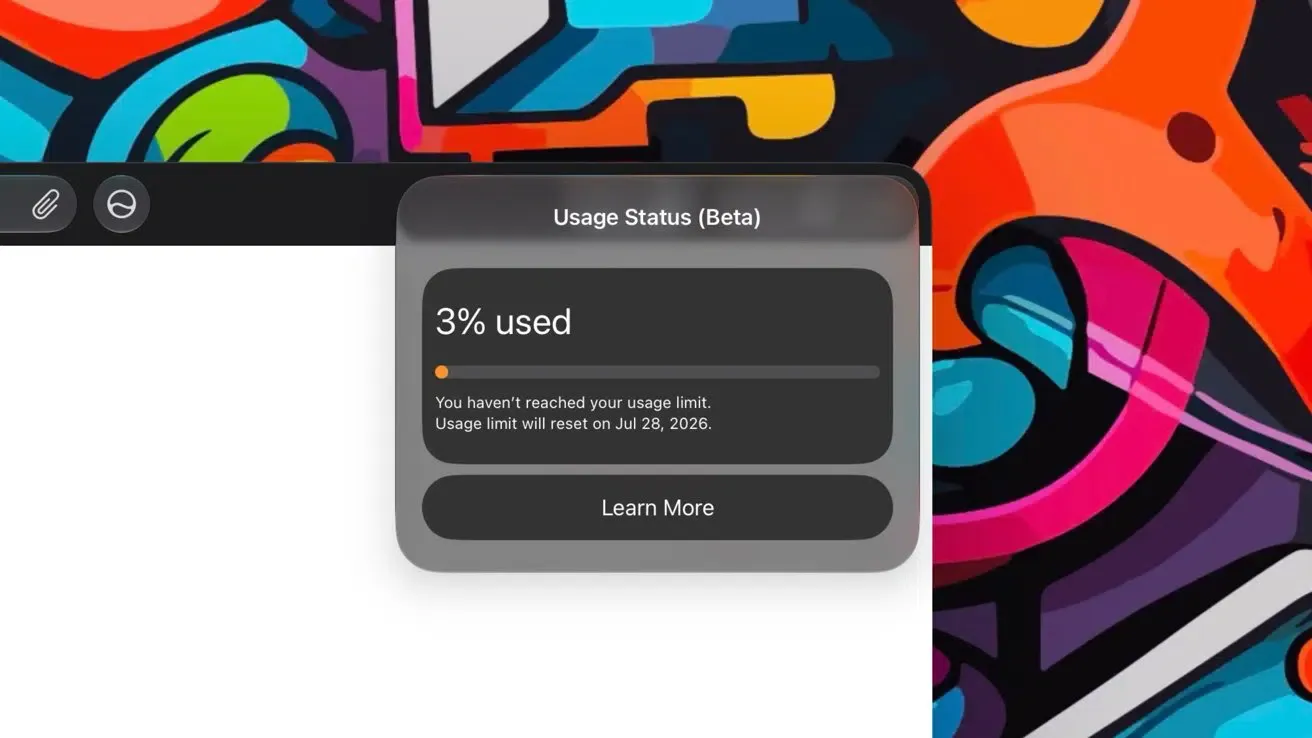
- Новые системные запросы в бета-версиях ОС предупреждают пользователей о том, что генеративные задачи направляются на сторонние серверы.
- Собственные базовые модели Apple (Foundation Models) и локальные вычисления на устройстве строго отделены от конвейеров сторонней облачной обработки.
- Расширенная архитектура внедряет паттерн гибридного облачного делегирования, используя зашифрованные изолированные «песочницы» для выполнения сложных генеративных запросов.
Дизайн современного потребительского искусственного интеллекта строится на тонком балансе между локальной обработкой и масштабируемостью облака. Когда стандартные модели на устройстве выполняют рутинные задачи, данные надежно хранятся в памяти терминала. Однако, когда требуются сложные ресурсоемкие генеративные функции (например, продвинутая генерация изображений или обработка сложных презентаций), локальное оборудование делегирует вычисления высокопроизводительным облачным кластерам. Это создает проблему потока данных: как масштабировать вычислительные возможности системы, не ставя под угрозу базовые принципы конфиденциальности?
За последние два года гибридные ИИ-архитектуры стали важной стратегией внедрения для потребительских платформ. Используя как модели на устройстве, так и сети удаленных серверов, эти сервисы могут предоставлять продвинутые генеративные возможности без перегрузки пользовательского терминала. Однако необходимость сбалансировать облачные мощности и безопасность данных сместила архитектурные приоритеты в сторону безопасных, изолированных многооблачных сред.
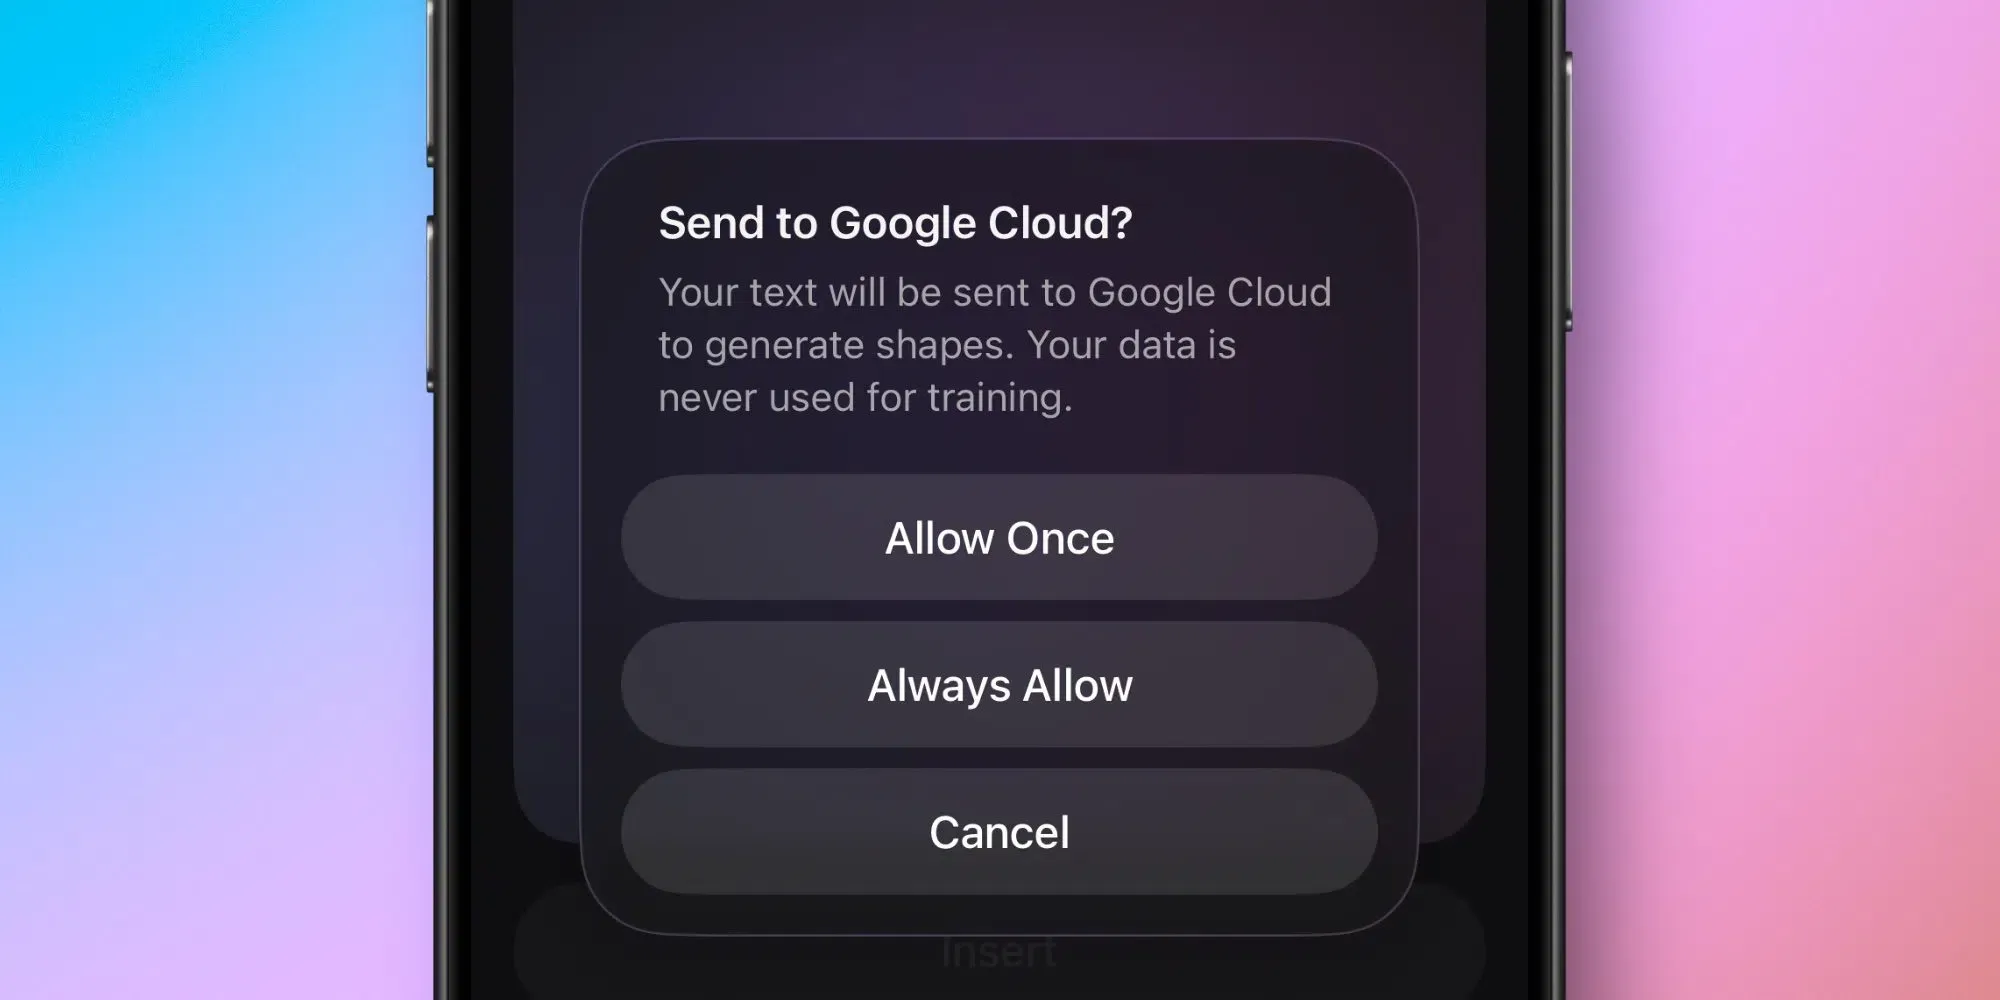
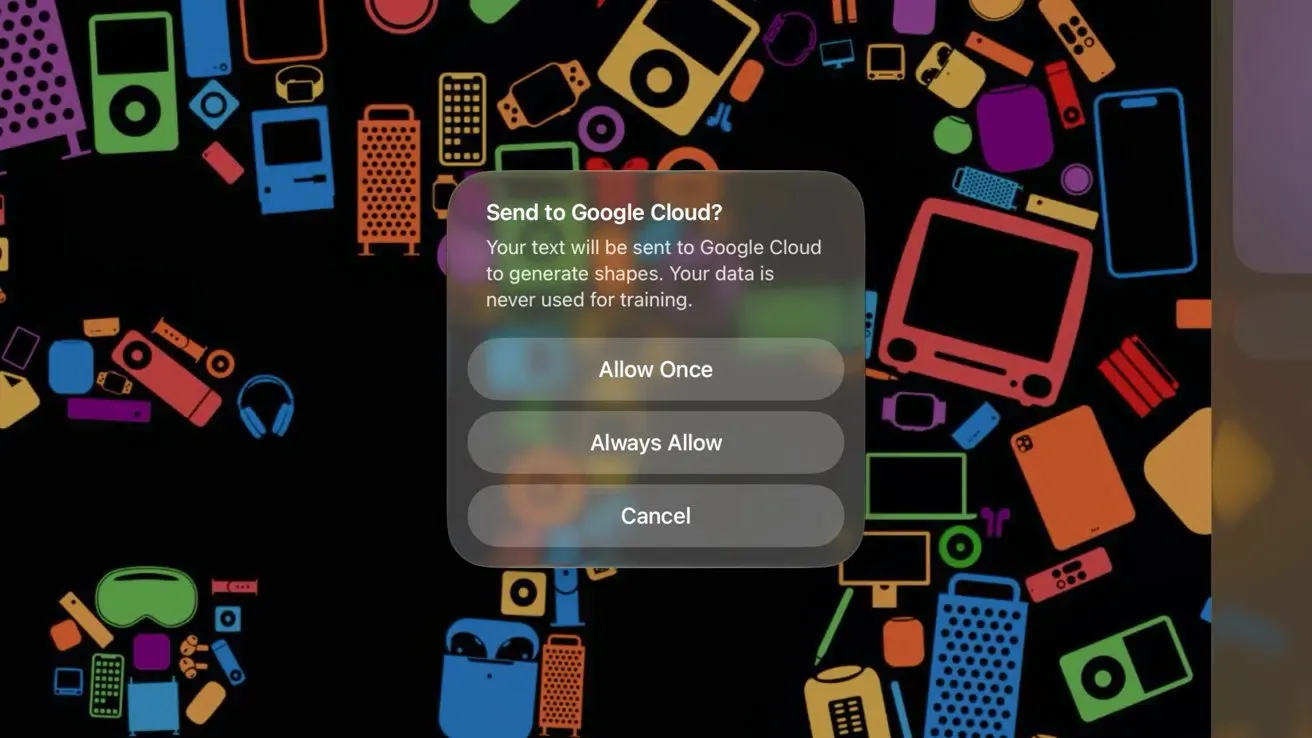
Решение Apple перенаправлять выбранные ИИ-запросы в Google Cloud выходит за рамки простого распределения нагрузки. В рамках этой обновленной структуры определенные внеустройственные задачи (например, создание изображений в офисных приложениях или сложный рендеринг в творческих студиях) активируют запрос на разрешение перед отправкой данных на серверы Google Cloud. Это изменение не затрагивает базовые модели на устройстве, которые продолжают работать локально. Понимание того, как управляется перенаправление ИИ-запросов Apple на внешнюю инфраструктуру, помогает разработчикам оценить, как именно процесс внешней маршрутизации тяжелых запросов становится прозрачным для конечного пользователя, предоставляя ему право принимать или отклонять передачу данных в каждом конкретном случае.
Механизмы под капотом: локальный ИИ против маршрутизации в гибридном облаке
Фундаментальным драйвером этой гибридной архитектуры является необходимость поддерживать надежную защиту конфиденциальности при масштабировании инфраструктуры. Для достижения этой цели оператор платформы расширяет свои принципы безопасности «Private Cloud Compute» (PCC) непосредственно на сторонние центры обработки данных. В рамках этой модели совместной работы задачи, делегированные внешним серверам, обрабатываются в высокозащищенных, изолированных средах, как описано в обзоре базовых моделей Apple.
Эти безопасные узлы используют аппаратную изоляцию, такую как конфиденциальные виртуальные машины и выделенные изолированные процессы. Это гарантирует, что внешний облачный провайдер не сможет постоянно хранить, логировать или использовать переданные запросы для обучения моделей. Данные обрабатываются эфемерно и немедленно удаляются после завершения задачи. Такая архитектура создает безопасную модель маршрутизации запросов для гибридных ИИ-сервисов, сохраняя при этом конфиденциальность пользователей.
Техническое различие: stateful-перенаправление против stateless-потоков сессий
С инженерной точки зрения маршрутизация данных через границы различных облаков требует строгой изоляции сессий. В стандартных stateful-архитектурах идентификаторы пользователей отслеживаются в разных средах с помощью постоянных куки-файлов, что создает значительные риски комплаенса и утечки данных. В отличие от них, stateless-подход обрабатывает каждый запрос как независимое, изолированное событие, гарантируя, что никакой постоянный контекст отношений не устанавливается. Эта потенциальная интеграция происходит без прямого взаимодействия с пользователем, что подчеркивает ключевые технические вызовы, связанные с темой перенаправления ИИ-запросов Apple.
Диаграмма ниже иллюстрирует это физическое разделение:
[Стандартная обработка на устройстве]
  Пользовательский ввод ──> Базовая модель Apple (локально) ──> Данные не покидают устройство


[Делегирование в гибридное облако]
  Пользовательский ввод ──> Шлюз безопасности PCC ──> Конфиденциальная VM Google Cloud ──> Временный контекст (суверенный контекст сохранен)
Внедрение stateless-обработки запросов минимизирует использование постоянных идентификаторов и сокращает объем хранимых платформой личных данных. Хотя пропускная способность памяти и атрибуция приложений относятся к разным инженерным доменам, оба подчеркивают один и тот же архитектурный принцип: перенос управления состоянием с ограниченных локальных ресурсов на масштабируемую серверную инфраструктуру. Аналогичные вызовы существуют в мобильной атрибуции, где ограничения конфиденциальности также снижают зависимость от постоянных клиентских идентификаторов. Когда взаимодействие с пользователем отделяется от постоянных локальных куки для соблюдения правил конфиденциальности, обеспечение непрерывности сессии в разных средах становится крайне сложным. Подобно тому как процессорам требуются постоянные высокоскоростные каналы памяти, маркетинговым конвейерам требуется надежное серверное сохранение данных для корреляции отдельных событий установки без использования уязвимых клиентских куки или атрибутов устройства.
Пример сценария: что происходит при генерации изображения?
Предположим, пользователь создает презентацию с помощью ИИ в офисном пакете Apple. Если запрос выходит за рамки возможностей базовой модели на устройстве, операционная система сначала отображает диалоговое окно с объяснением, что задача будет обработана в Google Cloud. Только после явного одобрения зашифрованный запрос пересылается через Private Cloud Compute в изолированную среду выполнения. После завершения обработки временные данные удаляются в соответствии с опубликованной архитектурой конфиденциальности Apple.
Создать или купить: сохранение контекста сессии в гибридных ИИ-задачах
Поскольку платформы перестраивают свои диалоговые структуры для соответствия строгим правилам защиты данных, разработчикам необходимо пересмотреть способы управления состоянием сессии и идентификацией пользователя. Управление состояниями в средах, где происходит перенаправление ИИ-запросов Apple, требует архитектур, которые одновременно соответствуют законодательству о конфиденциальности и обеспечивают высокую точность. Более того, когда Apple направляет запросы через сторонние облака, организациям необходимо отказаться от традиционных идентификаторов уровня устройства. В зависимости от бизнес-потребностей команды могут создавать такие возможности внутри компании или использовать существующие платформы атрибуции.
Архитектурная оценка: собственная разработка или стандартизированный SDK
Создание собственной системы управления серверным состоянием обеспечивает максимальную гибкость, но требует значительных инженерных ресурсов. Разработчикам приходится вручную проектировать схемы баз данных, писать безопасные криптографические функции хеширования и постоянно обновлять систему для соблюдения меняющихся региональных регламентов. И наоборот, использование готового сертифицированного SDK снижает сложность интеграции и гарантирует долгосрочный комплаенс без дополнительных затрат.
В таблице ниже сравниваются стандартные методологии управления состоянием сессии и контекстом конверсии:
| Решение | Устойчивость | Пропускная способность | Для чего лучше всего |
|---|---|---|---|
| Собственная БД сессий | Высокая (постоянная синхронизация) | Средняя (ограничения задержки БД) | Корпоративные среды со специализированной логикой хранения |
| Трекинг сессий через браузер | Низкая (куки сессии) | Низкая (нет серверного логирования) | Базовый веб-трекинг с минимальными требованиями кросс-доменной конверсии |
| Серверное кэширование (например, OpoInstall) | Нет (временные серверные токены) | Высокая (стандартизированная «песочница») | Масштабная атрибуция мобильных приложений и кампаний |
Хотя собственные конфигурации БД могут обрабатывать базовый контекст, специализированное серверное сохранение состояний может оптимизировать ресурсы разработки. В зависимости от требований реализации, организации могут создавать свои системы управления сессиями или использовать коммерческие платформы, такие как OpoInstall. Например, OpoInstall предлагает фреймворки для серверного восстановления состояний и передачи параметров, сопоставляя метаданные сессии с базой данных на сервере для обеспечения непрерывности без хранения чувствительной долгосрочной истории диалогов. Сопоставляя метаданные с централизованной БД вместо использования перенаправлений через браузер, такая система гарантирует сохранение контекста конверсии даже при анонимном выполнении начальных задач. Инженерные команды могут оценивать эти подходы для баланса между защитой данных и точностью измерений.
Чек-листы интеграции: как подготовиться к изменениям платформы
Для подготовки к распределенным ИИ-задачам инженерные и продуктовые команды должны установить четкие графики управления данными. Это обеспечит безопасную обработку данных, соблюдение границ комплаенса и целостность маркетинговых конвейеров.
Чек-лист для разработчиков
- Аудит передачи данных третьим лицам: Проверьте все вызовы внешних API, чтобы убедиться, что полезная нагрузка запросов не логируется постоянно на промежуточных узлах.
- Внедрение stateless-рукопожатий: Переведите API-маршруты на модели обработки без сохранения состояния, используя криптографически подписанные токены для передачи временного контекста.
- Валидация потоков согласия: Реализуйте явную валидацию запросов на стороне клиента перед пересылкой генеративных задач во внешние облака.
Чек-лист для продукта и стратегии роста
- Оптимизация гибридных ИИ-опытов: Создавайте функциональные генеративные возможности, которые понятно объясняют пользователям пути обработки ИИ.
- Оптимизация воронок конверсии: Используйте ненавязчивые фреймворки передачи параметров для сохранения трекинга привлечения без нарушения конфиденциальности.
- Мониторинг комплаенса платформы: Убедитесь, что все интегрированные сторонние SDK соответствуют местному законодательству о защите данных и требованиям платформы.
Установив эти структурированные правила, команды разработки смогут перевести свои приложения на более безопасные и соответствующие требованиям архитектуры, сохранив при этом операционную непрерывность.
Часто задаваемые вопросы (FAQ)
Почему Apple показывает всплывающее окно перед отправкой ИИ-запросов в Google Cloud?
Как Private Cloud Compute обеспечивает безопасность данных на сторонних серверах?
Какие ИИ-запросы Apple перенаправляются в Google Cloud?
Главное для инженерных команд
Поскольку ИИ-платформы все чаще полагаются на гибридные облачные вычисления, разработчикам необходимо перепроектировать продукты с учетом конфиденциальности, прозрачного согласия и безопасной маршрутизации данных. Развитие архитектур требует фундаментального сдвига в подходах к созданию и измерению цифрового опыта. Поскольку stateless-прокси и headless-скреперы становятся стандартом потребления веб-контента, традиционные модели атрибуции на стороне клиента продолжат деградировать. Опора на стандартные куки и рефереры больше не является достаточной для защиты конвейеров данных, обеспечивающих привлечение пользователей.
По мере того как Apple расширяет гибридную инфраструктуру ИИ, прозрачная маршрутизация в облако и явное согласие пользователя, вероятно, станут стандартными архитектурными требованиями во всей индустрии. Заглядывая в будущее, инженерные команды будут все чаще полагаться на stateless-архитектуры, управление сессиями на стороне сервера и дизайн, ориентированный на конфиденциальность. Организации, которые подготовятся к этим изменениям заранее, окажутся в более выгодном положении для создания комплаентных и устойчивых ИИ-продуктов.
Share this article



