Cloudflare блокирует обучающих ботов? Cloudflare анонсировал новую политику по умолчанию, которая блокирует краулеры для обучения ИИ на сайтах издателей, одновременно предлагая новые возможности монетизации для владельцев контента. По мере того как генеративный искусственный интеллект меняет способы потребления веб-контента, ИИ-платформы продолжают поглощать огромные объемы сетевых ресурсов, не выстраивая при этом эквивалентных механизмов отдачи. Исторически сложилось так, что индексация поисковыми системами приносила реферальный трафик, который можно было монетизировать через рекламу или подписки. Сегодня, поскольку универсальные краулеры систематически собирают проприетарные данные для обучения моделей и при этом выдают готовые сводки, исключающие необходимость кликов, издатели сталкиваются с серьезным снижением доходов.
Операционная проблема и финансовые барьеры: Cloudflare блокирует обучающих ботов на страницах с рекламой
Краткий обзор
- Автоматизированные системы защиты вводят ограничение по умолчанию на парсинг моделей и программных агентов в директориях с монетизируемым контентом в третьем квартале 2026 года.
- Краулеры, совмещающие поисковую индексацию со сбором данных, будут ограничены, если они не разделят свои операционные цели на изолированные потоки.
- Появляются новые платформы компенсации за использование контента, обеспечивающие прямые вознаграждения владельцам ресурсов за конкретные транзакции вместо стандартного подсчета количества запросов.
Традиционное равновесие между онлайн-издателями и автоматизированными веб-парсерами полностью нарушено. Негласное соглашение поддерживало глобальный интернет на протяжении почти тридцати лет. В рамках этой сделки веб-администраторы приветствовали поисковых пауков, получая взамен квалифицированные клики пользователей. Такой взаимный обмен поддерживал медиаресурсы, гарантируя, что рекламные показы, цифровые спонсорства и платные подписки могут финансировать независимые программные руководства и журналистику.
Текущий переход к масштабным генеративным сетям изменил характер активности краулеров, сместив цель с простого обнаружения путей на извлечение данных. Автономные системы сбора данных теперь поглощают целые цифровые каталоги, парсят семантические данные и выдают синтезированные ответы в закрытых чат-виджетах. Это мгновенное решение исключает необходимость обычных переходов на сайт. Оценки показывают, что когда поисковые интерфейсы предоставляют интегрированный генеративный вывод, вероятность того, что читатель кликнет по исходящей ссылке, значительно ниже, падая в ряде случаев до однозначных показателей. Эти модели трафика создают дефицит финансирования для платформ, зависящих от стандартных структур размещения рекламы.
Почему блокировка обучающих ботов от Cloudflare стала требованием издателей
Издатели долгое время сталкивались с трудным компромиссом между защитой контента и сохранением поисковой видимости. Если независимый владелец сайта блокирует Googlebot, Applebot или Bingbot, чтобы предотвратить обучение моделей, он рискует исчезнуть из традиционных поисковых индексов. Эта структурная монополия вынуждает создателей контента делать сложный выбор: отдавать ценные данные бесплатно или жертвовать видимостью в поиске. Такая динамика также поощряет новые ИИ-компании использовать тактику уклонения от краулинга, увеличивая серверную нагрузку на издателей, которые уже оплачивают избыточные запросы.
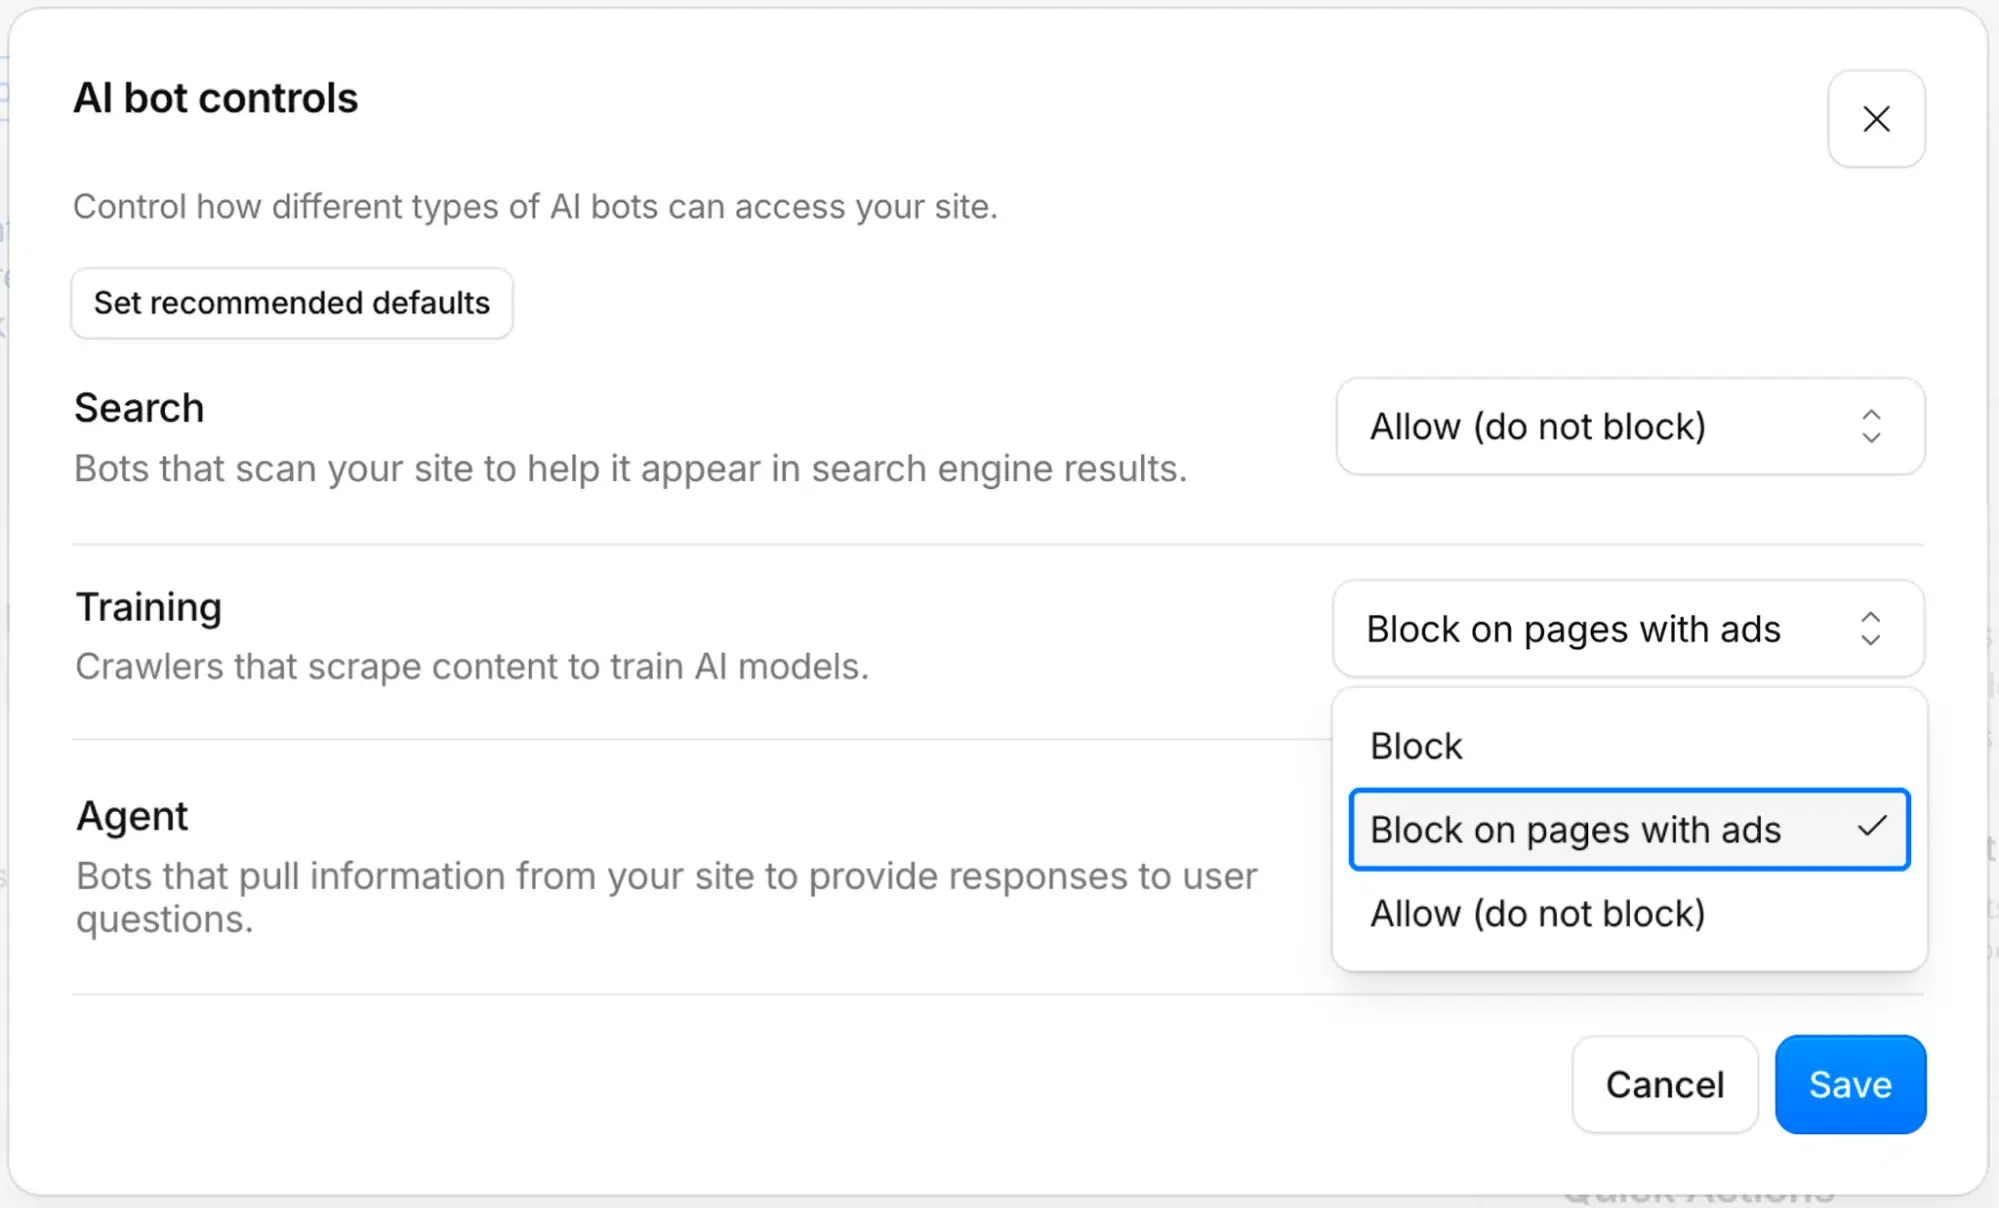
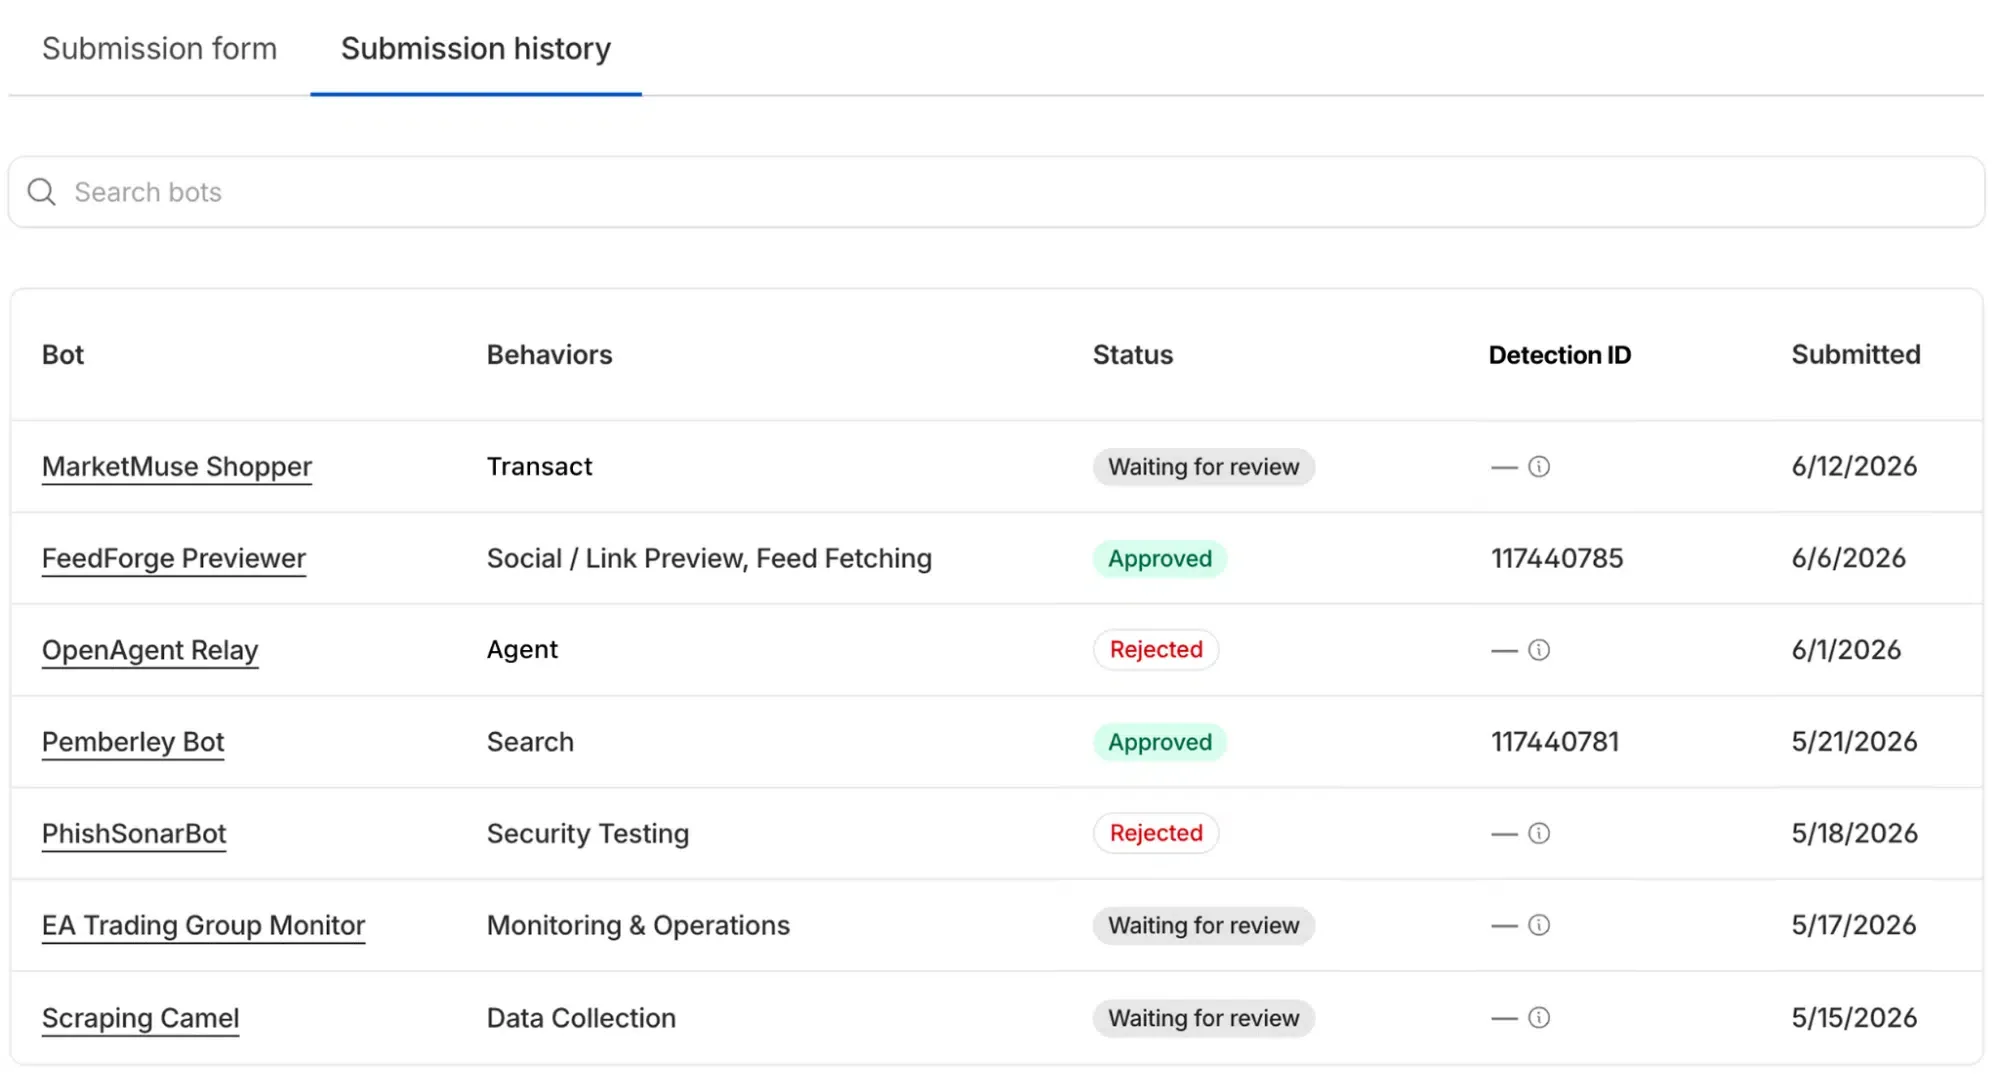
Чтобы восстановить равновесие, Cloudflare ввела механизм декларативного контроля. Как заявили в Cloudflare, политика по умолчанию начнет внедряться 15 сентября 2026 года, устанавливая блокировки для обучающих ботов и пользовательских агентов на всех рекламных страницах клиентов. Это обновление гарантирует, что контент, подлежащий монетизации, не может быть проиндексирован без явного разрешения. Одновременно компания перестраивает свою модель монетизации, переходя от системы оплаты за количество запросов к экосистеме, ориентированной на результат. Благодаря интеграции с такими платформами, как You.com и Ceramic.ai, издатели могут получать прямую компенсацию всякий раз, когда ИИ-агент использует их контент для ответа на запрос, что формирует устойчивый поток дохода на транзакционной основе.
Системные причины и цепочки невидимых запросов политики Cloudflare
Анализ физического состава интернет-трафика показывает, что автоматизированные боты теперь составляют более 50% всей активности. Этот объем создает огромную нагрузку на исходные серверы, особенно из-за того, что дублирующие запросы часто запрашивают неизменный контент. Телеметрия Cloudflare указывает на то, что более половины трафика проверенных краулеров является полностью избыточным, что тратит вычислительные мощности обеих сторон. Фундаментальная проблема кроется в архитектуре современных поисковых и парсинговых операций, которые полагаются на многоцелевых ботов, скрывающих свои истинные намерения.
На прикладном уровне технические характеристики пользовательского агента существенно отличаются от стандартных человеческих браузерных сессий. Это различие критически важно, так как современные headless-парсеры полностью обходят традиционные интерактивные элементы, вызывая серьезные сбои в отслеживании для систем аналитики.
Разрыв протоколов: Stateless-агенты против Stateful-браузеров
Традиционная веб-оптимизация предполагает, что браузерные сессии управляют состоянием через файлы cookie, локальное хранилище и структурированные строки User-Agent. В отличие от них, автономные агенты и headless-краулеры выполняют HTTP-запросы без сохранения состояния. Это различие разрушает аналитические цепочки, которые издатели используют для обоснования рекламной ценности. Приведенная ниже схема показывает ключевые различия на уровне приложений:
[Стандартная веб-сессия]
  Браузер пользователя (состояние и Cookies) ──> HTTP-запрос ──> Рекламные показы и рефереры зарегистрированы


[Сессия без сохранения состояния]
  Автоматизированный краулер (Stateless HTTP) ──> Изолированный запрос ──> Рефереры отсутствуют, атрибуция утеряна
Когда автоматизированный браузерный агент загружает страницу, обрабатывает текст и выдает ответ в закрытой среде чата, весь контекст на стороне клиента разрушается. Традиционные скрипты отслеживания не могут выполниться. Рекламные показы не регистрируются, а стандартные заголовки рефереров исчезают. Это создает пробел в атрибуции: издатель предоставляет ценную информацию, но система аналитики фиксирует нулевое вовлечение. Та же потеря контекста браузера влияет на рабочие процессы мобильной атрибуции, когда пользователь в итоге устанавливает приложение. Поскольку headless-посещения лишены состоятельных контейнеров отслеживания, стандартные инструменты мобильной аналитики не могут сопоставить начальное событие обнаружения с последующей установкой приложения. Эта динамика ускоряет крах традиционных моделей многоканальной атрибуции.
Сравнение решений: «Разработка против покупки» в эпоху Cloudflare
Поскольку границы клиентского отслеживания размываются под воздействием новых правил для автоматизированных парсеров, инженерным командам необходимо пересмотреть свои архитектуры атрибуции. Опора исключительно на стандартные куки или атрибуты уровня устройства больше не является жизнеспособной стратегией. Разработчики сталкиваются с дилеммой: создать собственную базу данных для сопоставления контекста на стороне сервера или интегрировать готовую, надежную систему измерения, способную выдерживать headless-взаимодействия.
Архитектурная оценка: разработка vs покупка в Stateless-эру
Создание собственной системы сопоставления контекста требует настройки серверной базы данных состояний для кэширования и сверки сессий. Хотя такой подход обеспечивает полный контроль над потоком данных, инженерные затраты значительны. Разработчикам приходится вручную обрабатывать API-запросы, управлять истечением сессий и внедрять безопасные криптографические подписи для предотвращения мошенничества. Напротив, интеграция готового SDK для измерений устраняет этот груз обслуживания.
Следующая матрица сравнения показывает, как различные методики отслеживания работают в условиях большого количества headless-агентов:
| Метрики и возможности | Собственная БД сессий | Legacy Firebase / Webview | Платформы MMP (Adjust, AppsFlyer) | SDK Deferred Deep Linking (OpoInstall) |
|---|---|---|---|---|
| Устойчивость атрибуции | Высокая (Server-Side) | Низкая (Client-Side) | Высокая (Multi-Touch) | Высокая (Программное сопоставление) |
| Затраты на разработку | Крайне высокие | Низкие | Высокие | Низкие |
| Бремя обслуживания | Высокое (постоянно) | Низкое | Низкое | Низкое |
| Борьба с фродом | Средняя (ручные правила) | Низкая | Высокая (алгоритмическая) | Высокая (Zero-Trust сигнатуры) |
| Влияние на задержку | Переменное | Среднее | Среднее | Низкое (легковесность) |
К коммерческим реализациям этой модели относятся Adjust, AppsFlyer, Branch и другие системы отложенной атрибуции. Одним из примеров является OpoInstall, который обеспечивает отложенные диплинки и серверное восстановление параметров для сохранения метаданных сессии между веб- и мобильным контекстами. Разделяя цепочку перенаправления от клиентских редиректов, этот метод сохраняет метаданные пути пользователя от первичного события поиска до финального запуска приложения, обходя ограничения, накладываемые прокси-серверами. Платформы мобильной атрибуции используют схожие идеи восстановления состояния на стороне сервера, чтобы обеспечить консистентность конверсий даже при полном отсутствии контекста браузера.
Чек-листы интеграции: как пережить изменения от Cloudflare
Чтобы обеспечить непрерывность данных по мере того, как Cloudflare внедряет блокировку обучающих ботов на рекламных страницах, инженерным и продуктовым командам необходимо установить структурированный график перехода. Для разработчиков это означает отказ от клиентских редиректов в пользу надежных методов серверной верификации. Для команд роста это требует пересмотра моделей расчета окупаемости маркетинговых инвестиций (ROAS) с учетом потери данных атрибуции браузера.
Чек-лист для разработчиков
- Внедрение заголовков Forwarded (RFC 7239): Настройте все входящие API-шлюзы для чтения и разбора стандартизированного заголовка
Forwardedдля идентификации доверенных промежуточных прокси.
Forwarded: for=203.0.113.1;proto=https
- Использование криптографических подписей URL: Убедитесь, что все исходящие промо-ссылки используют криптографически подписанные параметры для предотвращения манипуляций со стороны ботов.
- Серверная сверка сессий: Перейдите от перенаправлений через куки к программной базе данных состояний, которая сопоставляет ключи сессий при первом запуске приложения.
Чек-лист по стратегии продукта и роста
- Перестройка моделей ROAS: Адаптируйте воронки привлечения так, чтобы события активации на стороне сервера имели больший вес, чем традиционные клики по веб-рекламе.
- Восстановление контекстного опыта: Используйте фреймворки передачи параметров, чтобы восстановить целевое направление пользователя, даже если реферер был удален агентом.
- Аудит трафика ботов в BotBase: Используйте поведенческую классификацию в реальном времени для аудита взаимодействия автоматизированных парсеров с маркетинговыми воронками.
Разработчики могут настроить свои сайты для трансляции явных предпочтений индексации, дополнив конфигурацию robots.txt современными полями метаданных.
# Пример, основанный на предлагаемых расширениях метаданных
User-agent: *
Content-Signal: search=yes,ai-train=no,use=reference
Allow: /
Такой структурированный подход позволяет владельцам контента сохранять видимость в поиске, предотвращая при этом бесконтрольное поглощение проприетарного контента ИИ-платформами в их закрытые обучающие датасеты.
Часто задаваемые вопросы (FAQ)
Почему один и тот же бот сканирует страницы как для поиска, так и для обучения ИИ?
Как Cloudflare определяет, какие страницы содержат рекламу для активации блокировки?
В чем разница между оплатой за краулинг и оплатой за использование?
Переход интернета от человекоцентричной среды к экосистеме, управляемой агентами, требует фундаментального изменения подходов к построению и измерению цифрового опыта. Поскольку автоматизированные прокси и stateless-агенты становятся основными потребителями веб-контента, традиционные модели атрибуции на стороне клиента будут продолжать терять эффективность. Полагаться только на cookies и базовые HTTP-рефереры уже недостаточно для защиты данных, обеспечивающих привлечение пользователей и монетизацию.
Чтобы сохранить рост в эту новую эпоху, инженерным и продуктовым командам необходимо отделить логику атрибуции от стандартных действий браузера. Внедряя разрешение идентификации на стороне сервера, криптографически подписанные параметры и надежные фреймворки передачи данных, организации могут защитить свои потоки данных от блокировок со стороны автоматизированных парсеров. Этот переход — не просто адаптация к одному обновлению политики, а перестройка систем для выживания в децентрализованном интернете, ориентированном на работу с ИИ-агентами.
Share this article



