Google представляет Gemini 4 Hydrogen? Подразделение Google DeepMind официально представило модель Gemini 4 Hydrogen 12 ноября 2026 года, позиционируя ее как экономичную и высокопроизводительную систему для повседневной разработки программного обеспечения и многоэтапных агентских рабочих процессов, как описано в официальном анонсе Google DeepMind. Поскольку разработчики все чаще задействуют автономные агенты для навигации по репозиториям и запуска тестов, использование исключительно крупных передовых моделей рассуждений приводит к заметной задержке и росту расходов на API. Хотя глубокие архитектурные рассуждения остаются необходимыми для проектирования сложных систем, рутинные инженерные задачи (такие как локальные правки, запуск наборов тестов и анализ журналов сборки) требуют быстрого выполнения. Hydrogen создана как в качестве самостоятельного инструмента для разработки с высокой пропускной способностью, так и в роли исполнительного движка, работающего в паре с передовыми моделями в конвейерах многомодельной маршрутизации.
Главные изменения в отрасли: Google представляет Gemini 4 Hydrogen для рабочих процессов с высокой пропускной способностью
Краткий обзор
- Google DeepMind представила Gemini 4 Hydrogen — высокопроизводительную модель, предназначенную для решения рутинных задач программирования, ответов на вопросы по репозиторию и агентских процессов с меньшей задержкой по сравнению с передовыми моделями.
- Модель работает в рамках единого окна контекста на 1 048 576 токенов, общего для входных и выходных данных, при этом стоимость составляет $1.50 за миллион входных токенов и $7.50 за миллион выходных токенов.
- Доступ предоставляется через Google AI Studio, Gemini API, Android Studio, Google Search и корпоративные платформы, а уровни доступа различаются в зависимости от бесплатных потребительских тарифов и платных рабочих пространств для разработчиков.
Операционные требования к процессам разработки программного обеспечения уже давно вышли за рамки простого автодополнения кода по одному запросу. Современные агентские сценарии часто запускают десятки автономных шагов, включая чтение структуры каталогов, проверку деревьев зависимостей, предложение патчей и выполнение регрессионных тестов. Когда разработчики направляют каждое рутинное действие через передовые модели рассуждений, выполнение задач существенно замедляется. В итеративных средах даже умеренная задержка при вызове отдельных инструментов может вылиться в серьезные задержки в рамках автоматизированных циклов разработки.
Отраслевые дискуссии вокруг запуска отражают растущее понимание того, что специализация моделей имеет решающее значение для масштабирования в продакшене. Вместо того чтобы использовать одну универсальную модель в качестве решения по умолчанию для любой задачи разработки, команды оценивают многоуровневые архитектуры. В таких конфигурациях модели высокой емкости управляют проектированием систем и неоднозначными формулировками проблем, в то время как специализированные исполнительные модели берут на себя повторяющиеся операции с кодовой базой. Компания Google разработала Hydrogen именно для этого операционного уровня, обеспечив немедленную доступность для разработчиков через стандартные конечные точки API и программные среды.
Анализ бенчмарков и технические ограничения Gemini 4 Hydrogen
Google описывает Hydrogen как модель, адаптированную на базе Gemini 4 Carbon. Однако в опубликованной технической документации не раскрываются конкретные внутренние детали механизмов переноса весов, архитектуры токенизатора или конвейеров дистилляции. Таким образом, технические оценки должны базироваться на наблюдаемых данных бенчмарков, задокументированных ограничениях контекста и заявленных операционных ограничениях, а не на предполагаемых внутренних механизмах.
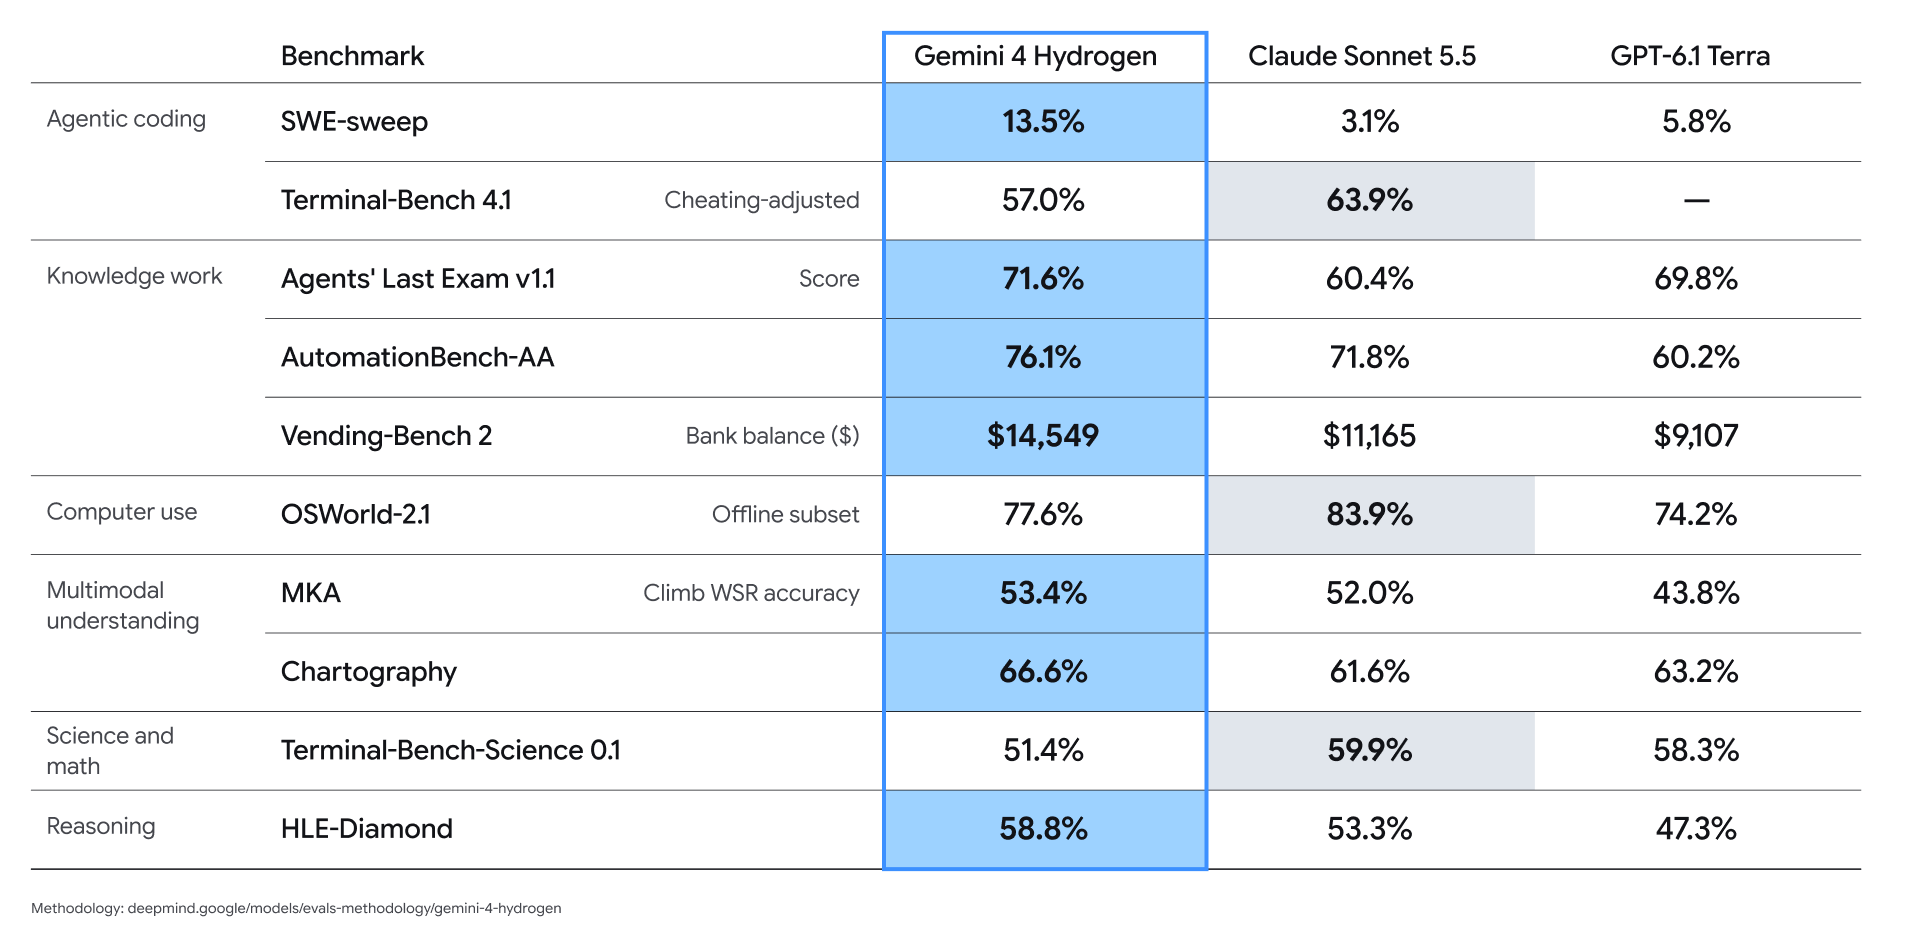
В стандартных оценках, приведенных в карте модели Gemini 4 Hydrogen, Hydrogen демонстрирует четкие различия в производительности по категориям задач. В бенчмарке SWE-sweep для устранения проблем компания Google зафиксировала процент успешных решений в 13.5% для Hydrogen по сравнению с 3.1% у Claude Sonnet 5.5 и 5.8% у GPT-6.1 Terra в заданных условиях оценки. С другой стороны, в Terminal-Bench 4.1 с учетом параметров коррекции обмана Hydrogen показала результат в 57.0%, что значительно превосходит Gemini 3.8 Flash (18.2%), но уступает Claude Sonnet 5.5, набравшей 63.9%. В независимом рейтинге Artificial Analysis Intelligence Index модель Hydrogen получила 51 балл при настройке режима размышлений по умолчанию (high) и 54 балла при настройке xhigh по сравнению с 50 баллами у флагманской Gemini 4 Argon.
Важным архитектурным аспектом является емкость контекста модели, как указано в документации по моделям Google Cloud. Hydrogen предоставляет единый предел контекста в 1 048 576 токенов, который распределяется между всеми входными и выходными данными. Это означает, что объемные входные файлы уменьшают оставшуюся емкость токенов, доступную для вывода модели. Один фрагмент на переднем плане поддерживает до 65 536 выходных токенов. Для более длинной генерации используются поддерживаемые механизмы продолжения, включая продолжение под управлением SDK, пользовательский цикл токенов продолжения или фоновое выполнение под управлением сервера (где это доступно). На все сегменты распространяется общее ограничение контекста. Выходные токены включают внутренние токены рассуждений, сгенерированные запросы инструментов и видимый текст.
[Архитектура многомодельного оркестратора в Google Antigravity]
                         ┌────────────────────────┐
                         │  Gemini 4 Carbon/Argon │ (Архитектурное планирование и сложные рассуждения)
                         └───────────┬────────────┘
                                     │ Делегирование задач и проверка планов
                                     ▼
                         ┌────────────────────────┐
                         │   Gemini 4 Hydrogen    │ (Параллельная генерация кода и вызов инструментов)
                         └───────────┬────────────┘
                                     │ Структурированные вызовы инструментов
                                     ▼
                [ Локальная среда / Наборы тестов / Файловая система ]
Для балансировки задержки и глубины анализа Hydrogen включает четыре настраиваемых уровня рассуждений: низкий (low), средний (medium), высокий (high, по умолчанию) и сверхвысокий (xhigh). Более низкие настройки уменьшают задержку ответов для простых синтаксических правок, в то время как более высокие уровни выделяют больше внутренних токенов рассуждений для оценки крайних случаев. Разработчикам следует учитывать сохраняющиеся ограничения: модель имеет срез знаний по март 2026 года, может испытывать периодические тайм-ауты при интенсивной фоновой обработке и способна выдавать галлюцинации или избыточные отказы при обработке двусмысленных запросов.
Раздельные системы и компромиссы при многомодельной оркестрации
Многомодельная оркестрация позволяет платформам разработки распределять рабочие процессы между различными уровнями моделей. При таком подходе моделирование сложных систем и проверки безопасности делегируются передовым моделям рассуждений, в то время как конкретные правки кода и тестовые утверждения закрепляются за быстрыми исполнительными моделями.
Google оценила этот подход с использованием экспериментального оркестратора в Google Antigravity. При тестировании на Terminal-Bench 4.0 компания Google сообщила, что динамическое переключение между Carbon и Hydrogen позволило достичь показателей успешности задач, близких к Carbon, при этом расходуя на 24% меньше квот и выполняя задачи на 19% быстрее, чем при работе только с Carbon. Google также отметила первые тесты с партнерами, показавшие ускорение выполнения в 2–2.8 раза и снижение использования токенов на 12%–23% по сравнению с Gemini 3.8 Flash на отдельных рабочих процессах. Например, компания Box сообщила примерно об ускорении в 2 раза и сокращении количества токенов на 12% при работе со сложными документами и таблицами. Эти примеры, предоставленные вендором, отражают специфические настройки интеграции и не являются контролируемыми оценками экономии во всех производственных развертываниях.
| Компонент системы | Репрезентативные инструменты | Определенная зона ответственности | Операционный охват и ограничения |
|---|---|---|---|
| Системный координатор | Gemini 4 Carbon / Argon | Проектирование архитектуры высокого уровня, планирование по репозиториям, оценка сложной логики | Высокая способность к рассуждениям; влечет более высокие затраты на токен и большую задержку генерации |
| Исполнительный движок | Gemini 4 Hydrogen | Локальная генерация кода, автоматическое редактирование файлов, циклы быстрого вызова инструментов | Высокая пропускная способность генерации; может работать автономно или под управлением координатора |
| Шлюз проверки | Модульные тесты / Статические линтеры | Проверка детерминированных правил, валидация синтаксиса, регрессионное тестирование | Проверяет заданные утверждения и статичные правила; надежность зависит от качества тестов, покрытия и независимого обзора |
Оценка многомодельной архитектуры требует от инженерных команд поиска баланса между сложностью системы и эффективностью выполнения. Хотя динамическая маршрутизация моделей позволяет снизить затраты токенов на повторяющиеся задачи, она привносит накладные расходы на оркестрацию, проблемы синхронизации состояния между субагентами и зависимость от классификаторов маршрутизации. Инженерные команды должны сопоставлять эти компромиссы с собственным распределением задач, структурой репозиториев и требованиями к задержке API.
Внедрение разработки и чек-листы контроля рабочих процессов
Интеграция Gemini 4 Hydrogen в автоматизированные цепочки инструментов разработчика требует четких границ выполнения, мониторинга токенов и защитного управления агентами.
Чек-лист по внедрению для разработчиков
- Согласуйте уровни мышления с операционными задачами: Настраивайте параметры объема рассуждений в зависимости от сложности рабочей нагрузки. Резервируйте уровень
xhighдля сложных алгоритмических крайних случаев, поддерживайте уровеньhighв качестве стандартной базы для навигации по репозиторию и используйтеmediumилиlowдля задач, чувствительных к задержкам (например, форматирование кода или простой поиск документации). - Структурируйте интерфейсы параллельных инструментов: Проектируйте определения инструментов так, чтобы они принимали пакетные аргументы (там, где это поддерживается средой выполнения), позволяя рабочим агентам запрашивать инспекцию нескольких файлов или проверки синтаксиса в рамках объединенных запросов, а не последовательных циклов «туда-обратно».
- Отделите генерацию моделей от выполнения: Обеспечьте, чтобы модели предлагали вызовы инструментов и модификации кода в виде структурированных данных, в то время как изолированная среда выполнения клиента или контейнеризированный инструмент тестирования выполняют команды и возвращают результаты выполнения и воспроизводимые доказательства, где это возможно.
Чек-лист корпоративного управления
- Настройте ведение журналов сеансов: Логируйте запросы инструментов, результаты выполнения, решения о правах доступа, изменения кода, результаты тестов и доступные сводки моделей. Не рассматривайте сводки рассуждений как полные или точные трассировки выполнения.
- Применяйте многоуровневые средства безопасности: Относитесь к внешней документации, бакерам задач и комментариям к пулл-реквестам как к ненадежным входным данным. Хотя Hydrogen продемонстрировала 2.3-кратное улучшение устойчивости в бенчмарке косвенных промпт-инъекций Gray Swan, автоматическая санитизация входных данных и шлюзы разрешений на выполнение остаются необходимыми.
- Контролируйте совокупное потребление токенов: Отслеживайте входные токены и токены вывода, подлежащие оплате (включая токены мышления), используя поля использования выбранного API. Не добавляйте токены мышления повторно, если они уже включены в общий оплачиваемый объем вывода.
Часто задаваемые вопросы (FAQ)
Как Gemini 4 Hydrogen соотносится с Carbon и Argon в рабочих нагрузках продакшена?
Каковы четыре уровня мышления и когда разработчикам следует использовать xhigh?
Как работает единая модель ценообразования в окне контекста в один миллион токенов?
Основные выводы для инженерных команд
Внедрение автономных инструментов программирования в продакшн-среду требует от команд разработки выхода за рамки показателей передовых бенчмарков и сосредоточения внимания на экономике итеративного выполнения инструментов. Перенаправление каждой рутинной модификации кода через модели рассуждений с высокой задержкой приводит к ненужным операционным задержкам и раздуванию бюджета. В то же время управление задержкой выполнения и процентом успешных задач требует реалистичных ожиданий в отношении результатов бенчмарков и поведения при восстановлении после ошибок.
Создавая многоуровневые архитектуры, объединяющие модели рассуждений высокой емкости с быстрыми и предсказуемыми исполнительными движками, инженерные организации могут устойчиво масштабировать автоматизированные рабочие процессы разработки. Команды, внедряющие дисциплинированную многомодельную маршрутизацию, структурированные границы тестирования и строгую валидацию входных данных, окажутся в наиболее выгодном положении для создания надежных и поддерживаемых программных конвейеров с поддержкой ИИ.
Ссылки
-
Google DeepMind. Представляем Gemini 4 Hydrogen. Официальный анонс.
-
Google DeepMind. Карта модели Gemini 4 Hydrogen. Техническая спецификация и отчет о безопасности.
-
Google Cloud. Документация по модели Gemini 4 Hydrogen. Технический справочник.
-
Google Antigravity. Gemini 4 Hydrogen в Google Antigravity. Обзор многомодельной оркестрации.
-
Artificial Analysis. Бенчмарк интеллекта и задержки Gemini 4 Hydrogen. Независимая оценка ИИ.
-
Ars Technica. Google выпускает Gemini 4 Hydrogen, наконец заменяя 3.8 Flash. Технический анализ.
Share this article