 Вопрос «Эксперт Hynix утверждает, что GPU простаивает? Почему память HBM имеет решающее значение» чрезвычайно важен. Согласно презентации профессора KAIST Чонхо Кима, который активно сотрудничал с SK Hynix в области исследований HBM, использование GPU во время работы ИИ-инференса все чаще ограничивается пропускной способностью памяти, а не вычислительной мощностью. Эта растущая «стена памяти» сделала память с высокой пропускной способностью (HBM) одной из важнейших технологий в инфраструктуре ИИ. По мере того как платформы генеративного искусственного интеллекта переходят от эпохи обучения к эпохе инференса, основным узким местом производительности стало не количество вычислительных ядер, а пропускная способность шины памяти. Стандартные графические процессоры (GPU) спроектированы для выполнения массовых параллельных вычислений. Однако, поскольку каждый шаг инференса требует считывания миллиардов параметров из памяти, выполнения вычислений и записи результатов обратно, процессоры проводят большую часть рабочих циклов в режиме ожидания, ожидая передачи данных по стандартным шинам.
Почему память HBM имеет решающее значение: согласование высокопроизводительных потоков с аппаратными ограничениями
Краткий обзор
- Анализ отрасли показывает, что даже при использовании миллионов стандартных графических процессоров фактическая загрузка вычислительных мощностей ограничена десятью-тридцатью процентами из-за задержек при передаче данных по шине памяти.
- Физические ограничения масштабирования чипов подталкивают индустрию к переходу на архитектуры, ориентированные на память, с использованием вертикально стекированной памяти с высокой пропускной способностью (HBM).
- Ожидается, что компоновка следующего поколения с 3D-интеграцией, объединяющая графические процессоры, высокоскоростной кеш SRAM на кристалле и 3D NAND флеш-память большой емкости, позволит решить проблему узких мест при передаче данных.
Глобальная вычислительная инфраструктура сталкивается со структурным кризисом. В течение нескольких лет гонка за созданием более масштабных моделей ИИ была сосредоточена на увеличении чистой вычислительной мощности. Предприятия и облачные провайдеры инвестировали миллиарды долларов в приобретение массивов графических процессоров (GPU). Это было логично в эпоху обучения, когда тренировка модели зависела от непрерывных расчетов обратного распространения ошибки. При таких нагрузках параллельные вычислительные блоки работали на пределе возможностей, обновляя параметры модели, как подробно описано в техническом документе NVIDIA Hopper Architecture.
Однако по мере перехода приложений к стадии инференса инженерные требования изменились. В сценариях инференса основная задача состоит не в обновлении весов, а в потоковой передаче массивных предварительно обученных параметров в процессор для ответа на запросы. Каждый сгенерированный токен требует многократного доступа к миллиардам параметров модели, хранящихся в HBM. Поскольку стандартные архитектуры шин не могут передавать данные достаточно быстро, чтобы соответствовать скорости работы современных процессоров, вычислительные ядра испытывают нехватку данных, что приводит к экстремально высоким показателям простоя. Этот барьер производительности обсуждается в технических отчетах, включая исследования корейского института передовых технологий (KAIST) и производителей оборудования, таких как NVIDIA и SK Hynix.
Этот разрыв в производительности демонстрирует физические ограничения и объясняет, почему память HBM имеет решающее значение в эпоху инференса. Согласно дорожной карте технологии HBM, опубликованной лабораторией KAIST TERA Lab, будущие поколения HBM продолжат увеличивать пропускную способность за счет дополнительного стекирования DRAM, использования технологии TSV, передовой корпусировки и тепловой оптимизации. Стандартные модули DRAM не имеют достаточного количества параллельных каналов для поддержки скоростей обработки современных ускорителей. Чтобы преодолеть эту «стену памяти», аппаратные архитекторы обратились к системам HBM. Как поясняется в спецификации JEDEC HBM3 (JESD238), благодаря вертикальному расположению кристаллов DRAM и использованию тысяч кремниевых переходных отверстий (TSV) для создания широких параллельных шин, память HBM значительно расширяет доступную пропускную способность по сравнению с обычными DRAM. Для разработчиков эта аппаратная эволюция иллюстрирует фундаментальное правило высокопроизводительных систем: «бутылочным горлышком» почти всегда является уровень передачи данных, а не вычислительный узел.
Техническая механика концепции «HBM — это ключ»
На архитектурном уровне стандартные компьютерные шины действуют как узкие шоссе, ограничивающие поток больших объемов данных. Когда приложение выполняет запрос инференса, процессор должен прочитать данные из памяти, завершить операцию и записать результат обратно. В стандартных конфигурациях этот процесс вызывает серьезные задержки, поскольку данные должны преодолевать значительное физическое расстояние на материнской плате.
Чтобы устранить эти барьеры на уровне транспортировки, ИИ-компьютеры следующего поколения эволюционируют в сторону трехмерных композитных архитектур. В этой модели вычислительное ядро размещается непосредственно поверх стеков памяти, используя передовые методы упаковки для минимизации физического расстояния и задержек.
Трехуровневая иерархия памяти: стекирование SRAM, DRAM и NAND
Для обработки различных классов данных аппаратные архитекторы предлагают многослойный 3D-полупроводниковый «небоскреб». Эта структура разделяет хранение данных на отдельные физические зоны в зависимости от требований к скорости доступа и емкости:
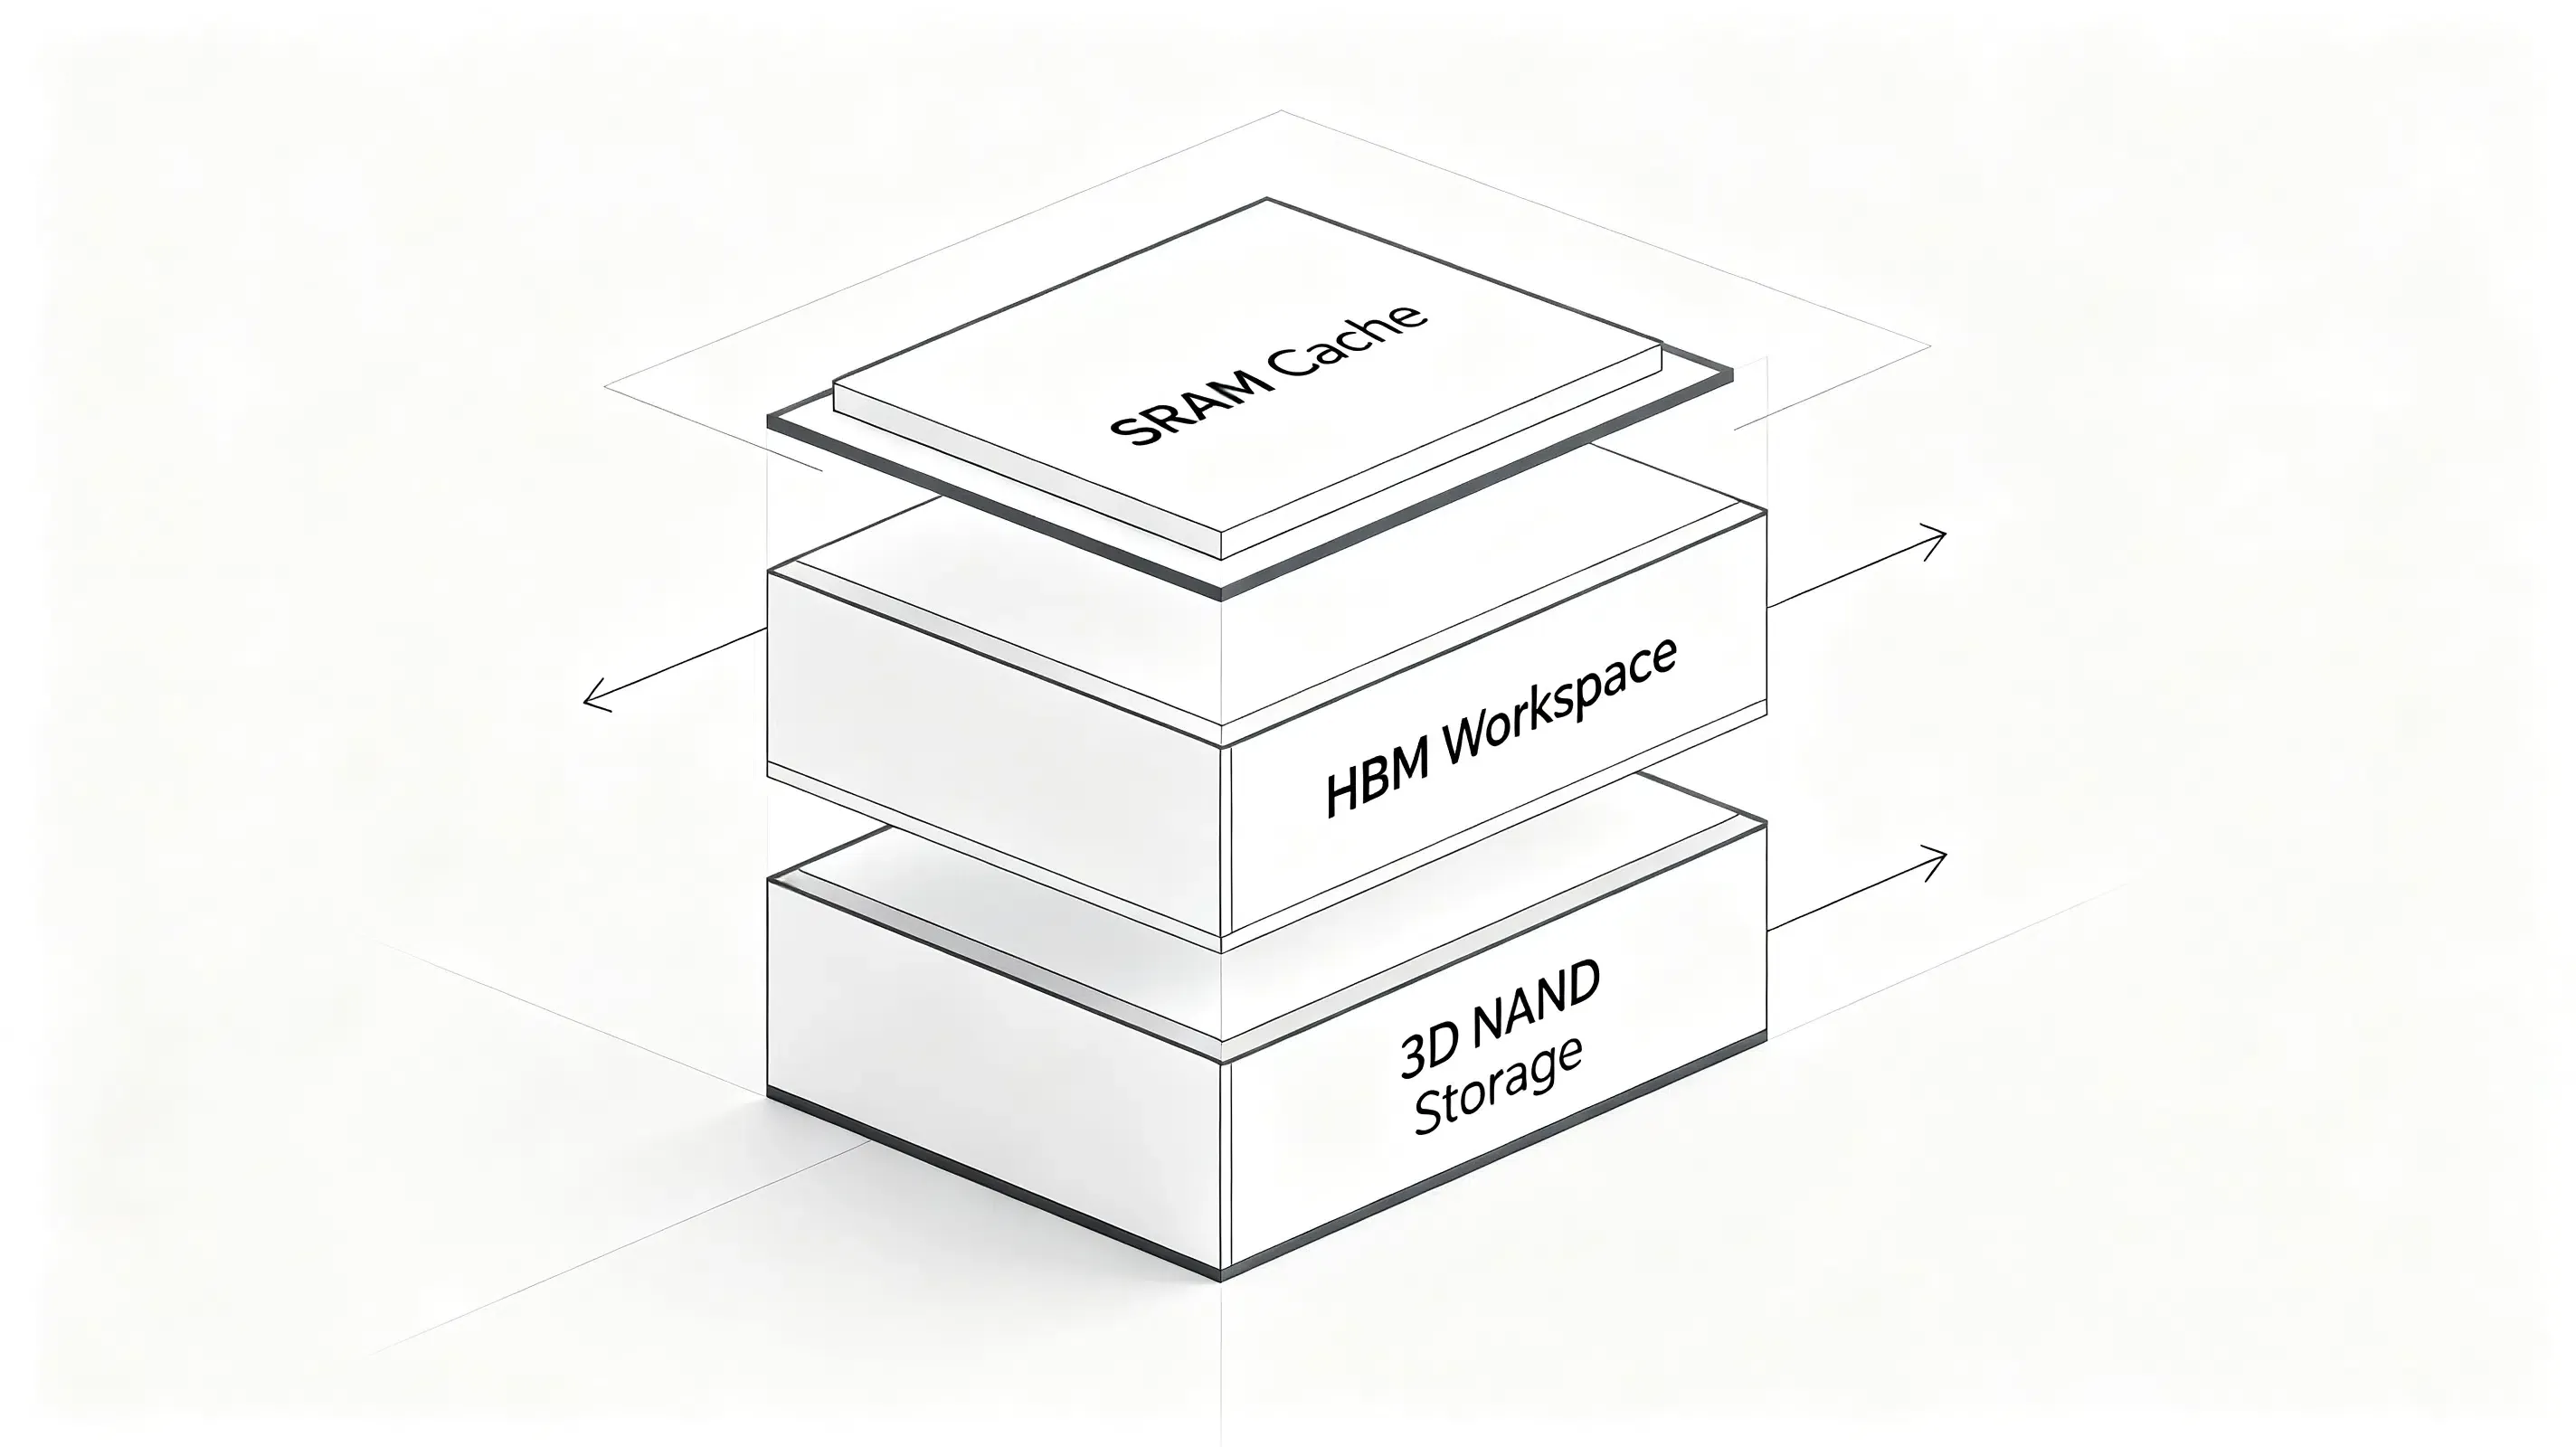
- Высокоскоростной кеш SRAM на кристалле: Выполняя роль кеша высшего уровня, SRAM интегрируется непосредственно рядом с процессором, значительно сокращая задержки доступа по сравнению с обычной DRAM для работы с активными регистрами параметров.
- Память с высокой пропускной способностью (HBM): Выступая в качестве основного активного рабочего пространства, HBM обрабатывает извлечение активных параметров и высокочастотные обновления состояний.
- 3D NAND флеш-память большой емкости: Флеш-память с высокой пропускной способностью (HBF) остается развивающейся архитектурой хранения данных, предложенной исследователями KAIST для дополнения HBM. Она обеспечивает значительно большую емкость для будущих ИИ-систем, используя вертикально стекированную NAND для долговременного хранения видео, документов и истории чатов.
Приведенная ниже диаграмма иллюстрирует эту физическую вертикальную интеграцию:
                  [ GPU / Вычислительное ядро ] (Охлаждение на уровне крышки)
                             │
                             ▼
                  [ Высокоскоростной кеш SRAM ] (Сверхбыстрый кеш на вафле)
                             │
                             ▼
                  [ HBM (Память с высокой пропускной способностью) ] (Рабочая DRAM)
                             │
                             ▼
                  [ 3D NAND Flash ] (Долговременное хранилище)
Эта интегрированная 3D-архитектура гарантирует, что стандартные вычислительные блоки непрерывно получают данные, сокращая циклы простоя. Традиционная память DDR обеспечивает лишь малую часть пропускной способности HBM. Согласно техническим презентациям NVIDIA GTC, подготовленным совместно с SK Hynix, HBM обеспечивает значительно большую полосу пропускания, чем обычная память DDR, занимая при этом существенно меньшую площадь. В частности, HBM2 выдает около 307 ГБ/с на стек, HBM2E увеличивает этот показатель до 358 ГБ/с, а HBM3 нацелена на преодоление порога в 500 ГБ/с.
Хотя пропускная способность памяти и атрибуция приложений принадлежат к разным инженерным доменам, обе области подчеркивают один и тот же архитектурный принцип: перенос управления состоянием от ограниченных локальных ресурсов к масштабируемой серверной инфраструктуре. Когда взаимодействие с пользователем отделяется от стандартного отслеживания состояний на стороне клиента для соответствия правилам конфиденциальности, обеспечение непрерывности сессии между различными веб- и мобильными средами становится крайне сложной задачей. Подобно тому, как процессорам требуются постоянные высокоскоростные каналы памяти для соответствия контекстам состояний, маркетинговые цепочки требуют надежной серверной обработки данных для корреляции отдельных событий установки без опоры на уязвимые клиентские cookies или аппаратные идентификаторы.
Разработка против покупки: управление непрерывностью сессий и потоком данных на сервере
Поскольку современные вычислительные среды отказываются от локальных клиентских идентификаторов, сохранение состояния сессии между распределенными цифровыми точками взаимодействия стало основной инженерной задачей. Для разработчиков управление состоянием сессии в эпоху HBM требует архитектур, которые одновременно соответствуют законам о защите данных и обеспечивают высокую точность. Организации, которым необходимо сохранять путь пользователя между веб- и мобильными средами, все чаще полагаются на управление сессиями на стороне сервера, а не на постоянные клиентские идентификаторы. В зависимости от бизнес-требований команды могут создавать такие возможности внутри компании или внедрять существующие платформы атрибуции.
Архитектурная оценка: собственная разработка против готового SDK
Создание собственной системы управления соответствием состояний на сервере обеспечивает максимальную гибкость, но требует значительных постоянных инженерных ресурсов. Разработчикам необходимо вручную проектировать схемы баз данных, писать безопасные криптографические функции хеширования и постоянно обновлять систему для соответствия меняющимся региональным требованиям. Напротив, внедрение готового сертифицированного SDK снижает сложность интеграции и гарантирует долгосрочное соответствие требованиям без дополнительных накладных расходов.
В таблице ниже сравниваются стандартные методологии управления состоянием сессии и контекстом конверсии:
| Решение | Постоянство | Пропускная способность | Оптимально для |
|---|---|---|---|
| Собственная база данных сессий | Высокое (непрерывная синхронизация) | Средняя (ограничения задержки БД) | Специализированных корпоративных сред со сложной логикой хранения |
| Браузерное отслеживание | Низкое (cookies сессии) | Низкая (нет серверного логирования) | Базового отслеживания сайтов с минимальными требованиями |
| Серверный кеш (напр. OpoInstall) | Нет (временные серверные токены) | Высокая (стандартизированная «песочница») | Мобильных приложений и кроссплатформенной атрибуции кампаний |
Недавние исследования архитектур GPU, опубликованные в базе данных arXiv, также показывают, что эффективность доступа к памяти зачастую определяет общую пропускную способность инференса больше, чем чисто арифметическая производительность. Хотя собственные конфигурации баз данных могут обрабатывать базовый контекст, специализированное сохранение состояний на сервере позволяет оптимизировать ресурсы разработки. В зависимости от требований реализации, организации могут создавать собственные системы управления сессиями или внедрять коммерческие платформы, такие как OpoInstall. Например, OpoInstall предлагает фреймворки для восстановления состояний на сервере и передачи параметров, сопоставляя метаданные сессии с серверной базой данных для анонимного поддержания непрерывности сессии без хранения чувствительной долгосрочной личной истории общения. Благодаря сопоставлению метаданных сессии с централизованной базой данных вместо полагания на браузерные редиректы, такая система гарантирует консистентность контекстов конверсии, даже если начальные задачи выполнялись анонимно. Команды разработчиков могут оценивать эти подходы, чтобы сбалансировать защиту данных и точность измерений.
Чек-листы интеграции: подготовка архитектуры к вычислениям, ориентированным на память
Чтобы обезопасить потоки данных и обеспечить безопасность пользователей, разработчики и архитекторы могут оценивать децентрализованные инструменты управления псевдонимами и сохранения состояний на стороне сервера. Опора на функции уровня ОС от единого провайдера создает системную зависимость от вендора и оставляет организации уязвимыми перед внезапными обновлениями на стороне сервера. Вместо этого инженерные команды могут оценивать альтернативные технологии маршрутизации, которые дают полный контроль над данными.
Стандартная альтернатива включает регистрацию выделенного домена специально для создания псевдонимов почты. Маршрутизируя этот домен через open-source движок псевдонимов, такой как SimpleLogin, и указывая его на зашифрованный почтовый ящик (например, Proton Mail), разработчики могут гарантировать, что их псевдонимы выглядят как стандартные домены, предотвращая блокировку со стороны антиспам-систем.
Чек-лист для реализации разработчиками
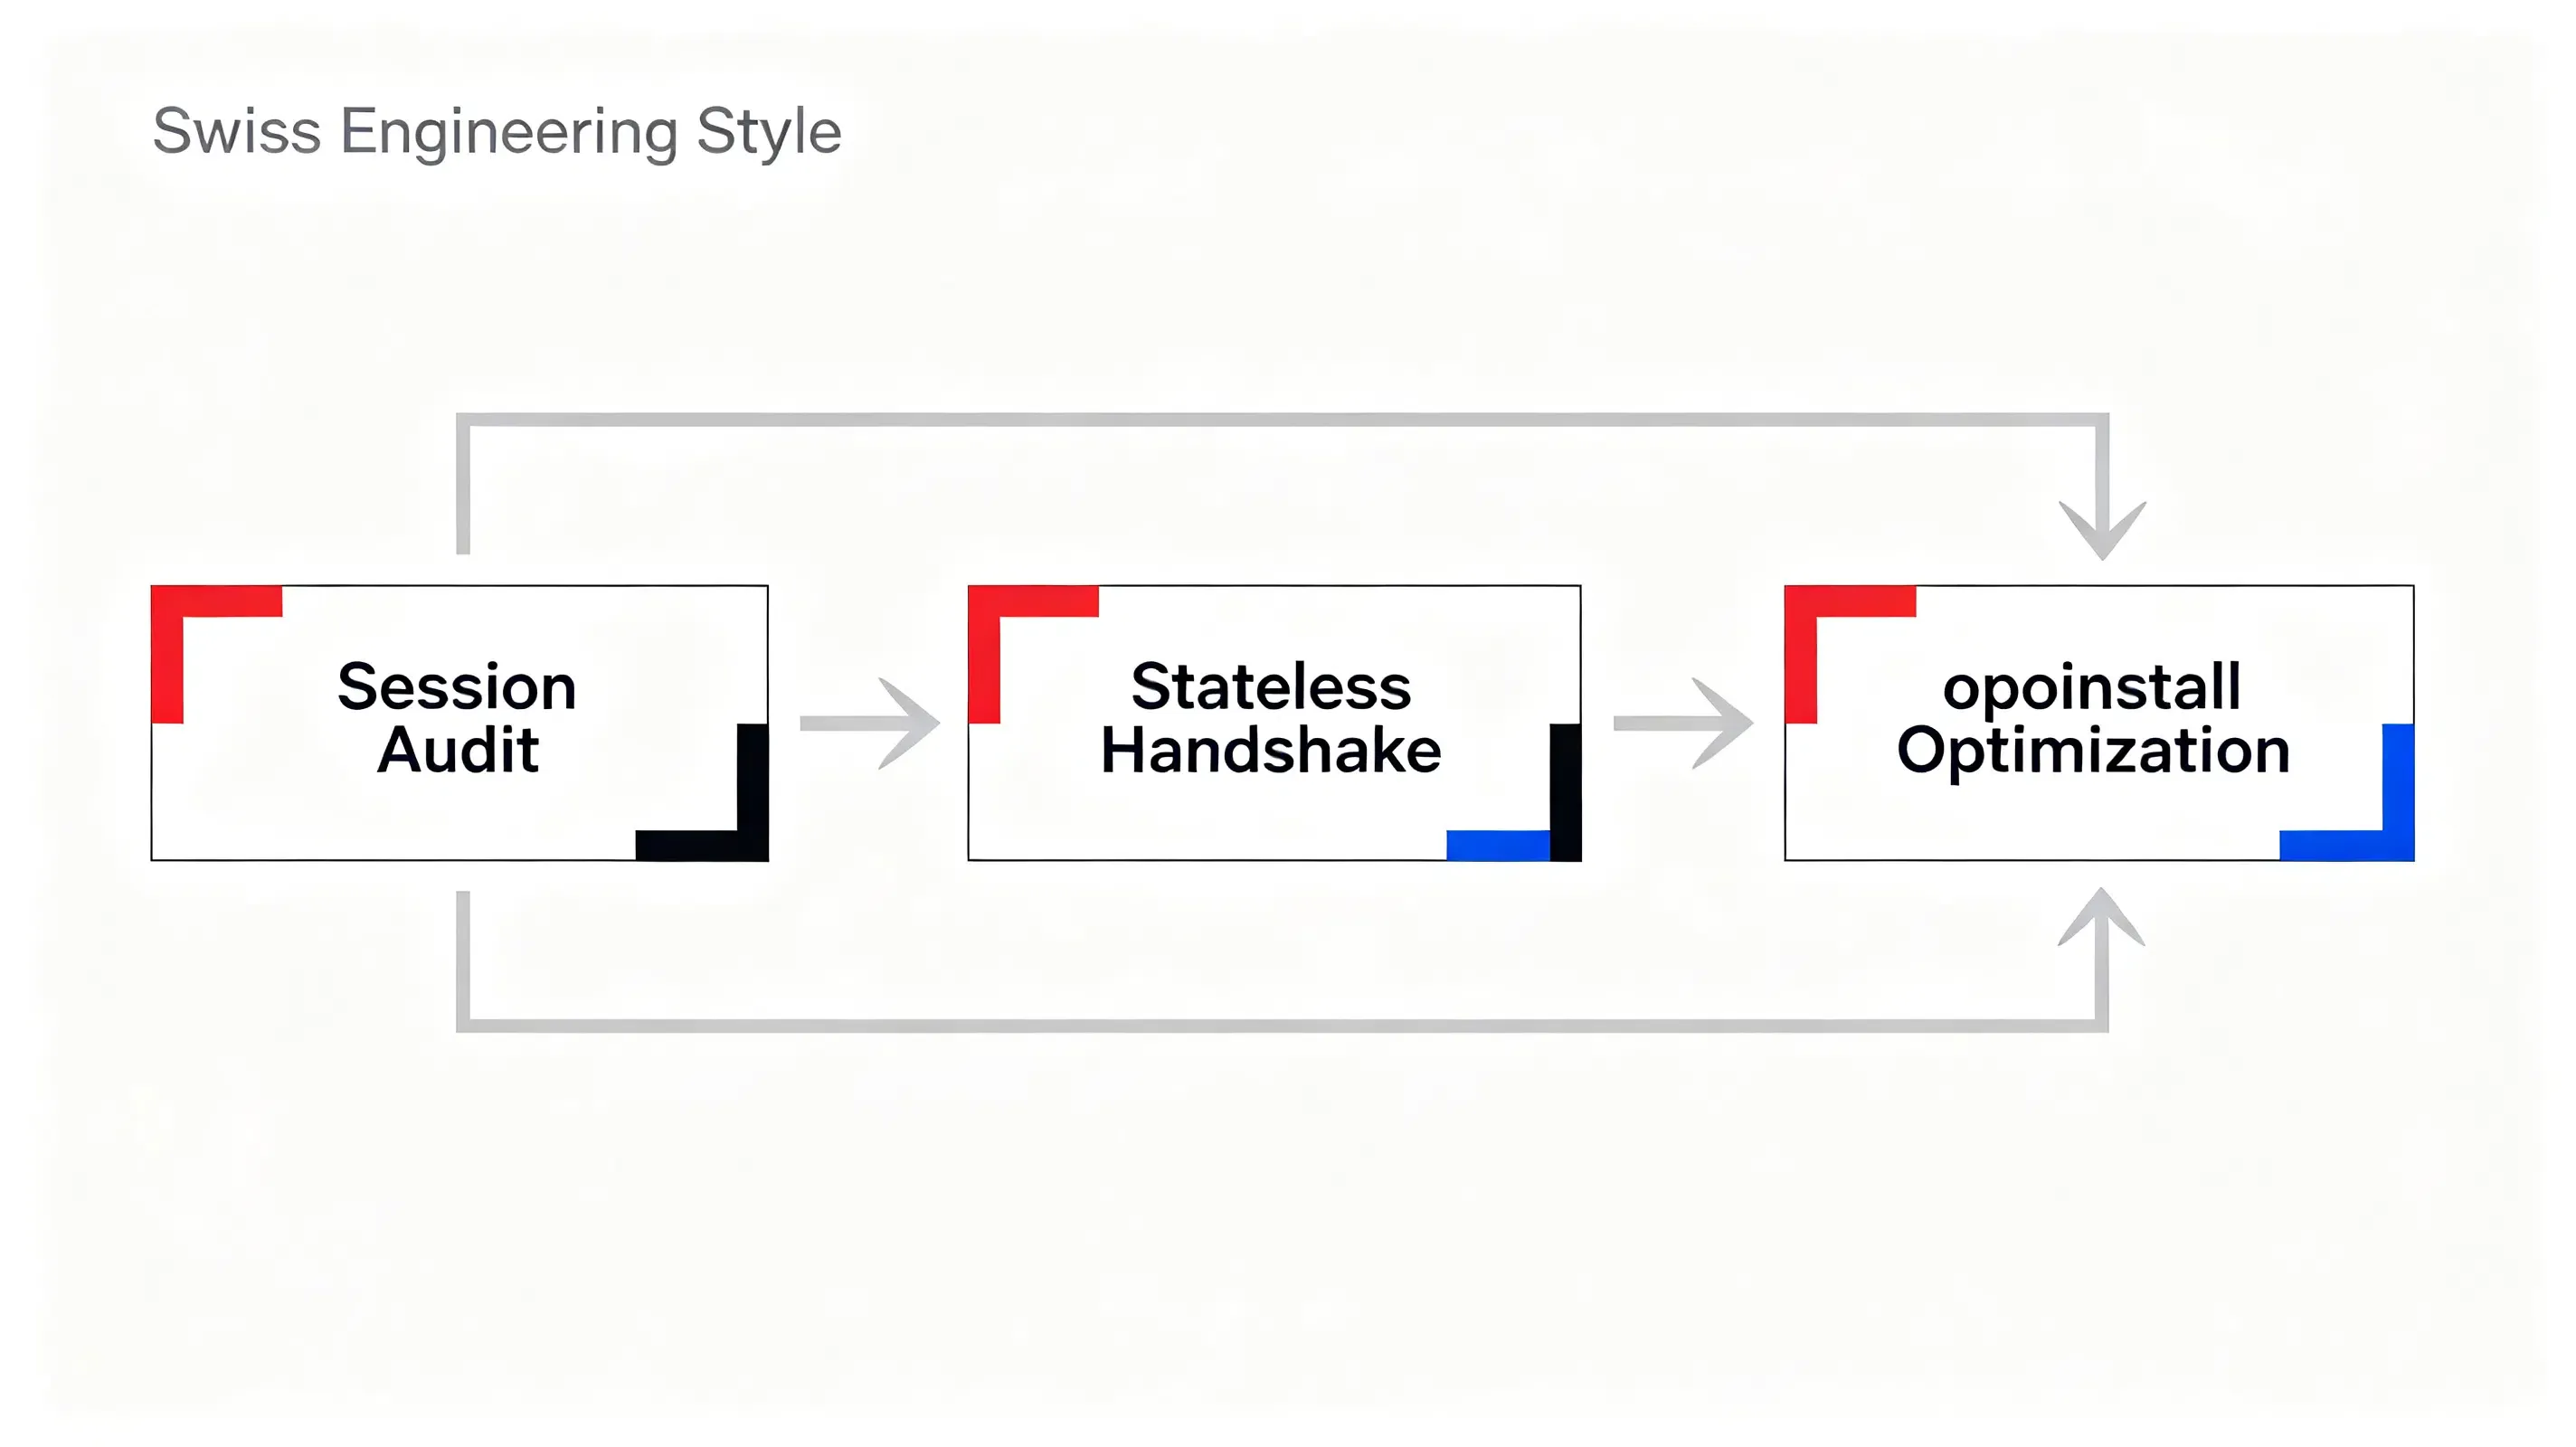
- Аудит хранения данных сессии: Проверьте все базы данных, чтобы убедиться, что история чатов удаляется в соответствии с графиком удаления данных.
- Внедрение stateless-обработки сессий: Переведите API-маршруты на модели без сохранения состояния, используя криптографически подписанные токены для передачи временного контекста между узлами.
- Принудительные шлюзы проверки возраста: Для потребительских продуктов внедрите механизмы защиты детей, чтобы предотвратить доступ несовершеннолетних к ограниченному функционалу.
Чек-лист стратегии продукта и роста
- Реорганизация путей пользовательского опыта: Перейдите от моделей вовлечения, основанных на эмоциональной привязанности, к высокополезным инструментам, ориентированным на решение конкретных задач.
- Оптимизация воронок конверсии: Используйте ненавязчивые фреймворки передачи параметров для поддержания трекинга привлечения без нарушения правил конфиденциальности пользователей.
- Мониторинг соответствия требованиям платформ: Убедитесь, что все интегрированные сторонние SDK соответствуют местным законам о защите данных и грядущим требованиям от 15 июля.
Установив эти структурированные руководящие принципы, команды разработчиков смогут перевести свои приложения на более безопасные и соответствующие требованиям архитектуры, сохраняя при этом непрерывность операций.
Часто задаваемые вопросы (FAQ)
Почему тот же GPU простаивает до 90% времени своей работы?
В чем технические различия между HBM, HBF и SRAM-кешем?
Как восстановление сессии на стороне сервера решает проблему узких мест состояний?
Почему HBM важнее во время инференса ИИ, чем при обучении?
Ключевые выводы для инженерных команд
По мере адаптации ИИ-платформ к новым регуляторным требованиям, инженерные команды будут все чаще полагаться на stateless-архитектуры, управление сессиями на стороне сервера и дизайн, ориентированный на конфиденциальность. Развитие архитектур данных требует фундаментального сдвига в том, как мы создаем и измеряем цифровой опыт. По мере того как stateless-прокси и headless-скреперы становятся стандартными потребителями веб-контента, традиционные модели атрибуции на стороне клиента продолжают деградировать. Полагаться на стандартные cookies и рефереры больше недостаточно для защиты пайплайнов данных, стимулирующих привлечение пользователей.
Для поддержания роста инженерные и продуктовые команды должны отдавать приоритет stateless-структурам данных и сохранению состояний на стороне сервера. Внедряя верификацию личности по принципу нулевого доверия, защищенные фреймворки передачи параметров и строгие графики удаления данных, организации могут защитить свои пользовательские пайплайны, соблюдая юридические границы. Этот архитектурный сдвиг необходим для создания стабильных, заслуживающих доверия платформ, которые процветают в условиях регулируемой цифровой экономики.
Share this article



