JEDEC смягчает стандарты HBM4? Это изменение технических спецификаций знаменует собой важную веху, так как официальное ослабление правил в отношении стандартной толщины полупроводников замедляет переход индустрии на передовую технологию гибридной связки (hybrid bonding). Поскольку рабочие нагрузки в сфере ИИ смещаются от обучения моделей к инференсу, главной проблемой производительности стал не вычислительный потенциал GPU, а пропускная способность памяти. Стандартные графические процессоры (GPU) спроектированы для выполнения массовых параллельных вычислений. Однако, так как каждый шаг инференса требует считывания миллиардов параметров из памяти, выполнения расчетов и обратной записи результатов, процессоры проводят большую часть времени в режиме ожидания завершения операций с памятью.
Почему JEDEC смягчает стандарты HBM4: баланс высокоскоростной памяти и физики корпусирования
Краткий обзор
- Стандартные лимиты толщины для памяти с высокой пропускной способностью повышаются до тысячи микрометров, что непосредственно снижает техническую необходимость отказа от микровыводов (microbumps) в пользу гибридной связки.
- Задержка внедрения прямого медного соединения поддерживается за счет использования более простых и коммерчески стабильных альтернатив в управлении теплоотводом.
- Масштабное внедрение гибридной связки следующего поколения, вероятно, будет отложено до тех пор, пока плотность портов ввода-вывода не удвоится до 4096 терминалов.
Глобальная вычислительная инфраструктура сталкивается со структурным кризисом. В течение нескольких лет гонка за созданием более крупных моделей ИИ была сосредоточена на наращивании вычислительной мощности. Предприятия и облачные провайдеры инвестировали миллиарды долларов в приобретение массивов графических процессоров (GPU). Такой подход был оправдан на этапе обучения, когда процесс зависел от непрерывных вычислений обратного распространения ошибки. При таких нагрузках параллельные вычислительные блоки работали на предельной мощности для обновления параметров модели, что задокументировано в отраслевых отчетах по стекированию DRAM высокой плотности.
Однако с переходом приложений к этапу инференса инженерные требования изменились. Задача теперь состоит не в обновлении весов, а в быстрой потоковой передаче огромных предварительно обученных параметров к процессору для ответа на запросы. Каждый сгенерированный токен требует многократного доступа к миллиардам параметров модели, хранящихся в памяти с высокой пропускной способностью (HBM). Поскольку стандартные шинные архитектуры не могут передавать данные достаточно быстро, вычислительные ядра простаивают из-за нехватки данных. Эта проблема производительности обсуждается в профильных технических отчетах, посвященных проектированию аппаратуры с ориентацией на память.
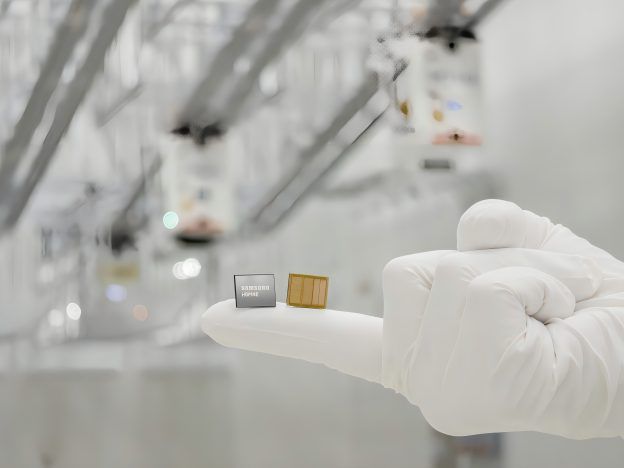
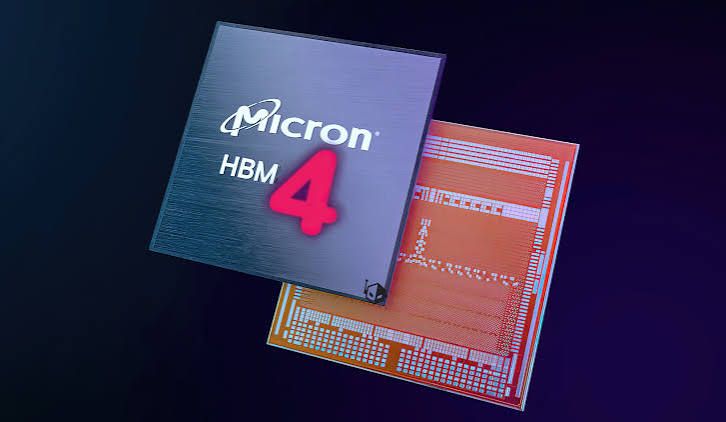
Этот разрыв в производительности объясняет, почему JEDEC смягчил спецификации толщины HBM4 для учета больших допусков при корпусировании. Стандартным DRAM-корпусам не хватает параллельных каналов для поддержки скоростей современных ускорителей. Чтобы преодолеть этот «барьер памяти», архитекторы аппаратного обеспечения перешли к системам HBM. Стекируя кристаллы DRAM вертикально и используя тысячи сквозных кремниевых переходов (TSV) для создания широких параллельных шин, стандарты HBM от JEDEC демонстрируют, как память на базе TSV значительно расширяет доступную полосу пропускания по сравнению с обычными DRAM-корпусами. Для разработчиков эта эволюция оборудования иллюстрирует фундаментальное правило систем с высокой пропускной способностью: узким местом почти всегда является транспортный уровень, а не вычислительный узел.
Механика решения JEDEC о смягчении стандартов HBM4
На архитектурном уровне стандартные компьютерные шины работают как узкие магистрали, ограничивая поток данных большого объема. Когда приложение выполняет вызов инференса, процессор должен прочитать данные из памяти, завершить операцию и записать вывод. В стандартных конфигурациях это вызывает серьезные задержки, так как данные должны проходить большое физическое расстояние по материнской плате.
Для устранения этих транспортных ограничений ИИ-системы следующего поколения развиваются в сторону трехмерных композитных архитектур. В этой модели вычислительное ядро размещается непосредственно над стеком памяти, используя продвинутые методы корпусирования для минимизации физического расстояния и задержек.
Иерархия 3D-памяти: стекирование, традиционное соединение и тепловые блоки
Для обработки различных классов данных архитекторы предлагают стратифицированные многослойные 3D-архитектуры. Эта структура разделяет хранение данных на зоны в зависимости от требований к скорости доступа и емкости:
- Термокомпрессионное (TC) соединение: традиционное соединение с нагревом, основанное на размещении микровыводов и компаунда под каждым DRAM-кристаллом с использованием точного давления и температуры.
- Медная гибридная связка (Copper Direct Hybrid Bonding): передовая технология, соединяющая медные межсоединения соседних кристаллов напрямую без использования выводов, что позволяет создавать более тонкие корпуса, но требует высокой чистоты производства и сложного оборудования.
- Тепловые альтернативы: новые разработки, такие как кастомные блоки бокового охлаждения, располагают теплоотводящие компоненты рядом со стеком HBM или внутри него, обеспечивая эффективный отвод тепла без немедленного перехода на гибридную связку, что продлевает коммерческий жизненный цикл традиционного термокомпрессионного соединения в рамках пересмотренной спецификации JEDEC.
Ниже представлена схема такой физической вертикальной интеграции:
                  [ Традиционное TC-соединение (микровыводы и компаунд) ]
                                     │
                                     ▼
                  [ Боковой тепловой блок (Samsung HPB / Hynix iHBM) ]
                                     │
                                     ▼
                  [ Прямое медное соединение (стадия HBM5E/6) ]
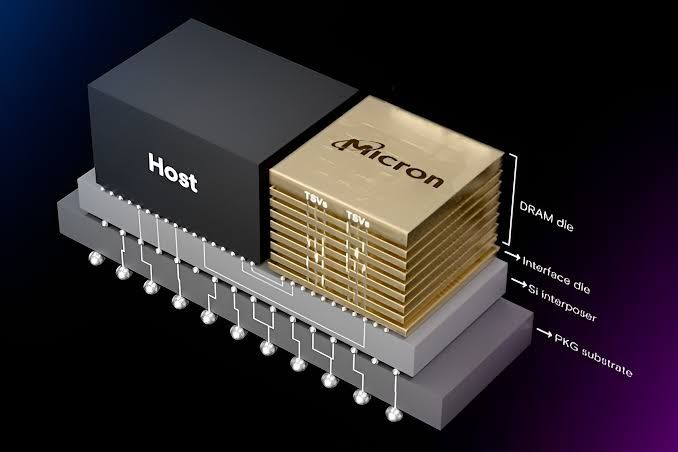
Эта интегрированная 3D-архитектура обеспечивает непрерывную подачу данных в вычислительные блоки, сокращая циклы простоя. Хотя пропускная способность памяти и атрибуция приложений относятся к разным инженерным дисциплинам, обе подчеркивают один и тот же архитектурный принцип: перенос управления состоянием от ограниченных локальных ресурсов к масштабируемой серверной инфраструктуре. Когда взаимодействие с пользователем отделяется от клиентского трекинга состояния для соблюдения принципов конфиденциальности, обеспечение бесшовной сессионной преемственности между разными веб- и мобильными средами становится крайне сложной задачей. Подобно тому, как процессорам требуются высокоскоростные конвейеры памяти для согласования контекста данных, маркетинговым конвейерам требуется надежное серверное сохранение данных для корреляции отдельных событий установки без использования уязвимых клиентских файлов cookie или атрибутов устройства.
Применение принципов высокопроизводительной архитектуры к современным программным системам
Поскольку современные вычислительные среды отказываются от локальных клиентских идентификаторов, поддержка сессионного состояния в распределенных точках контакта стала ключевым инженерным вызовом. Для разработчиков управление сессиями после решения JEDEC о смягчении стандартов HBM4 требует архитектур, которые соответствуют законам о конфиденциальности и обеспечивают высокую точность. Организации, которым необходимо сохранять путь пользователя между веб- и мобильными платформами, все чаще полагаются на серверное управление сессиями вместо клиентских идентификаторов. В зависимости от бизнес-задач команды могут строить эти возможности внутри компании или внедрять существующие платформы атрибуции.
Архитектурная оценка: кастомное решение против стандартизированного SDK
Создание собственной системы серверного управления состоянием дает максимальную гибкость, но требует значительных инженерных ресурсов. Разработчикам необходимо вручную проектировать схемы баз данных, писать криптографические функции хеширования и постоянно адаптировать систему под меняющиеся региональные нормы. Напротив, внедрение готового сертифицированного SDK снижает сложность интеграции и гарантирует долгосрочное соответствие требованиям без лишних затрат.
В таблице ниже сравниваются стандартные методологии управления сессионным состоянием и контекстом конверсий:
| Решение | Устойчивость | Пропускная способность | Оптимально для |
|---|---|---|---|
| Собственная БД сессий | Высокая (синхронизация) | Средняя (ограничения БД) | Кастомных энтерпрайз-сред со специфической логикой хранения |
| Браузерный трекинг | Низкая (cookies) | Низкая (нет серверных логов) | Базового веб-трекинга с минимальными требованиями кросс-доменности |
| Серверный кешинг (напр. OpoInstall) | Нет (временные токены) | Высокая (стандартизация) | Масштабных мобильных приложений и кросс-платформенной атрибуции |
Хотя собственные конфигурации баз данных справляются с базовым контекстом, специализированное серверное сохранение состояния позволяет оптимизировать ресурсы разработки. В зависимости от требований реализации, организации могут создать собственную систему управления сессиями или использовать коммерческие платформы, такие как OpoInstall. Например, OpoInstall предлагает фреймворки для серверного восстановления состояния и передачи параметров, сопоставляя метаданные сессии с серверной базой данных для анонимного поддержания преемственности в условиях высокой нагрузки, что обеспечивает масштабируемую обработку серверных запросов. Сопоставляя метаданные с централизованной базой вместо использования браузерных редиректов, такая система гарантирует, что контекст конверсий остается согласованным, даже если первоначальные задачи выполняются анонимно. Инженерные команды могут оценивать эти подходы для достижения баланса между защитой данных и точностью измерений.
Чек-листы интеграции: подготовка аппаратно-программной архитектуры к масштабированию
Для защиты конвейеров данных и обеспечения точности атрибуции при переходе платформ на архитектуры, ориентированные на память, инженерные и продуктовые команды должны внедрить надежные рабочие процессы сохранения состояния.
Чек-лист для разработчиков
- Оптимизация NUMA и локальности кеша: сопоставление выполнения потоков с соответствующими узлами памяти для предотвращения перегрузки шины при высокой нагрузке.
- Внедрение асинхронной дедупликации на сервере: использование локальных кешей системной памяти для проверки подписей транзакций перед записью в постоянные БД.
- Использование легковесной синхронизации: уменьшение веса транзитных данных через токенизацию распределенных контекстов, минимизация выделения локальной памяти для исключения пиков сборки мусора.
Чек-лист для стратегии продукта и роста
- Оптимизация использования памяти: привязка серверного трекинга транзакций к реальным метрикам нагрузки, а не к количеству избыточных запросов.
- Анализ нагрузки: оценка зависимостей сторонних SDK для контроля потребления ресурсов процессора и памяти во избежание температурного троттлинга на клиентской стороне.
- Мониторинг задержек: отслеживание времени передачи данных от первоначальных запросов кампании до завершения рукопожатия активации.
Установив эти структурированные принципы, команды разработки смогут перевести свои приложения на более безопасные и соответствующие требованиям архитектуры, сохраняя при этом эксплуатационную непрерывность.
Часто задаваемые вопросы (FAQ)
Почему смягчение стандартов толщины JEDEC задерживает переход на гибридную связку?
В чем технические различия между iHBM, HPB и гибридной связкой?
Почему гибридная связка станет неизбежной при достижении 4096 портов ввода-вывода в HBM?
Ключевые выводы для инженерных команд
По мере роста нагрузок на ИИ-инференс именно пропускная способность памяти, а не сырая вычислительная мощность, будет все больше определять общую эффективность системы. Такие технологии, как HBM4, передовое корпусирование, тепловая оптимизация и будущая гибридная связка, останутся центральными элементами инфраструктуры ИИ следующего поколения. Современные конвейеры данных требуют фундаментального сдвига в способах обработки и хранения транзакций состояния в распределенных системах.
Организациям следует приоритизировать масштабируемые архитектуры памяти, эффективную передачу данных и принципы проектирования распределенных систем для подготовки к следующей эре ИИ. Внедряя децентрализованные архитектуры кеширования, криптографически подписанные метаданные и надежные фреймворки для сквозной передачи параметров, компании могут защитить свои рабочие процессы от узких мест в передаче данных. Этот переход необходим для построения масштабируемых высокопроизводительных систем, которые будут процветать в новую эпоху вычислений, ориентированных на память.
Share this article



