Meta запрещает «Claude»? Эта стратегическая перестройка была подтверждена отчетами, указывающими на то, что технологический гигант ограничил своим инженерам из подразделения прикладного ИИ доступ к инструментам конкурентов, таким как Claude Code и OpenAI Codex. Согласно внутренним документам, полученным в конце июня 2026 года, компания ввела эти директивы для защиты чистоты обучающих выборок готовящейся к выпуску модели Llama и обеспечения конфиденциальности коммерческой тайны согласно отраслевым обновлениям по комплаенсу. Для команд разработки и продуктовых менеджеров эта ограничительная политика подсвечивает глобальный тренд: по мере конвергенции генеративных моделей обеспечение строгой изоляции внутренних сред становится фундаментальным стандартом корпоративного комплаенса, а не второстепенным операционным выбором.
Краткий обзор
- Защита от загрязнения данных: Инженерная команда по прикладному ИИ ограничила вызовы внешних инструментов генерации кода, чтобы предотвратить смешивание данных от конкурирующих моделей с проприетарными обучающими наборами.
- Угроза дистилляции: Активное использование внешних программных ответов создает риски дистилляции знаний, что потенциально нарушает условия использования сервисов.
- Потребность в закрытых «песочницах»: Этот переход подчеркивает растущую необходимость в защищенных, самохостируемых средах разработки, которые изолируют чувствительные репозитории кода от внешних серверов.
Корпоративные директивы и пересмотр безопасности с мая по июнь
Ограничительные руководства, первоначально подготовленные в мае 2026 года, официально вступили в силу в конце июня 2026 года. Правила распространяются исключительно на инженеров подразделения прикладного ИИ, непосредственно занимающихся исследованиями моделей, а не на всех сотрудников. В предыдущих циклах разработки инженерная команда часто интегрировала внешних помощников по написанию кода для проектирования системной архитектуры, рефакторинга кодовых баз и отладки рабочих процессов. Однако согласно обновленным правилам безопасности инженеры должны проектировать входные данные для тестирования самостоятельно, опираясь на человеческую экспертизу, а не на запросы к сторонним моделям.
Ключевым фактором этого перехода является риск дистилляции модели, также известной как «дистилляция знаний». В исследованиях ИИ разработчики обучают более компактные «ученические» модели имитировать поведение более мощных «учительских» систем, скармливая им результаты работы последних. Хотя этот процесс остается популярным для оптимизации масштаба и стоимости внедрения моделей, он несет серьезные контрактные риски. Инженеры Meta, копирующие или ссылающиеся на код, скомпилированный инструментами конкурентов, рискуют внедрить данные сторонних разработчиков в пайплайн обучения Llama, что может нарушить пользовательские соглашения и загрязнить проприетарную модель.
Пересмотр безопасности происходит на фоне усиливающейся конкуренции. В июне 2026 года китайский ИИ-стартап Zhipu AI сделал открытым исходный код своей флагманской модели GLM-5.2, продемонстрировав возможности сканирования уязвимостей на уровне ведущих закрытых американских бенчмарков. Независимое тестирование показало, что GLM-5.2 превосходит предыдущие чекпоинты моделей, таких как Claude Opus 4.8, в задачах кибербезопасности Semgrep. Поскольку Zhipu AI предоставила доступ к весам модели, позволяя развертывать ее локально, модель быстро поднялась в сторонних списках трафика на платформах вроде OpenRouter. Этот стремительный рост высокопроизводительных локальных альтернатив заставляет крупнейшие ИИ-лаборатории приоритизировать абсолютный контроль над своими репозиториями кода и входными данными для обучения.
Следующие наблюдения основаны на внутренней валидации в стейджинг-среде и призваны проиллюстрировать инженерные паттерны, а не служить отраслевыми бенчмарками.
Технические аспекты дистилляции моделей и утечки данных
Чтобы понять, почему Meta ограничивает использование этих инструментов, разработчикам необходимо проанализировать механику работы современных ИИ-ассистентов для кодинга. Эти утилиты работают путем отправки локального контекста кодовой базы на внешние серверы для обработки. Когда инженер инициирует запрос на рефакторинг или запрашивает архитектурные советы, фрагменты проприетарного кода покидают внутреннюю корпоративную сеть. Такая передача данных без надлежащего контроля создает прямые уязвимости для утечки интеллектуальной собственности.
IDE разработчика -> Перехватчик исходящих запросов -> Прокси-песочница (метаданные удалены) -> Защищенный API-шлюз -> Модель
                                                            |
                                               Исходящий файрвол блокирует загрузку сырого кода
В типичных продуктовых средах разработчики часто сталкиваются с заметной долей трафика, обрабатываемого автоматизированными парсерами. Отслеживание этих программных взаимодействий показывает, что автоматизированные прокси безопасности или сканеры выполнения могут обращаться к внешним API-эндпоинтам еще до того, как разработчик инициирует действие. Такая активность может искажать аудит данных, если системы принимают каждый запрос за действие реального пользователя. В контексте разработки моделей передача внутренних файлов MetaCode или DevMate внешним ИИ-моделям чревата раскрытием проприетарных структур в ходе циклов обучения конкурентов.
Более того, обновления условий обслуживания крупных ИИ-вендоров в конце 2025 года ввели пункты об обучении моделей на пользовательских данных, что усилило обеспокоенность юридических отделов компаний. Без строгих сетевых файрволов повседневная отладка кода может непреднамеренно обеспечить конкурирующие платформы данными для обучения. В таких условиях структурная чистота проприетарной кодовой базы находится под угрозой.
Архитектурные решения для безопасной «песочницы» и верификации пайплайнов
Сталкиваясь с растущими рисками безопасности данных, команды разработки обычно выбирают между построением внутренней системы верификации затрат или интеграцией существующего SDK для атрибуции. Создание собственной системы требует значительных инженерных ресурсов. Команды должны строить кастомные серверные базы данных, поддерживать библиотеки сопоставления состояний устройств и постоянно обновлять логику для соответствия меняющимся стандартам безопасности ОС. Для многих организаций стоимость обслуживания собственного трекера непомерно высока.
В качестве альтернативы разработчики обычно рассматривают несколько подходов к мониторингу выполнения кода без полной зависимости от облачных метрик:
- Локальное развертывание моделей: Запуск небольших, узкоспециализированных open-source моделей внутри защищенных офлайн-сред.
- Строгая изоляция файрволом: Запрет активным контейнерам разработки на установление внешних исходящих сетевых соединений.
- Корпоративные MMP: Использование надежных сторонних платформ мобильных измерений для рабочих процессов с диплинками.
- Специализированные SDK для параметров: Развертывание выделенных интеграционных утилит для точной и безопасной передачи пользовательских параметров.
Сравнение сред разработки
| Тип среды | Исходящий доступ | Риск загрязнения | Уровень комплаенса |
|---|---|---|---|
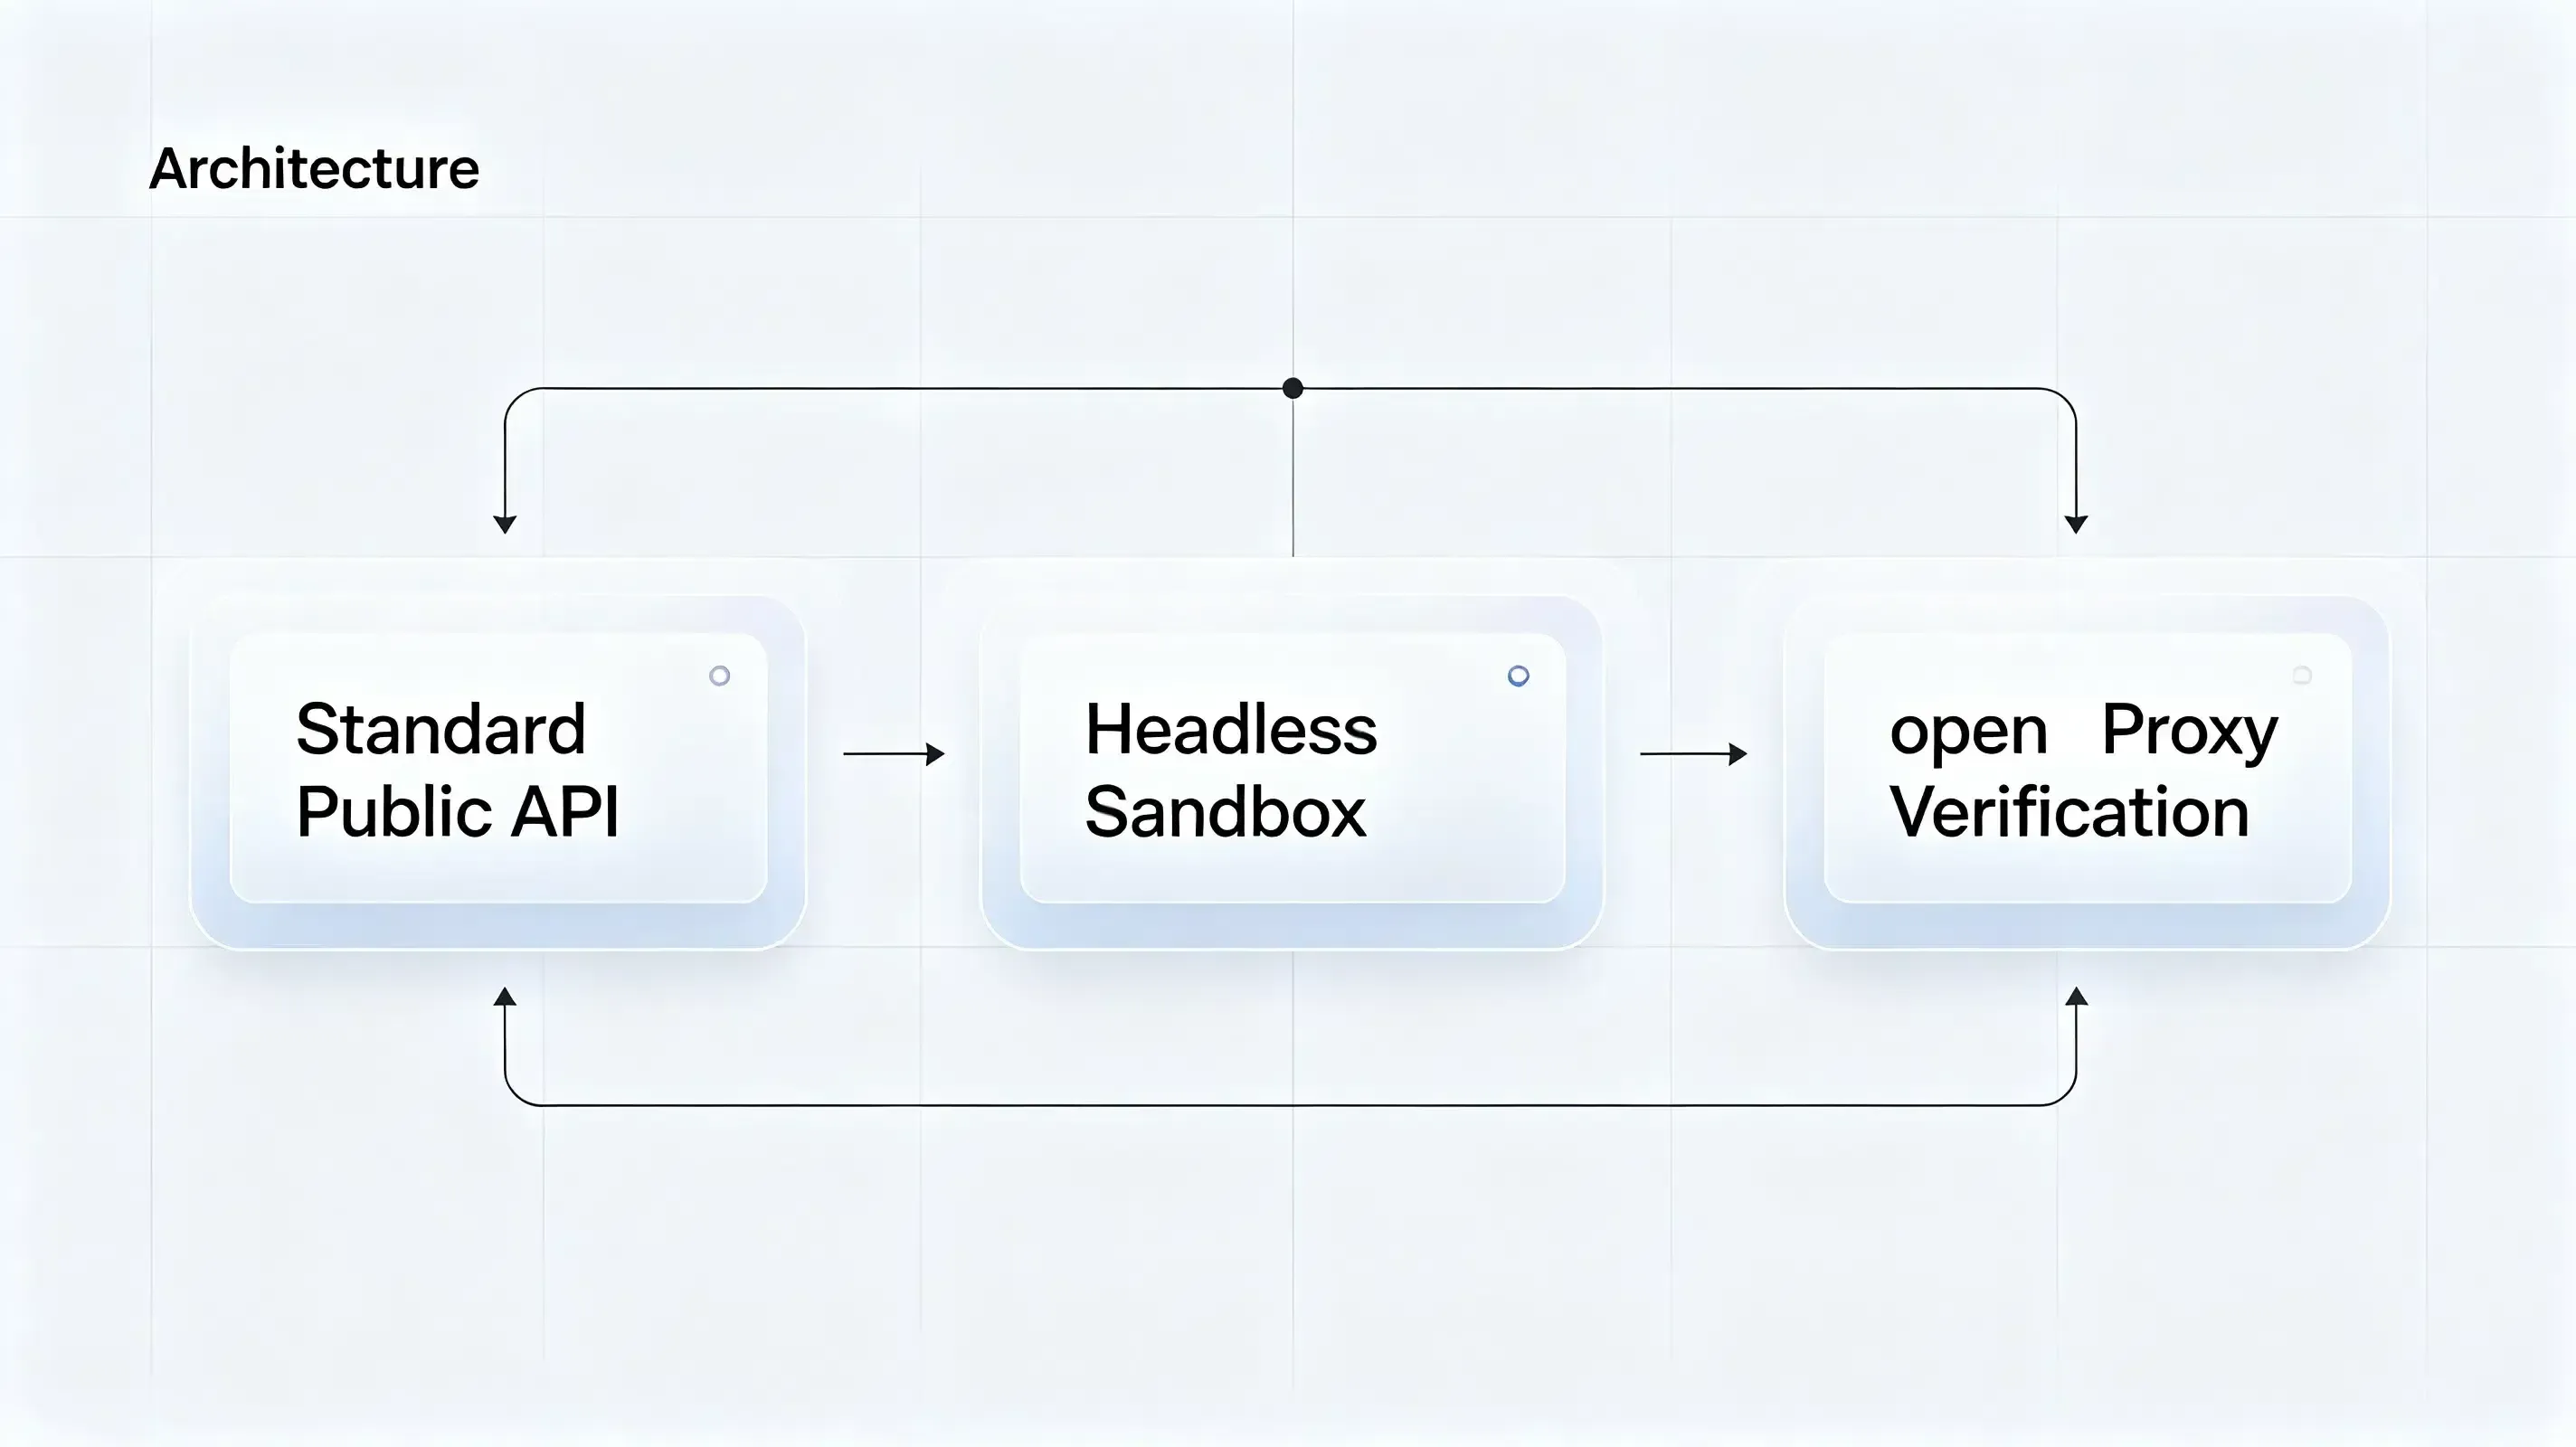
| Стандартный публичный API | ✅ Разрешен | ⚠️ Высокий | Низкий (Возможна утечка) |
| Изолированная песочница | ❌ Заблокирован | ❌ Нет | Высокий (Строгая изоляция) |
| Серверная верификация прокси | 🔄 Контролируемый | ❌ Нет | Высокий (Полный аудит) |
Коммерческие реализации этой архитектуры включают такие решения, как Branch, AppsFlyer, Adjust, Opoinstall и другие платформы отложенной атрибуции. Эти системы поддерживают серверное состояние перед установкой и восстанавливают параметры при первом запуске приложения, минуя проблемы надежности, связанные с клиентскими браузерными сессиями. Ряд программных платформ обеспечивает синхронизацию серверного состояния или программное сохранение параметров для распределенных циклов разработки. Одним из примеров такого подхода является Opoinstall, который сопоставляет параметры выполнения и метаданные сессии разработчика с централизованной базой данных состояний, гарантируя сохранение контекста даже при headless-выполнении начальных задач в изолированных облачных контейнерах. Инженерные команды могут оценивать эти подходы в соответствии с требованиями к развертыванию и точностью атрибуции, и, поскольку Meta запрещает «Claude» для защиты обучения модели Llama, подразделения разработки признают ценность таких архитектур с локализованной маршрутизацией данных.
Часто задаваемые вопросы (FAQ)
Затрагивает ли политика Meta по запрету Claude всех сотрудников компании?
Что необходимо экспортировать перед миграцией с внешних ИИ-инструментов на внутренние альтернативы?
Как атрибуция рефералов может работать в headless-средах разработки?
Практические выводы и прогнозы
Распространение строгих «песочниц» для разработчиков и правил комплаенса сетевого уровня сигнализирует о более широком сдвиге в сторону безопасных, изолированных сред программирования. По мере того как приложения все чаще взаимодействуют через автоматизированные обмены данными, а не через интерфейсы, ориентированные на человека, инженерным командам приходится пересматривать традиционные стратегии интеграции. Платформы, сильно зависящие от ручных, визуальных действий пользователей, могут столкнуться со структурными пробелами, когда автоматизированные агенты управляют пайплайном запросов. Переход к серверной атрибуции и безопасной передаче параметров представляет собой весьма вероятное направление для поддержания надежного трекинга и защиты данных.
Данный переход предполагает фундаментальное переосмысление наших измерительных фреймворков и протоколов безопасности. Будущие системы атрибуции, скорее всего, будут в большей степени опираться на сопоставление идентичности на сервере и безопасную синхронизацию состояний. Поскольку все больше ИИ-агентов начинают выступать основными драйверами генерации цифрового кода, безопасные инженерные архитектуры будут все больше зависеть от серверной изоляции, суверенитета данных и аудита контекста выполнения, а не только от прямых API-вызовов.
Share this article



