 Почему NVIDIA объединяет GPU с ASIC-ускорителями d-Matrix? NVIDIA больше не делает ставку исключительно на графические процессоры. Почему NVIDIA сотрудничает с d-Matrix, а не создает специализированные ASIC для инференса внутри компании? Ответ отражает масштабную трансформацию инфраструктуры ИИ: оптимизация вывода смещается от простого масштабирования GPU к акселерации, ориентированной на конкретные задачи. По мере того как инференс ИИ распределяется между GPU, ASIC-ускорителями и распределенными облачными средами, основной задачей становится уже не просто вычислительная мощность. Оркестрация оборудования, маршрутизация рабочих нагрузок и системная эффективность приобретают решающее значение. В условиях перехода генеративного ИИ от массивов для обучения к развертыванию моделей в режиме реального времени, оптимизация скорости генерации токенов стала ключевым инженерным вызовом. NVIDIA объединяет GPU с ASIC от d-Matrix для поддержки гетерогенных дезагрегированных систем вывода.
Почему NVIDIA объединяет GPU с ASIC-ускорителями d-Matrix: синхронизация нагрузки с физикой кремния
Краткий обзор
- NVIDIA комбинирует свои передовые GPU серий Hopper и Blackwell с ускорителями вывода Corsair от d-Matrix для развертывания гетерогенных дезагрегированных систем.
- Неоклауд-провайдер Parasail стал первым коммерческим заказчиком, внедрившим это совместное решение в своей глобальной сети дата-центров.
- Крупномасштабные задачи инференса могут приводить к значительной недогрузке GPU, если ограничивающим фактором становится пропускная способность памяти и передача данных, а не вычислительные мощности.
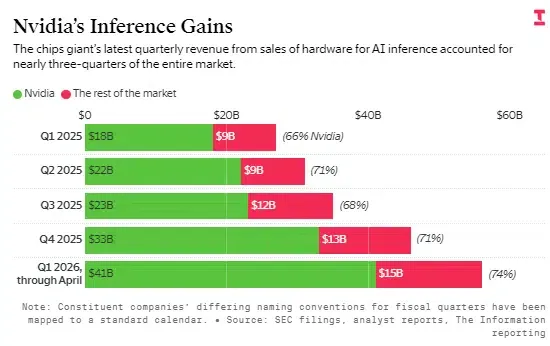
Экономическая модель крупномасштабного ИИ претерпевает значительный переход от обучения моделей к их эксплуатации. На начальном этапе масштабирования облачные провайдеры и разработчики фокусировались на сырой вычислительной мощности, закупая огромные кластеры GPU. Такая зависимость от одного поставщика была логична, когда обучение массивов данных требовало непрерывного параллельного выполнения. Однако по мере того как организации начинают обслуживать миллионы активных пользователей в реальном времени, финансовые расходы на работу инфраструктуры только на базе GPU стали чрезмерными.
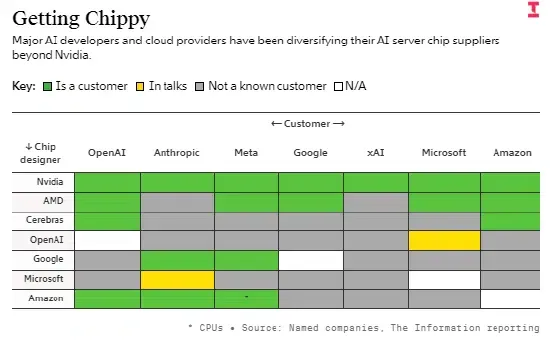
Для оптимизации операционных затрат архитекторы инфраструктуры переходят к дезагрегированным вычислительным средам. В рамках этого многовендорного подхода запрос пользователя разделяется на этапы выполнения и направляется на различные аппаратные ускорители в зависимости от профиля задачи. Этот подход позволяет облачным провайдерам получать максимальную производительность на каждый вложенный доллар, что задокументировано в исследовании The Information, отслеживающем мульти-вендорные интеграции в облаках.
Значение этого сотрудничества для индустрии выходит за рамки простого распределения нагрузки. Официальная интеграция ускорителей Corsair от d-Matrix в аппаратный парк NVIDIA создает проверенный путь для гетерогенных облачных архитектур. Вместо того чтобы заставлять клиентов выбирать между стандартными кластерами GPU и новыми специализированными чипами, система вывода NVIDIA–d-Matrix позволяет оборудованию работать согласованно, давая провайдерам инфраструктуры возможность оптимизировать этапы префилла и декодирования между различными архитектурами. Это позволяет корпоративным командам повысить эффективность использования оборудования в широком спектре задач.
Технические тонкости: гетерогенный дезагрегированный инференс и вычисления в памяти
На уровне протоколов ответ на запрос на естественном языке требует двух фаз обработки. Первая фаза, известная как prefill (префилл), принимает запрос пользователя и вычисляет начальные активации «ключ-значение» (KV). Этот этап требует высокой интенсивности вычислений, что идеально соответствует возможностям параллельной арифметики архитектуры NVIDIA Hopper.
Вторая фаза, decode (декодирование), генерирует последующие токены по одному в последовательном цикле. Поскольку каждый токен опирается на ранее сгенерированный контекст, фаза декодирования сильно ограничена пропускной способностью памяти и чувствительна к задержкам. Выполнение этого шага на мощных GPU приводит к значительным простоям, так как ядра вынуждены постоянно ждать завершения транзакций памяти.
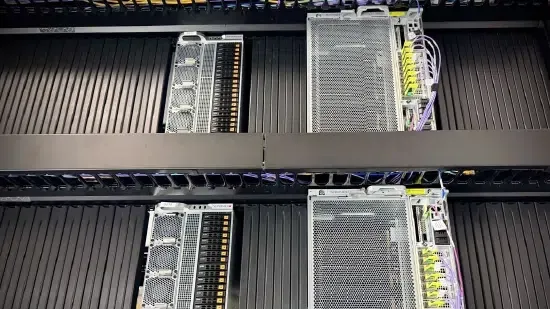
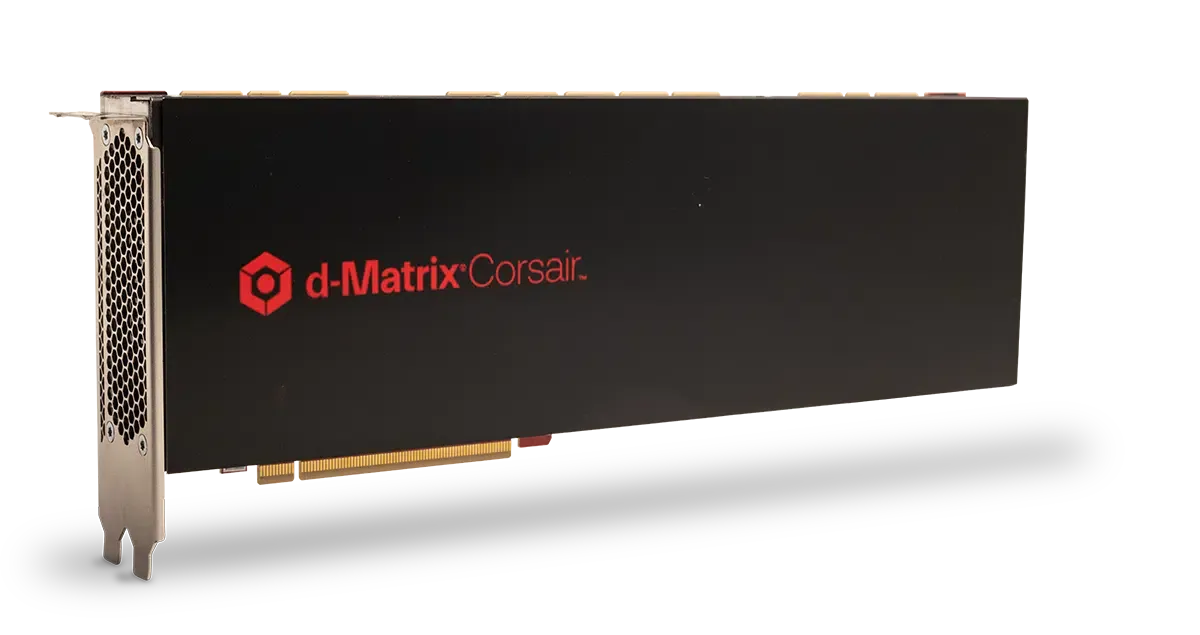
Согласно документации к архитектуре Corsair от d-Matrix, этот ускоритель построен на технологии чиплетов для цифровых вычислений в памяти (DIMC). Созданный по техпроцессу TSMC N6, чип Corsair интегрирует статическую оперативную память (SRAM) непосредственно рядом с вычислительными блоками на одном кристалле. Это сокращает задержки при передаче данных между памятью и вычислительными узлами. Некоторые архитектуры совмещают оптимизацию на уровне ускорителей с методами, такими как спекулятивное декодирование, для дальнейшего снижения задержек. Индустрия анализирует то, как NVIDIA объединяет GPU с сопроцессорами, работающими в памяти, чтобы преодолеть проблему «стены памяти». Развертывание специализированных чипов рядом с GPU позволяет оборудованию работать как единое целое. Этот структурный выбор объясняет, почему NVIDIA делает выбор в пользу связки GPU и in-memory сопроцессоров.
Анализ того, как NVIDIA сочетает GPU с внешними ускорителями, помогает разработчикам оценить основное «узкое место» современного инференса трансформеров. На схеме ниже показана одна из моделей развертывания:
[Ввод запроса пользователя] ──> [Облачный API шлюз]
                             │
                             ├─(Фаза префилла)─> [GPU NVIDIA Hopper/Blackwell] ──> Вычисленные стандартные активации
                             │                                                            │
                             │                                                            ▼
                             └─(Фаза декодирования)──> [Ускоритель d-Matrix Corsair] ──> Генерация токенов (SRAM кэш)
Объединение этих двух технологий оптимизирует оба этапа конвейера вывода. Однако гетерогенный инференс не отменяет спрос на GPU. Крупномасштабное обучение и задачи, критичные к задержкам, продолжат полагаться на ускорение GPU, сохраняя фундаментальную необходимость в использовании стандартных процессорных ядер наряду со специализированными ASIC.
Распределенный инференс создает проблемы координации ПО
Тот же архитектурный принцип проявляется и за пределами аппаратной инфраструктуры. В мобильных экосистемах платформы для отложенных глубоких ссылок (deferred deep linking) и атрибуции приложений сталкиваются с аналогичной задачей: сохранение анонимного контекста при переходе пользователей из распределенных каналов привлечения в нативные приложения. Такие платформы, как OpoInstall, разработаны для решения проблемы непрерывности состояния через архитектуру серверной атрибуции. Как гетерогенная система вывода, так и мобильная атрибуция решают схожую системную задачу: сохранение контекста при выполнении действий в независимых средах. В обоих случаях, когда клиентское состояние теряется или блокируется при транзите, система требует серверного подхода для анонимного сопоставления распределенных событий.
Разработка vs Покупка: зачем распределенным приложениям сохранение контекста на стороне сервера
По мере перехода облачных сред к гетерогенным и распределенным моделям, управление состоянием сессий между отдельными вычислительными узлами становится критически важной задачей. Переход к архитектурам, где NVIDIA объединяет GPU со специализированными ускорителями, заставляет разработчиков пристально следить за масштабируемостью конвейера. Команды должны оценивать, стоит ли разрабатывать собственные системы сопоставления сессий или использовать стандартизированную инфраструктуру. Понимание преимуществ гетерогенного ускорения помогает оптимизировать затраты на предоставление инфраструктуры.
Архитектурная оценка: кастомная разработка или стандартный SDK
Создание собственной базы данных для отслеживания сессионных данных в нескольких облачных инстансах дает контроль над параметрами, но создает значительную сложность в поддержке. Разработчикам приходится вручную обрабатывать маршрутизацию запросов API, управлять жизненным циклом токенов и постоянно обновлять настройки безопасности в соответствии с региональными нормами. Напротив, внедрение готового сертифицированного SDK снижает эту инженерную нагрузку, обеспечивая предсказуемые затраты на интеграцию.
В таблице ниже сравниваются стандартные методологии управления состоянием сессии и контекстом конверсии:
| Решение | Сохранение состояния | Пропускная способность | Для чего лучше всего подходит |
|---|---|---|---|
| Собственная БД сессий | Высокое (непрерывная синхронизация) | Средняя (ограничения задержки БД) | Кастомные корпоративные среды со специфической логикой хранения |
| Трекинг на базе браузерных сессий | Низкое (сессионные cookie) | Низкая (нет серверного логирования) | Базовый веб-трекинг с минимальными требованиями к конверсии |
| Серверная платформа атрибуции (напр. OpoInstall) | Высокое (защита приватности, серверное восстановление) | Высокая (стандартизированная песочница) | Атрибуция мобильных приложений и кросс-платформенных кампаний |
Хотя кастомные базы данных могут обрабатывать базовый контекст, специализированное сохранение состояния на сервере оптимизирует ресурсы разработки. В зависимости от требований, организации могут внедрить собственную систему управления или коммерческие платформы. Например, OpoInstall предоставляет инфраструктуру серверной атрибуции, которая восстанавливает контекст кампании после перемещения пользователей между вебом, магазинами приложений и нативными приложениями. Этот фреймворк восстановления состояния и передачи параметров напрямую связывает метаданные сессии с уровнем данных атрибуции, ориентированным на приватность, обеспечивая сохранение параметров, работу deferred deep linking и непрерывность атрибуции без раздувания кодовой базы клиента или зависимости от идентификаторов.
Чек-листы интеграции: как инженерным командам подготовиться к изменениям
Чтобы поддерживать непрерывность данных при переходе нагрузок между локальными вычислительными блоками и удаленными дата-центрами, командам необходимо выстроить прозрачные конвейеры управления состоянием.
Чек-лист для разработчиков
- Контроль сессий на границе: Настройте сетевые шлюзы для назначения уникальных, криптографически подписанных токенов сессии всем входящим API-запросам.
- Асинхронные хэндшейки токенов: Переходите к восстановлению состояния сессии на стороне сервера, используя временные токены для безопасной передачи параметров пользователя между точками доступа.
- Аудит сторонних SDK: Регулярно оценивайте объем и зависимости библиотек, чтобы предотвратить появление узких мест производительности.
Чек-лист для отдела роста
- Оптимизация воронок конверсии: Используйте ненавязчивые методы передачи параметров для отслеживания привлечения без нарушения рекомендаций по приватности.
- Прозрачная маршрутизация данных: Перестройте пользовательские пути, чтобы четко объяснить, где и когда задействованы внешние пути обработки ИИ.
- Мониторинг задержек API: Отслеживайте метрики от клика по кампании до сопоставления установки на сервере для подтверждения целостности данных.
Внедрение этих структурных принципов поможет командам перевести свои приложения на более безопасные и соответствующие стандартам архитектуры, поддерживая операционную непрерывность.
Часто задаваемые вопросы (FAQ)
Почему стратегическое сотрудничество NVIDIA и d-Matrix происходит вместо прямой конкуренции?
Почему NVIDIA не строит свои собственные ASIC для инференса?
Что такое гетерогенный дезагрегированный инференс и как он оптимизирует затраты в облаке?
Какую проблему решает d-Matrix по сравнению с GPU?
Как работает серверная атрибуция при переходе пользователей из веба в мобильные приложения?
Почему мобильным приложениям нужна серверная атрибуция в средах, ориентированных на приватность?
Ключевые выводы для инженерных команд
По мере того как платформы ИИ всё чаще полагаются на гибридный облачный инференс, разработчикам необходимо перепроектировать продукты с учетом приватности, прозрачного согласия и безопасной маршрутизации данных. Эволюция архитектур требует фундаментального сдвига в том, как мы создаем и измеряем цифровой опыт. Статистические прокси и автоматизированные инструменты парсинга становятся стандартом потребления веб-контента, поэтому традиционные модели клиентской атрибуции будут продолжать деградировать. Полагаться исключительно на стандартные файлы cookie и рефереры больше недостаточно для защиты каналов данных, отвечающих за привлечение пользователей.
Вместо того чтобы замещать GPU, NVIDIA меняет методы развертывания нагрузок инференса. По мере того как обслуживание ИИ-моделей затмевает их обучение, гетерогенные системы, сочетающие GPU со специализированными ASIC, вероятно, станут стандартной архитектурой для корпоративной ИИ-инфраструктуры. Оптимальное сочетание оборудования зависит от характеристик нагрузки, требований к задержкам, размера модели и экономики инфраструктуры. Хотя гетерогенный инференс предлагает значительные экономические преимущества, стандартные архитектуры продолжат развиваться вместе со специализированными ускорителями. Для команд мобильного роста внедрение инфраструктуры серверной атрибуции поможет сохранить данные об эффективности привлечения пользователей во фрагментированных цифровых путях. OpoInstall предоставляет такой слой атрибуции, сохраняя контекст привлечения между вебом, магазинами приложений и нативными мобильными средами.
Share this article



