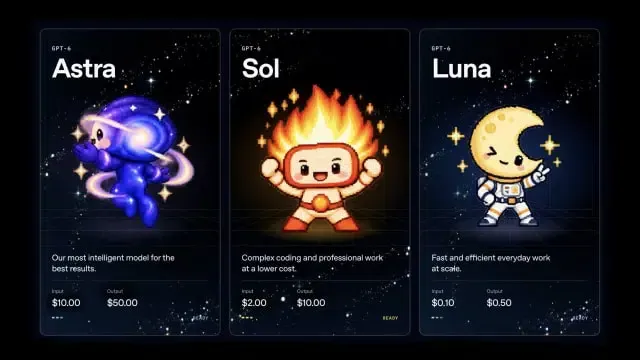
OpenAI снижает стоимость Sol API вдвое? Компания OpenAI официально объявила о коммерческом запуске GPT-6 Sol и GPT-6 Luna 22 сентября 2026 года, снизив расценки на токены API на 50% и более по сравнению с предыдущими промо-ценами на стандартные эндпоинты GPT-5.6. Для стандартной обработки промптов с количеством входных токенов до 272 тыс. стоимость GPT-6 Sol составляет $2.00 за миллион входных и $10.00 за миллион выходных токенов, в то время как более компактная модель GPT-6 Luna обойдется в $0.10 за входные и $0.50 за выходные токены на миллион. Когда OpenAI снижает стоимость Sol API на стандартных уровнях для разработчиков, структурное снижение стоимости вычислений меняет операционные ограничения генеративного софта. Более низкая удельная стоимость делает экономически выгодными в масштабе рекурсивные агентные циклы, фоновое пакетное извлечение данных и автономных многошаговых воркеров. Однако для системных архитекторов, инженеров по надежности и бэкенд-разработчиков снижение финансового барьера обнажает проблемы масштабируемости в будущем, смещая фокус инженерной мысли с бюджетов токенов на границы лимитов запросов, ограничения параллелизма, конвейеры телеметрии и узкие места обратного давления.
Операционная проблема и финансовые узкие места
На ранних этапах внедрения LLM на корпоративном уровне номинальная стоимость токенов служила неформальным архитектурным регулятором. Высокие затраты на инференс заставляли команды разработчиков относиться к вызовам моделей как к дискретным транзакциям, инициируемым пользователем. Приложения во многом полагались на ручное подтверждение (human-in-the-loop), ограниченную историю диалогов и строго контролируемые запланированные фоновые задачи, чтобы счета от провайдеров оставались предсказуемыми. Появление постоянного снижения цен на модели среднего уровня ставит под сомнение эти устоявшиеся компромиссы, смещая заботы системной инженерии с ценообразования моделей на отказоустойчивость бэкенд-инфраструктуры.
Краткий обзор
- Базовое снижение цен: 22 сентября 2026 года OpenAI представила GPT-6 Sol по цене $2.00 за ввод / $10.00 за вывод и GPT-6 Luna по цене $0.10 за ввод / $0.50 за вывод на миллион токенов для стандартной обработки промптов объемом до 272 тыс. токенов, что представляет собой номинальное снижение на 50% или более по сравнению с промо-ценами API GPT-5.6.
- Экономика бенчмарков уровня задач: В AutomationBench 1.0.6 компания OpenAI сообщает, что модель GPT-6 Sol при настройке рассуждений xhigh достигла оценки рабочего процесса 33.2% при средней заявленной стоимости $0.27 за попытку выполнения задачи, перенося оценку разработчиков с чистой стоимости токенов на стоимость за единицу выполненной работы.
- Динамика кэширования промптов: Платформа обеспечивает автоматическую скидку 90% на чтение кэшированных входных токенов (с тарификацией 0.1× от базовой ставки входного токена), в то время как первичное создание кэша тарифицируется по коэффициенту 1.25× от ставки некаэшированного входного токена, что требует тщательной нормализации префиксов для поддержания высокого процента попаданий в кэш при динамических многошаговых запусках.
Как подробно описано в официальной справочной документации по ценам OpenAI Developer API и объявлении в сообществе OpenAI, эти структуры ценообразования проистекают из постоянных улучшений конвейеров низкоуровневого инференса и систем KV-кэширования. Тем не менее, когда стоимость выполнения автоматизированных последовательностей задач существенно падает, инженерные команды расширяют масштаб фоновых задач. Экономический порог, ранее препятствовавший непрерывному опросу, автоматическому код-ревью или многоэтапному извлечению документов фоновыми воркерами, снизился.
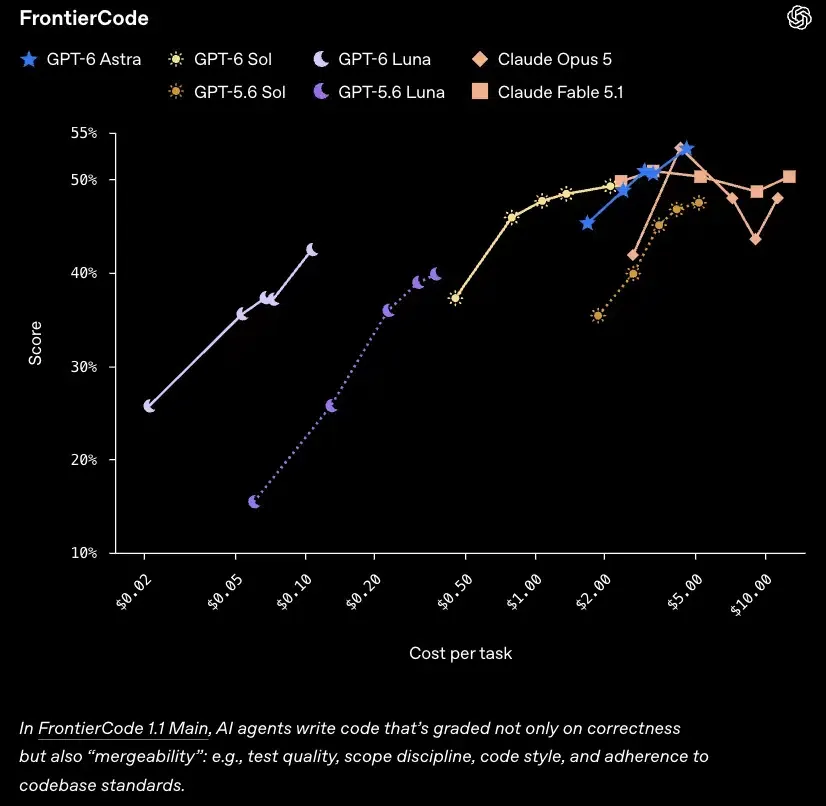
На рынке несколько провайдеров базовых моделей снизили или реструктурировали цены на API на разных уровнях для разработчиков. Компания Anthropic выпустила Claude Opus 5.5 вместе с обновленными спецификациями в документе Anthropic Claude Opus 5.5 Platform Specification, указав расценки $4 за миллион входных токенов, $0.20 за миллион кэшированных входных чтений и $20 за миллион выходных токенов, что подчеркивает снижение потребления токенов в бенчмарках рефакторинга кода. Параллельно Google сохраняет промо-цены на запуск Gemini 3.8 Flash, задокументированные на Google AI for Developers, а релизы с открытыми весами, такие как MiMo-V2.6-Pro от Xiaomi, предоставляют командам самостоятельного хостинга выгодные варианты стоимости токенов в рамках мягких лицензий на ПО.
Когда стоимость моделей падает, модели поведения разработчиков меняются. Инженерные команды развертывают более глубокие рекурсивные циклы, внедряют исчерпывающую корпоративную документацию в системные промпты и настраивают автоматическую логику повторных попыток в сложных графах задач. То, что начинается как снижение затрат на уровне API, может перенести задержки и всплески трафика на внутренние сервисы. Если оркестрационный воркер генерирует десятки последовательных или параллельных вызовов модели для одной пользовательской транзакции, внутренние пулы баз данных, вспомогательные хранилища, конвейеры телеметрии и ограничители частоты запросов должны справляться с возникающей нагрузкой.

Системные первопричины и не визуальные цепочки запросов
Когда клиентские приложения переходят от интерактивных чат-интерфейсов к не визуальной фоновой автоматизации, профили входящих запросов кардинально меняются. Одно бизнес-событие может инициировать автономный конвейер, который проверяет схемы, оценивает переменные окружения, вызывает внешние инструменты и проверяет результаты в ходе нескольких непрерывных проходов.
+-----------------------------------------------------------------------------------------+
|                  RECURSIVE AGENT EXECUTION & BACKPRESSURE BOTTLENECK                    |
+-----------------------------------------------------------------------------------------+
|                                                                                         |
|  [ User Web / App Trigger ]                                                             |
|         |                                                                               |
|         v                                                                               |
|  [ Ingestion API Gateway ]                                                              |
|         |                                                                               |
|         +---> Spawns Autonomous Worker Instance                                         |
|         |                                                                               |
|         v                                                                               |
|  [ Autonomous Orchestration Loop (GPT-6 Sol / Luna) ]                                   |
|         |                                                                               |
|         +--- Step 1: Query Context (Cache Read) -----------------+                      |
|         |                                                        |                      |
|         +--- Step 2: Tool Execution (Uncached Call)              |                      |
|         |                                                        |                      |
|         +--- Step 3: Self-Correction Validation                  |                      |
|         |                                                        v                      |
|         +--- Step 4: Recursive Execution Fork ----> [ Bursting Internal RPCs ]          |
|                                                                  |                      |
|  [ Downstream System Bottlenecks ]                               |                      |
|         |                                                        |                      |
|         +--- Internal Microservices <-- (Connection Starvation) -+                      |
|         +--- PostgreSQL / Cache Stores <-- (Connection Pool Saturation)                 |
|         +--- Distributed Telemetry Stream <-- (Lossy Drop Buffer Applied)               |
|         +--- Audit Compliance Store <-- (Durable / Replayable Queue Lag)                |
|         +--- Upstream Provider Thresholds <-- (HTTP 429 Rate Limit Exhaustion)          |
|                                                                                         |
+-----------------------------------------------------------------------------------------+
Рекурсивное выполнение агентов и мультипликация параллелизма
В традиционных интерактивных веб-системах объем запросов отражает ритмы взаимодействия с человеком. Каждый HTTP-поток обычно соотносится с конкретным действием пользователя, при этом общий коэффициент ветвления ниже, а темп ограничен временем раздумий человека. Клиентская среда выполнения отправляет полезную нагрузку, ожидает ответа и делает паузу перед началом последующих взаимодействий.
Сравнение концептуальных профилей запросов: интерактивный режим и режим агентов
| Архитектурная метрика | Интерактивный пользовательский сценарий | Цикл автономного агента |
|---|---|---|
| Модель параллелизма | Ветвление запросов в темпе пользователя обычно ниже | 1 входящее событие = N связанных дочерних вызовов |
| Время выполнения | Регулируется ответом пользователя и временем на размышления | Происходит автоматически до достижения лимитов политики |
| Инвалидация контекста | Свежие данные для каждой сессии | Активно опирается на кэшированный контекст |
| Обработка ошибок | Повторная попытка пользователя при ошибке | Автоматические программные повторы |
| Системные узкие места | Пропускная способность фронтенд-шлюза | Лимиты пула внутренних баз данных |
| Каскадные сбои | Изолированы одной сессией | Могут вызвать переполнение очередей |
Когда системы интегрируют автономных агентов, этот темп рассогласовывается. Одно инициированное событие может породить непрерывную последовательность автоматических вызовов. Если агент сталкивается с временной ошибкой или некорректным выводом инструмента, наивная логика повторных попыток может генерировать быстрые всплески запросов к бэкенд-сервисам. Поскольку сниженная стоимость токенов делает более длинные запуски экономически доступными, автоматизированные рабочие процессы могут значительно масштабировать объем фоновых запросов даже при неизменной базе активных пользователей.
Механика кэширования промптов: повторное использование KV, накладные расходы на запись и стабильность префиксов
OpenAI сопроводила релизы Sol и Luna оптимизацией подсистемы кэширования промптов. Как задокументировано в спецификации кэширования промптов OpenAI, входные токены, совпадающие с кэшированным префиксом, получают скидку 90% на чтение. Кэширование промптов в первую очередь снижает объем перерасчетов на стороне модели, а не выступает универсальным механизмом сжатия сетевого трафика. Во время стандартных безсостояниевых взаимодействий клиентское приложение передает контекст запроса, а провайдер пропускает пересчет KV-тензоров для совпадающего префикса, существенно сокращая задержку до получения первого токена и затраты на ввод.
Важно отметить, что запись начального префикса в кэш на стороне сервера тарифицируется по коэффициенту 1.25× от стоимости некашированного входного токена. Максимизация экономической эффективности требует поддержания стабильности префиксов в течение нескольких запросов.
Выбранные публичные базовые цены API — некорректно сравнивать напрямую у разных провайдеров
| Идентификатор модели | Ввод ($/1 млн. токенов) | Вывод ($/1 млн. токенов) | Политика чтения кэша |
|---|---|---|---|
| OpenAI GPT-6 Luna (Std) | $0.10 | $0.50 | Скидка 90% (0.10×) |
| OpenAI GPT-6 Sol (Std) | $2.00 | $10.00 | Скидка 90% (0.10×) |
| OpenAI GPT-6 Astra (Std) | $10.00 | $50.00 | Динамическое многоуровневое ценообразование |
| Anthropic Opus 5.5 | $4.00 | $20.00 | $0.20 за 1 млн. чтений (0.05×) |
| Anthropic Sonnet 5 | $2.00 | $10.00 | До 90% на кэш |
| Google Gemini 3.8 Flash | $0.75 (промо) | $3.75 (промо) | $0.075 за 1 млн. кэшированных чтений |
| Xiaomi MiMo-V2.6-Pro | $0.435 | $0.87 | $0.0036 за 1 млн. кэшированных чтений |
Примечание: Стандартные расценки применяются к уровням с коротким контекстом (промпты до 272 тыс. входных токенов для OpenAI). Провайдеры устанавливают различные накладные расходы на запись в кэш, ограничения контекста и временные промо-условия.
Сохранение префиксов требует аккуратного обращения с параметрами конфигурации API. В архитектуре API от OpenAI прямое изменение параметров интенсивности рассуждений или массивов описания инструментов изменяет рендеринг префикса промпта и аннулирует предыдущие состояния кэша.
Для сохранения кэшированного контекста в течение многосессионных сценариев разработчики должны поддерживать неизменный порядок схем инструментов и базовых инструкций. Если требуются изменения во время выполнения, разработчики должны обновлять параметры через элементы управления структурированными сессиями (например, configuration_update) или переключать выполнение инструментов с помощью tool_choice или allowed_tools вместо прямого изменения массива определений инструментов.
При промахах кэша апстрим-провайдер повторно обрабатывает входную последовательность без скидки 90% на чтение. В масштабе это может увеличить задержку инференса и риск превышения таймаутов. Для многошагового выполнения задач оценка стоимости смещается от простых множителей токенов к затратам на завершенные задачи, как показано в отчете VentureBeat по бенчмаркам GPT-6 Sol и Luna, где GPT-6 Sol достиг оценки 33.2% в AutomationBench 1.0.6 при среднем значении $0.27 за попытку решения задачи.
Архитектура телеметрии: отделение операционных метрик от аудита соответствия требованиям
Всплеск автоматизированных запросов к LLM создает серьезную нагрузку на бэкенд-наблюдаемость и конвейеры комплаенса. Агентные рабочие процессы с высокой степенью параллелизма требуют четкого архитектурного разделения между операционной телеметрией и журналами юридического аудита.
Корпоративные политики комплаенса часто требуют записи метаданных сессий, подтверждений выполнения инструментов и записей транзакций. Одинаковое отношение к операционной телеметрии и данным комплаенса порождает серьезные инженерные компромиссы:
- Каналы аудита безопасности и соответствия: Должны обеспечивать надежную доставку с возможностью повтора через явную обработку повторных попыток, персистентности и сбоев в хранилищах аудита с однократной записью и защищенным доступом. Полезная нагрузка должна фиксировать структурированные метаданные, идентификатор вызывающего абонента и криптографическое состояние, систематически очищая персональные данные (PII) и секретные ключи. При высокой нагрузке эти конвейеры должны применять обратное давление или ставить задачи в надежную очередь вместо отбрасывания записей.
- Каналы операционной телеметрии: Отслеживают показатели производительности, такие как количество токенов, коэффициенты попадания в кэш промптов и задержки ответов на стороне провайдера. Поскольку эти трассировки используются для мониторинга и отладки в реальном времени, они могут обрабатываться через ограниченные буферы с потерями при сбросе. Если нижестоящие коллекторы замедляются, приложение может безопасно отбросить избыточную операционную телеметрию для сохранения доступности основного сервиса.
Когда внешние провайдеры возвращают ошибки ограничения частоты HTTP 429, неправильно настроенная политика повторных попыток может вызвать серьезные операционные проблемы. Немедленные повторные попытки или синхронизированные алгоритмы экспоненциальной задержки без рандомизированного джиттера создают волны повторов, которые могут каскадом распространяться по промежуточным микросервисам, исчерпывая пулы потоков и соединения с базами данных.
Сравнение решений: компромиссы между разработкой своими силами и покупкой
Управление операционной нагрузкой, возникающей из-за снижения затрат на инференс, требует от организаций оценки архитектур шлюзов ИИ и прокси-серверов. Командам предстоит решить, разрабатывать ли собственную маршрутизацию, ограничение частоты запросов и прокси телеметрии собственными силами или развертывать специализированную инфраструктуру сторонних разработчиков.
+-----------------------------------------------------------------------------------------+
|                 SYSTEM RESILIENCY PIPELINE WITH DECOUPLED TELEMETRY                     |
+-----------------------------------------------------------------------------------------+
|                                                                                         |
|  [ Inbound Application Requests ]                                                       |
|         |                                                                               |
|         v                                                                               |
|  [ Sliding-Window Rate Limiter ] <--- Local In-Memory or Distributed Cache              |
|         |                                                                               |
|         +---> Rejects / Delays Excess Concurrency (HTTP 429 Protection)                 |
|         |                                                                               |
|         v                                                                               |
|  [ Prompt Normalization & Cache Alignment Engine ]                                      |
|         |                                                                               |
|         +---> Pins Static System Prompts & Tool Definitions to Base Prefix              |
|         +---> Uses Structured Controls to Modify Session Parameters                     |
|         |                                                                               |
|         v                                                                               |
|  [ Upstream Provider Dispatch (OpenAI / Anthropic / Local API) ]                         |
|         |                                                                               |
|         +---------------------------------------+---------------------------------------+
|         |                                       |                                       |
|         v (Synchronous Fast Path)               |                                       |
|  [ Client Response Assembly ]                   |                                       |
|         |                                       v (Asynchronous Dual Path)              |
|         v                               +-----------------------------------------------+
|  [ Return Payload to App ]              |                                               |
|                                         v (Lossy Ring Buffer)   v (Durable Outbox)      |
|                                    [ Operational Metrics ]  [ Compliance Audit Store ]  |
|                                    (Drops on Congestion)    (Durable / Replayable)      |
|                                                                                         |
+-----------------------------------------------------------------------------------------+
Собственные конвейеры обеспечения отказоустойчивости
Создание собственной инфраструктуры дает инженерным командам полный контроль над сетевыми политиками, очисткой данных и стратегиями маршрутизации. Организации могут создавать пограничные прокси-серверы, адаптированные под их точные топологии внутренних микросервисов.
// Reference implementation: Synchronized Token Bucket with fractional remainder and bounded saturation
package com.example.ai.resilience;

import java.math.BigInteger;
import java.time.Duration;

public final class TokenBucketLimiter {
    private final long maxTokenCapacity;
    private final long refillPeriodNanos;
    private long availableTokens;
    private long lastRefillNanos;
    // Scaled remainder numerator in the range [0, refillPeriodNanos)
    private long scaledRemainder;

    public TokenBucketLimiter(long maxTokens, Duration refillPeriod) {
        if (maxTokens <= 0 || refillPeriod.isZero() || refillPeriod.isNegative()) {
            throw new IllegalArgumentException("Invalid boundary configuration for TokenBucketLimiter.");
        }
        this.maxTokenCapacity = maxTokens;
        this.refillPeriodNanos = refillPeriod.toNanos();
        this.availableTokens = maxTokens;
        this.lastRefillNanos = System.nanoTime();
        this.scaledRemainder = 0L;
    }

    public synchronized boolean tryAcquire(long requestedUnits) {
        if (requestedUnits <= 0) {
            return false;
        }
        refillTokens();
        if (requestedUnits > availableTokens) {
            return false;
        }
        availableTokens -= requestedUnits;
        return true;
    }

    private void refillTokens() {
        long nowNanos = System.nanoTime();
        long elapsedNanos = nowNanos - lastRefillNanos;

        if (elapsedNanos <= 0) {
            return;
        }

        // Advance baseline timestamp monotonically
        this.lastRefillNanos = nowNanos;

        // If bucket is already full, discard unconsumed fractional credits to prevent timing drift
        if (this.availableTokens >= this.maxTokenCapacity) {
            this.scaledRemainder = 0L;
            return;
        }

        long wholePeriods = elapsedNanos / refillPeriodNanos;
        long remElapsedNanos = elapsedNanos % refillPeriodNanos;

        // Fast-path: if at least one complete period has elapsed, the bucket fully replenishes to capacity.
        // This eliminates the multiplication overflow surface (wholePeriods * maxTokenCapacity).
        if (wholePeriods > 0) {
            this.availableTokens = maxTokenCapacity;
            this.scaledRemainder = 0L;
            return;
        }

        // Under sub-period micro-intervals, calculate exact fractional tokens using BigInteger arithmetic
        BigInteger bigRemNanos = BigInteger.valueOf(remElapsedNanos);
        BigInteger bigCapacity = BigInteger.valueOf(maxTokenCapacity);
        BigInteger bigRemainder = BigInteger.valueOf(scaledRemainder);
        BigInteger bigPeriod = BigInteger.valueOf(refillPeriodNanos);

        // totalWork = (remElapsedNanos * maxTokenCapacity) + scaledRemainder
        BigInteger totalWork = bigRemNanos.multiply(bigCapacity).add(bigRemainder);
        BigInteger[] divAndRem = totalWork.divideAndRemainder(bigPeriod);

        long tokensGenerated = divAndRem[0].longValue();
        this.scaledRemainder = divAndRem[1].longValue();

        if (tokensGenerated > 0) {
            long spaceLeft = maxTokenCapacity - availableTokens;
            if (tokensGenerated >= spaceLeft) {
                this.availableTokens = maxTokenCapacity;
                this.scaledRemainder = 0L;
            } else {
                this.availableTokens += tokensGenerated;
            }
        }
    }
}
Однако внутренняя разработка требует постоянного инженерного обслуживания. Командам приходится вручную адаптироваться к обновлениям API провайдеров, обрабатывать изменяющиеся лимиты запросов от множества вендоров и управлять очередями распределенной телеметрии. Эти накладные расходы на обслуживание могут отвлекать ресурсы внутренних разработчиков от создания ключевых функций продукта.
Коммерческие шлюзы и инструменты инфраструктуры
Чтобы избежать создания этих возможностей с нуля, многие предприятия развертывают управляемые прокси API, шлюзы LLM и пограничные плоскости управления. Некоторые управляемые шлюзы обеспечивают координацию ограничения частоты с учетом особенностей провайдеров, наблюдаемость, управление политиками и маршрутизацию с учетом кэширования; конкретные возможности различаются в зависимости от вендора, а оптимизация префиксов часто по-прежнему требует дисциплины запросов на уровне приложений.
Коммерческие платформы позволяют инженерным командам устанавливать квоты затрат для каждой среды, настраивать автоматическую резервную маршрутизацию между семействами моделей и удалять конфиденциальные данные клиентов перед логированием метаданных запросов. Специализированные шлюзы управляют всплесками параллелизма, отслеживают тенденции потребления API и защищают нижестоящие микросервисы в сложных средах приложений.
Матрица решений: собственный конвейер против управляемых платформ
| Критерии оценки | Инструменты отказоустойчивости собственными силами | Управляемая инфраструктура маршрутизации |
|---|---|---|
| Первоначальные затраты на разработку | Высокие (3-6 инженерных недель) | Низкие (интеграция через стандартный API) |
| Поддержка протоколов | Постоянная ответственность команды | Решается за счет обновлений вендора |
| Операционный контроль | Полная видимость стека | Ограничен интерфейсом вендора |
| Тюнинг кэша промптов | Требуются кастомные прокси | Зависит от вендора; обычно требует взаимодействия с приложением |
| Изоляция телеметрии | Управление кастомными очередями | Зависит от вендора |
| Профиль финансовых затрат | Накладные расходы на зарплату инженеров | Повторяющиеся расходы на SaaS / оплату по факту использования |
Чек-листы интеграции и графики регламента
Организации, масштабирующие использование моделей после снижения цен на GPT-6 Sol и Luna, могут использовать этот операционный каркас для предотвращения системных перегрузок:
+-----------------------------------------------------------------------------------------+
|                  ENTERPRISE LLM INFRASTRUCTURE READINESS CHECKLIST                      |
+-----------------------------------------------------------------------------------------+
| [ ] Провести аудит клиентских приложений на предмет выявления неконтролируемых рекурсивных циклов вызова моделей |
| [ ] Установить жесткие ограничения тайм-аутов и нелинейные задержки повторных попыток с рандомизированным джиттером |
| [ ] Внедрить локальные и пограничные токен-бакеты для ограничения частоты запросов перед вызовами в апстрим |
| [ ] Организовать структуру промптов для максимизации повторного использования префиксов кэша |
| [ ] Отделить операционную телеметрию с потерями от надежных и пригодных для повторного воспроизведения журналов аудита |
| [ ] Добавить выборку во время выполнения для удаления тел сырых промптов из высокочастотных трассировок |
| [ ] Мониторить тенденции статусов HTTP 429 и настроить триггеры автоматического обратного давления |
| [ ] Настроить оповещения о затратах и выключатели нагрузки для отлова вышедших из-под контроля автоматических заданий |
+-----------------------------------------------------------------------------------------+
Конфигурация конвейера телеметрии
Системы наблюдаемости должны отделять логирование промптов от путей запросов в реальном времени. При обработке высокочастотных агентных нагрузок приложения должны записывать метаданные телеметрии в асинхронные очереди с ограниченной памятью, предотвращая задержки ввода-вывода в случае замедления работы коллекторов нижестоящей телеметрии.
// Reference implementation: Memory-bounded telemetry logger with lossy load shedding
package com.example.ai.resilience;

import java.util.concurrent.ArrayBlockingQueue;
import java.util.concurrent.BlockingQueue;
import java.util.concurrent.atomic.AtomicLong;

public final class BoundedTelemetryQueue {
    public static final class LogPayload {
        public final String traceId;
        public final String modelId;
        public final long promptTokens;
        public final long completionTokens;
        public final boolean cacheHit;

        public LogPayload(String traceId, String modelId, long pTokens, long cTokens, boolean hit) {
            this.traceId = traceId;
            this.modelId = modelId;
            this.promptTokens = pTokens;
            this.completionTokens = cTokens;
            this.cacheHit = hit;
        }
    }

    private final BlockingQueue<LogPayload> internalQueue;
    private final AtomicLong droppedEvents = new AtomicLong(0);

    public BoundedTelemetryQueue(int maxQueueCapacity) {
        if (maxQueueCapacity <= 0) {
            throw new IllegalArgumentException("Queue capacity must be positive.");
        }
        this.internalQueue = new ArrayBlockingQueue<>(maxQueueCapacity);
    }

    public boolean recordEvent(LogPayload payload) {
        if (payload == null) {
            return false;
        }
        // Non-blocking submission: drops telemetry under load to preserve app stability
        boolean accepted = internalQueue.offer(payload);
        if (!accepted) {
            droppedEvents.incrementAndGet();
        }
        return accepted;
    }

    public LogPayload pollEvent() {
        return internalQueue.poll();
    }

    public long getDroppedEventCount() {
        return droppedEvents.get();
    }
}
Часто задаваемые вопросы (FAQ)
Каковы официальные расценки API для GPT-6 Sol и Luna?
Как кэширование промптов снижает затраты при длинных диалогах?
Почему удешевление токенов увеличивает операционный риск бэкенда?
Основные выводы для инженерных команд
Запуск GPT-6 Sol и Luna ускоряет более масштабную тенденцию: передовой уровень интеллекта становится дешевле и доступнее. Поскольку стоимость токенов резко падает, финансовые ограничения перестают быть эффективным механизмом контроля для программных архитектур.
Поскольку организации внедряют высокочастотных агентов и многоуровневые топологии моделей, операционная инженерия становится критически важной для успеха предприятия. Командам необходимо выйти за рамки оценки моделей исключительно по номинальным ценам токенов или результатам бенчмарков. Долгосрочная надежность будет зависеть от того, насколько эффективно системы управляют параллелизмом, выстраивают контексты промптов для повторного использования кэша, корректно обрабатывают лимиты запросов на апстриме и отделяют телеметрию от критических путей приложения. Организации, которые построят отказоустойчивую инфраструктуру, смогут успешно масштабировать свои автоматизированные рабочие процессы агентов без ущерба для времени безотказной работы и стабильности системы.
Первоисточники и справочная документация
-
Справочник цен OpenAI Developer API: Официальные тарифные сетки для разработчиков, ограничения контекстного окна (стандартный порог ≤272 тыс.) и графики цен на чтение/запись кэша для GPT-6 Sol, Luna и Astra.
-
Объявление в сообществе OpenAI: Публичное раскрытие информации, подтверждающее снижение базовой цены на 50% по сравнению с промо-уровнями GPT-5.6, и детали поэтапного внедрения.
-
Спецификация кэширования промптов OpenAI: Архитектурная документация по повторному использованию префиксов «ключ-значение» на стороне сервера, накладным расходам на запись в кэш и правилам инвалидации конфигурации.
-
Спецификация платформы Anthropic Claude Opus 5.5: Официальная спецификация релиза, подтверждающая расценки $4 за ввод / $20 за вывод / $0.20 за чтение кэша и производительность в бенчмарках.
-
Обзор Anthropic Claude Sonnet 5: Официальный прейскурант разработчика и метрики эффективности кэширования промптов ($2 за ввод / $10 за вывод / скидка на кэш до 90%).
-
Прейскурант Google AI for Developers: Обзор тарифов для разработчиков и вводных правил ценообразования для Gemini 3.8 Flash.
-
Официальные расценки на API и график тарифов Xiaomi MiMo: Канонические зарубежные тарифы на токены с оплатой по факту использования для инференса MiMo-V2.6-Pro ($0.435 за ввод / $0.87 за вывод / $0.0036 за попадание в кэш).
-
Отчет VentureBeat о бенчмарках GPT-6 Sol и Luna: Освещение экономики релиза, постоянных ценовых гарантий и показателей стоимости задач AutomationBench 1.0.6 ($0.27 за попытку решения задачи).
Share this article



