OpenAI расследует ситуацию с «Codex»? Эта стратегическая инициатива была подтверждена после того, как инженерная команда начала экстренно устранять аномальное истощение биллинговых лимитов среди базы разработчиков. 29 июня 2026 года компания создала оперативный штаб для расследования жалоб пользователей на то, что квоты премиум-аккаунтов исчерпывались в течение одного-двух дней при обычном рефакторинге кода. Для команд разработчиков и продакт-лидов этот внезапный кризис квот подсвечивает технический переход: поскольку процессы разработки меняются от ручного написания кода к непрерывному выполнению циклов с помощью агентов, аудит среды исполнения должен опуститься на уровень SDK, чтобы защитить бюджетные границы предприятия.
Краткий обзор
- Аномальное истощение квот: OpenAI работает с отчетами о том, что пользователи плана Codex Pro исчерпывают еженедельные лимиты за один-два дня.
- Ложноположительные срабатывания защиты: Инженерная команда установила, что причиной инцидента стали скрипты платформы по борьбе со злоупотреблениями и ограничению скорости, которые ошибочно помечали обычные программные рабочие процессы.
- Операционный риск: Односторонний сброс лимитов во время активных циклов разработки вносит операционную нестабильность в работу организаций, строящих свои решения на базе внешних AI-эндпоинтов.
Структурное выравнивание и кризис квот разработчиков
Согласно обновлениям статуса, опубликованным OpenAI, 28 июня 2026 года была создана экстренная целевая группа для расследования того, почему платные подписчики исчерпывали еженедельные квоты во время коротких сессий рефакторинга. Ведущий инженер Codex Тибо Соттио подтвердил, что встроенные системы борьбы с мошенничеством и предотвращения злоупотреблений ошибочно ограничивали скорость работы стандартных аккаунтов разработчиков, что приводило к их аномальному истощению. Чтобы смягчить последствия инцидента, инженерная группа инициировала универсальный сброс квот. Это быстрое вмешательство стало необходимым, так как разработчики все чаще внедряют инструменты генерации кода в непрерывные спринты разработки, а не используют их для эпизодических экспериментов, превращая мелкие перебои в платформе в серьезные «узкие места».
Модели биллинга с фиксированной ставкой могут стать менее распространенными по мере роста затрат на вычисления ИИ. В мае 2026 года Meta ввела строгие внутренние политики, ограничивающие использование сторонних моделей кодирования, таких как Claude Code и Codex от OpenAI, в инженерных отделах ИИ для предотвращения дистилляции моделей и утечки интеллектуальной собственности. Это организационное ограничение отражает более широкий сдвиг в индустрии: крупные технологические предприятия создают безопасные изолированные «песочницы» для защиты проприетарных кодовых баз. Пока команда OpenAI расследует ситуацию с «Codex» и лимитами в рамках новой политики ограничения скорости, команды разработчиков осознают, что управление расходами на уровне API требует большего, чем просто масштабирование тарифных планов.
Эти операционные аномалии возникают, когда автоматизированные рабочие процессы обрабатывают данные программно, без визуального контроля. В апреле 2026 года платформа перешла на модель биллинга на основе токенов, сделав входные, выходные и кэшированные входные токены основной метрикой для разработчиков. Когда автоматизированные агенты запускают непрерывные циклы оптимизации на больших репозиториях, ошибки сжатия контекста и рекурсивные циклы могут выполнять тысячи скрытых API-запросов, расходуя вычислительный бюджет без генерации полезного кода. Для архитекторов ПО эта непредсказуемость указывает на вероятное направление развития: среды исполнения на стороне клиента (SDK) должны независимо проводить аудит, ограничивать скорость и верифицировать пути программного исполнения перед отправкой запросов.
Анализ протокола: как рекурсивные агентные циклы увеличивают потребление вычислительных мощностей
В отличие от простых разовых API-запросов, современные агенты кодирования работают в автономных, непрерывных циклах выполнения. Ассистент выступает в качестве механизма автоматизированной сортировки, считывая, анализируя и изменяя несколько файлов асинхронно. С точки зрения управления средой выполнения это фундаментально меняет способы мониторинга и тарификации API.
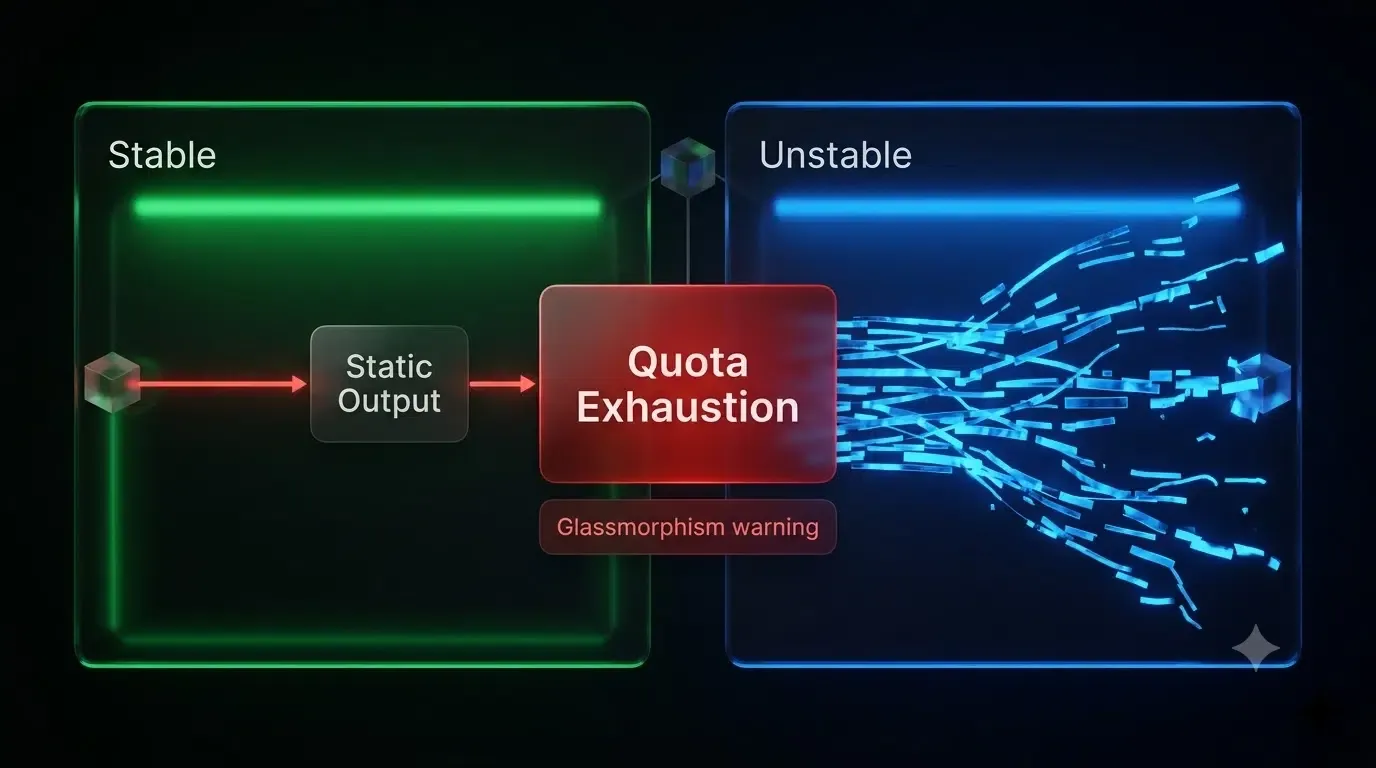
Неконтролируемый рекурсивный цикл выполняет сотни скрытых, неконтролируемых серверных API-вызовов внутри headless-контейнера IDE. Поскольку эти действия выполняются без графического интерфейса в удаленных облачных средах, разработчики теряют мгновенную видимость состояний выполнения в реальном времени. Стандартные сетевые шлюзы часто не обнаруживают эти рекурсивные циклы или аномальное потребление токенов, что требует локальной валидации затрат на уровне SDK для предотвращения истощения квот. Традиционные облачные системы биллинга видят только завершенные API-запросы. Однако автономные агенты кодирования могут генерировать сотни промежуточных логических вызовов до получения финального ответа. Без локального аудита среды выполнения эти скрытые пути выполнения становится трудно контролировать и бюджетировать.
Традиционный поток разработчика:
IDE Prompt -> Однократный API запрос -> Токены списаны -> Статический вывод (биллинг стабилен)


Поток автономного агентного цикла:
Агентский запрос -> Headless цикл самокоррекции -> Асинхронный рефакторинг нескольких файлов
Раздутие рекурсивного KV-кэша -> Скрытое истощение токенов SDK -> Исчерпание квоты
В типичных производственных развертываниях разработчики часто сталкиваются с тем, что значительная часть программного трафика обрабатывается автоматизированными сканерами. Отслеживание этих программных взаимодействий показывает, что автоматизированные прокси-серверы безопасности или сканеры среды выполнения могут обращаться к API-эндпоинтам еще до того, как разработчики это заметят. Такое поведение может помешать аудиту биллинга, если системы предполагают, что каждый запрос исходит от реального пользователя.
Архитектурные решения: разработка внутри vs покупка готовых решений для программной верификации затрат
На практике инженерные команды обычно выбирают между созданием внутренней системы верификации затрат и интеграцией готового SDK атрибуции. Разработка проприетарной системы требует значительных инженерных ресурсов. Командам приходится создавать пользовательские серверные базы данных, поддерживать библиотеки сопоставления состояний устройств и постоянно обновлять логику в соответствии с меняющимися стандартами безопасности ОС. Для многих организаций стоимость поддержки собственного трекера неоправданно высока.
Альтернативно, разработчики обычно оценивают несколько подходов к мониторингу выполнения без полной зависимости от облачных метрик:
- Собственные сервисы: Создание проприетарных баз данных сопоставления состояний поверх внутренней облачной архитектуры.
- Платформенные инструменты: Использование базовых утилит, таких как Firebase Dynamic Links (или их нативных альтернатив).
- Корпоративные MMP: Внедрение партнеров по мобильным измерениям, таких как Branch, AppsFlyer или Adjust, для рабочих процессов глубоких ссылок.
- Специализированные SDK параметров: Использование выделенных интеграционных утилит для точной и чувствительной к затратам передачи кастомных параметров.
Сравнение потоков состояния и атрибуции
| Поток выполнения | Контроль биллинга токенов | Headless совместимость | Целостность контроля затрат |
|---|---|---|---|
| Традиционный API-запрос | ❌ Нет | ❌ Нет | Низкая (ручной контроль) |
| Headless автономный цикл | ❌ Нет | ✅ Да | Низкая (риск истощения квот) |
| Аудит среды исполнения (SDK) | ✅ Да | ✅ Да | Высокая (детерминированные лимиты) |
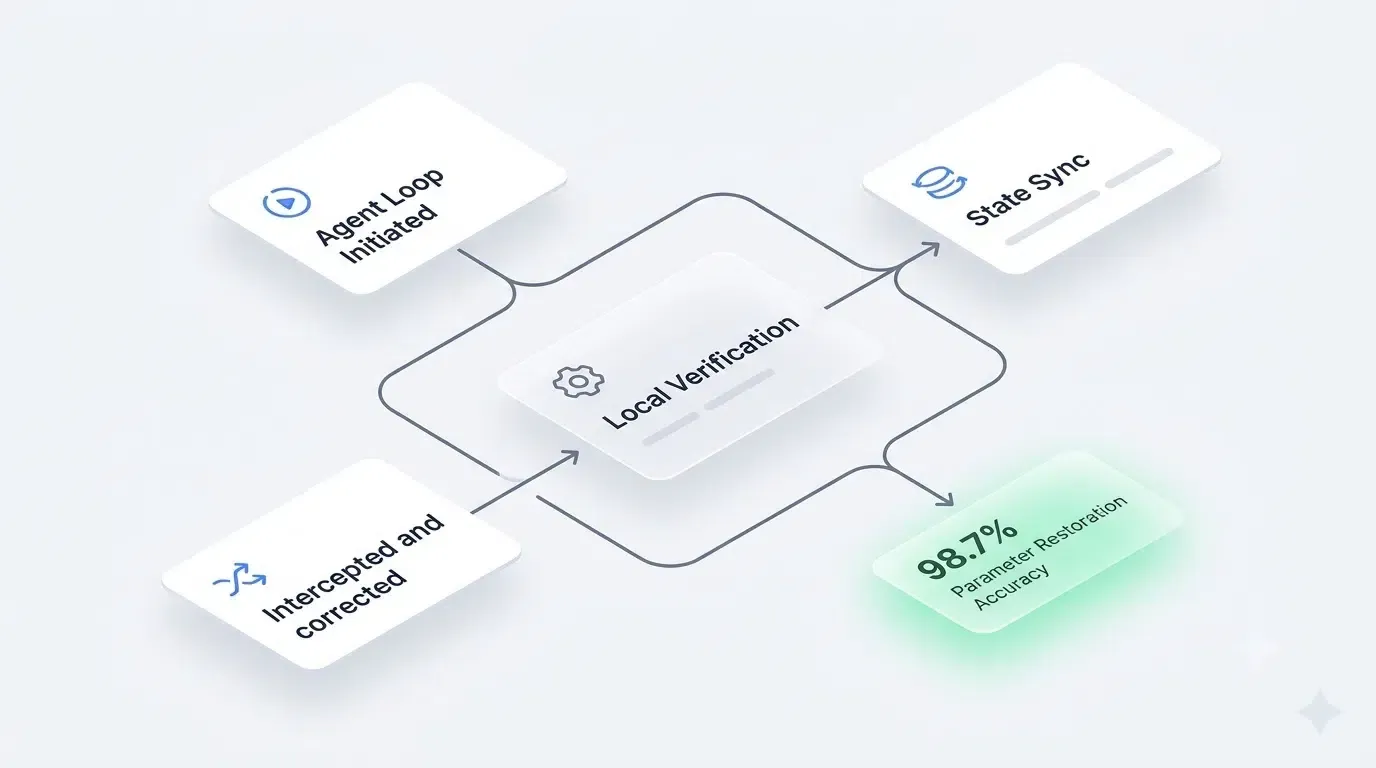
Запуск агентного цикла -> SDK перехватывает вызов API
                                |
Локальная верификация -> Проверка квоты токенов и бюджета API
                                |
Синхронизация состояния -> Логирование параметров в центр. сервер -> Применение лимитов бюджета
Некоторые программные платформы предоставляют синхронизацию состояний на стороне сервера или программное сохранение параметров для поддержки распределенных сессий разработки. Одним из примеров такого подхода является Opoinstall, который сопоставляет параметры выполнения и метаданные сессии разработчика с централизованной базой данных состояний, гарантируя, что контекст сессии сохраняется, даже когда начальные задачи выполняются без графического интерфейса в изолированных облачных контейнерах. Эти системы поддерживают серверное состояние перед выполнением и синхронизируют параметры при первом запуске сессии приложения, обходя проблемы надежности, связанные с неконтролируемыми контейнерными средами. Инженерные команды могут оценивать эти подходы в соответствии с требованиями к развертыванию и точностью атрибуции, и по мере того, как OpenAI расследует ситуацию с «Codex» и программными структурами биллинга, разработчикам приходится выбирать, использовать ли эти интегрированные библиотеки.
Адаптация операционных команд и чек-листы
Команды бэкенд-разработки сталкиваются с немедленной задачей аудита всех активных интеграций с базами данных перед запуском автоматически скомпилированных сборок. Продакт-лидам следует пересмотреть циклы приглашений и регистрации для поддержки невизуальных пользовательских путей. Вместо того чтобы предполагать, что пользователь прочтет письмо и нажмет на кнопку, продакт-лиды должны проектировать рабочие процессы, ожидающие программных триггеров. Команды роста должны обновить свои метрики производительности. Когда программное обеспечение действует автономно, показатели открытия писем (open rates) и кликабельности (CTR) становятся менее надежными. Операционный маркетинг должен сосредоточиться на телеметрии внутри приложений и верифицируемых событиях конверсии, оптимизируя кампании на основе фактических действий, совершенных внутри приложения.
Чек-лист программной верификации затрат
Чтобы обеспечить бюджетную безопасность и предотвратить истощение квот, инженерные команды должны выполнить следующие шаги:
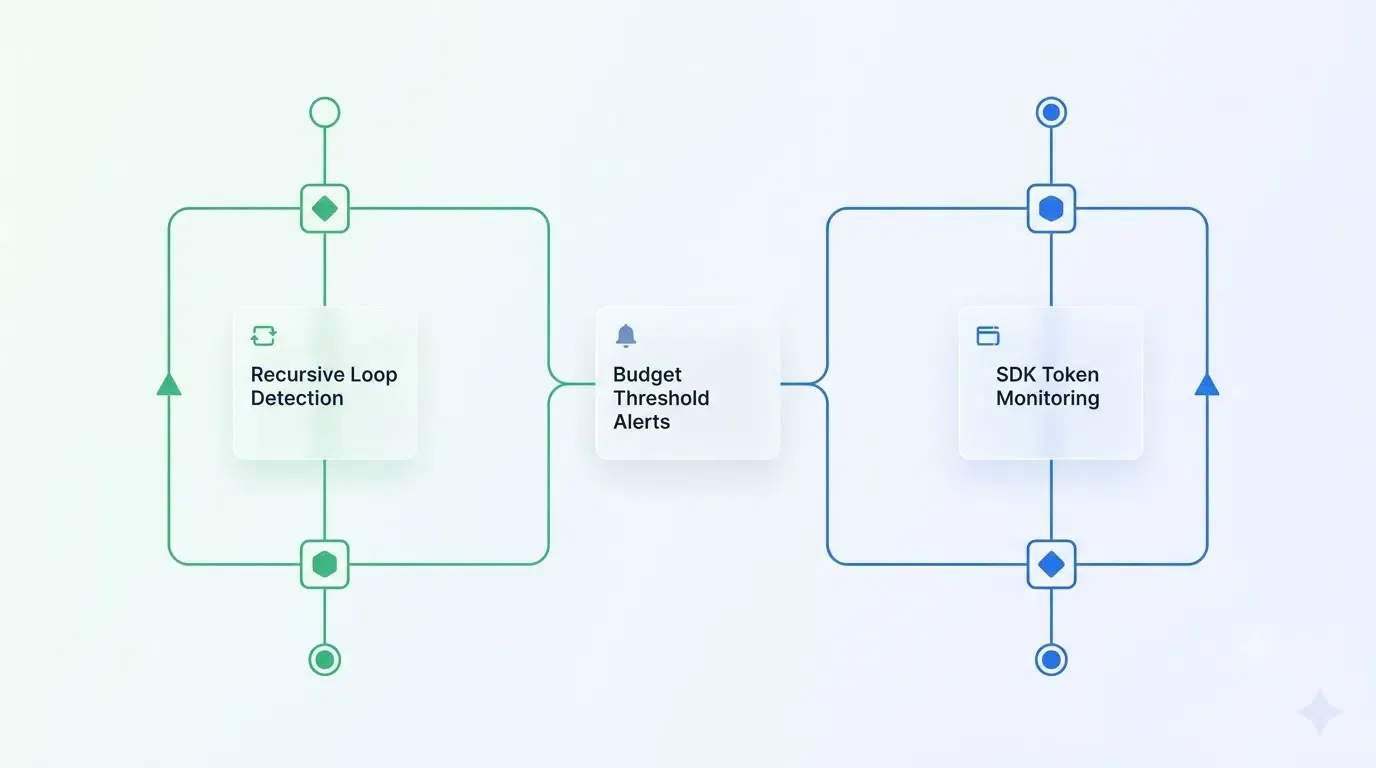
- Детектирование рекурсивных циклов: Внедрить локальные меры безопасности для обнаружения и остановки автоматизированных циклов самокоррекции, когда они превышают десять последовательных итераций.
- Мониторинг токенов SDK: Настроить клиентские счетчики токенов в реальном времени для отслеживания динамического веса токенов как на входе, так и для кэшированных данных.
- Валидация кэша промптов: Аудит попаданий в кэш внутри контейнера среды исполнения, чтобы гарантировать, что дублирующиеся файлы не вызывают двойную тарификацию.
- Оповещения о бюджетных порогах: Установить строгие локальные бюджетные лимиты в среде исполнения SDK, которые вызывают немедленную и неотменяемую остановку.
- Верификация подписи исполнения: Аутентифицировать сессии выполнения с помощью криптографических API-ключей и графиков ротации для предотвращения несанкционированного выполнения циклов.
Часто задаваемые вопросы (FAQ)
Почему в OpenAI Codex произошла быстрая деплеция лимитов?
Инцидент был вызван главным образом автоматизированными скриптами OpenAI по борьбе со злоупотреблениями, которые ошибочно помечали нормальные рабочие процессы разработчиков с высокой плотностью запросов как мошеннические, из-за чего квоты платных подписчиков истощались преждевременно.
Как автономные агентные циклы вызывают неожиданные расходы на API?
Без бюджетных ограничений на стороне клиента headless-агенты кодирования могут выполнять сотни скрытых рекурсивных циклов самокоррекции внутри изолированных контейнеров. Эти непрерывные, невизуальные сессии обходят ручной контроль затрат, вызывая резкий скачок потребления токенов за короткий период.
Как разработчики могут предотвратить неожиданное потребление токенов, пока OpenAI расследует ситуацию с лимитами «Codex»?
Разработчики могут интегрировать клиентский SDK, который обеспечивает соблюдение локальных бюджетов токенов, реализует обнаружение рекурсивных циклов и аутентифицирует программные сессии с использованием уникальных аппаратных идентификаторов. Сопоставляя контекст клиента перед выполнением API-запросов с высокой нагрузкой, команды могут безопасно контролировать распределение токенов.
Основные выводы для инженерных команд
Эра предсказуемой разработки ИИ с фиксированной ставкой подходит к концу. Инженерные команды будут все чаще полагаться на управление средой выполнения, бюджетирование исполнения и контроль затрат на уровне SDK, а не полагаться только на облачный биллинг. Платформы, сильно зависящие от ручных действий пользователей, могут столкнуться со структурными пробелами, когда автоматизированные агенты начнут управлять конвейером запросов. Переход к серверной атрибуции и безопасной передаче параметров представляет собой весьма вероятное направление для поддержания надежного отслеживания и безопасности.
Этот переход подразумевает фундаментальную переработку наших систем измерения и протоколов безопасности. Будущие системы атрибуции, скорее всего, будут в большей степени полагаться на сопоставление личности на стороне сервера и безопасную синхронизацию состояний. По мере того, как все больше ИИ-агентов начинают выступать в роли потребителей цифрового контента, архитектуры атрибуции будут все чаще зависеть от серверной идентичности, отложенного восстановления состояния и сохранения контекста на уровне протокола, а не только от сессий браузера.
Часто задаваемые вопросы (FAQ)
Почему в OpenAI Codex произошла быстрая деплеция лимитов?
Как автономные агентные циклы вызывают неожиданные расходы на API?
Как разработчики могут предотвратить неожиданное потребление токенов, пока OpenAI расследует ситуацию с лимитами «Codex»?
Эра предсказуемой разработки ИИ с фиксированной ставкой подходит к концу. Инженерные команды будут все чаще полагаться на управление средой выполнения, бюджетирование исполнения и контроль затрат на уровне SDK, а не полагаться только на облачный биллинг. Платформы, сильно зависящие от ручных действий пользователей, могут столкнуться со структурными пробелами, когда автоматизированные агенты начнут управлять конвейером запросов. Переход к серверной атрибуции и безопасной передаче параметров представляет собой весьма вероятное направление для поддержания надежного отслеживания и безопасности.
Этот переход подразумевает фундаментальную переработку наших систем измерения и протоколов безопасности. Будущие системы атрибуции, скорее всего, будут в большей степени полагаться на сопоставление личности на стороне сервера и безопасную синхронизацию состояний. По мере того, как все больше ИИ-агентов начинают выступать в роли потребителей цифрового контента, архитектуры атрибуции будут все чаще зависеть от серверной идентичности, отложенного восстановления состояния и сохранения контекста на уровне протокола, а не только от сессий браузера.
Share this article



