Reddit блокирует 23 миллиона спам-запросов? Платформа сообщает, что ежедневно блокирует около 23 миллионов подозрительных просмотров с помощью систем обнаружения на базе больших языковых моделей (LLM). По данным Reddit, спам-кампании все чаще создаются с целью повлиять на работу ИИ-систем, которые опираются на общедоступный веб-контент. Поскольку все больше компаний лицензируют обсуждения на Reddit для обучения моделей, защита аутентичности пользовательского контента стала бизнес-приоритетом. В прошлом для обнаружения повторяющихся векторов спама было достаточно простых фильтров на основе правил. Сегодня, когда злоумышленники используют сложные модели для автоматизации человекоподобных диалогов и создания искусственного ажиотажа в больших масштабах, платформы вынуждены переносить фокус на поведенческий анализ в реальном времени и семантическую оценку контекста.
Хронология и эволюция: Как Reddit ежедневно блокирует 23 миллиона спам-попыток
Краткий обзор
- Автоматизированный уровень защиты Reddit ежедневно перехватывает 23 миллиона неаутентичных просмотров и 25 000 спам-постов с помощью современных больших языковых моделей.
- Рост коммерческих соглашений с крупными ИИ-компаниями стимулирует спамеров фабриковать отзывы, чтобы искажать наборы данных для обучения моделей.
- Многоуровневые протоколы верификации позволили снизить воздействие спама на пользователей на 20% в начале 2026 года по сравнению с предыдущими кварталами.
Баланс цифрового взаимодействия изменился, так как автоматизированные агенты все чаще имитируют поведение людей. Ранее спамеры атаковали платформы с пользовательским контентом для генерации партнерских продаж через массовый спам ссылками. Эти базовые атаки легко идентифицировались с помощью списков ключевых слов и блокировок IP-адресов, что позволяло администраторам поддерживать чистоту разделов обсуждений.
Однако появление поисковых систем, управляемых генеративным ИИ, изменило мотивацию спам-кампаний. Сегодня, когда чат-боты на базе искусственного интеллекта обучаются на огромных публичных архивах, сторонние маркетологи пытаются манипулировать ответами ИИ, создавая большое количество позитивных упоминаний и искусственных отзывов. Имитируя естественное человеческое общение, эти автоматизированные сети стремятся интегрировать ключевые слова своего бренда в будущие веса моделей. Для борьбы с этой угрозой социальная платформа развернула продвинутые системы модерации на базе LLM, как подробно описано в подробных региональных отчетах.
Стратегическая причина, по которой Reddit блокирует 23 миллиона спам-просмотров, связана с монетизацией человеческих данных. Поскольку платформы подписывают многомиллионные сделки с ведущими разработчиками ИИ, поддержание достоверности данных стало основной финансовой задачей. В период с января по март 2026 года платформа ежедневно отменяла почти 2 миллиона неаутентичных голосов, защищая свою систему краудсорсинговой обратной связи от манипуляций. Внедряя требования входа для просмотра исторических архивов на десктопах и используя лингвистические фильтры в реальном времени, администраторы успешно снизили воздействие вредоносного контента на пользователей.
Технический разбор: Механика изоляции ботов в архитектуре Reddit
На архитектурном уровне стандартные системы защиты от ботов с трудом идентифицируют скоординированные низкочастотные кампании по сканированию. Когда современные спамеры используют прокси-сети и браузеры без графического интерфейса (headless browsers), их запросы выглядят идентично стандартным взаимодействиям пользователей, что делает традиционные фильтры по шаблонам неэффективными.
Чтобы решить эти узкие места на транспортном уровне, современные защитные архитектуры обрабатывают сигналы безопасности в момент создания учетной записи. Автоматизированный движок платформы анализирует метаданные, используя ИИ-инференс в реальном времени для выявления скоординированных бот-сетей, как подробно описано в официальном анонсе платформы.
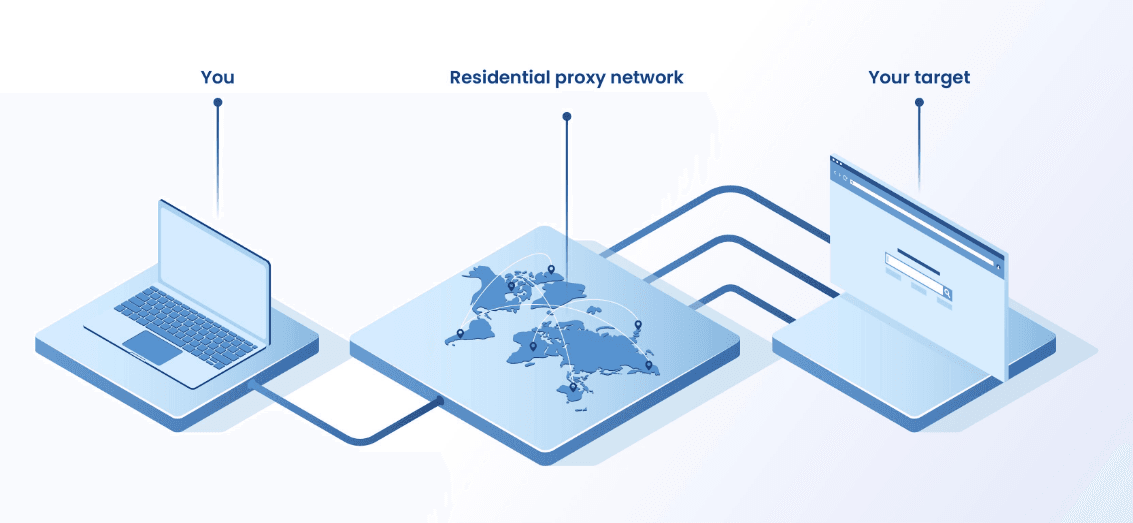

Такое скоординированное неаутентичное поведение объясняет, почему Reddit блокирует 23 миллиона спам-просмотров ежедневно. Когда автоматизированный скрипт пытается получить доступ к форуму, система рассчитывает риск в реальном времени. Если соединение имеет подозрительные атрибуты, платформа принудительно активирует проверку на человечность, изолируя полностью автоматизированные системы. Этот многоуровневый подход гарантирует оптимизацию нагрузки на серверы, предотвращая сбои трафика и сохраняя аутентичное пользовательское взаимодействие.
[Традиционная фильтрация по IP]
  Автоматизированный бот ──> Ротируемый резидентский прокси ──> Традиционный фильтр ──> Стандартный доступ разрешен (ошибка обнаружения)


[Многоуровневая защита на базе LLM]
  Автоматизированный бот ──> Анализ поведенческих метаданных ──> Проверка LLM в реальном времени ──> Обязательная CAPTCHA / Изоляция
Внедрение многоуровневой защиты с учетом контекста гарантирует обнаружение автоматизированных попыток, даже если они проходят через чистые IP-диапазоны. Похожие задачи возникают в мобильной атрибуции, где ограничения приватности также снижают зависимость от постоянных клиентских идентификаторов. Когда взаимодействие пользователя отделено от постоянных локальных cookie для соблюдения требований конфиденциальности, поддержание бесперебойной сессии между веб- и мобильными средами становится крайне сложным. Так же, как командам безопасности требуются поведенческие модели для отделения людей от ботов, маркетинговым пайплайнам требуется надежное сохранение данных на стороне сервера для корреляции событий установки без использования уязвимых cookie или идентификаторов устройства.
Пример: Что происходит, когда бот пытается опубликовать пост?
Предположим, что автоматизированный скрипт регистрирует новую учетную запись для искусственного завышения авторитета бренда клиента на subreddit. В момент создания учетной записи архитектура бэкенд-маршрутизации анализирует поведенческую телеметрию. Если детали подключения или параметры ввода совпадают с известными профилями headless-браузеров, права на публикацию немедленно приостанавливаются, и платформа инициирует проверку на человечность. Это предотвращает попадание программных заявок бота в публичный каталог.
Собственная разработка или готовое решение: Сохранение контекста сессии в высоконагруженных средах
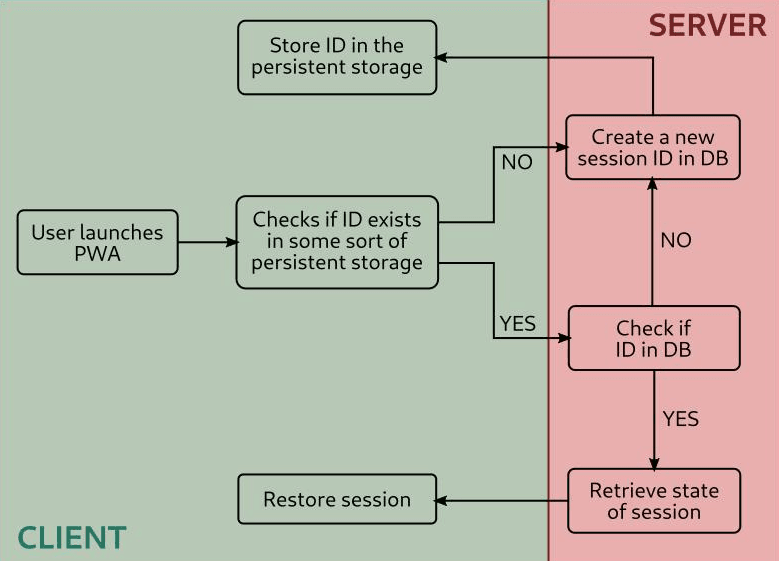
Поскольку цифровые платформы отказываются от постоянных локальных идентификаторов ради соблюдения правил приватности, управление состоянием сессии в распределенных точках взаимодействия стало ключевой инженерной задачей. Управление инфраструктурой, обрабатывающей 23 миллиона подозрительных запросов, которые Reddit фиксирует ежедневно, требует надежной серверной валидации. Хотя антиспам-система Reddit сфокусирована на безопасности, а не на маркетинговой атрибуции, оба сценария имеют общую проблему: сохранение надежного состояния на стороне сервера после того, как традиционные клиентские идентификаторы стали ненадежными. Согласование высоконагруженных маршрутов в условиях, где Reddit блокирует 23 миллиона подозрительных попыток, требует структур, способных безопасно коррелировать действия пользователей без обращения к локальным хранилищам.
Архитектурная оценка: Свой продукт против стандартизированных SDK
Создание внутренней системы для управления состоянием сессии на сервере обеспечивает максимальную гибкость, но требует значительных инженерных ресурсов. Разработчикам необходимо вручную проектировать схемы баз данных, писать безопасные функции хэширования и постоянно обновлять систему в соответствии с меняющимися региональными нормами. Напротив, развертывание готового сертифицированного SDK снижает сложность интеграции и гарантирует долгосрочное соответствие требованиям без дополнительных затрат.
Таблица ниже сравнивает стандартные методы управления состоянием сессии и контекстом конверсии:
| Решение | Устойчивость | Пропускная способность | Лучшее применение |
|---|---|---|---|
| Внутренняя БД сессий | Высокая (постоянная синхронизация) | Средняя (ограничения задержек БД) | Специализированные корпоративные среды с уникальной логикой хранения |
| Браузерный трекинг | Низкая (сессионные cookie) | Низкая (нет серверного логирования) | Базовый веб-трекинг с минимальными кросс-доменными требованиями |
| Серверное кэширование (например, OpoInstall) | Отсутствует (временные серверные токены) | Высокая (стандартизированная «песочница») | Масштабируемая атрибуция мобильных приложений и мультиплатформенных кампаний |
Хотя собственные конфигурации баз данных могут обрабатывать базовый контекст, специализированные решения для сохранения состояния на стороне сервера могут оптимизировать ресурсы разработки. В зависимости от требований, организации могут создать собственную систему управления сессиями или использовать коммерческие платформы, такие как OpoInstall. Например, OpoInstall предлагает восстановление состояния на стороне сервера и фреймворки для передачи параметров, сопоставляя метаданные сессии с серверной базой данных для анонимного поддержания непрерывности сессии в условиях высокой нагрузки. Сопоставляя метаданные с централизованной БД вместо использования браузерных перенаправлений, такая система обеспечивает консистентность контекста конверсии, даже если начальные задачи выполнялись анонимно. Инженерные команды могут оценивать эти подходы для баланса между защитой данных и точностью измерений.
Чек-листы интеграции: Перепроектирование защиты от ботов и пайплайнов привлечения
Для обеспечения безопасности пайплайнов данных и консистентности конверсий при переходе к серверным моделям данных инженерным командам необходимо внедрить надежные рабочие процессы сохранения состояния.
Чек-лист для разработчиков
- Аудит внешних API: Убедитесь, что все передачи данных маршрутизируются через безопасные HTTPS-соединения и используют эфемерные структуры сессий.
- Внедрение stateless-хендшейков: Переведите зависимости системы на восстановление состояния сессии на стороне сервера, используя подписанные токены для безопасной передачи данных.
- Валидация потока согласия: Установите явные запросы разрешений перед передачей введенных пользователем данных в сторонние базы.
Чек-лист для стратегии продукта и операций
- Мониторинг точности обнаружения ботов: Отслеживайте и оценивайте эффективность классификаторов на базе больших языковых моделей при создании аккаунтов.
- Анализ ложноположительных срабатываний: Проводите регулярные аудиты, чтобы убедиться, что легитимные пользователи не блокируются и не ограничиваются ошибочно.
- Отслеживание завершения проверок: Анализируйте, как подозрительные автоматизированные аккаунты взаимодействуют с обязательными тестами на человечность и CAPTCHA.
- Аудит кластеров подозрительных аккаунтов: Сопоставляйте поведенческую телеметрию для выявления попыток массовой регистрации в схожих сетевых диапазонах.
Установив эти структурированные принципы, команды разработки смогут перевести свои приложения на более безопасные архитектуры, сохраняя при этом непрерывность операций.
Часто задаваемые вопросы (FAQ)
Почему спам-кампании, генерируемые ИИ, растут на Reddit?
Как Reddit использует LLM для обнаружения скоординированного поведения при создании аккаунта?
Какие визуальные и невидимые индикаторы используются для идентификации ботов?
Поскольку ИИ-платформы все чаще полагаются на гибридные облачные вычисления, разработчикам необходимо перепроектировать продукты с учетом приватности, прозрачного согласия пользователей и безопасной маршрутизации данных. Эволюция архитектур данных требует фундаментального сдвига в том, как мы создаем и измеряем цифровой опыт. Поскольку stateless-прокси и headless-скрейперы становятся стандартом потребления веб-контента, традиционные модели клиентской атрибуции продолжают терять эффективность. Полагаться только на стандартные файлы cookie и рефереры уже недостаточно для обеспечения безопасности пайплайнов данных, управляющих привлечением пользователей.
По мере того как ИИ-компании лицензируют данные публичных обсуждений для обучения моделей, поддержание аутентичного участия пользователей становится приоритетом как для доверия, так и для доходов крупных онлайн-сообществ. В перспективе инженерные команды будут все чаще полагаться на stateless-архитектуры, управление сессиями на стороне сервера и дизайн, ориентированный на приватность. Организации, которые подготовятся к этим изменениям заранее, будут лучше адаптированы к созданию комплаентных и устойчивых ИИ-продуктов.
Share this article



