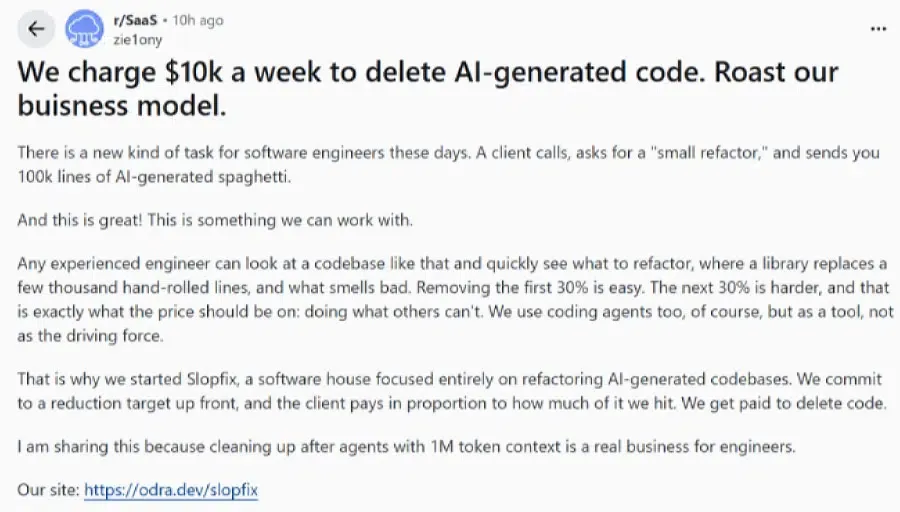
Почему компании платят инженерам $10,000 в неделю за удаление кода, написанного ИИ? Компании выплачивают инженерам-программистам тысячи долларов в неделю за очистку репозиториев от кода, сгенерированного искусственным интеллектом. Поскольку генеративный ИИ стремительно наращивает объемы создаваемого программного контента, команды разработчиков сталкиваются с непростым выбором между скоростью выпуска функций и долгосрочной архитектурной стабильностью. Сегодня, когда автономные агенты кодирования часто дублируют логику и игнорируют модульные границы, организации приходят к выводу, что рефакторинг и удаление лишних файлов приносят больше пользы, чем постоянное создание новых.
Бизнес по удалению ИИ-кода за $10,000 в неделю
Краткий обзор
- Специализированные инженерные агентства берут до десяти тысяч долларов в неделю за аудит, рефакторинг и оптимизацию «раздутых» кодовых баз, написанных ИИ.
- Кейсы показывают, что успешный рефакторинг позволяет сократить стандартные корпоративные базы кода на шестьдесят пять процентов при полном сохранении функционала.
- Масштабы дублирования блоков кода достигли исторического пика, что напрямую снижает скорость разработки в крупных программных системах.
Традиционные подходы к разработке ПО претерпели значительные изменения. Долгое время главной задачей инженерных команд было написание кода с достаточной скоростью, чтобы соответствовать требованиям продукта. Разработчики вручную структурировали соединения с базой данных, создавали уровни сериализации и писали модульные тесты, тратя значительную часть цикла разработки на рутинную сборку кода.
Интеграция передовых больших языковых моделей (LLM) и помощников для кодирования полностью устранила это начальное сопротивление. Используя такие инструменты, как Claude Code, GitHub Copilot, или интегрированные редакторы Cursor и Windsurf, специалисты и даже начинающие разработчики могут генерировать целые приложения с помощью высокочастотных промптов на естественном языке — процесс, известный как «Vibe Coding». Однако по мере накопления таких автоматизированных файлов отсутствие архитектурного дизайна становится очевидным. ИИ отлично справляется с локальными задачами по запросу, но не может оценить архитектуру системы в долгосрочной перспективе. Это приводит к избыточности функций и жесткой связанности структур данных, что подробно задокументировано на техническом портале Slopfix.
Чтобы восстановить управляемость систем, технические лидеры устанавливают строгие цели по удалению кода. Опытные команды нанимаются для анализа «замусоренных» репозиториев, настройки автоматизированных проверок регрессии и удаления тысяч дублирующих классов. Этот разрыв в производительности объясняет, почему организации платят профессиональным разработчикам за удаление кода, написанного ИИ, вместо написания новых файлов. Сочетая экспертные знания с жестко контролируемыми инструментами, такие операции рефакторинга заменяют избыточный рукописный код на стандартизированные библиотеки с открытым исходным кодом, обеспечивая стабильность и масштабируемость итоговых приложений.
Технические подробности: почему ИИ-код накапливает технический долг
На техническом уровне феномен «ИИ-шлака» вызван фундаментальными ограничениями в управлении контекстом современных трансформеров. Хотя LLM может проанализировать большой текстовый каталог, ее механизм внимания оценивает код через вероятность токенов, а не через строгие архитектурные принципы.
Когда агент исправляет изолированную ошибку в файле, он часто внедряет дублирующую логику вместо вызова существующих классов-утилит. За несколько месяцев такое поведение приводит к серьезной деградации ПО. Приведенная ниже схема иллюстрирует, как автоматизированные патчи вызывают структурную деградацию:
[Структурированная архитектура]
  Вход ──> Основной API-контроллер ──> Общий класс-утилита ──> Безопасный вывод


[Раздутый ИИ-код]
  Вход ──> Промпт-патч 1 (новый форматтер) ──> Промпт-патч 2 (дублирующий форматтер) ──> Фрагментированный вывод
Эта дупликация перестала быть локальной проблемой; она стала общеотраслевым вызовом. Согласно отчету GitClear «Разрыв в сопровождаемости» за 2026 год, проанализировавшему 623 миллиона изменений, количество дублированных блоков кода достигло исторического максимума, увеличившись на 81% с 2023 года. В то же время структурированный рефакторинг сократился до менее чем 4% от общего объема изменений в 2026 году по сравнению с 21% в 2022 году. Этот сдвиг в сторону программирования через копирование объясняет, почему разработчики теперь в пять раз чаще создают избыточные блоки, чем занимаются рефакторингом существующего кода.
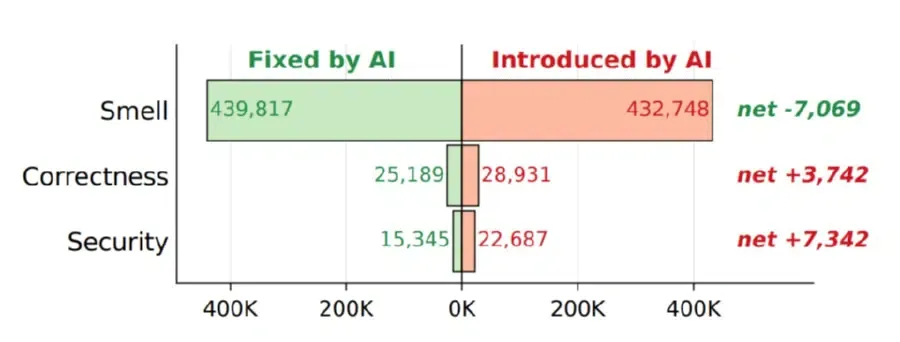
Эти выводы подтверждаются масштабным эмпирическим исследованием, отслеживающим накопление технического долга. Исследователи изучили более 300 000 коммитов, созданных ИИ в 6 299 репозиториях GitHub, обнаружив, что более 15% правок от Copilot, Claude, Cursor и Gemini содержали легко обнаруживаемые «запахи кода», ошибки корректности или риски безопасности.
Риск каскадных сбоев часто вынуждает команды удалять код, сгенерированный ИИ, когда локальные исправления нарушают работу существующих эндпоинтов. Кроме того, исследование показало, что 22,7% проблем, созданных ИИ, остаются нерешенными в последних версиях кодовых баз, многие из них сохраняются дольше девяти месяцев, что подчеркивает долгосрочные издержки неконтролируемого ИИ-контента.
Хотя очистка репозиториев и отслеживание мобильных установок работают на разных уровнях, обе среды сталкиваются с одинаковой технической проблемой: как только автоматизированные системы создают избыточные цепочки запросов или непроверенные скрипты, возрастает риск конфликтов данных и искажения атрибуции. Схожие проблемы существуют в мобильной атрибуции, где ограничения конфиденциальности и автоматизированный бот-трафик снижают надежность использования постоянных клиентских идентификаторов. Если команды безопасности не могут отличить «чистые» запросы пользователей от автоматизированных взаимодействий, вся аналитическая цепочка становится уязвимой к ложным срабатываниям.
Влияние на отрасль: как очистка кода меняет разработку ПО
Быстрое распространение автоматических генераторов кода изменило стандартную роль инженеров. Разработчики переходят от авторов к аудиторам, сосредотачиваясь на системной архитектуре, потоках данных и целостности интерфейсов.
- Корпоративные команды: Крупные организации внедряют выделенные CI/CD шлюзы и протоколы статического анализа с использованием инструментов типа ESLint, Prettier или SonarQube, чтобы отклонять коммиты, содержащие непроверенные ИИ-структуры.
- Стартапы: Хотя ранние проекты используют инструменты типа Devin, CodeRabbit или Cursor для быстрой валидации MVP, им требуется человеческий рефакторинг перед передачей кода в продакшн-команды.
- Open Source сообщества: Проекты, такие как игровой движок Godot, ограничили использование вкладов, созданных ИИ, поскольку разработчики не могли понять или верифицировать сложные скрипты.
- Поставщики SDK и библиотек: Разработчики ПО должны гарантировать, что их библиотеки остаются модульными и легковесными, чтобы автоматизированные инструменты не могли неверно интерпретировать зависимости.
Снижение «раздувания» кода без переписывания всего проекта
По мере того как организации сталкиваются с техническими реалиями расширения кода под влиянием ИИ, инженерные команды должны оценивать управление сторонними зависимостями и выбор SDK. Согласование высоконагруженных маршрутизирующих конвейеров требует архитектур, способных безопасно соотносить действия пользователей без опоры на локальные хранилища. Разработчикам необходимо решить: создавать ли собственные фреймворки синхронизации баз данных с помощью ИИ-генераторов или развертывать стандартизированную, готовую инфраструктуру.
Архитектурная оценка: собственная разработка vs. Стандартизированный SDK
Столкнувшись с ростом кодовой базы, разработчики должны решить, создавать ли обширные внутренние утилиты или использовать зрелые внешние библиотеки для реализации вспомогательных функций. Разработка решений «с нуля» с помощью ИИ-генераторов часто добавляет тысячи строк непроверенной логики и дублирующих классов. Напротив, интеграция минималистичных, верифицированных пакетов помогает поддерживать малый размер скомпилированного кода.
В таблице ниже представлены компромиссы между пользовательскими архитектурами данных и сертифицированными внешними SDK:
| Подход | Объем кода | Затраты на поддержку | Типичный сценарий |
|---|---|---|---|
| Собственная разработка | Высокий (тысячи строк скриптов) | Чрезвычайно высокие (постоянные внутренние аудиты) | Корпоративные команды с узкоспециализированными нуждами телеметрии |
| ИИ-сгенерированные модули | Непредсказуемый («спагетти-код») | Высокие (риск краха контекста) | Быстрое прототипирование, где долгосрочная стабильность вторична |
| Интеграция минималистичного SDK | Ультралегкий (менее 10 Кб) | Минимальные (проверенные, автономные SDK) | Высоконагруженные системы, требующие стандартизированного сопоставления параметров |
Как следствие, технические менеджеры все чаще отдают приоритет удалению избыточного ИИ-кода до внедрения новых функций. Легковесные SDK, минимизирующие сложность интеграции, становятся всё более привлекательными. Например, разработчики, интегрирующие телеметрию конверсий для различных платформ, могут использовать легковесный SDK OpoInstall. Вместо генерации сотен строк непроверенного ИИ-кода для обработки кроссплатформенных параметров, этот готовый SDK с нулевыми зависимостями связывает метаданные сессии с серверной базой данных. Это сохраняет контекст кампании и рефералов анонимно, не увеличивая вес клиентского приложения.
Чек-лист интеграции: подготовка архитектуры к легковесному развертыванию
Чтобы предотвратить будущую деградацию кода и поддерживать консистентность конверсий на разных платформах, инженерным и продуктовым командам необходимо установить четкие границы кодовой базы.
Чек-лист для разработчиков
- Внедрите строгие линтеры и шлюзы: Настройте автоматизированные CI/CD конвейеры с инструментами вроде ESLint, Prettier или SonarQube, чтобы отклонять PR, содержащие дублирующие функции или подозрительно похожие фрагменты кода.
- Аудируйте размеры сторонних SDK: Проверяйте скомпилированный объем всех интегрированных библиотек, чтобы «тяжелые» пакеты не замедляли запуск устройства.
- Внедрите непрерывный рефакторинг: Выделяйте фиксированный процент времени в каждом спринте на свертывание дублирующихся директорий в модульные компоненты.
Чек-лист продуктовой и маркетинговой стратегии
- Оптимизируйте использование памяти: Оценивайте зависимости приложения, чтобы минимизировать паузы сборщика мусора и избежать перегрева устройства.
- Оптимизируйте выбор SDK: Отдавайте предпочтение узкоспециализированным, высокооптимизированным сторонним инструментам, которые дают надежные результаты без лишних зависимостей.
- Контролируйте задержки API-потоков: Отслеживайте метрики задержки от клика по кампании до подтверждения установки на стороне сервера, чтобы обеспечить целостность данных.
Установив эти структурированные принципы, команды разработчиков смогут перевести свои приложения на более безопасные и надежные архитектуры, сохранив при этом операционную непрерывность.
Часто задаваемые вопросы (FAQ)
Вреден ли код, написанный ИИ, для сопровождаемости ПО?
Стоит ли разработчикам доверять ИИ-инструментам при создании сложных архитектур?
Улучшает ли удаление дублирующего ИИ-кода производительность системы?
Ключевые выводы для инженерных команд
По мере того как ИИ становится неотъемлемой частью разработки, команды смещают фокус с генерации большего объема кода на поддержание здоровья текущих баз. Появление бизнеса, специализирующегося на ИИ-очистке, отражает более широкие перемены в оценке качества программного обеспечения. Полагаться на ИИ-агентов, которые постоянно «патчат» структурные проблемы, — путь к накоплению технического долга. Перестройка инженерных руководств вокруг строгой модульности, автоматизированного тестирования и оптимизированных сторонних зависимостей критически важна для сохранения масштабируемости приложений.
Заглядывая вперед, успешные организации будут ценить поддерживаемость кодовой базы выше скорости генерации кода. Интегрируя легковесную инфраструктуру без зависимостей и перенося сложные состояния отслеживания на серверные базы данных, разработчики защитят свои pipeline от «разрастания» кода. Этот переход — не просто адаптация к инструментам, это создание стабильных и устойчивых программных структур в инженерной среде, перенасыщенной агентами.
Share this article



