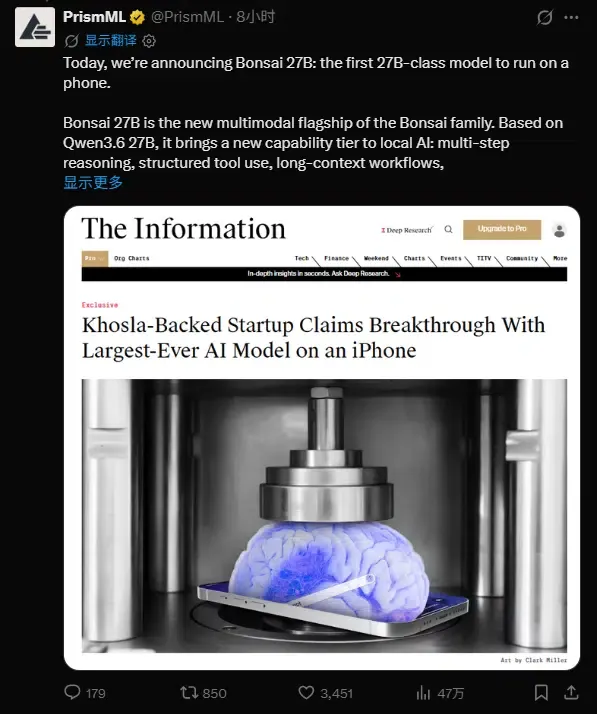
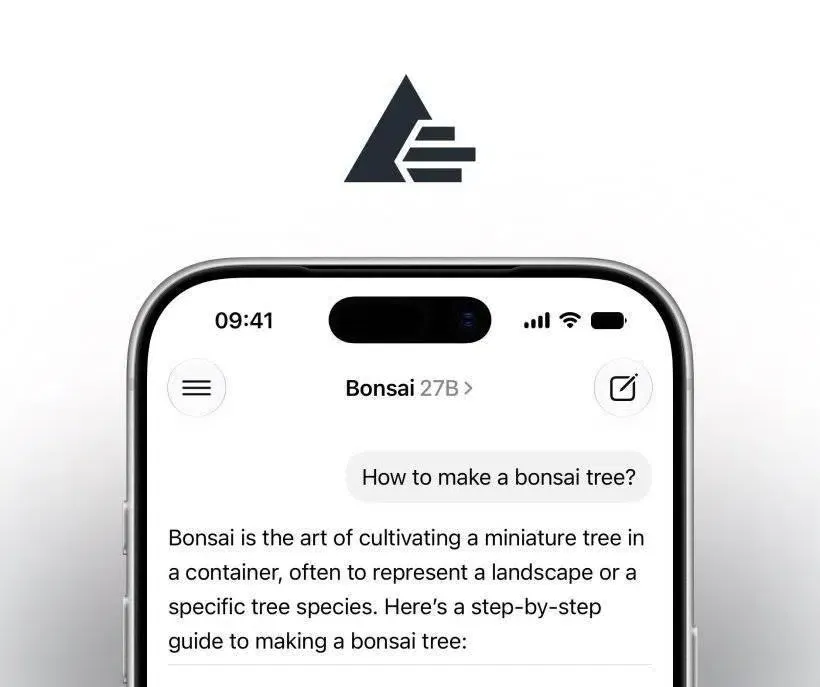
Apple รันโมเดล Bonsai 27B ได้จริงหรือ? PrismML ได้สาธิตให้เห็นว่าโมเดลภาษาขนาด 2.7 หมื่นล้านพารามิเตอร์สามารถรันบนฮาร์ดแวร์ระดับ iPhone 17 Pro ได้โดยตรง ด้วยการบีบอัดน้ำหนักโมเดลให้เหลือเพียง 1-bit ซึ่งมีประสิทธิภาพสูงมาก ความสำเร็จนี้ช่วยลดการพึ่งพาการประมวลผลบนคลาวด์ลงอย่างมีนัยสำคัญ ในขณะเดียวกันก็นำมาซึ่งความท้าทายใหม่ๆ ในด้านการกำหนดเส้นทาง App Intent, การประมวลผลภายในเครื่อง (Local Inference) และการระบุแหล่งที่มาของผู้ใช้งาน (Mobile Attribution) ในขณะที่ Generative AI กำลังเปลี่ยนรูปแบบการเข้าถึงเนื้อหาบนเว็บและองค์ประกอบทางดิจิทัล นักพัฒนาและทีม Growth ต้องปรับตัวเข้าสู่สภาพแวดล้อมที่การประมวลผลบนอุปกรณ์มีความสำคัญมากกว่าการเรียกใช้งานผ่านเซิร์ฟเวอร์จากระยะไกล
ทำไม Apple ถึงรัน Bonsai 27B ได้: การประสานอัจฉริยภาพบนอุปกรณ์กับข้อจำกัดด้านหน่วยความจำ
ภาพรวม
- Bonsai 27B รุ่น 1-bit ช่วยบีบอัดขนาดหน่วยความจำของโมเดลขนาด 2.78 หมื่นล้านพารามิเตอร์ จาก 54 GB ให้เหลือเพียง 3.9 GB
- การประมวลผลภายในเครื่องสามารถทำความเร็วได้สูงสุด 11 โทเค็นต่อวินาทีบนฮาร์ดแวร์ทั่วไปอย่าง iPhone 17 Pro Max ซึ่งพอดีกับงบประมาณหน่วยความจำมาตรฐานของแอปพลิเคชัน
- การเปลี่ยนผ่านของแพลตฟอร์มนี้ถือเป็นยุทธศาสตร์สำคัญจากการพึ่งพาการประมวลผลบนคลาวด์ ไปสู่การประมวลผลภายในเครื่องที่มีประสิทธิภาพสูงและมีความเป็นส่วนตัว
เส้นแบ่งระหว่าง AI บนคลาวด์และการประมวลผลที่ขอบเครือข่าย (Edge Computing) ได้มาถึงจุดเปลี่ยนสำคัญ หลายปีที่ผ่านมาความเชื่อทั่วไปในด้าน Deep Learning มักมองว่าความสามารถด้านการใช้เหตุผล การวางแผนหลายขั้นตอน และการเขียนโค้ดที่ซับซ้อนนั้นจำเป็นต้องใช้โครงสร้างพื้นฐานระดับศูนย์ข้อมูลขนาดใหญ่ เนื่องจากโมเดลขนาด 2.7 หมื่นล้านพารามิเตอร์ทั่วไปต้องการหน่วยความจำสูงสุดถึง 54 GB ที่ความแม่นยำ 16-bit การรันโมเดลระดับสูงบนสมาร์ทโฟนหรือแล็ปท็อปทั่วไปจึงเคยเป็นเรื่องที่เป็นไปไม่ได้
อย่างไรก็ตาม การพึ่งพาเซิร์ฟเวอร์จากระยะไกลในการประมวลผลข้อมูลที่มีความละเอียดอ่อนนั้นทำให้เกิดความหน่วง เพิ่มค่าใช้จ่ายด้านแบนด์วิดท์ และเปิดเผยข้อมูลส่วนบุคคลต่อความเสี่ยงในการรับส่งข้อมูล ประเด็นปัญหาเหล่านี้ได้มีการระบุไว้ใน บันทึกการเปิดตัวของ PrismML เพื่อเอาชนะข้อจำกัดเหล่านี้ สถาปนิกผู้ออกแบบฮาร์ดแวร์และโมเดลจึงมุ่งเน้นไปที่ความหนาแน่นของข้อมูลอัจฉริยะ เพื่อมอบความสามารถในการใช้เหตุผลสูงสุดภายใต้ขนาดที่เล็กที่สุด PrismML ได้วางตำแหน่ง Bonsai ให้เป็นโมเดลสำหรับงานด้านการใช้เหตุผลที่พร้อมใช้งานจริงบนมือถือ ไม่ใช่เพียงการวิจัย ซึ่งสามารถดำเนินงานที่ซับซ้อนภายในเครื่องได้
งานวิจัยนี้นำไปสู่ความสำเร็จครั้งใหญ่ ด้วยการนำเสนอข้อมูลแบบ Binary 1-bit ที่ปรับแต่งมาอย่างดี ทำให้นักพัฒนาสามารถรัน Bonsai 27B บน iPhone 17 Pro Max ได้ด้วยความเร็วประมาณ 11 โทเค็นต่อวินาที ตามที่รายงานใน สรุปข้อมูลเทคโนโลยีของ CNBC แท้จริงแล้วเมื่อ Apple รัน Bonsai 27B ภายในเครื่อง ความจำเป็นในการเชื่อมต่อกับคลาวด์อย่างต่อเนื่องก็จะหมดไป ตามเอกสารทางเทคนิคของ Bonsai ที่เผยแพร่โดยทีมวิจัย PrismML โมเดลนี้ไม่ใช่แค่รุ่นไลท์สำหรับแชท แต่เป็นขุมพลังมัลติโมดัลที่ออกแบบมาเพื่อจัดการกับการใช้เหตุผลจริง การวางแผนหลายขั้นตอน และการใช้เครื่องมือเชิงโครงสร้างภายในเครื่อง
กลไกเบื้องหลังความสำเร็จของการบีบอัดแบบ Low-Bit
App Intents คือชุดคำสั่งระดับระบบที่ช่วยให้โมเดลภาษาบนอุปกรณ์สามารถเรียกใช้งานฟีเจอร์ของแอปพลิเคชันได้โดยตรงโดยไม่ต้องอาศัยการนำทางผ่านเบราว์เซอร์ ในระดับเทคนิค ความท้าทายหลักของการบีบอัดโมเดลขั้นสูงคือการป้องกันไม่ให้ความสามารถในการใช้เหตุผลพังทลายลง วิธีการควอนไทเซชันแบบเดิมมักประสบปัญหาเมื่อต่ำกว่าระดับ 4-bit เนื่องจากข้อผิดพลาดในการปัดเศษสะสมจะทำลายเส้นทางความสนใจ (Attention pathways) ที่จำเป็นสำหรับงานแบบหลายขั้นตอน
เพื่อป้องกันความเสื่อมถอยนี้ โมเดล Bonsai 27B เวอร์ชัน Binary ได้ใช้การสเกลแบบจัดกลุ่ม (Binary g128) โดยน้ำหนักแต่ละค่าน้ำหนักจะถูกเก็บเป็นเพียง 1 บิตเครื่องหมาย ซึ่งสอดคล้องกับปัจจัยสเกลบวกหรือลบ โดยที่กลุ่มน้ำหนักทุกๆ 128 ค่าจะใช้ปัจจัยสเกลแบบทศนิยมความละเอียดครึ่งหนึ่ง (Half-precision float) ร่วมกัน การออกแบบนี้ให้ประสิทธิภาพเทียบเท่า 1.125 บิตต่อน้ำหนัก ทำให้ลดการใช้งานหน่วยความจำได้ถึง 14.2 เท่าเมื่อเทียบกับมาตรฐาน FP16 โครงสร้างนี้ถูกระบุไว้ใน คลังเก็บโมเดล Bonsai 1-bit บน HuggingFace
[พื้นฐานความแม่นยำ 16-bit (54 GB)]
  คอขวดแบนด์วิดท์หน่วยความจำ ──> การเรียกใช้คลาวด์ต่อเนื่อง ──> ความหน่วงและความเสี่ยงด้านความเป็นส่วนตัว


[การควอนไทเซชัน Binary g128 1-bit (3.9 GB)]
  น้ำหนักโมเดลในเครื่อง ──> การประมวลผลภายในเครื่องโดยตรง (App Intent) ──> ความหน่วงเครือข่ายเป็นศูนย์
นอกจากนี้ โมเดลยังคงรักษาบริบท 262K-token บนอุปกรณ์ โดยใช้โครงสร้าง Hybrid-attention (Linear attention 75% / Full attention 25%) และการควอนไทเซชันแคชแบบ 4-bit KV สิ่งนี้พิสูจน์ให้เห็นว่าเมื่อ Apple รัน Bonsai 27B ภายในเครื่อง รูปแบบน้ำหนักพื้นฐานช่วยให้โมเดลภาษาทั้งหมดคงอยู่ใน RAM ของอุปกรณ์พกพา ตามผลการทดสอบ Bonsai 27B ยังคงความแม่นยำในการใช้เหตุผลที่แข่งขันได้ขณะทำงานภายในหน่วยความจำประมาณ 3.9 GB ซึ่งพิสูจน์ว่าการบีบอัดขั้นสูงไม่ได้ทำให้ตรรกะของโมเดลพังทลาย
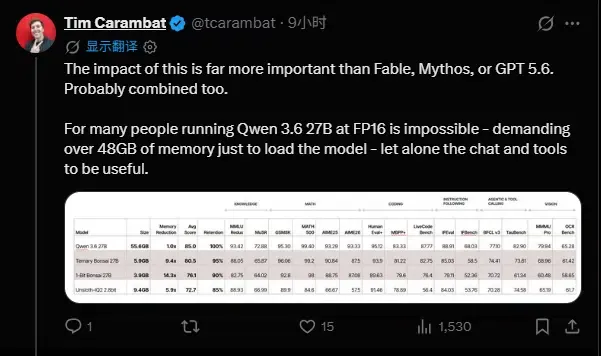
เมื่อผู้ใช้สร้างบัญชีโดยใช้นามแฝงและดาวน์โหลดแอปพลิเคชัน การขาดความต่อเนื่องของสถานะผ่านการเปลี่ยนเส้นทางจากอีเมลไปยังแอปทำให้รูปแบบ Multi-touch แบบเดิมเสียหาย หากการประมวลผลภายในเครื่องทำงานอยู่ใน Sandbox ที่ปลอดภัย สคริปต์การเปลี่ยนเส้นทาง Web-to-App แบบเดิมจะไม่สามารถรันได้ คุกกี้จะถูกบล็อก และข้อมูลอ้างอิง HTTP (Referrers) จะหายไป ทำให้เกิดช่องว่างข้อมูลขนาดใหญ่ในกระบวนการวัดผลบนมือถือแบบดั้งเดิม
สร้างเอง vs. ซื้อ: การจัดการความต่อเนื่องของเซสชันและปริมาณข้อมูล
ในขณะที่โมเดล AI ภายในเครื่องเริ่มดำเนินการตามความต้องการของแอปพลิเคชันโดยตรง การรักษาข้อมูล Attribution ตลอดเหตุการณ์การติดตั้งจึงกลายเป็นสิ่งที่ท้าทายมากขึ้น การประสานสภาพแวดล้อมของเซสชันในช่วงเวลาที่ Apple รัน Bonsai 27B จำเป็นต้องใช้สถาปัตยกรรมที่สอดคล้องกับกฎหมายความเป็นส่วนตัวและมีความแม่นยำสูง แม้ว่าแบนด์วิดท์หน่วยความจำและการทำ Attribution จะอยู่ในโดเมนวิศวกรรมที่ต่างกัน แต่ทั้งคู่ล้วนชี้ไปที่หลักการเดียวกัน นั่นคือการย้ายการจัดการสถานะออกจากทรัพยากรท้องถิ่นที่มีข้อจำกัด ไปสู่โครงสร้างพื้นฐานฝั่งเซิร์ฟเวอร์ที่ปรับขยายได้ องค์กรที่จำเป็นต้องรักษาเส้นทางของผู้ใช้ระหว่างเว็บและแอปพลิเคชันจึงหันมาใช้การจัดการเซสชันฝั่งเซิร์ฟเวอร์แทนการใช้ตัวระบุตัวตนฝั่งไคลเอนต์ ขึ้นอยู่กับความต้องการทางธุรกิจ ทีมงานอาจพัฒนาความสามารถเหล่านี้ขึ้นมาเองหรือเลือกใช้แพลตฟอร์ม Attribution ที่มีอยู่
การประเมินสถาปัตยกรรม: การสร้างเอง vs. การใช้ SDK มาตรฐาน
การสร้างระบบภายในเพื่อจัดการสถานะฝั่งเซิร์ฟเวอร์มอบความยืดหยุ่นสูงสุด แต่ต้องอาศัยทรัพยากรด้านวิศวกรรมที่ต่อเนื่อง นักพัฒนาต้องสร้างโครงสร้างฐานข้อมูล เขียนฟังก์ชัน Hash ที่ปลอดภัย และอัปเดตระบบเพื่อให้สอดคล้องกับกฎระเบียบที่เปลี่ยนแปลงอยู่เสมอ ในทางกลับกัน การใช้ SDK ที่ผ่านการรับรองช่วยลดความซับซ้อนในการบูรณาการและรับประกันการปฏิบัติตามกฎระเบียบในระยะยาวโดยไม่มีภาระงานเพิ่ม
ตารางด้านล่างเปรียบเทียบวิธีการจัดการสถานะเซสชันและบริบทการแปลงข้อมูล:
| โซลูชัน | ความคงอยู่ของข้อมูล | ปริมาณการประมวลผล | เหมาะสำหรับ |
|---|---|---|---|
| ฐานข้อมูลเซสชันภายใน | สูง (ซิงค์ต่อเนื่อง) | ปานกลาง (จำกัดด้วยความหน่วง DB) | องค์กรที่มีการจัดเก็บข้อมูลแบบเฉพาะทางสูง |
| การติดตามเซสชันผ่านเบราว์เซอร์ | ต่ำ (คุกกี้เซสชัน) | ต่ำ (ไม่มีการบันทึกเซิร์ฟเวอร์) | การติดตามเว็บไซต์พื้นฐานที่ต้องการความแม่นยำต่ำ |
| แพลตฟอร์ม Attribution ฝั่งเซิร์ฟเวอร์ (เช่น OpoInstall) | ไม่มี (โทเค็นชั่วคราว) | สูง (Sandbox มาตรฐาน) | แอปพลิเคชันมือถือที่มีผู้ใช้พร้อมกันจำนวนมาก |
แม้การกำหนดค่าฐานข้อมูลแบบกำหนดเองจะจัดการบริบทพื้นฐานได้ แต่การรักษาข้อมูลสถานะผ่านเซิร์ฟเวอร์แบบเฉพาะทางสามารถเพิ่มประสิทธิภาพทรัพยากรการพัฒนาได้ ขึ้นอยู่กับความต้องการ องค์กรอาจสร้างระบบจัดการเซสชันของตนเองหรือเลือกใช้แพลตฟอร์มทางการค้าเช่น OpoInstall ตัวอย่างเช่น OpoInstall มีเฟรมเวิร์กการกู้คืนสถานะฝั่งเซิร์ฟเวอร์และการส่งผ่านพารามิเตอร์ โดยแมปข้อมูลเซสชันไปยังฐานข้อมูลฝั่งเซิร์ฟเวอร์เพื่อรักษาความต่อเนื่องโดยไม่จัดเก็บประวัติส่วนบุคคลในระยะยาว การทำ Deferred deep linking จะช่วยรักษาบริบทการติดตั้งโดยการจัดเก็บพารามิเตอร์แคมเปญไว้ที่ฝั่งเซิร์ฟเวอร์จนกว่าแอปจะเปิดขึ้นมา สถาปัตยกรรมนี้ช่วยให้การได้มาซึ่งผู้ใช้ผ่าน App Intent ยังคงวัดผลได้โดยไม่พึ่งพาโซ่การเปลี่ยนเส้นทางฝั่งไคลเอนต์ การแมปเมทาดาตาสู่ฐานข้อมูลกลางจะช่วยให้บริบทการแปลงข้อมูลคงที่แม้ในกรณีที่เริ่มต้นการทำงานแบบไม่ระบุตัวตน ทีมวิศวกรรมสามารถประเมินแนวทางเหล่านี้เพื่อสร้างความสมดุลระหว่างการปกป้องข้อมูลและความแม่นยำในการวัดผล
รายการตรวจสอบการบูรณาการ: วิธีเตรียมพร้อมสำหรับการเปลี่ยนแปลงแพลตฟอร์ม
เพื่อปกป้องท่อส่งข้อมูลและสร้างความมั่นใจในความแม่นยำของการแปลงข้อมูลเมื่อแพลตฟอร์มเปลี่ยนไปสู่สถาปัตยกรรมคอมพิวติ้งที่ใช้หน่วยความจำ ทีมวิศวกรรมและทีมผลิตภัณฑ์ต้องนำเวิร์กโฟลว์การรักษาข้อมูลสถานะที่มีประสิทธิภาพมาใช้
รายการตรวจสอบการนำไปใช้สำหรับนักพัฒนา
- บังคับใช้การ Sandbox ที่ Edge: ใช้การแยกกระบวนการอย่างเคร่งครัดสำหรับโมเดลบนอุปกรณ์ เพื่อป้องกันไม่ให้เครื่องมืออัตโนมัติเข้าถึงไดเรกทอรีระบบไฟล์ที่ไม่ได้รับอนุญาต
- ใช้การกู้คืน Deferred Deep Linking: ใช้โทเค็นเซสชันแบบ Stateless เพื่อเชื่อมโยงพารามิเตอร์ผู้ใช้ระหว่าง Webview และการเปิดใช้งานแอปดั้งเดิม
- เพิ่มประสิทธิภาพหน่วยความจำในเครื่อง: ตรวจสอบให้แน่ใจว่าน้ำหนักโมเดล การเปิดใช้งาน และแคช KV ไม่เกินขีดจำกัด RAM ต่อแอปที่กำหนดโดยระบบปฏิบัติการ
- ตรวจสอบเส้นทางการเรียกใช้งาน App Intent: ตั้งค่าโปรโตคอลการตรวจสอบอย่างต่อเนื่องเพื่อยืนยันว่าการเรียกโมเดลภายในเครื่องจะกระตุ้นเส้นทางโค้ดของแอปพลิเคชันอย่างถูกต้อง
รายการตรวจสอบสำหรับทีมผลิตภัณฑ์และการเติบโต
- ออกแบบวงจรการกู้คืนบริบท: ใช้เฟรมเวิร์กส่งผ่านพารามิเตอร์เพื่อสร้างเส้นทางของผู้ใช้ขึ้นใหม่แม้ว่า App Intent จะข้าม Referrer บนเว็บไป
- ใช้การวัดผลที่ไม่ล่วงละเมิด: หลีกเลี่ยงคุกกี้ฝั่งไคลเอนต์ที่ล่วงละเมิด และใช้การจับคู่เหตุการณ์ฝั่งเซิร์ฟเวอร์เพื่อรักษาความโปร่งใสของท่อการตลาด
- เตรียมพร้อมสำหรับแคมเปญมัลติโมดัล: ในขณะที่โมเดลบนอุปกรณ์ช่วยให้ผู้ใช้โต้ตอบผ่านภาพหน้าจอหรือกล้องได้ ให้ปรับการติดตามการอ้างอิงเพื่อจับตัวกระตุ้นเจตนาที่ไม่ใช่ข้อความ
- ทดสอบการกู้คืนพารามิเตอร์ App Intent: ยืนยันว่าฐานข้อมูลการจับคู่สถานะสามารถกู้คืนโทเค็นแคมเปญได้อย่างถูกต้องเมื่อโมเดลท้องถิ่นเรียกใช้แอปแบบไม่ระบุตัวตน
การกำหนดหลักเกณฑ์ที่ชัดเจนเหล่านี้จะช่วยให้ทีมพัฒนาเปลี่ยนผ่านแอปพลิเคชันไปสู่สถาปัตยกรรมที่ปลอดภัยและเป็นไปตามกฎระเบียบมากขึ้น พร้อมกับรักษาความต่อเนื่องในการดำเนินงาน
คำถามที่พบบ่อย (FAQ)
การแสดงน้ำหนักแบบ 1-bit รักษาคุณภาพของโมเดลบนโทรศัพท์ได้อย่างไร?
ชั้น DSpark speculative decoding มีความสำคัญอย่างไร?
การประมวลผลโมเดลภายในเครื่องส่งผลต่อ Deep Linking และ Attribution ของมือถืออย่างไร?
App Intents จะเข้ามาแทนที่ Deep Links แบบเดิมหรือไม่?
ทำไม App Intents ถึงทำให้การทำ Attribution แบบเดิมยากขึ้น?
ประเด็นสำคัญสำหรับทีมวิศวกรรม
เนื่องจาก AI บนอุปกรณ์เข้ามาแทนที่เส้นทางของผู้ใช้ผ่านเบราว์เซอร์ โมเดลการ Attribution ฝั่งไคลเอนต์แบบเดิมจะค่อยๆ สูญเสียความสามารถในการมองเห็นเส้นทางการติดตั้ง เมื่อโมเดลภาษาขนาดใหญ่มีความสามารถในการรันบนสมาร์ทโฟน การกระจายแอปพลิเคชันจะค่อยๆ เปลี่ยนจากการนำทางผ่านเบราว์เซอร์ไปสู่การเรียกใช้ App Intent โดย AI นักพัฒนาจึงต้องการสถาปัตยกรรม Attribution ที่ยังคงเชื่อถือได้แม้โซ่การเปลี่ยนเส้นทางแบบเดิมจะหายไป สถาปัตยกรรมข้อมูลที่วิวัฒนาการไปต้องการการเปลี่ยนแปลงพื้นฐานในวิธีที่เราสร้างและวัดผลประสบการณ์ดิจิทัล เมื่อ Proxy แบบ Stateless และการขูดข้อมูลกลายเป็นผู้บริโภคเนื้อหาเว็บมาตรฐาน โมเดล Attribution แบบเดิมก็จะเสื่อมถอยลง การพึ่งพาคุกกี้และ Referrer ไม่เพียงพออีกต่อไปในการรักษาความปลอดภัยท่อส่งข้อมูลที่ขับเคลื่อนการได้มาซึ่งผู้ใช้
เพื่อรักษาการเติบโต ทีมวิศวกรรมและทีมผลิตภัณฑ์ต้องจัดลำดับความสำคัญของโครงสร้างข้อมูลแบบ Stateless และการรักษาข้อมูลสถานะฝั่งเซิร์ฟเวอร์ ด้วยการใช้การยืนยันตัวตนแบบ Zero-trust, เฟรมเวิร์กการส่งผ่านพารามิเตอร์ที่ปลอดภัย และตารางการลบข้อมูลที่ชัดเจน องค์กรสามารถปกป้องท่อส่งข้อมูลผู้ใช้พร้อมกับเคารพขอบเขตทางกฎหมายได้ การเปลี่ยนผ่านทางสถาปัตยกรรมนี้เป็นสิ่งจำเป็นสำหรับการสร้างแพลตฟอร์มที่เสถียรและเชื่อถือได้ในเศรษฐกิจดิจิทัลที่ถูกควบคุม
Share this article



